Bạn muốn tìm "10 quán cà phê gần tôi nhất" hoặc "sự kiện nào diễn ra trong tuần này". B-tree chịu thua cả hai. Lý do sâu xa: B-tree sắp dữ liệu trên một trục tuyến tính — số, chuỗi, ngày đều có thứ tự "trước/sau" rõ ràng. Nhưng một điểm hai chiều (x, y) thì không có thứ tự tự nhiên: sắp theo x rồi thì hai điểm gần nhau về y nằm cách xa nhau trong index. GiST (Generalized Search Tree) giải quyết đúng chỗ đó. Bài này đo GiST trên 1 triệu địa điểm thật.
Ý tưởng: cây của các hộp bao
GiST là một cây cân bằng, nhưng mỗi nút không giữ một khoảng giá trị như B-tree, mà giữ một hộp bao (bounding box) — vùng nhỏ nhất chứa trọn tất cả dữ liệu của các nút con bên dưới. Với điểm, hộp bao là một hình chữ nhật; với khoảng thời gian, là một khoảng lớn bao trùm. Khi tìm, PostgreSQL chỉ đi xuống những nhánh mà hộp bao có thể chứa kết quả, cắt bỏ phần lớn cây.
-- Điểm địa lý — dùng kiểu point sẵn có, không cần PostGIS
CREATE INDEX idx_dd_vitri ON diadiem USING gist (vi_tri);

-- Khoảng thời gian — dùng tsrange
CREATE INDEX idx_dd_kg ON diadiem USING gist (khung_gio);
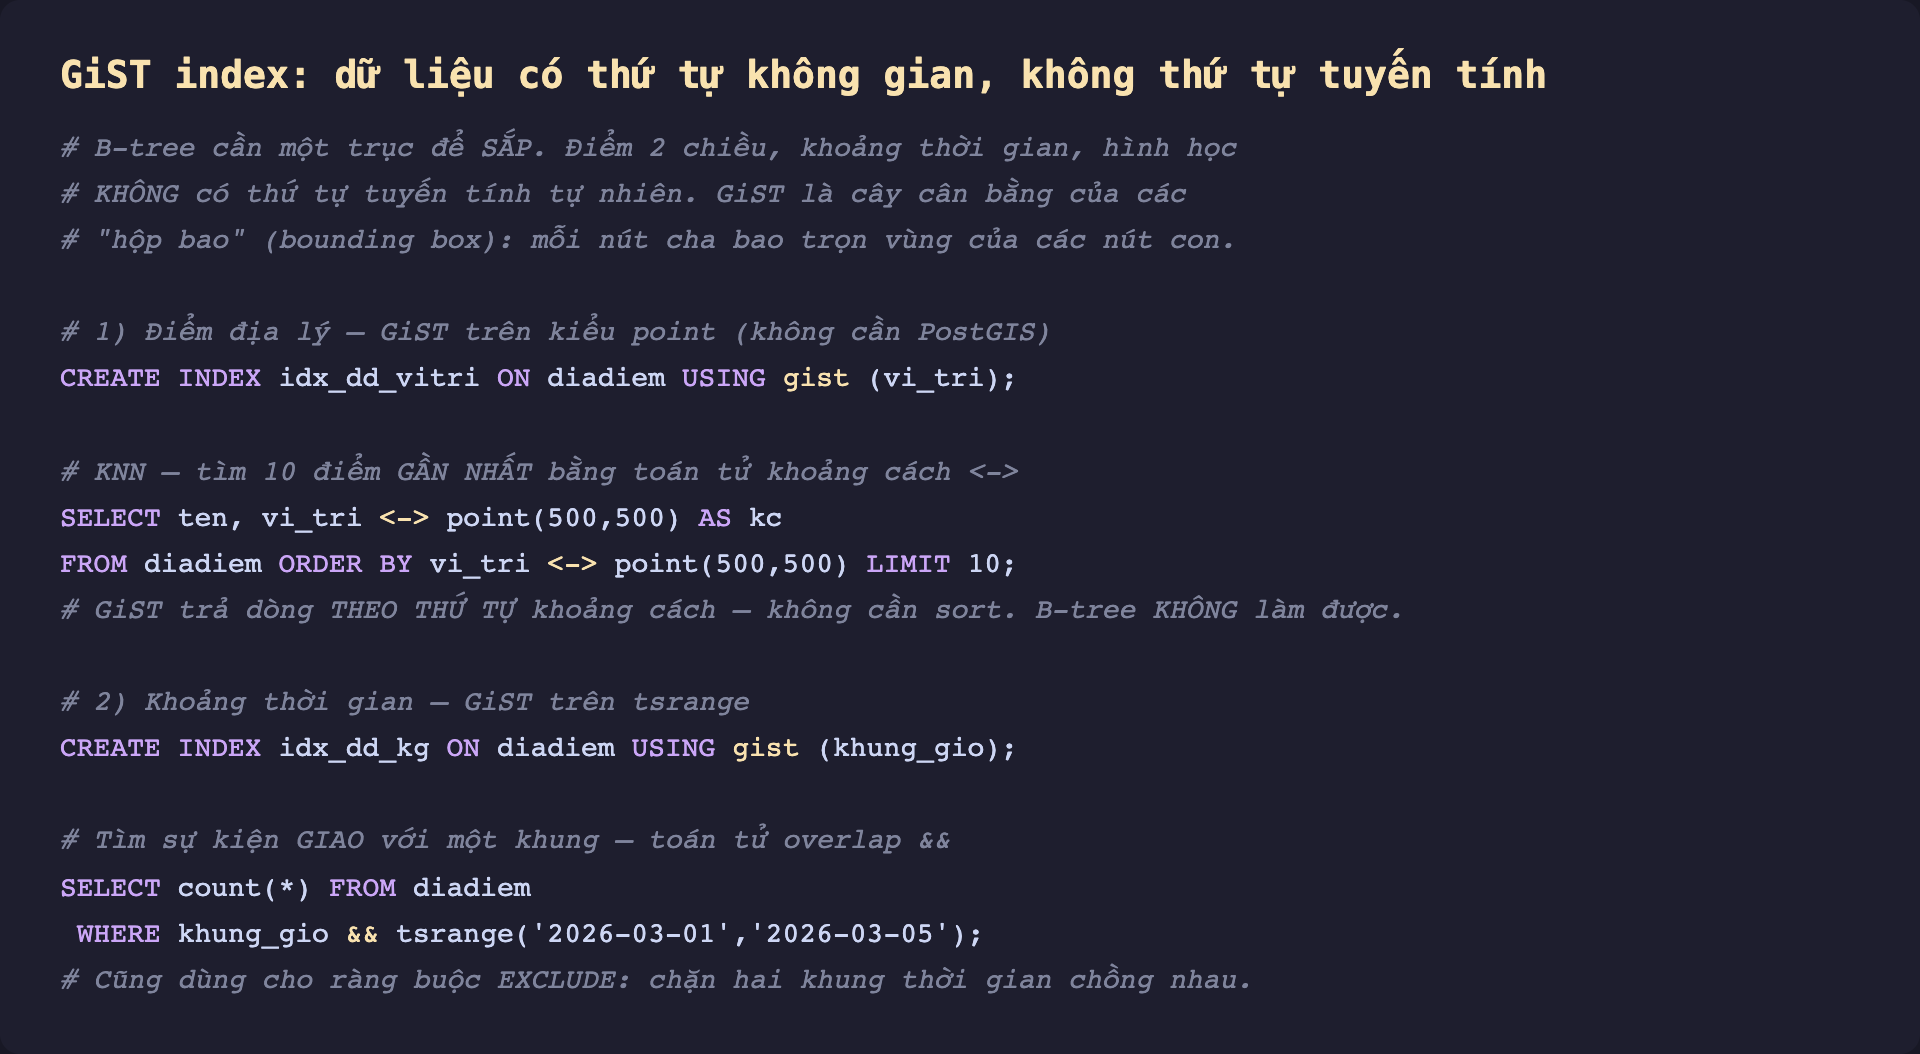
Hình 1: GiST cho hai loại dữ liệu không có thứ tự tuyến tính. Điểm dùng toán tử khoảng cách <-> (KNN), khoảng thời gian dùng toán tử overlap &&. Cả hai đều là thao tác mà B-tree không hỗ trợ.
KNN: điểm gần nhất — nơi GiST không có đối thủ
Đây là tính năng đắt giá nhất của GiST: k-nearest-neighbor. Tìm 10 điểm gần điểm (500, 500) nhất, sắp theo khoảng cách:
SELECT ten, vi_tri <-> point(500,500) AS kc
FROM diadiem
ORDER BY vi_tri <-> point(500,500)
LIMIT 10;
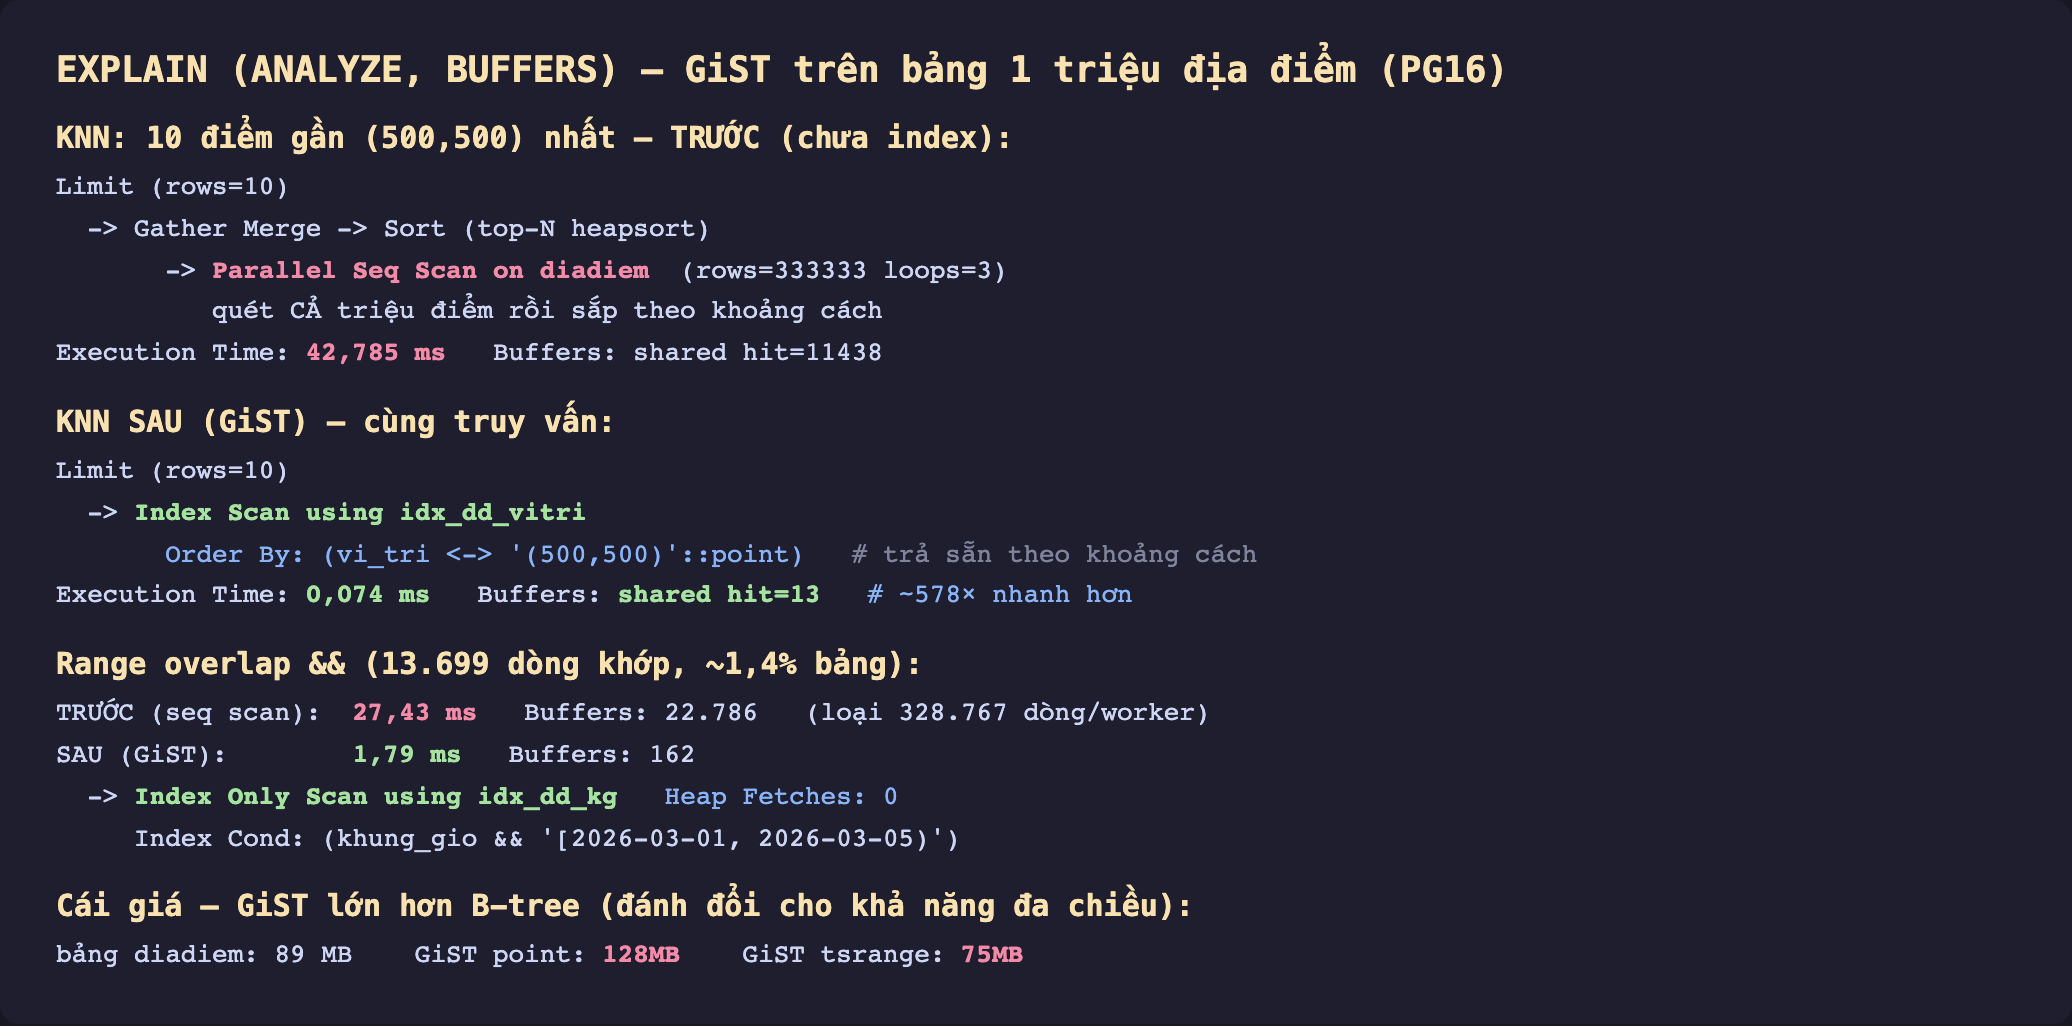
Hình 2: KNN trước/sau GiST. Không index: quét cả triệu điểm rồi top-N heapsort — 42,785 ms. Có GiST: Index Scan với Order By trả dòng sẵn theo khoảng cách, dừng ngay sau 10 dòng — 0,074 ms, chỉ đọc 13 trang. Nhanh gấp ~578 lần.
Con số 0,074 ms so với 42,785 ms không phải lỗi đánh máy. Chìa khóa nằm ở dòng kế hoạch: Index Scan ... Order By: (vi_tri <-> '(500,500)'). GiST duyệt cây theo thứ tự khoảng cách tăng dần và trả dòng ra đã sắp sẵn, nên LIMIT 10 dừng lại ngay sau khi lấy đủ 10 điểm — chỉ chạm 13 trang. Không index, PostgreSQL buộc phải tính khoảng cách cho cả triệu điểm rồi mới sắp để lấy top 10. B-tree không có cách nào làm KNN: nó không hiểu khái niệm "gần" trong không gian hai chiều.
Range overlap: khoảng thời gian giao nhau
GiST cũng đánh chỉ mục kiểu range. Tìm địa điểm có khung giờ giao với một tuần cụ thể bằng toán tử &&:
SELECT count(*) FROM diadiem
WHERE khung_gio && tsrange('2026-03-01', '2026-03-05');
Truy vấn này khớp 13.699 dòng (~1,4% bảng). Không index: seq scan cả triệu dòng, loại 328.767 dòng mỗi worker, mất 27,43 ms. Có GiST: Index Only Scan với Heap Fetches: 0 — index tự chứa đủ thông tin để đếm, không cần chạm heap — chỉ 1,79 ms, đọc 162 trang thay vì 22.786. Nhanh gấp ~15 lần.
Cùng cơ chế này còn dựng được thứ B-tree không làm nổi: ràng buộc EXCLUDE. Ví dụ, chặn hai lịch đặt phòng có khung giờ chồng nhau chỉ bằng EXCLUDE USING gist (phong WITH =, khung_gio WITH &&) — PostgreSQL dùng chính GiST để kiểm tra giao nhau khi ghi.
Đánh đổi cần cân nhắc
GiST mạnh nhưng có giá rõ ràng, đọc kỹ trước khi dùng:
Index lớn hơn B-tree. Ở đây GiST trên point chiếm 128 MB — lớn hơn cả bảng 89 MB — và GiST trên tsrange là 75 MB. Hộp bao và cấu trúc cây đa chiều tốn nhiều không gian hơn khoảng giá trị tuyến tính gọn gàng của B-tree. Đây là cái giá cho khả năng truy vấn không gian; đừng dựng GiST cho cột vô hướng thường mà B-tree đã lo tốt.
GiST "lossy" theo bản chất. Hộp bao chỉ nói vùng có thể chứa kết quả, nên GiST luôn cần bước kiểm lại chính xác (recheck) trên dữ liệu thật — khác với B-tree cho câu trả lời chắc chắn ngay từ index. Với KNN, PostgreSQL xử lý việc này trong lúc duyệt cây; nhưng nó là lý do GiST tốn CPU hơn cho mỗi mục.
Chọn lọc vẫn quyết định. Như mọi index, GiST chỉ thắng khi truy vấn lấy về phần nhỏ. Overlap 1,4% ở trên thắng đậm; nếu khung giờ rộng khiến truy vấn khớp 20% bảng, seq scan lại nhanh hơn. GiST không phá được quy luật đó.
Ba ý mang về
- GiST đánh chỉ mục dữ liệu không có thứ tự tuyến tính — điểm, hình học, khoảng — bằng cây của các hộp bao, mở ra hai thao tác B-tree không làm được: tìm láng giềng gần nhất (
<->) và giao nhau (&&). - KNN là ngôi sao của GiST:
ORDER BY cot <-> diem LIMIT kđược trả dòng sẵn theo khoảng cách nênLIMITdừng sớm — trong phép đo này 0,074 ms so với 42,785 ms khi phải quét và sắp cả triệu điểm (~578×). - GiST đắt về không gian và CPU: index có thể lớn hơn cả bảng (128 MB so với 89 MB ở đây) và luôn cần recheck vì hộp bao là "lossy" — chỉ dùng cho cột không gian/khoảng, và vẫn cần truy vấn đủ chọn lọc.
Phần sau ta sang một loại index đi ngược hoàn toàn triết lý GiST — cực nhỏ, cực rẻ, dành cho bảng khổng lồ đã sắp sẵn theo thứ tự tự nhiên: Phần sau nói về BRIN — index chỉ vài chục KB cho bảng hàng GB.
