Bạn có một bảng log 10 triệu dòng, 687 MB, và hay truy vấn theo khoảng thời gian. Tạo B-tree trên cột thoi_diem thì index ngốn thêm 214 MB — gần một phần ba kích thước bảng. Với bảng time-series ghi liên tục, chi phí đó cộng dồn đáng kể. Có một loại index cho kết quả truy vấn gần y hệt B-tree nhưng chỉ chiếm 40 kB: BRIN (Block Range INdex). Bài này đo cả ba cách trên cùng một bảng thật.
Ý tưởng: một mục cho mỗi khối, không phải mỗi dòng
B-tree lưu một mục index cho mỗi dòng — đó là lý do nó to. BRIN đi hướng ngược lại triệt để: nó chia bảng thành các vùng khối (mặc định 128 trang mỗi vùng, ~1 MB), và với mỗi vùng chỉ lưu giá trị nhỏ nhất và lớn nhất của cột. Thế thôi. 10 triệu dòng gói trong vài nghìn cặp min/max, vừa vặn trong vài chục KB.
Khi truy vấn thoi_diem >= X AND thoi_diem < Y, BRIN quét danh sách vùng, loại ngay những vùng có khoảng [min, max] không giao với [X, Y], và chỉ đọc heap ở các vùng còn lại. Vì mỗi vùng "thô" (chứa nhiều dòng thừa), sau khi đọc heap PostgreSQL vẫn phải kiểm lại từng dòng — bù lại, nó bỏ qua được phần lớn bảng mà không cần một index đồ sộ.
-- Điều kiện SỐNG CÒN: cột phải tương quan cao với thứ tự vật lý trên đĩa
SELECT correlation FROM pg_stats
WHERE tablename='log_su_kien' AND attname='thoi_diem';   -- = 1.0

CREATE INDEX idx_log_brin ON log_su_kien USING brin (thoi_diem);
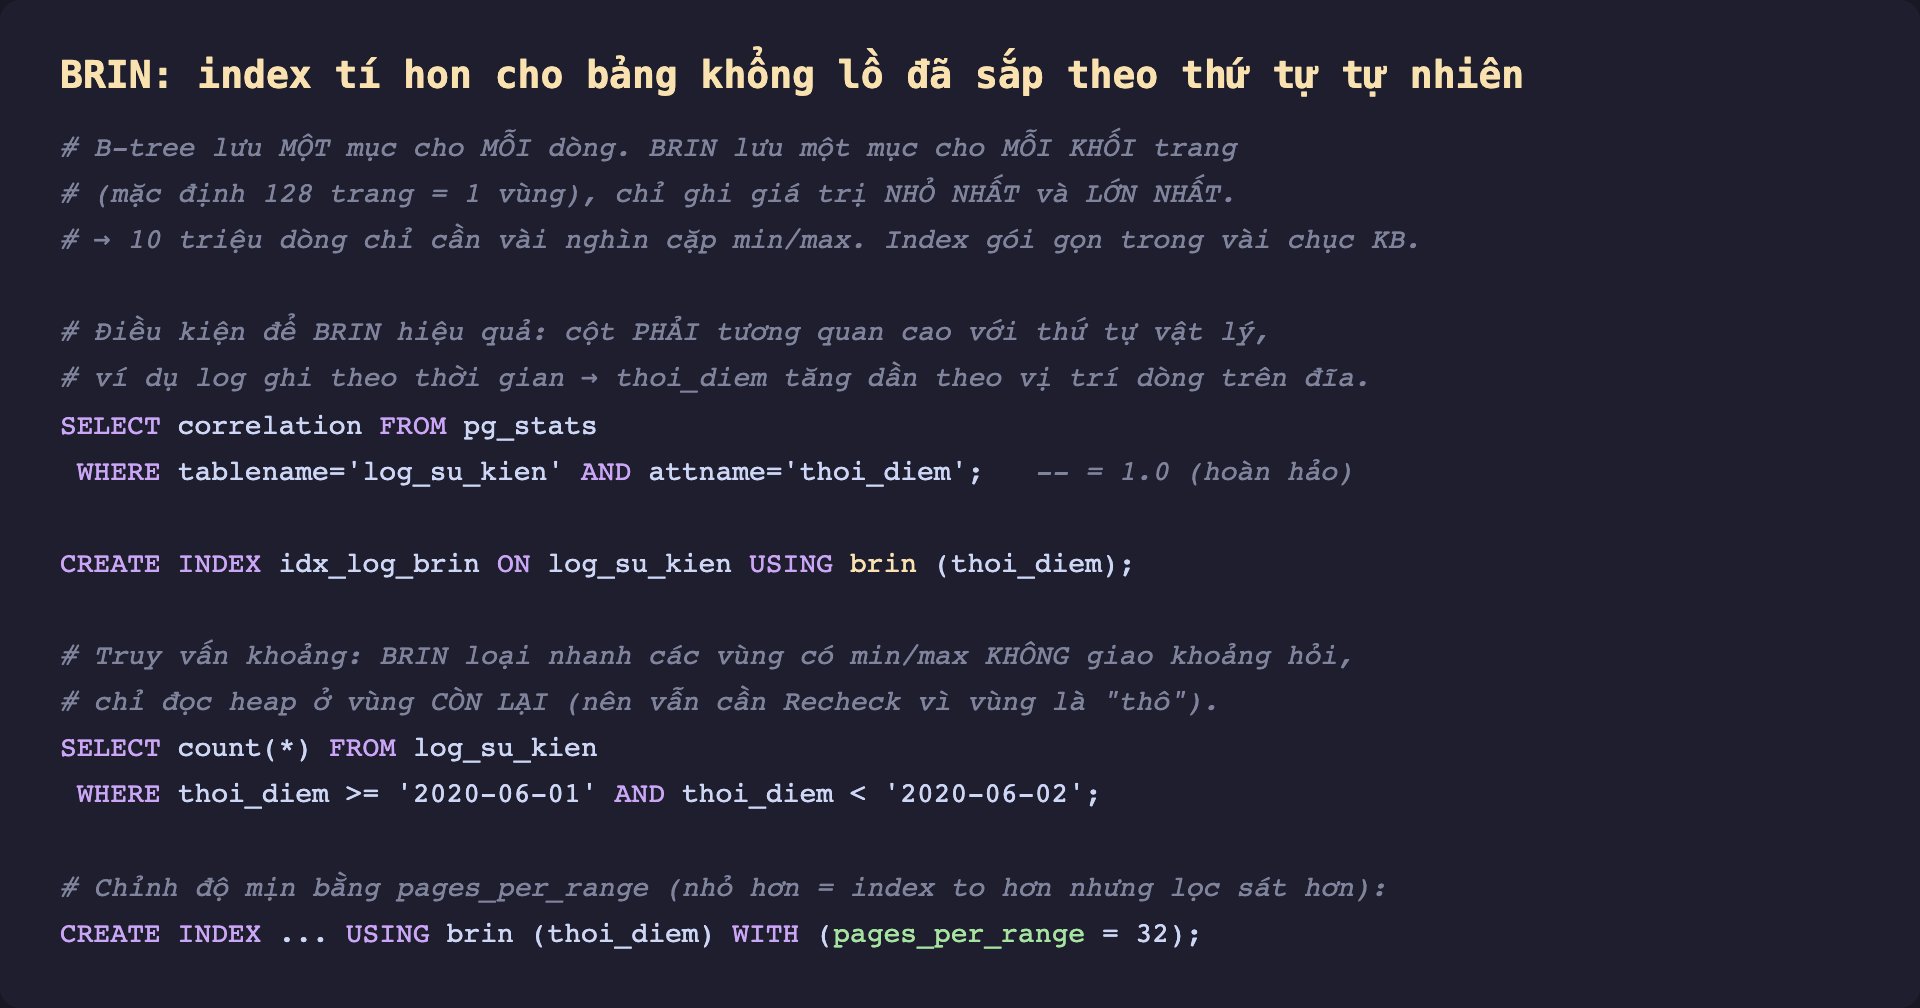
Hình 1: BRIN lưu min/max cho mỗi vùng khối thay vì mỗi dòng. Điều kiện tiên quyết: cột tương quan cao với thứ tự vật lý — kiểm bằng correlation trong pg_stats. Ở đây thoi_diem tăng đều theo thứ tự chèn nên correlation = 1,0.
Đo thật: BRIN nhanh ngang B-tree, nhỏ hơn 5.000 lần
Bảng log_su_kien có 10 triệu dòng, cột thoi_diem tăng đều (mỗi dòng cách nhau 3 giây), correlation = 1,0. Truy vấn lấy đúng một ngày (28.800 dòng), so ba cách:
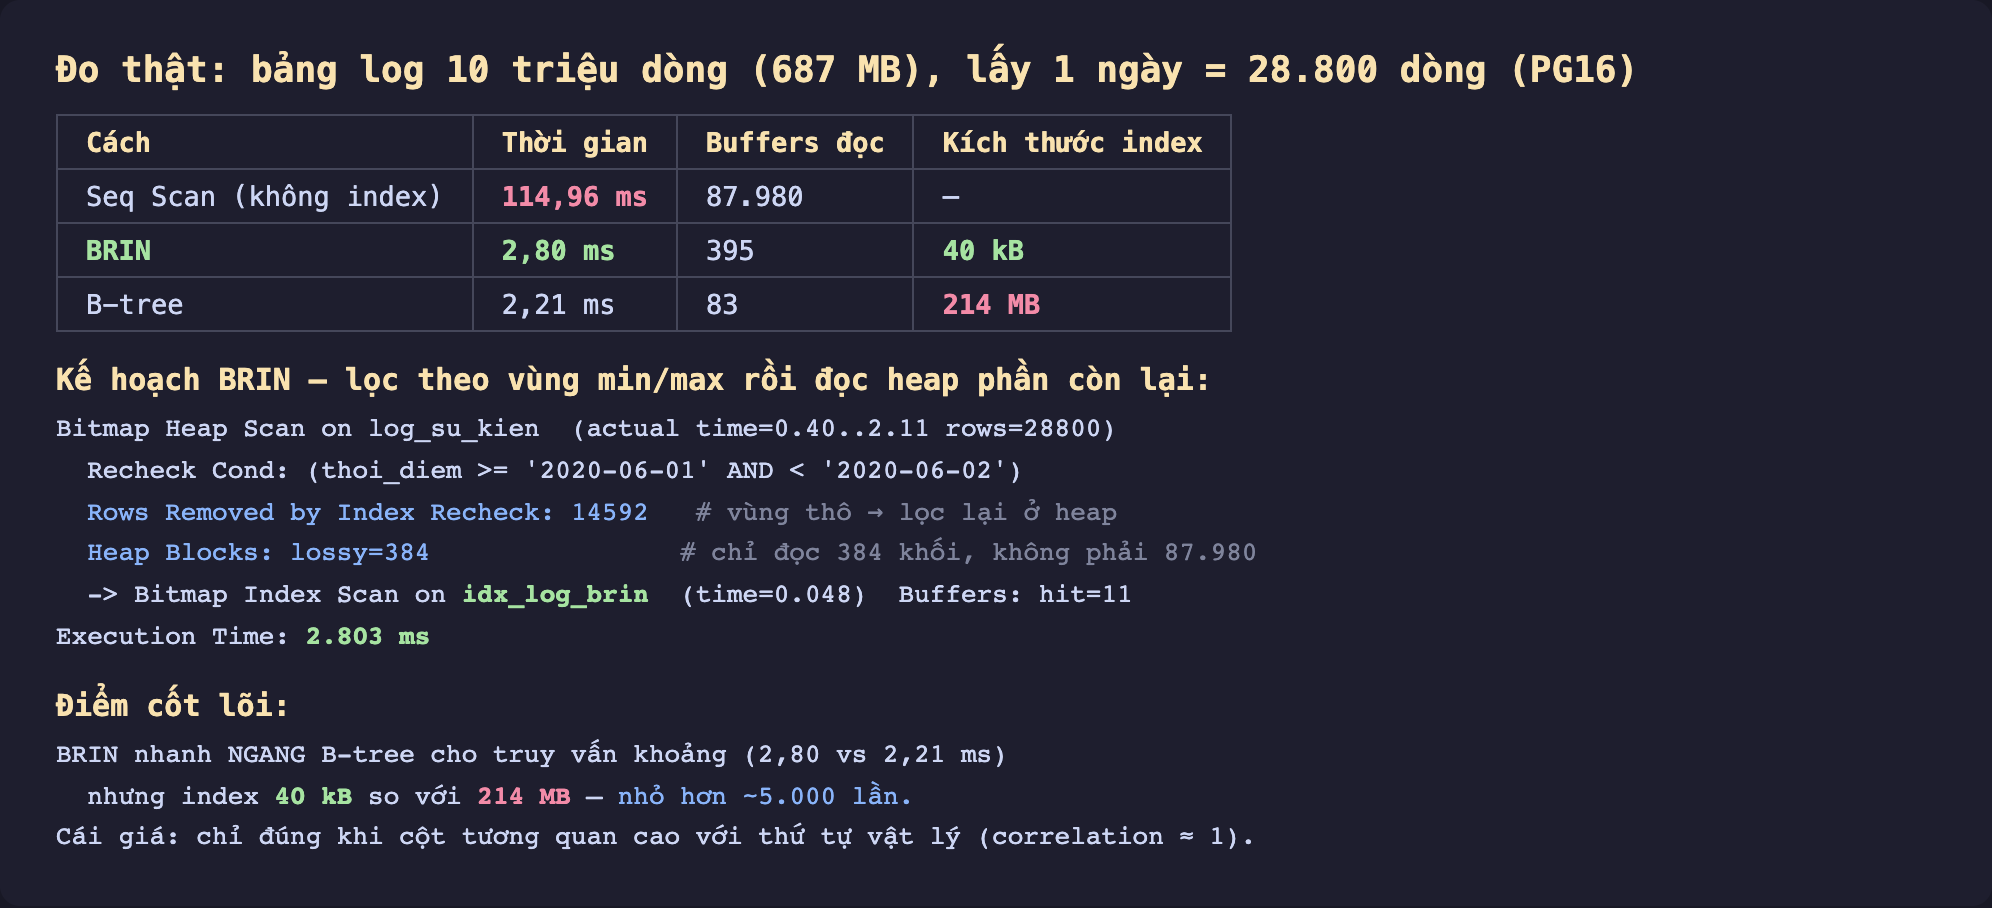
Hình 2: Ba cách trên cùng truy vấn. Seq scan 114,96 ms; BRIN 2,80 ms (index 40 kB); B-tree 2,21 ms (index 214 MB). BRIN nhanh gần bằng B-tree nhưng index nhỏ hơn ~5.000 lần.
Đọc kỹ ba dòng bảng:
- Seq scan (không index): quét cả 10 triệu dòng, loại 3,3 triệu dòng mỗi worker, đọc 87.980 trang — 114,96 ms.
- BRIN: đọc index chỉ 11 trang để biết vùng nào có thể chứa ngày cần tìm, rồi đọc 384 khối heap (
Heap Blocks: lossy=384), kiểm lại loại 14.592 dòng thừa — 2,80 ms. Index vỏn vẹn 40 kB. - B-tree:
Index Only Scan, đọc 83 trang, 2,21 ms. Nhanh hơn BRIN một chút, nhưng index nặng 214 MB.
Điểm mấu chốt: cho truy vấn khoảng trên bảng đã sắp theo thứ tự, BRIN cho tốc độ gần y hệt B-tree (2,80 so với 2,21 ms) trong khi tốn dung lượng gần như bằng không. Với bảng time-series hàng chục GB, chênh lệch giữa index 40 kB và index vài GB là khác biệt rất lớn về đĩa, về bộ nhớ đệm, và về thời gian bảo trì.
Chỉnh độ mịn: pages_per_range
BRIN có một núm điều chỉnh: pages_per_range (mặc định 128). Giảm nó xuống (ví dụ 32) làm mỗi vùng nhỏ hơn, nên min/max sát hơn và loại được nhiều dòng thừa hơn — nhưng index to hơn. Tăng lên thì index còn nhỏ hơn nữa nhưng lọc thô hơn, đọc nhiều heap hơn.
CREATE INDEX idx_log_brin_min ON log_su_kien
USING brin (thoi_diem) WITH (pages_per_range = 32);
Với bảng correlation gần 1, mặc định 128 thường đã rất tốt; chỉ chỉnh khi đo thấy Rows Removed by Index Recheck quá cao so với số dòng thật cần.
Đánh đổi: BRIN chỉ đúng khi dữ liệu sắp thứ tự
Đây là điều kiện sống còn, không phải tùy chọn:
Correlation thấp là BRIN vô dụng. Nếu cột không tương quan với thứ tự vật lý — ví dụ một user_id ngẫu nhiên rải khắp bảng — thì mỗi vùng khối sẽ có min/max trải rộng gần như toàn miền giá trị. Không vùng nào bị loại, BRIN phải đọc gần hết bảng, và bạn mất trắng. BRIN dành riêng cho cột tăng/giảm dần theo thứ tự chèn: thời gian tạo, id tự tăng, số thứ tự.
BRIN không giữ được thứ tự cho ORDER BY. Khác B-tree, BRIN không giúp ORDER BY thoi_diem hay tìm một dòng đơn lẻ nhanh — nó chỉ mạnh ở truy vấn khoảng trên bảng lớn.
Cập nhật ngoài thứ tự làm suy giảm dần. Nếu bạn chèn dữ liệu cũ vào giữa bảng đã sắp, hoặc UPDATE làm dòng nhảy trang, các vùng min/max sẽ nới rộng ra và mất khả năng loại. Với bảng append-only (log, sự kiện) thì không phải lo; với bảng sửa nhiều, cân nhắc brin_summarize_new_values hoặc quay lại B-tree.
Ba ý mang về
- BRIN lưu min/max cho mỗi vùng khối thay vì mỗi dòng, nên index nhỏ hơn B-tree hàng nghìn lần — ở đây 40 kB so với 214 MB trên bảng 10 triệu dòng, mà truy vấn khoảng vẫn nhanh gần bằng (2,80 so với 2,21 ms).
- Điều kiện sống còn là correlation cao giữa cột và thứ tự vật lý trên đĩa (log theo thời gian, id tự tăng): kiểm bằng
pg_stats.correlation, gần 1 thì BRIN tỏa sáng, gần 0 thì vô dụng. - BRIN là lựa chọn cho bảng time-series/append-only khổng lồ nơi dung lượng index quan trọng; nó không thay B-tree cho tra cứu dòng đơn hay
ORDER BY, và suy giảm nếu dữ liệu bị chèn/sửa ngoài thứ tự.
Phần sau ta xét một loại index hẹp nhất về công dụng — chỉ làm được đúng một việc, nhưng làm rất nhanh: Phần sau nói về hash index, vì sao nó chỉ phục vụ phép so bằng = và khi nào đáng dùng thay B-tree.
