B-tree là index vạn năng: nó phục vụ =, <, >, BETWEEN, ORDER BY, cả LIKE 'tiền tố%'. Vậy tại sao PostgreSQL còn giữ một loại index chỉ làm được đúng một việc — phép so bằng =? Câu trả lời nằm ở cách hash index lưu dữ liệu, và ở một trường hợp cụ thể nơi nó thắng B-tree về dung lượng. Bài này đo cả hai trên bảng 5 triệu phiên với token dài 101 ký tự.
Vì sao hash chỉ làm được =
B-tree lưu cả giá trị khoá, sắp theo thứ tự. Nhờ giữ thứ tự, nó trả lời được mọi câu hỏi liên quan đến "lớn hơn / nhỏ hơn / nằm giữa / bắt đầu bằng". Hash index thì khác hẳn: nó băm khoá xuống một mã 4 byte và dùng mã đó làm địa chỉ trong bảng băm. Cho một khoá, tính hash, nhảy thẳng tới đúng ngăn — cực nhanh cho =. Nhưng hàm băm phá huỷ thứ tự: hai token gần nhau về giá trị cho ra hai mã băm rải rác không liên quan. Vì thế hash không có khái niệm "trước/sau", nên chịu thua mọi truy vấn cần thứ tự.
-- Bảng phiên, token dài 101 ký tự, chỉ bao giờ tra bằng token
CREATE INDEX idx_phien_hash ON phien USING hash (token);

SELECT id FROM phien WHERE token = 'sess_dc41...';   -- dùng hash, tức thì
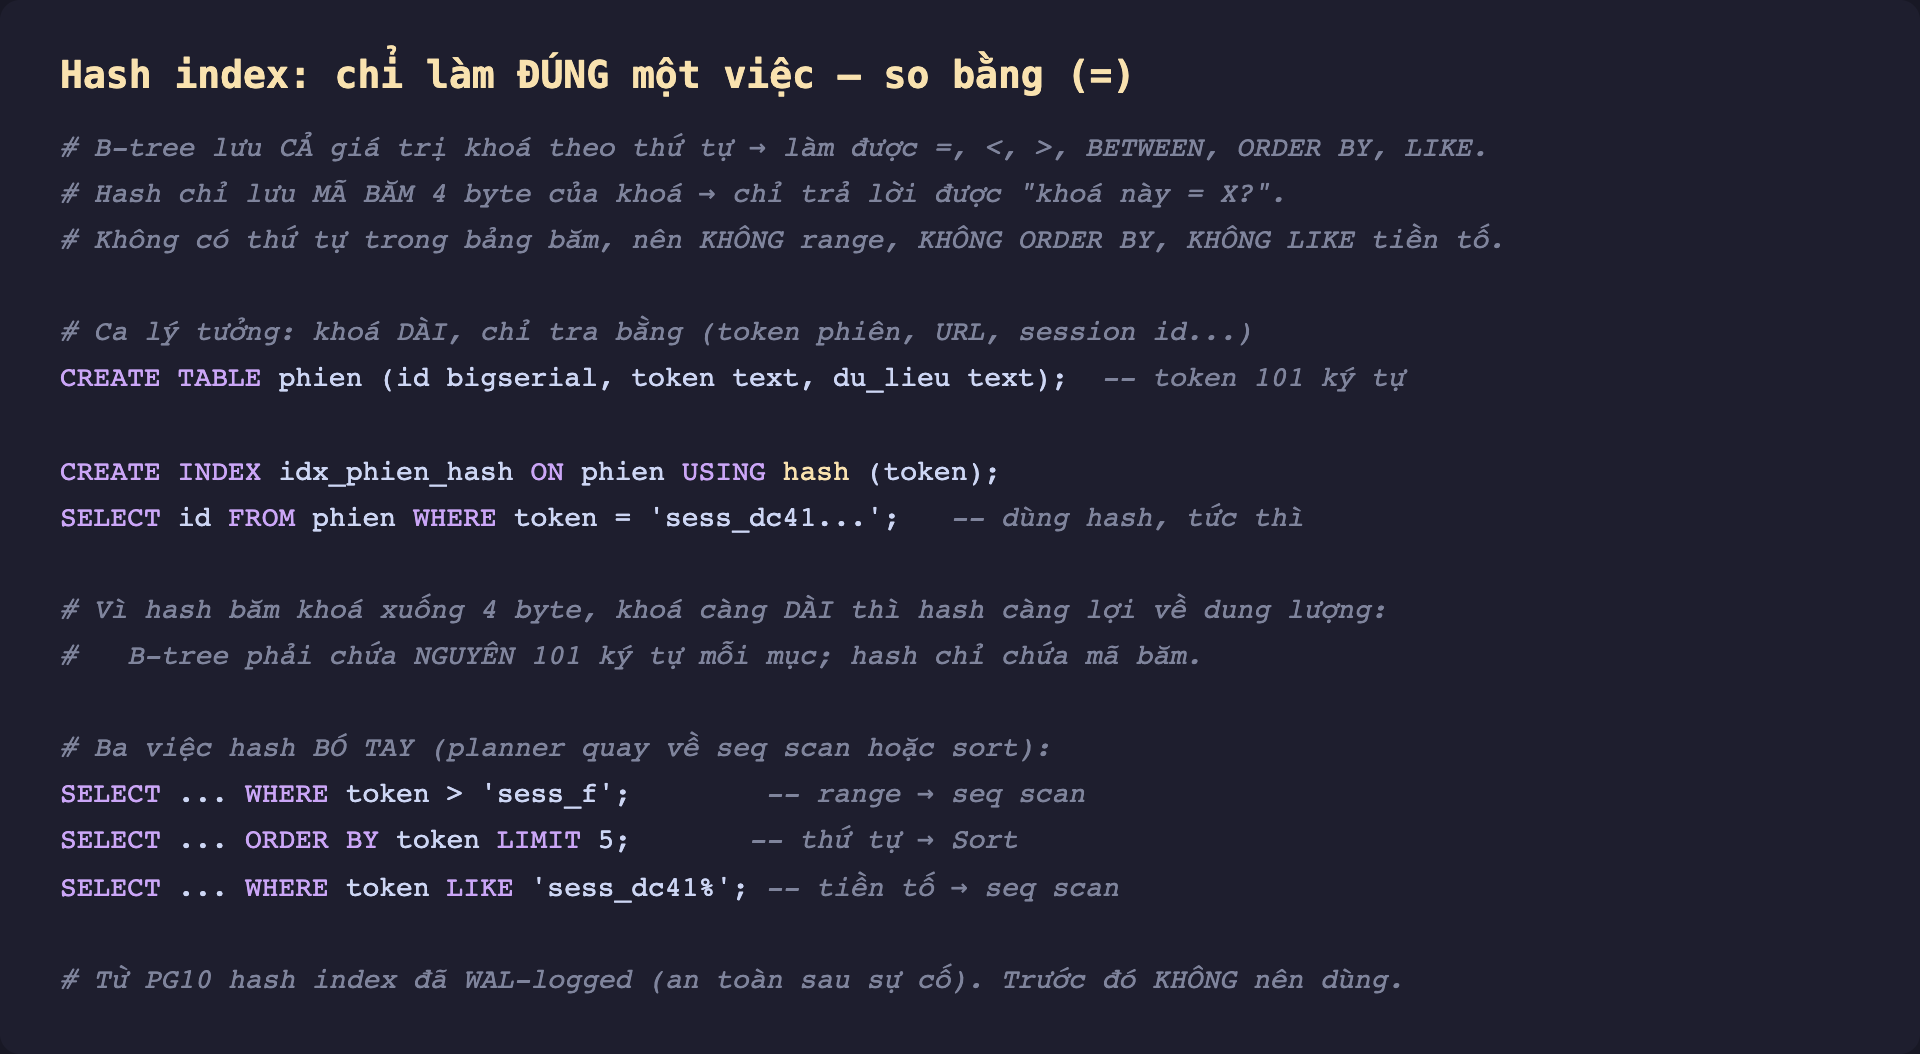
Hình 1: Hash chỉ lưu mã băm 4 byte, nên tra = tức thì nhưng mất hết khả năng về thứ tự. Ba truy vấn dưới cùng — range, ORDER BY, LIKE tiền tố — hash đều bó tay.
Đo thật: nhanh ngang B-tree, nhỏ hơn 5 lần
Bảng phien có 5 triệu dòng, cột token dài 101 ký tự (751 MB). So ba cách tra một token bằng phép =:
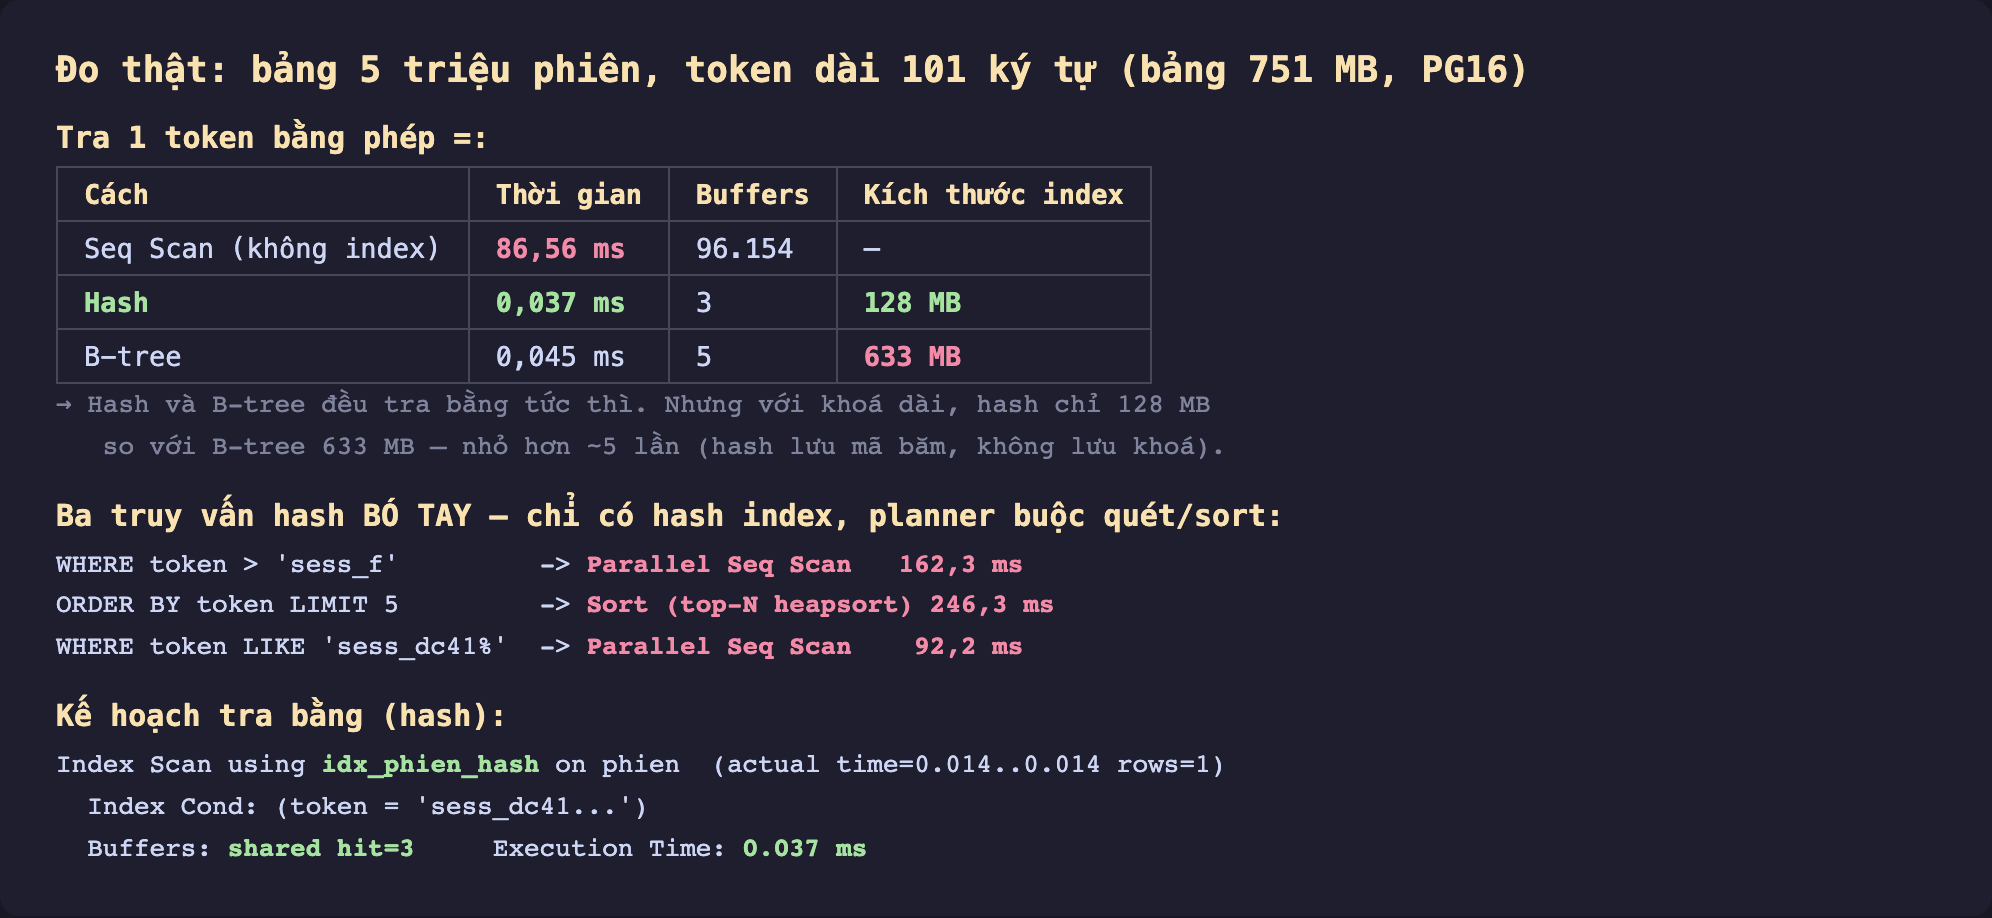
Hình 2: Tra = bằng ba cách. Seq scan 86,56 ms; hash 0,037 ms (index 128 MB); B-tree 0,045 ms (index 633 MB). Hash và B-tree nhanh tương đương, nhưng index hash nhỏ hơn ~5 lần vì nó chỉ lưu mã băm chứ không lưu cả token 101 ký tự.
Đây là toàn bộ lý do hash index tồn tại: với khoá dài, hash nhỏ hơn B-tree đáng kể. B-tree phải chứa nguyên vẹn 101 ký tự của mỗi token trong mỗi mục index (633 MB); hash chỉ chứa mã băm 4 byte (128 MB). Cả hai tra = đều tức thì (0,037 so với 0,045 ms), nên khi bạn chỉ bao giờ tra bằng — token phiên, session id, URL, API key — hash cho cùng tốc độ với một phần năm dung lượng. Index nhỏ hơn nghĩa là vừa bộ nhớ đệm tốt hơn, backup nhanh hơn, ghi rẻ hơn.
Ba việc hash bó tay
Khi chỉ có hash index và truy vấn cần thứ tự, planner buộc phải quét bảng hoặc sắp lại — đo thật cho thấy giá đắt:
WHERE token > 'sess_f'(range) →Parallel Seq Scan, 162,3 msORDER BY token LIMIT 5→Sort(top-N heapsort), 246,3 msWHERE token LIKE 'sess_dc41%'(tiền tố) →Parallel Seq Scan, 92,2 ms
Cả ba, nếu dùng B-tree, sẽ nhanh hơn nhiều nhờ index có thứ tự. Đây là điều bạn phải chắc chắn trước khi chọn hash: cột đó không bao giờ cần sắp xếp hay tìm khoảng.
Đánh đổi cần cân nhắc
Chỉ chọn hash khi truy vấn thuần =. Nếu chỉ có khả năng cần ORDER BY hay range trong tương lai, B-tree an toàn hơn vì nó làm được cả = lẫn mọi thứ khác. Hash là lựa chọn chuyên biệt, không phải mặc định.
Lợi ích dung lượng phụ thuộc độ dài khoá. Với khoá ngắn (một int 4 byte), B-tree cũng đã nhỏ và còn kèm được nhiều tính năng — hash gần như không lợi gì, thậm chí thua. Hash chỉ thực sự tỏa sáng khi khoá dài: token, hash chuỗi, định danh văn bản lớn.
Hash không hỗ trợ unique index đa cột hay khoá chính. Bạn không dùng hash làm PRIMARY KEY hay UNIQUE nhiều cột được; nó chỉ là index tra cứu một cột.
Một lưu ý lịch sử quan trọng: trước PostgreSQL 10, hash index không được ghi WAL, nghĩa là không an toàn sau sự cố và không sao chép sang replica — tài liệu cũ khuyên tránh hoàn toàn. Từ PG10 trở đi điều này đã sửa: hash index được WAL-log đầy đủ, an toàn như mọi index khác. Nếu bạn đọc một lời khuyên "đừng bao giờ dùng hash index", hãy kiểm xem nó viết cho phiên bản nào.
Ba ý mang về
- Hash index chỉ phục vụ phép so bằng
=vì nó băm khoá xuống mã 4 byte và phá huỷ thứ tự — không range, khôngORDER BY, khôngLIKEtiền tố (đo thật: ba truy vấn đó rơi về seq scan/sort, 92–246 ms). - Với khoá dài, hash nhỏ hơn B-tree nhiều lần (128 MB so với 633 MB ở đây) trong khi tra
=nhanh tương đương — vì hash lưu mã băm chứ không lưu cả khoá; đó là lý do duy nhất và chính đáng để chọn nó. - Chỉ dùng hash khi chắc chắn cột thuần tra
=(token, session id, API key) và khoá đủ dài để hưởng lợi dung lượng; từ PostgreSQL 10 hash index đã an toàn với WAL, nhưng B-tree vẫn là mặc định an toàn khi có bất kỳ nhu cầu thứ tự nào.
Phần sau ta rời chủ đề loại index để bàn cách tạo index an toàn trên hệ thống đang chạy: Phần sau nói về CREATE INDEX CONCURRENTLY — vì sao tạo index thường khoá bảng, và cách né nó.
