Bạn có index trên cột email. Bạn viết WHERE lower(email) = 'user@example.com' để tra không phân biệt hoa thường. Truy vấn chậm ê chề, và EXPLAIN cho thấy... Seq Scan. Index đâu rồi? Đây là một trong những cái bẫy phổ biến nhất về index: bọc một hàm quanh cột là vô hiệu hóa index thường. May thay, PostgreSQL có lời giải gọn: expression index.
Vì sao hàm làm mất index
Index thường trên email lưu giá trị gốc của cột — 'User123@Example.COM' như người dùng gõ vào. Nhưng truy vấn của bạn cần so lower(email) = 'user123@example.com'. PostgreSQL không biết lower(email) bằng gì cho tới khi tính hàm đó cho từng dòng — mà index không chứa giá trị đã tính. Kết quả: nó bỏ index, quét cả bảng.
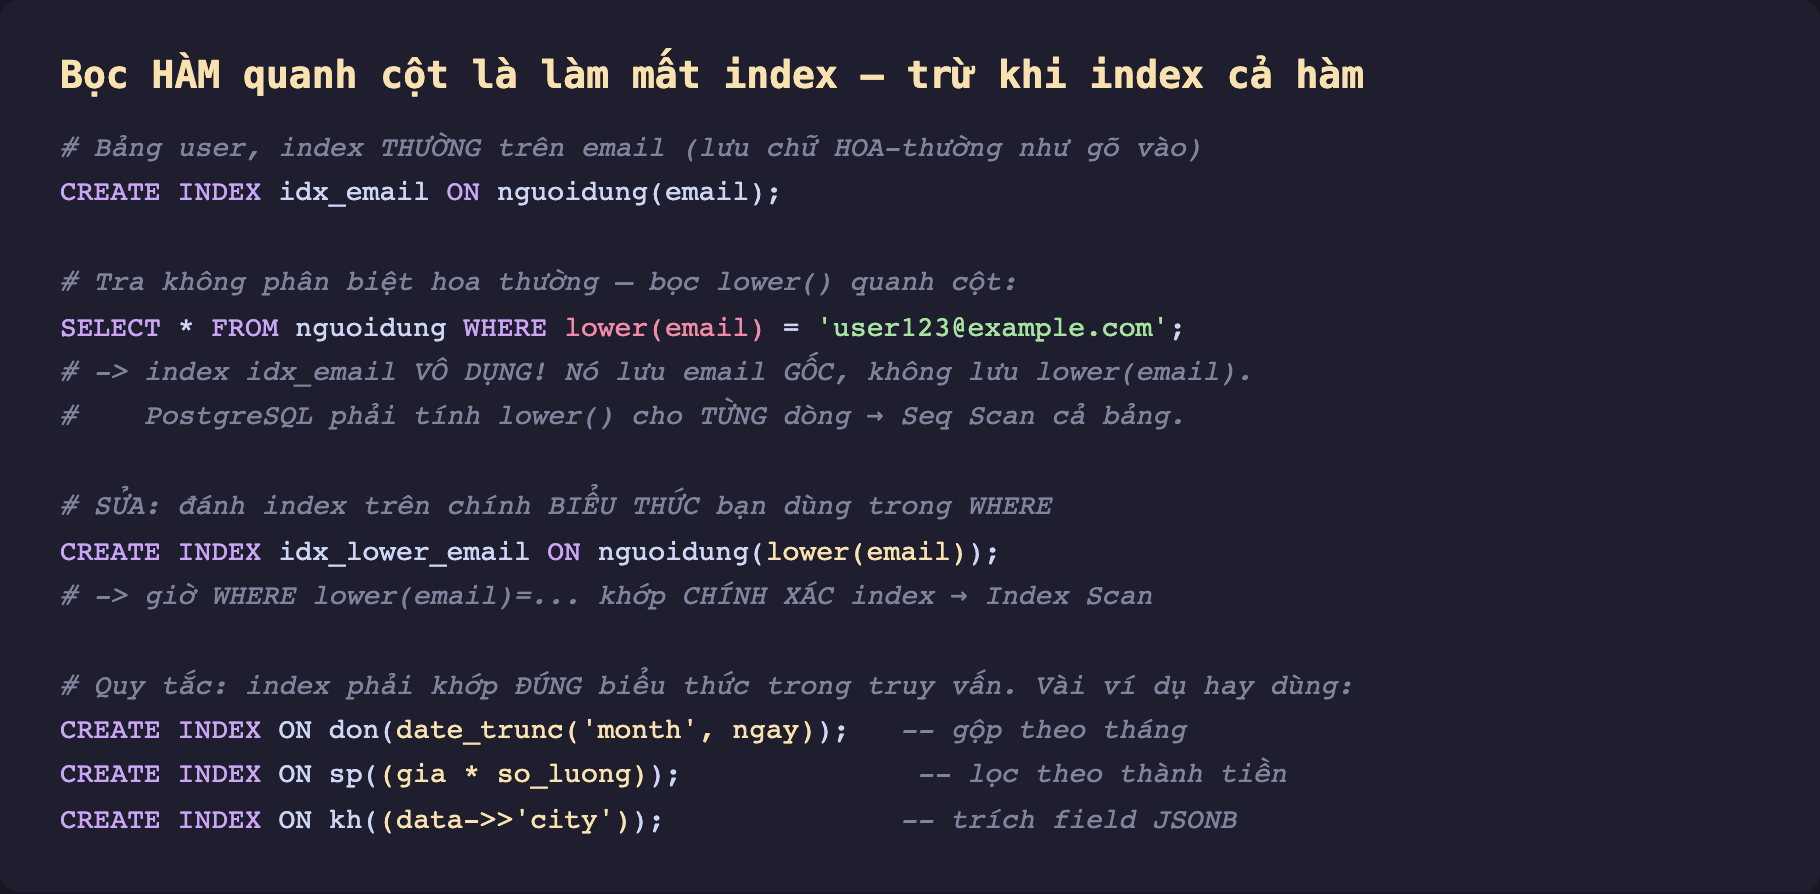
Hình 1: Bọc lower() quanh cột email khiến index thường trên email vô dụng — vì index lưu giá trị gốc, không lưu lower(email). Cách sửa: CREATE INDEX ... ON nguoidung(lower(email)) — đánh index trên chính biểu thức dùng trong WHERE. Quy tắc vàng: index phải khớp đúng biểu thức trong truy vấn.
Đo thật: 320 ms xuống 0,018 ms
Trên bảng 2 triệu user:
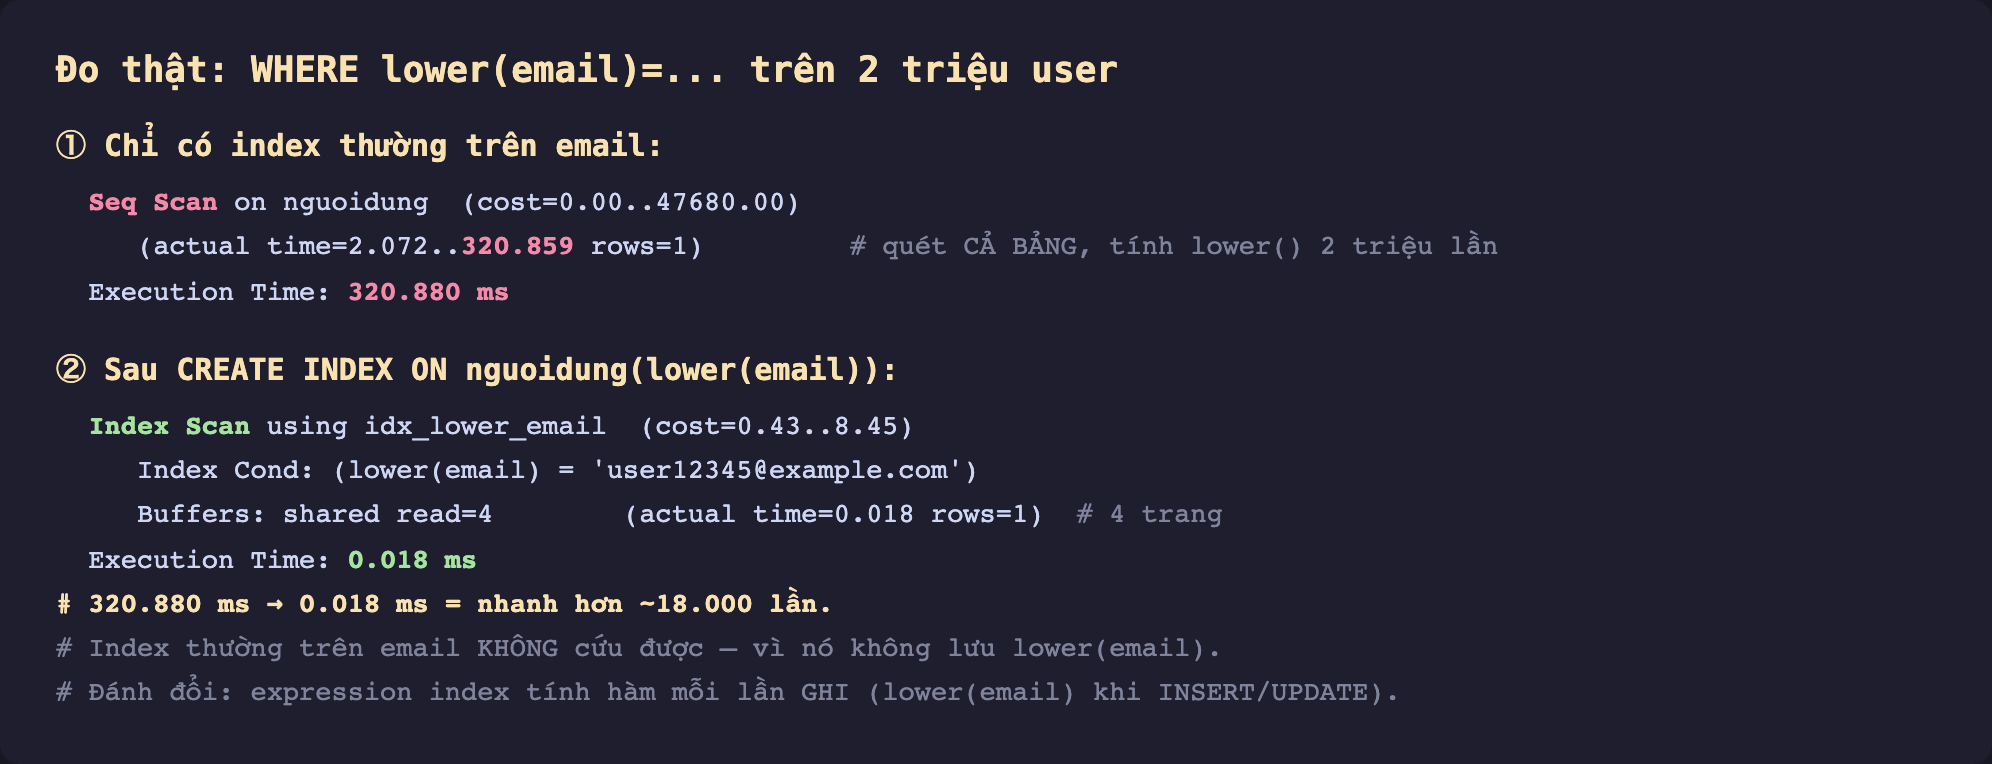
Hình 2: Thật. Với index thường trên email: truy vấn WHERE lower(email)=... phải Seq Scan, tính lower() cho cả 2 triệu dòng, mất 320,880 ms. Sau khi tạo expression index (lower(email)): Index Scan, chỉ chạm 4 trang, 0,018 ms — nhanh hơn ~18.000 lần. Con số nói tất cả.
Không chỉ lower() — mọi biểu thức
Expression index dùng được với bất kỳ biểu thức bất biến (immutable) nào, không chỉ lower(). Vài ca thực tế:
- Chuẩn hóa chuỗi:
lower(email),upper(ma_the),trim(ten)— tra không phân biệt hoa thường/khoảng trắng. - Cắt/gộp thời gian:
date_trunc('month', ngay)— nhóm báo cáo theo tháng mà không quét cả bảng. - Tính toán:
(gia * so_luong)— lọc/sắp theo thành tiền. - Trích JSONB:
(data->>'city')— index một field bên trong cột JSONB (một chủ đề lớn ở bài JSONB). - Ép kiểu:
(so_dien_thoai::bigint)— nếu bạn hay so như số.
Điều kiện: biểu thức phải IMMUTABLE — luôn cho cùng kết quả với cùng đầu vào. lower() immutable ✓. Nhưng now() hay random() thì không — không index được (và cũng vô nghĩa nếu có).
Cái giá và một lưu ý tinh tế
- Tốn khi ghi. Mỗi
INSERT/UPDATEphải tính biểu thức (lower(email)) để cập nhật index — chi phí ghi tăng chút. Vớilower()thì rẻ, nhưng biểu thức nặng thì đáng cân nhắc. - Truy vấn phải khớp ĐÚNG biểu thức. Index
(lower(email))phục vụWHERE lower(email)=..., nhưng không phục vụWHERE email=...(thiếulower), cũng không phục vụWHERE lower(trim(email))=...(biểu thức khác). Muốn cả hai kiểu tra thì cần hai index. - PostgreSQL còn dùng expression index cho thống kê. Nó tự thu thập thống kê trên biểu thức đã index, giúp ước lượng dòng chính xác hơn cho các truy vấn dùng biểu thức đó — một lợi ích phụ dễ chịu.
- Bọc
emailbằnglower()để tra hoa-thường là mẫu chuẩn — nhưng nếu bạn luôn lưu email dạng thường (chuẩn hóa lúc ghi), thì index thường trênemaillà đủ và rẻ hơn. Chọn cách phù hợp với dữ liệu của bạn.
Ba ý mang về
- Bọc hàm quanh cột trong
WHEREvô hiệu hóa index thường — vì index lưu giá trị gốc, không lưu kết quả hàm. Đã thấyWHERE lower(email)=...phải Seq Scan dù có index trênemail. - Expression index đánh index trên chính biểu thức (
CREATE INDEX ON t(lower(email))) — đo thật giảm từ 320 ms xuống 0,018 ms (~18.000 lần). - Dùng cho mọi biểu thức bất biến (
date_trunc, phép tính, trích JSONB...); truy vấn phải khớp đúng biểu thức; đánh đổi là chi phí tính hàm mỗi lần ghi.
Index đến giờ đều để tăng tốc đọc. Nhưng index còn một vai trò khác: cưỡng chế tính đúng đắn của dữ liệu. Phần sau nói về unique index và ràng buộc duy nhất — cách PostgreSQL đảm bảo không có giá trị trùng, mối liên hệ giữa UNIQUE constraint và index đứng sau nó, và những cái bẫy với NULL.
