Nhớ ở bài B-tree: index chỉ chứa khóa + con trỏ ctid, không chứa dữ liệu dòng. Nên sau khi tìm thấy trong index, PostgreSQL thường phải đọc thêm một lần vào heap (bảng thật) để lấy các cột còn lại. Bước đọc heap đó là chi phí ẩn của mọi index scan. Bài này chỉ cách bỏ hẳn nó bằng index-only scan — và công cụ để đạt được: covering index với INCLUDE.
Nhét sẵn cột vào index bằng INCLUDE
Nếu mọi cột truy vấn cần (cả trong SELECT lẫn WHERE) đều đã nằm trong index, PostgreSQL không cần chạm bảng nữa — nó trả kết quả chỉ từ index. Đó là index-only scan. Cách đưa thêm cột vào index mà không dùng chúng để tìm kiếm: mệnh đề INCLUDE.
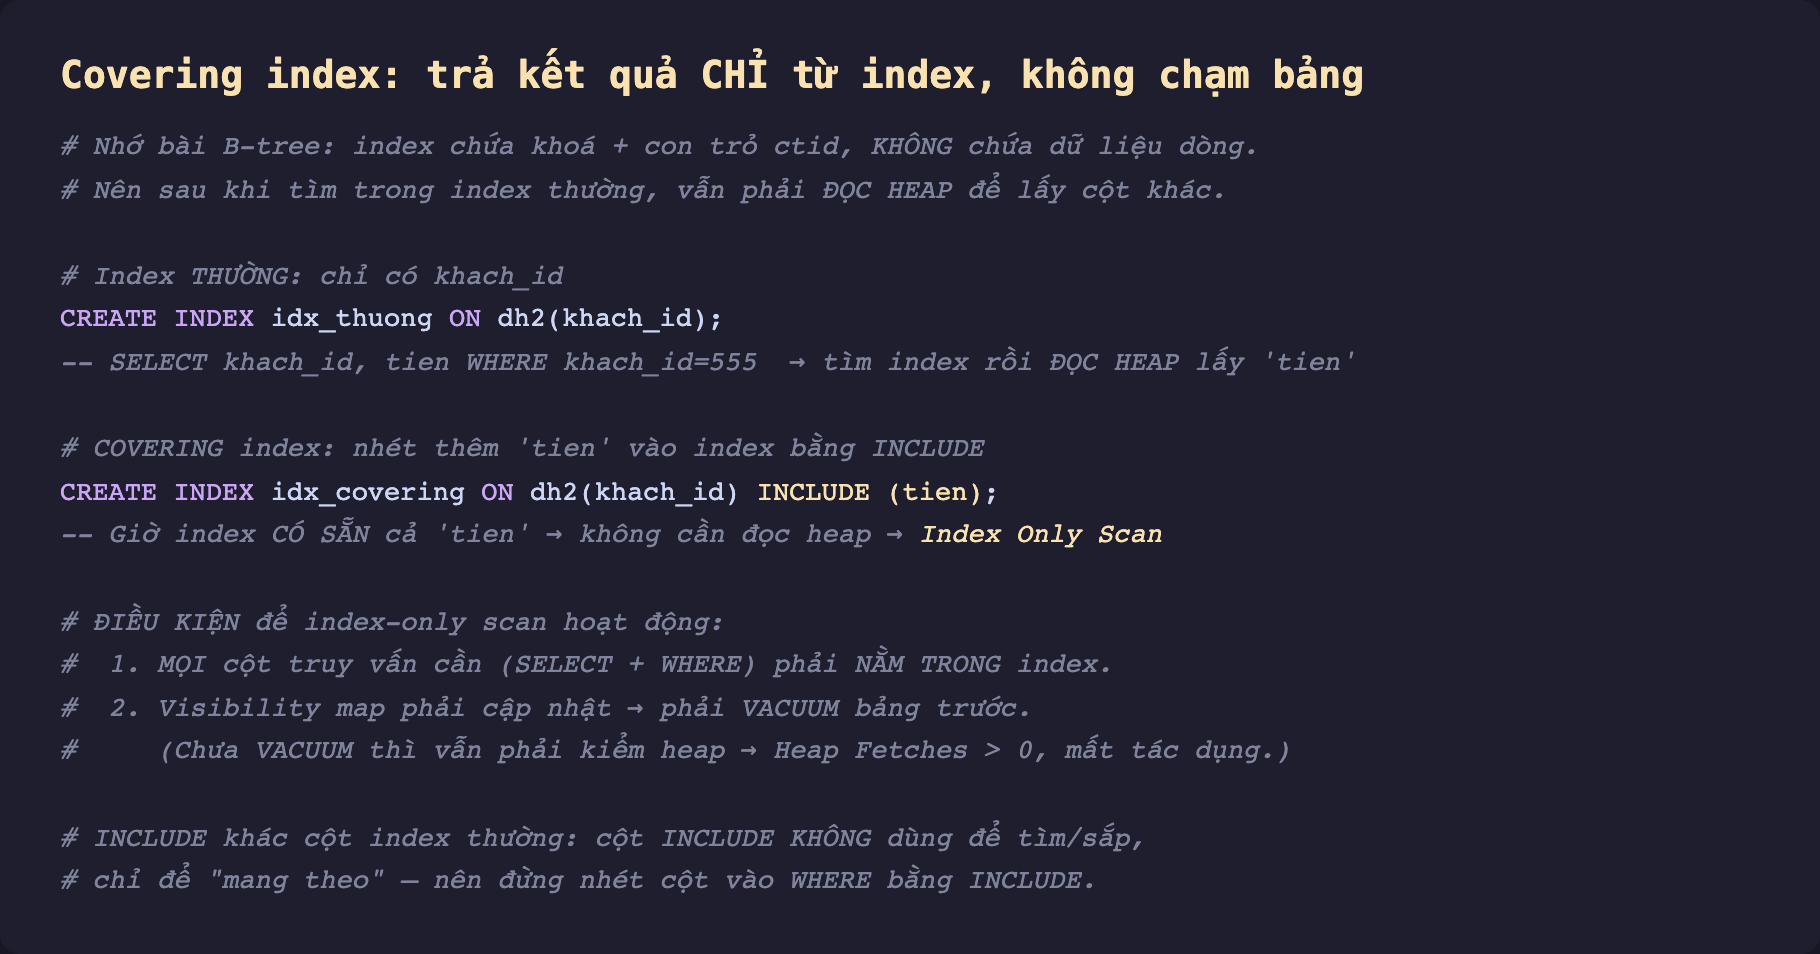
Hình 1: INCLUDE (tien) nhét cột tien vào index nhưng không dùng nó để tìm/sắp — chỉ để "mang theo". Hai điều kiện để index-only scan chạy: (1) mọi cột truy vấn cần phải có trong index; (2) visibility map phải cập nhật — nghĩa là bảng phải được VACUUM, vì PostgreSQL cần biết dòng nào chắc chắn hiển thị mà không phải mở heap ra kiểm.
Đo thật: cost 52.718 xuống 554
Cùng truy vấn SELECT khach_id, tien WHERE khach_id = 555, với index thường và với covering index:
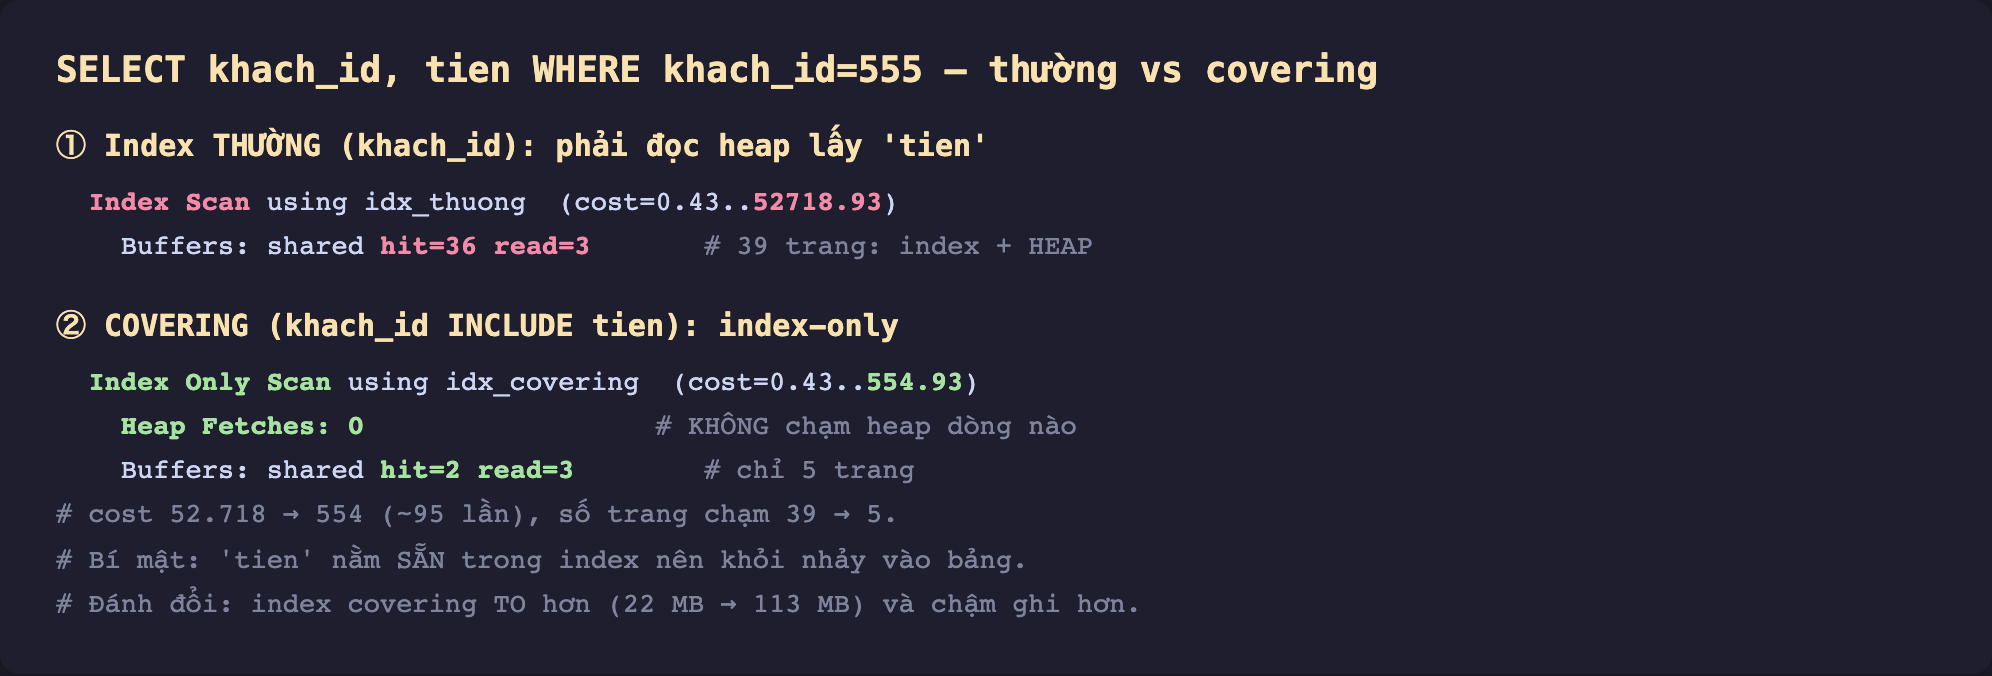
Hình 2: Thật. Index thường: Index Scan, cost 52.718, chạm 39 trang (index + heap để lấy tien). Covering index: Index Only Scan, cost 554 (~95 lần thấp hơn), Heap Fetches: 0, chỉ chạm 5 trang — không mở heap dòng nào. Bí mật: tien đã nằm sẵn trong index nên khỏi nhảy vào bảng.
Cạm bẫy: quên VACUUM
Đây là chỗ nhiều người vấp — và mình cũng vấp khi chuẩn bị bài này. Index-only scan chỉ hoạt động khi visibility map cập nhật. PostgreSQL không thể tin index một cách mù quáng: nó phải biết dòng đó có hiển thị với transaction hiện tại không (do MVCC, một dòng trong index có thể đã bị xóa/cập nhật). Visibility map ghi lại "trang này toàn dòng hiển thị" — và map đó được cập nhật bởi VACUUM.
- Chưa
VACUUMsau khi nạp/sửa dữ liệu →Heap Fetchessẽ lớn hơn 0, tức PostgreSQL vẫn phải mở heap để kiểm — mất phần lớn lợi ích. - Sau
VACUUM(hoặc autovacuum chạy),Heap Fetches: 0và index-only scan phát huy trọn vẹn.
Vì vậy, nếu bảng ghi nhiều mà autovacuum không theo kịp, index-only scan có thể "lúc nhanh lúc chậm" tùy visibility map — một điều đáng biết khi chẩn đoán.
INCLUDE vs cột index thường
Có hai cách đưa cột vào index, khác nhau về mục đích:
- Cột khóa index — dùng để tìm kiếm và sắp xếp (theo quy tắc cột trái nhất, bài trước). Nếu bạn cần lọc/sort theo cột đó, đặt nó làm cột khóa.
- Cột
INCLUDE— chỉ mang theo để phục vụ index-only scan, không dùng tìm/sắp. Hợp cho cột bạn chỉ cần đọc ra chứ không lọc, ví dụtienở trên. Nhét cột như vậy vàoINCLUDEgọn hơn làm nó thành cột khóa (không phình phần cây định vị).
Cái giá phải cân nhắc
Index-only scan không miễn phí:
- Index to hơn. Đo thật: covering index 113 MB so với index thường 22 MB — vì phải chứa thêm dữ liệu
tien. Tốn đĩa và bộ nhớ cache. - Ghi chậm hơn. Mỗi
UPDATEcột đượcINCLUDEcũng phải cập nhật index. Nếu cột hay đổi, chi phí ghi tăng. - Phụ thuộc VACUUM. Như trên — bảng ghi nhiều cần autovacuum tốt để giữ lợi ích.
Vì vậy: dùng covering index cho những truy vấn nóng, chạy nhiều mà chỉ cần vài cột — nơi khoản tiết kiệm đọc heap bù lại chi phí index lớn. Đừng INCLUDE bừa mọi cột.
Ba ý mang về
- Index-only scan trả kết quả chỉ từ index, bỏ bước đọc heap — điều kiện: mọi cột truy vấn cần phải nằm trong index. Dùng
INCLUDEđể nhét cột "mang theo" mà không làm cột khóa. - Đo thật cost giảm ~95 lần (52.718 → 554) và số trang chạm 39 → 5, với
Heap Fetches: 0— vìtiencó sẵn trong covering index. - Bắt buộc VACUUM: index-only scan cần visibility map cập nhật, nếu không
Heap Fetches > 0làm mất lợi ích. Đánh đổi: index to hơn (22 → 113 MB) và ghi chậm hơn — chỉ dùng cho truy vấn nóng đáng giá.
Các loại index đến giờ đều dựa trên toàn bộ bảng. Nhưng nếu bạn chỉ hay truy vấn một phần dữ liệu? Phần sau nói về partial index — index chỉ trên những dòng thỏa một điều kiện, cho index nhỏ hơn nhiều và nhanh hơn cho đúng truy vấn bạn quan tâm.
