Từ đây ta bước vào mảng lớn nhất của tối ưu: index. Và index quan trọng nhất — mặc định khi bạn gõ CREATE INDEX, và cái đứng sau mọi khóa chính — là B-tree. Trước khi học khi nào nên đánh index, hãy hiểu vì sao nó nhanh. Câu trả lời nằm ở một cấu trúc dữ liệu thanh lịch mà ta sẽ soi tận trang bằng pageinspect.
Cây cân bằng, tìm kiếm theo tầng
B-tree (Balanced tree) tổ chức các khóa thành một cây nhiều tầng: một trang gốc ở trên, các trang nội bộ ở giữa, và các trang lá ở dưới cùng chứa khóa thật kèm con trỏ tới dòng dữ liệu. Mỗi trang chứa hàng trăm khóa đã sắp xếp, nên cây rất "béo" và rất "nông".
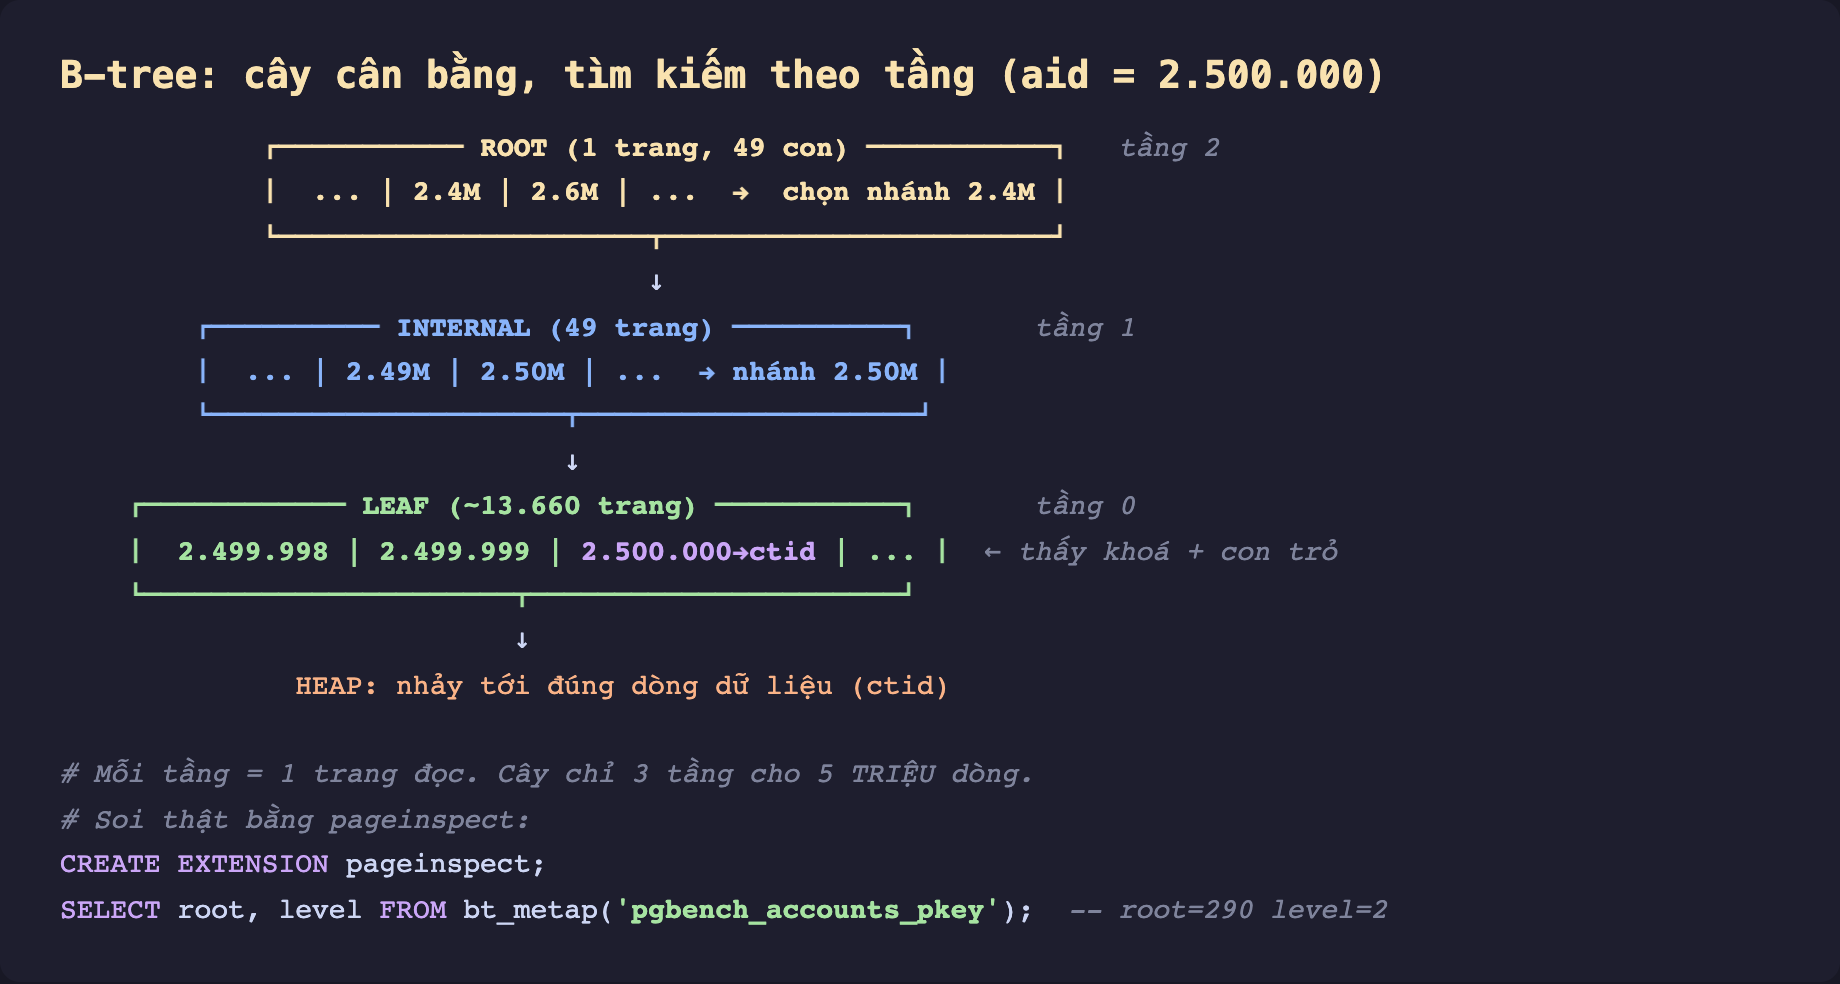
Hình 1: Tìm aid = 2.500.000 trong index khóa chính. Bắt đầu ở gốc, so khóa để chọn đúng nhánh, xuống một trang nội bộ, lại chọn nhánh, xuống trang lá — nơi có khóa thật kèm ctid (con trỏ tới dòng trong heap). Mỗi tầng chỉ tốn một trang đọc. Cây này chỉ ba tầng cho toàn bộ 5 triệu dòng.
Số thật: 4 trang cho 5 triệu dòng
Không phải sơ đồ minh hoạ — đây là index thật, soi bằng pageinspect:
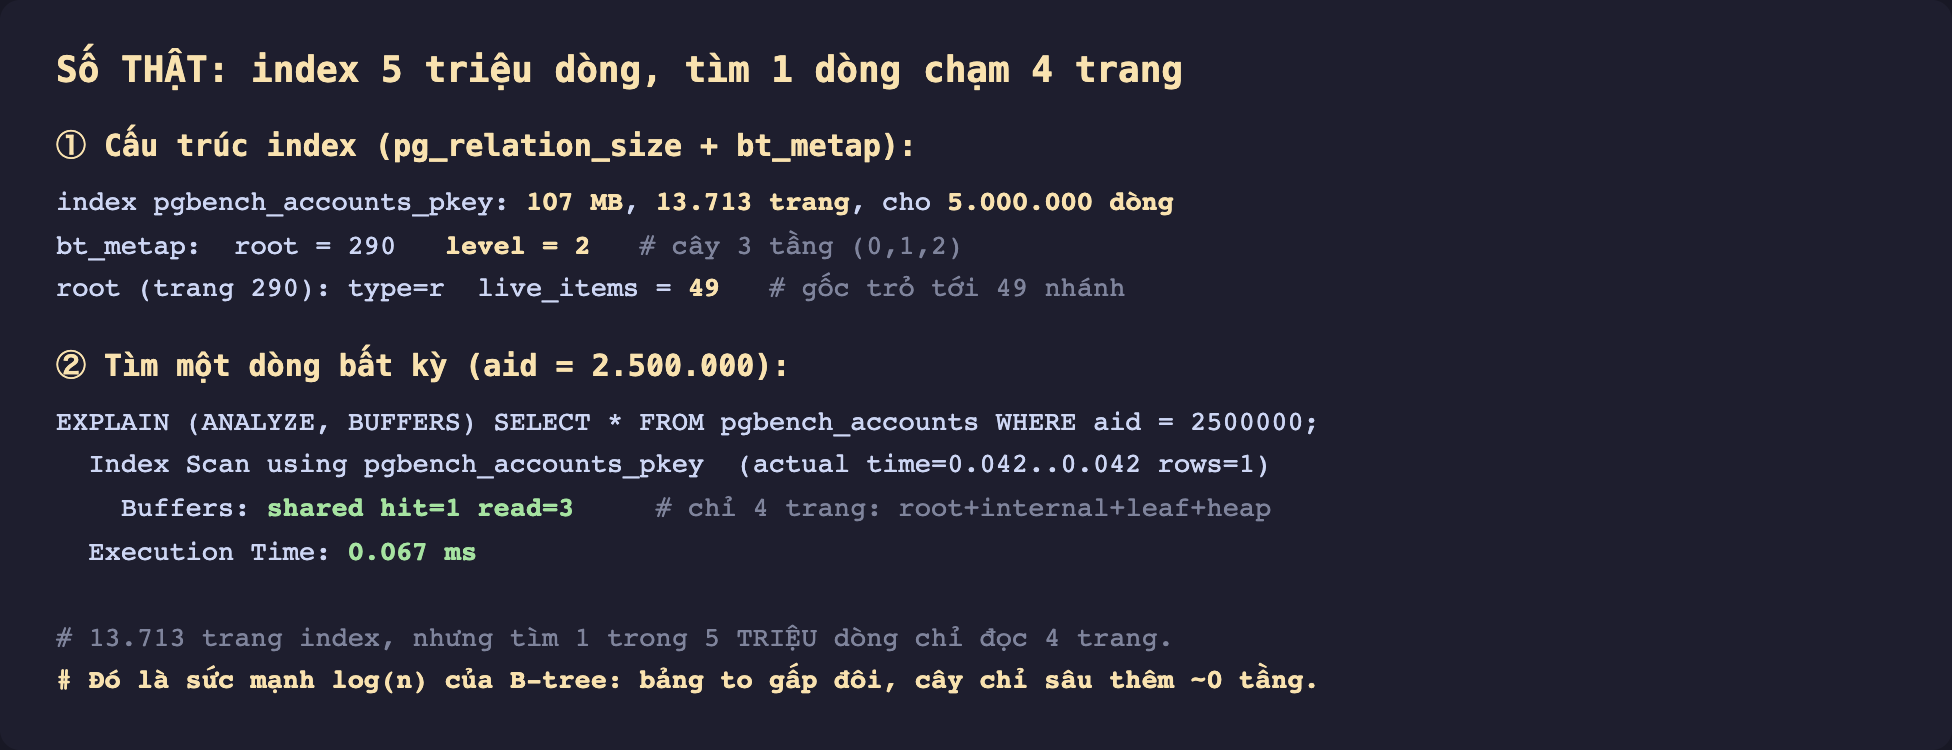
Hình 2: Thật. Index khóa chính là 107 MB, 13.713 trang cho 5 triệu dòng. bt_metap xác nhận level = 2 (cây ba tầng), gốc có 49 nhánh. Và cú chốt: tìm một dòng bất kỳ (aid = 2500000) chỉ đọc 4 trang (hit=1 read=3: gốc + nội bộ + lá + heap), mất 0,067 ms. Trong 13.713 trang, ta chạm đúng 4.
Vì sao đây là nền tảng của mọi quyết định index
Con số "4 trang cho 5 triệu dòng" giải thích gần như mọi thứ về index B-tree:
- Tìm kiếm nhanh cỡ logarit. Số trang phải đọc ≈ chiều cao cây ≈
log(số_dòng). Bảng tăng gấp đôi, cây thường không sâu thêm tầng nào (vì mỗi tầng nhân thêm hàng trăm lần). Đó là lý do index vẫn nhanh khi dữ liệu lớn lên. - Khóa được sắp xếp trong lá. Điều này khiến B-tree hỗ trợ không chỉ tìm bằng (
=) mà cả so sánh khoảng (<,>,BETWEEN) và sắp xếp (ORDER BY) — chỉ cần đi dọc các lá theo thứ tự. (Đây là lý do B-tree "đa năng" hơn hash index, ta sẽ so ở bài sau.) - Lá trỏ tới heap qua
ctid. Index không chứa dữ liệu dòng, chỉ chứa khóa + con trỏ. Nên sau khi tìm thấy trong lá, thường phải một lần đọc heap nữa để lấy dòng thật (trang thứ 4 trong ví dụ). Đây là mấu chốt của "index-only scan" — kỹ thuật tránh lần đọc heap đó, sẽ học ở bài riêng.
Vài điều đáng biết
- Fanout lớn nhờ trang 8KB. Mỗi trang chứa hàng trăm khóa (ở đây avg 15 byte/mục → ~500 mục/trang). Fanout cao là lý do cây nông:
49 × ~280 × ~366 ≈ 5 triệuchỉ với ba tầng. - Chèn giữ cây cân bằng. Khi một trang lá đầy, B-tree tách trang (page split) và có thể đẩy lên tầng trên — nên cây luôn cân bằng, mọi lá cùng độ sâu. Đổi lại, chèn/cập nhật index tốn công hơn đọc (đánh đổi ghi vs đọc, ta sẽ đo ở bài về chi phí index).
pageinspectđể soi.bt_metap()cho gốc và chiều cao;bt_page_stats()cho thống kê từng trang. Hữu ích khi học và khi chẩn đoán index phình.
Ba ý mang về
- B-tree là cây cân bằng nhiều tầng: gốc → nội bộ → lá (chứa khóa +
ctid). Tìm kiếm đi theo tầng, mỗi tầng một trang đọc. - Đã đo thật: index 5 triệu dòng (107 MB, 13.713 trang) chỉ ba tầng, tìm một dòng chạm 4 trang trong 0,067 ms — sức mạnh
log(n)khiến index vẫn nhanh khi dữ liệu lớn. - Khóa được sắp xếp trong lá nên B-tree phục vụ cả
=, so sánh khoảng, vàORDER BY; lá trỏ tới heap nên thường có thêm một lần đọc dữ liệu — nền tảng để hiểu index-only scan và mọi kỹ thuật index sau này.
Hiểu B-tree nhanh cỡ nào rồi, câu hỏi thực dụng là: khi nào nó thực sự giúp? Phần sau đo cụ thể khi nào index tăng tốc truy vấn, khi nào PostgreSQL cố tình bỏ qua nó (và làm vậy là đúng) — dựa trên độ chọn lọc và kích thước bảng.
