"Tôi đã tạo index rồi mà PostgreSQL vẫn quét cả bảng!" — có lẽ là câu than phiền phổ biến nhất về index. Nhưng phần lớn thời gian, PostgreSQL đúng: nó tính ra rằng với truy vấn đó, quét tuần tự thực sự rẻ hơn dùng index. Bài trước ta thấy B-tree tìm một dòng nhanh cỡ nào. Bài này đo khi nào sức mạnh đó thực sự phát huy — và khi nào nó phản tác dụng.
Bí mật nằm ở độ chọn lọc
Độ chọn lọc (selectivity) là tỉ lệ dòng truy vấn lấy ra. Index tỏa sáng khi bạn lấy ít dòng, và trở nên vô dụng — thậm chí có hại — khi bạn lấy nhiều. Lý do: mỗi dòng khớp qua index là một lần nhảy ngẫu nhiên vào heap để lấy dữ liệu, mà đọc ngẫu nhiên đắt gấp 4 lần đọc tuần tự (random_page_cost=4, nhớ bài cost model). Lấy quá nhiều dòng thì thà quét liền mạch cả bảng còn nhanh hơn.
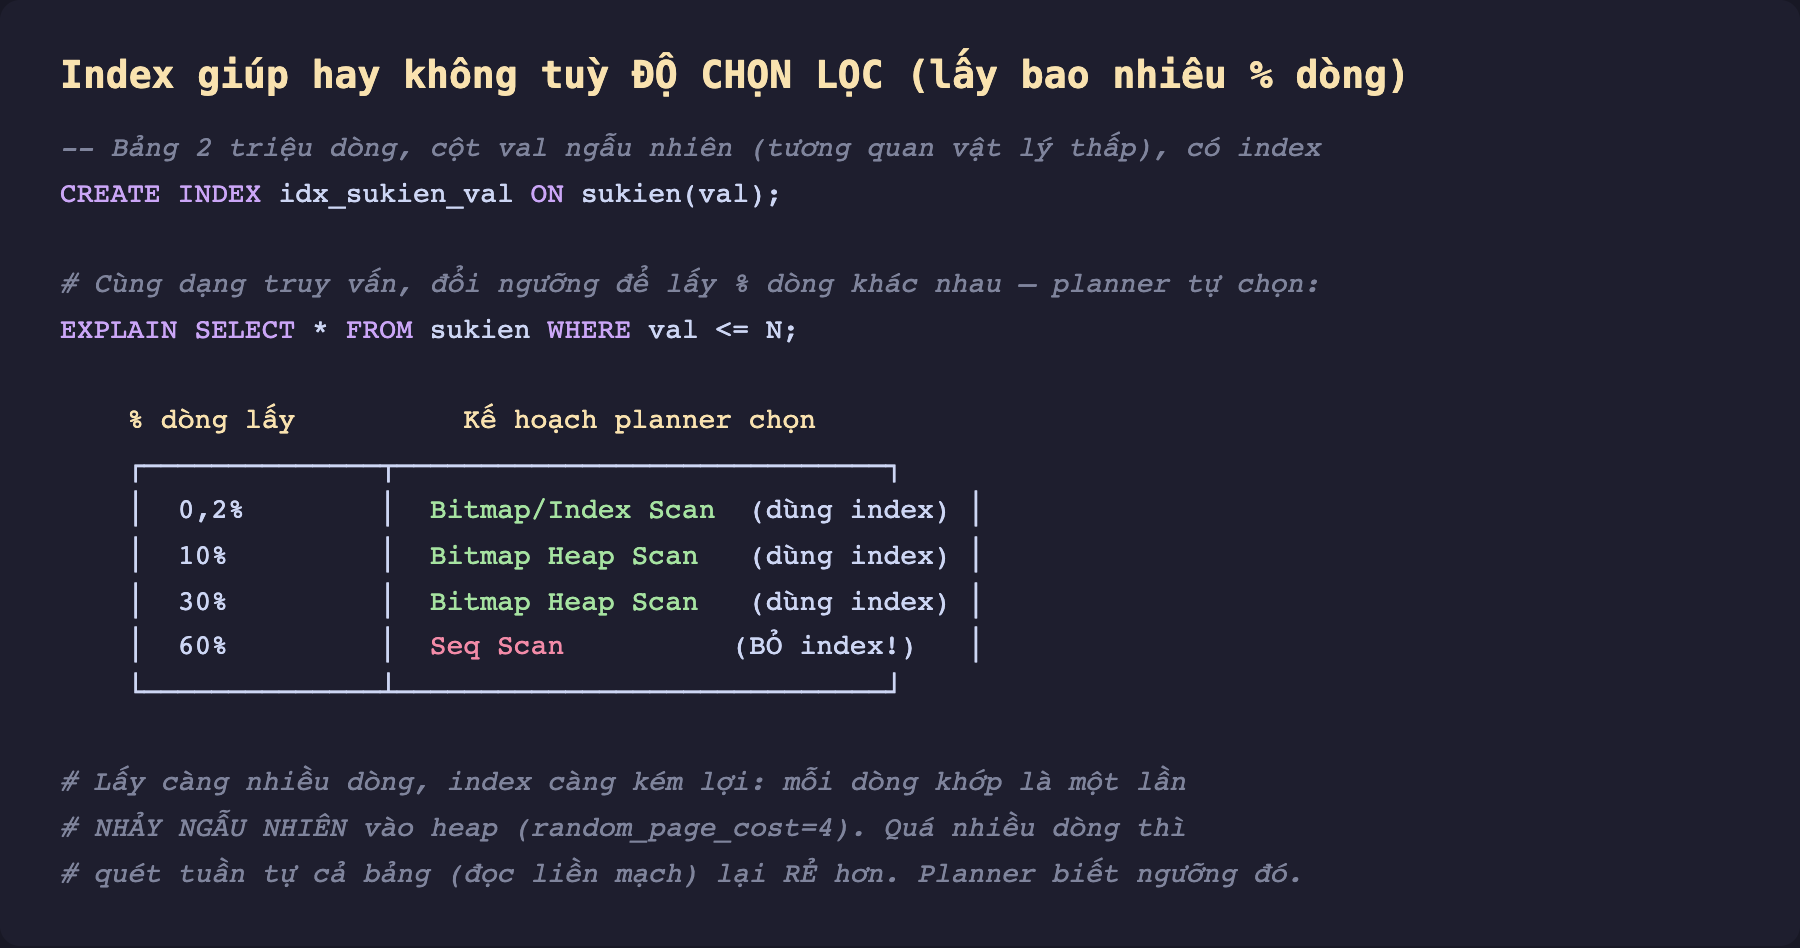
Hình 1: Cùng một dạng truy vấn WHERE val <= N trên bảng 2 triệu dòng, chỉ đổi ngưỡng N. Ở 0,2%, 10%, 30% dòng, planner dùng index (Bitmap Heap Scan). Nhưng ở 60%, nó bỏ index và quét tuần tự. Ngưỡng lật nằm đâu đó giữa 30% và 60% — không phải con số cố định, mà phụ thuộc kích thước dòng, tương quan, và cấu hình cost.
Đo thời gian: planner đúng cả hai chiều
Đừng tin lời, hãy đo. Ở mỗi chiều, mình bắt planner chạy cả cách nó chọn và cách nó từ chối:
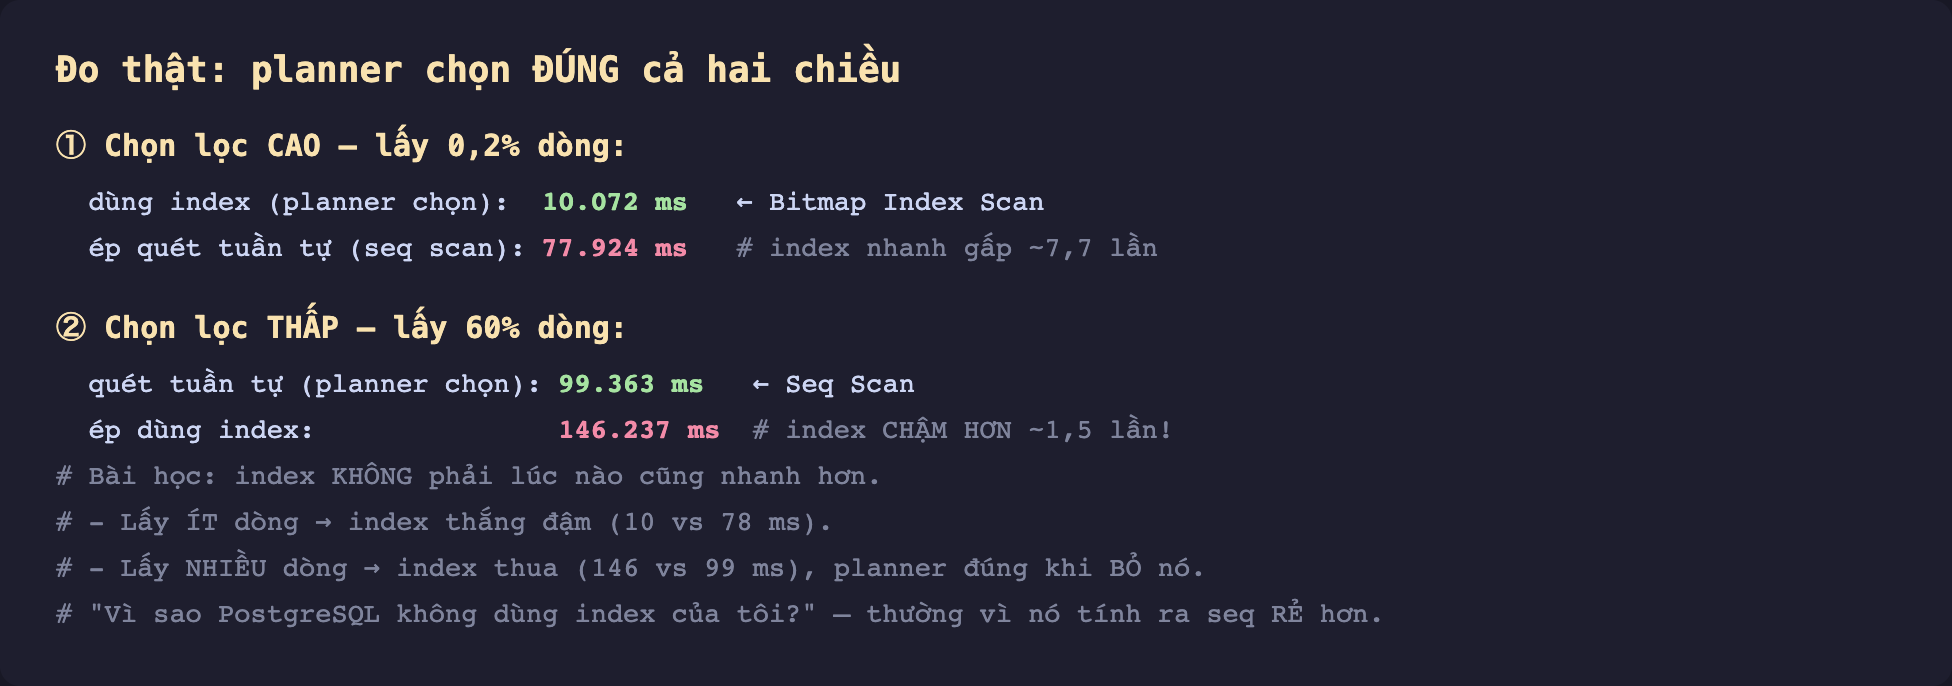
Hình 2: Thật, và dứt khoát. Chọn lọc cao (0,2%): dùng index 10 ms vs ép quét tuần tự 78 ms — index nhanh gấp ~7,7 lần, planner đúng khi dùng nó. Chọn lọc thấp (60%): quét tuần tự 99 ms vs ép dùng index 146 ms — index chậm hơn ~1,5 lần, planner đúng khi bỏ nó. Con dao hai lưỡi: index không phải lúc nào cũng nhanh hơn.
Vậy khi nào index thực sự giúp?
- Truy vấn chọn lọc cao —
WHEREtrên cột lọc ra ít dòng (=trên khóa/mã, khoảng hẹp). Đây là ca vàng của index. JOIN— dò từng dòng bảng này vào bảng kia qua index (Nested Loop) rất hiệu quả khi mỗi lần dò lấy ít dòng.ORDER BY/LIMIT— index đã sắp sẵn, PostgreSQL lấy top-N mà không cần sort cả bảng.- Ràng buộc duy nhất — index cưỡng chế
UNIQUE.
Và khi nào index không giúp (đừng đánh, hoặc đừng ngạc nhiên khi planner bỏ):
- Truy vấn lấy phần lớn bảng — như 60% ở trên; quét tuần tự thắng.
- Bảng quá nhỏ — vài trăm dòng nằm gọn trong một hai trang; đọc thẳng nhanh hơn đi qua index.
- Cột độ chọn lọc thấp — ví dụ cột
gioi_tinhchỉ 2 giá trị: mọi truy vấn lấy ~50% bảng, index gần như vô dụng (trừ khi kết hợp partial index, bài sau).
Nếu bạn tin planner sai
Đôi khi planner thật sự chọn nhầm — gần như luôn vì ước lượng dòng sai (nhớ bài EXPLAIN ANALYZE: rows ước lượng lệch rows thực tế). Trước khi đổ lỗi cho index:
- Chạy
ANALYZEđể cập nhật thống kê — nguyên nhân số một của lựa chọn tồi. - So
rowsước lượng vs thực tế trongEXPLAIN ANALYZE. Lệch nhiều → sửa thống kê (tăngdefault_statistics_target, hoặc extended statistics cho cột tương quan). - Kiểm cấu hình cost —
random_page_cost=4là cho HDD; trên SSD hạ xuống ~1.1 khiến planner mạnh dạn dùng index hơn (bài cấu hình I/O).
Tắt enable_seqscan để ép chỉ nên dùng khi gỡ lỗi (như mình làm ở trên để đo), tuyệt đối không để trong production — nó bóp méo mọi truy vấn.
Ba ý mang về
- Index giúp khi truy vấn chọn lọc cao, hại khi lấy nhiều dòng. Đo thật: 0,2% dòng thì index 10 ms vs seq 78 ms; 60% dòng thì seq 99 ms vs index 146 ms. Ngưỡng lật phụ thuộc dữ liệu và cost.
- "PostgreSQL không dùng index của tôi" thường là planner đúng — nó tính ra quét tuần tự rẻ hơn vì đọc ngẫu nhiên qua index đắt gấp 4 lần đọc tuần tự.
- Khi nghi planner sai: chạy
ANALYZE, sorowsước lượng vs thực tế, kiểmrandom_page_cost. Đừng đánh index cho cột chọn lọc thấp hay bảng quá nhỏ.
Biết khi nào index giúp rồi, giờ tới cách đánh index cho hiệu quả. Phần sau đào index nhiều cột — vì sao thứ tự cột trong index quyết định nó dùng được cho truy vấn nào, và quy tắc "cột trái nhất" mà bỏ qua là đánh index xong vẫn vô dụng.
