Bạn có một truy vấn lọc theo khach_id và ngay, nên bạn tạo index trên cả hai cột: (khach_id, ngay). Hợp lý. Nhưng rồi một truy vấn khác lọc chỉ theo ngay lại chậm ê chề, dù ngay có trong index. Vì sao? Câu trả lời là điều quan trọng nhất về index nhiều cột mà nhiều người bỏ qua: thứ tự cột quyết định index dùng được cho truy vấn nào.
Nghĩ về index nhiều cột như một cuốn danh bạ
Cách dễ nhất để hiểu: index (khach_id, ngay) giống một cuốn danh bạ điện thoại sắp theo Họ trước, rồi Tên. Nó sắp khach_id trước; trong mỗi khach_id mới sắp theo ngay.
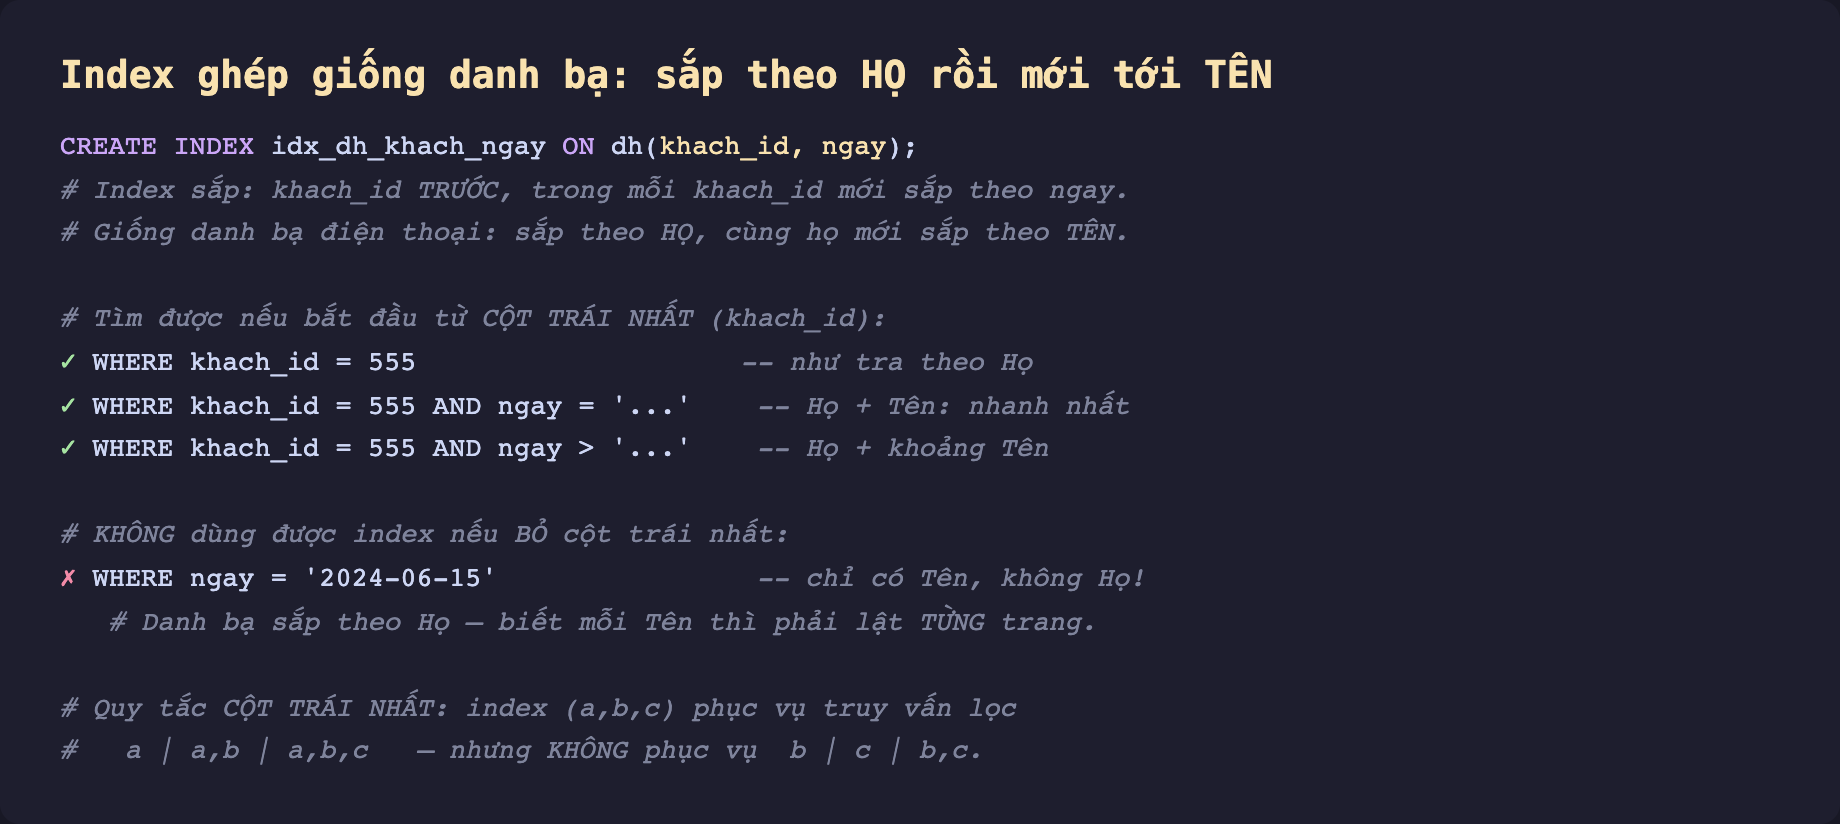
Hình 1: Quy tắc cột trái nhất (leftmost prefix). Bạn tra được nếu bắt đầu từ cột trái nhất của index: chỉ khach_id, hoặc khach_id + ngay, hoặc khach_id + khoảng ngay. Nhưng nếu bỏ cột trái nhất và chỉ lọc ngay — như biết mỗi Tên trong cuốn danh bạ sắp theo Họ — index vô dụng, phải lật từng trang.
Đo thật: 0,033 ms hay 109 ms
Trên bảng 3 triệu đơn hàng với index (khach_id, ngay), chạy ba truy vấn:
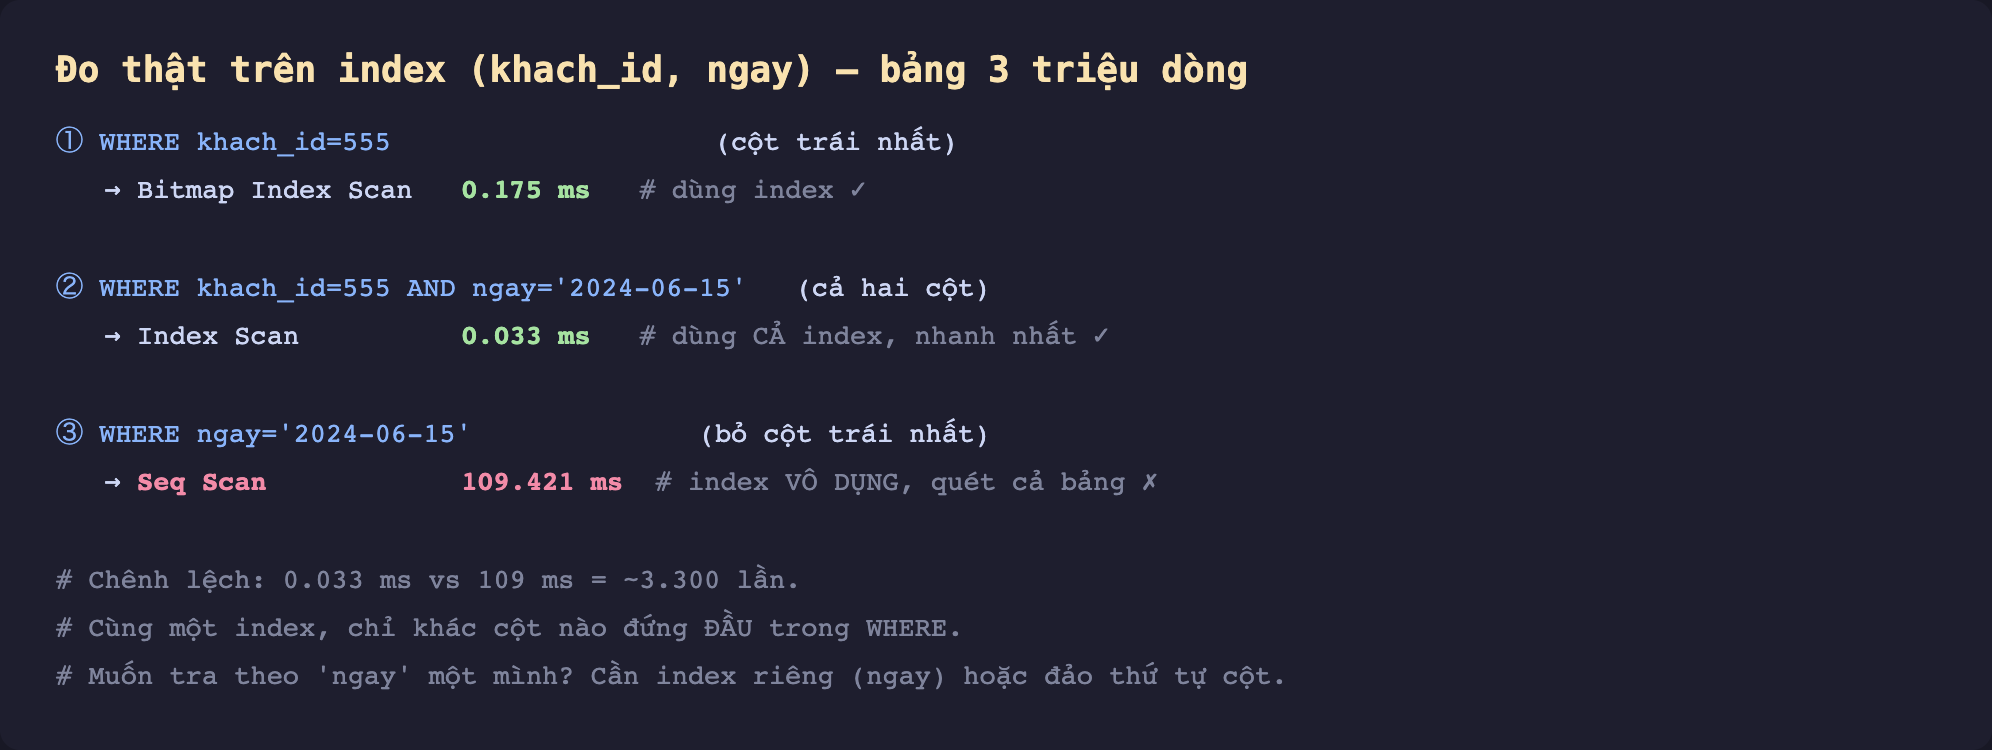
Hình 2: Thật. ① Lọc khach_id (cột trái nhất): Bitmap Index Scan, 0,175 ms. ② Lọc cả khach_id AND ngay: Index Scan dùng trọn index, 0,033 ms — nhanh nhất. ③ Lọc chỉ ngay (bỏ cột trái nhất): Seq Scan, 109 ms — index hoàn toàn vô dụng. Cùng một index, chỉ khác cột nào đứng đầu WHERE, chênh nhau ~3.300 lần.
Chọn thứ tự cột thế nào
Quy tắc thực dụng khi thiết kế index nhiều cột:
- Cột lọc bằng (
=) đặt trước, cột lọc khoảng (<,>,BETWEEN) đặt sau. Index đi hiệu quả tới cột khoảng đầu tiên rồi dừng "định vị"; các cột sau cột khoảng chỉ dùng để lọc thêm, không định vị. Ví dụ lọckhach_id = ? AND ngay BETWEEN ? AND ?thì(khach_id, ngay)là đúng. - Cột dùng trong nhiều truy vấn nhất đặt trước. Vì index phục vụ mọi tiền tố trái, đặt cột "phổ biến" ở đầu cho một index dùng được cho nhiều truy vấn.
- Cân nhắc độ chọn lọc. Thường đặt cột chọn lọc cao (nhiều giá trị khác nhau) trước để lọc nhanh — nhưng quy tắc "cột hay dùng ở đầu" thường quan trọng hơn.
Vài lưu ý quan trọng
- Một index
(a, b)thay được cho index(a)— vì mọi truy vấn dùng được index(a)cũng dùng được(a, b)(tiền tố trái). Nên đừng tạo cả hai; giữ(a, b)là đủ cho truy vấn lọcalẫna, b. (Đánh đổi: index(a, b)to hơn(a)một chút.) - Nhưng
(a, b)KHÔNG thay được(b). Nếu bạn thật sự cần tra theobmột mình, phải có index riêng chob, hoặc đảo thứ tự thành(b, a)nếublà cột hay lọc hơn. - Cột thứ hai vẫn giúp ngay cả khi chỉ lọc cột đầu — nó cho phép index-only scan nếu truy vấn chỉ cần các cột có trong index (chủ đề bài sau).
- Thứ tự trong
WHEREkhông quan trọng, thứ tự trong INDEX mới quan trọng.WHERE ngay=? AND khach_id=?vẫn dùng được index(khach_id, ngay)— planner tự sắp lại điều kiện. Cái quyết định là thứ tự cột lúcCREATE INDEX.
Ba ý mang về
- Index nhiều cột chỉ phục vụ truy vấn bắt đầu từ cột trái nhất (quy tắc leftmost prefix): index
(a, b, c)dùng được choa,a,b,a,b,c— nhưng không chob,c,b,c. - Đo thật cho thấy chênh 3.300 lần: cùng index
(khach_id, ngay), lọckhach_id AND ngaylà 0,033 ms, còn lọc chỉngaylà 109 ms (Seq Scan) vì bỏ mất cột trái nhất. - Chọn thứ tự cột: cột
=trước, cột khoảng sau; cột hay dùng ở đầu.(a, b)thay được(a)nhưng không thay được(b).
Ta đã tối ưu cách dùng index. Bài sau chạm tới một kỹ thuật khiến index còn nhanh hơn nữa: bỏ hẳn bước đọc heap. Phần sau nói về index-only scan và covering index — khi PostgreSQL trả kết quả chỉ từ index, không thèm chạm bảng, và cách dùng INCLUDE để đạt điều đó.
