Observability lý tưởng là ghi mọi thứ: mọi request một trace đầy đủ, mọi sự kiện một dòng log. Nhưng lý tưởng đó va vào thực tế phũ phàng — một dịch vụ lớn xử lý hàng triệu, hàng tỷ request mỗi ngày, và lưu trọn trace/log cho từng cái là khối dữ liệu khổng lồ: tốn tiền lưu trữ khủng khiếp, tốn băng thông gửi đi, và làm chậm chính ứng dụng. Ở quy mô đó, sampling — chỉ giữ một phần dữ liệu — không phải lựa chọn mà là bắt buộc.
Câu hỏi khó không phải "có sample không" mà là "sample thế nào". Cách ngây thơ nhất — giữ ngẫu nhiên p% — nghe hợp lý nhưng có một khiếm khuyết chí mạng: nó bỏ sót đúng thứ bạn cần nhất. Vì trong observability, cái đáng xem nhất là các trace lỗi và chậm — mà chúng lại hiếm. Giữ ngẫu nhiên 1% nghĩa là bạn chỉ thấy 1% số lỗi. Bài này (phần 11 loạt Observability) đo thật khiếm khuyết đó và một chiến lược sampling thông minh hơn hẳn.
Cơ chế: head sampling vs error-biased (tail)
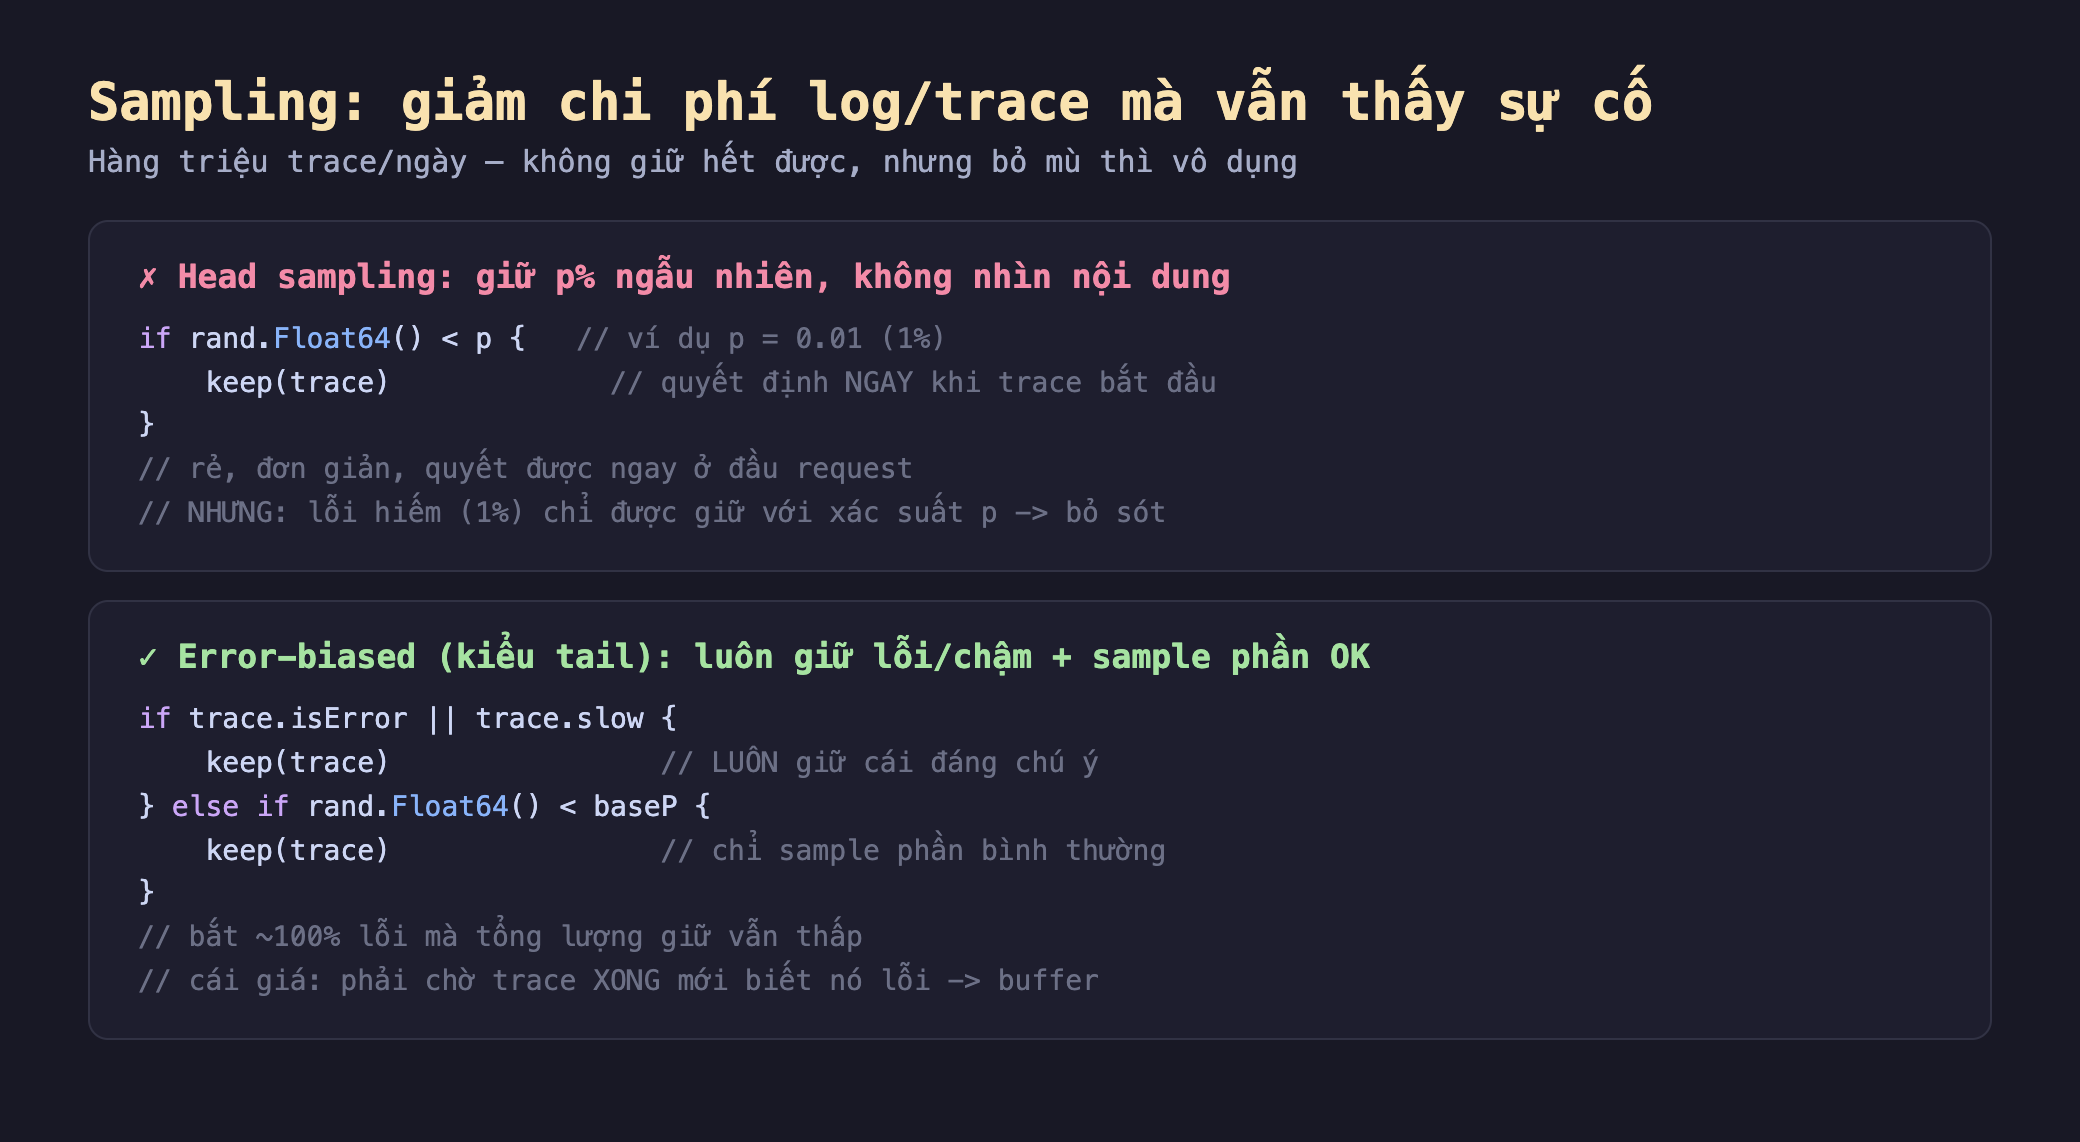
Hình 1: Head sampling quyết định giữ/bỏ ngay đầu request theo xác suất p — rẻ, đơn giản, nhưng lỗi hiếm chỉ được giữ với xác suất p nên bị bỏ sót. Error-biased (kiểu tail) luôn giữ trace lỗi/chậm và chỉ sample phần bình thường — bắt gần 100% lỗi mà tổng lượng vẫn thấp, đổi lại phải chờ trace xong mới biết nó lỗi (cần buffer).
Khác biệt cốt lõi nằm ở khi nào và dựa vào gì để quyết định:
- Head sampling: quyết định ngay khi request bắt đầu, dựa vào một đồng xu ngẫu nhiên. Không biết trace sẽ lỗi hay không — vì nó chưa xảy ra. Rẻ và đơn giản.
- Tail / error-biased: quyết định sau khi trace kết thúc, dựa vào nội dung — nó có lỗi không, có chậm không. Giữ hết cái đáng chú ý, sample thưa phần bình thường.
Đo thật trong go-lab
Mình tạo trong go-lab (golang 1.23) 100.000 trace giả với phân phối thực tế: 1% lỗi, 2% chậm. Rồi áp ba chiến lược và đếm: giữ bao nhiêu trace, bắt được bao nhiêu lỗi.
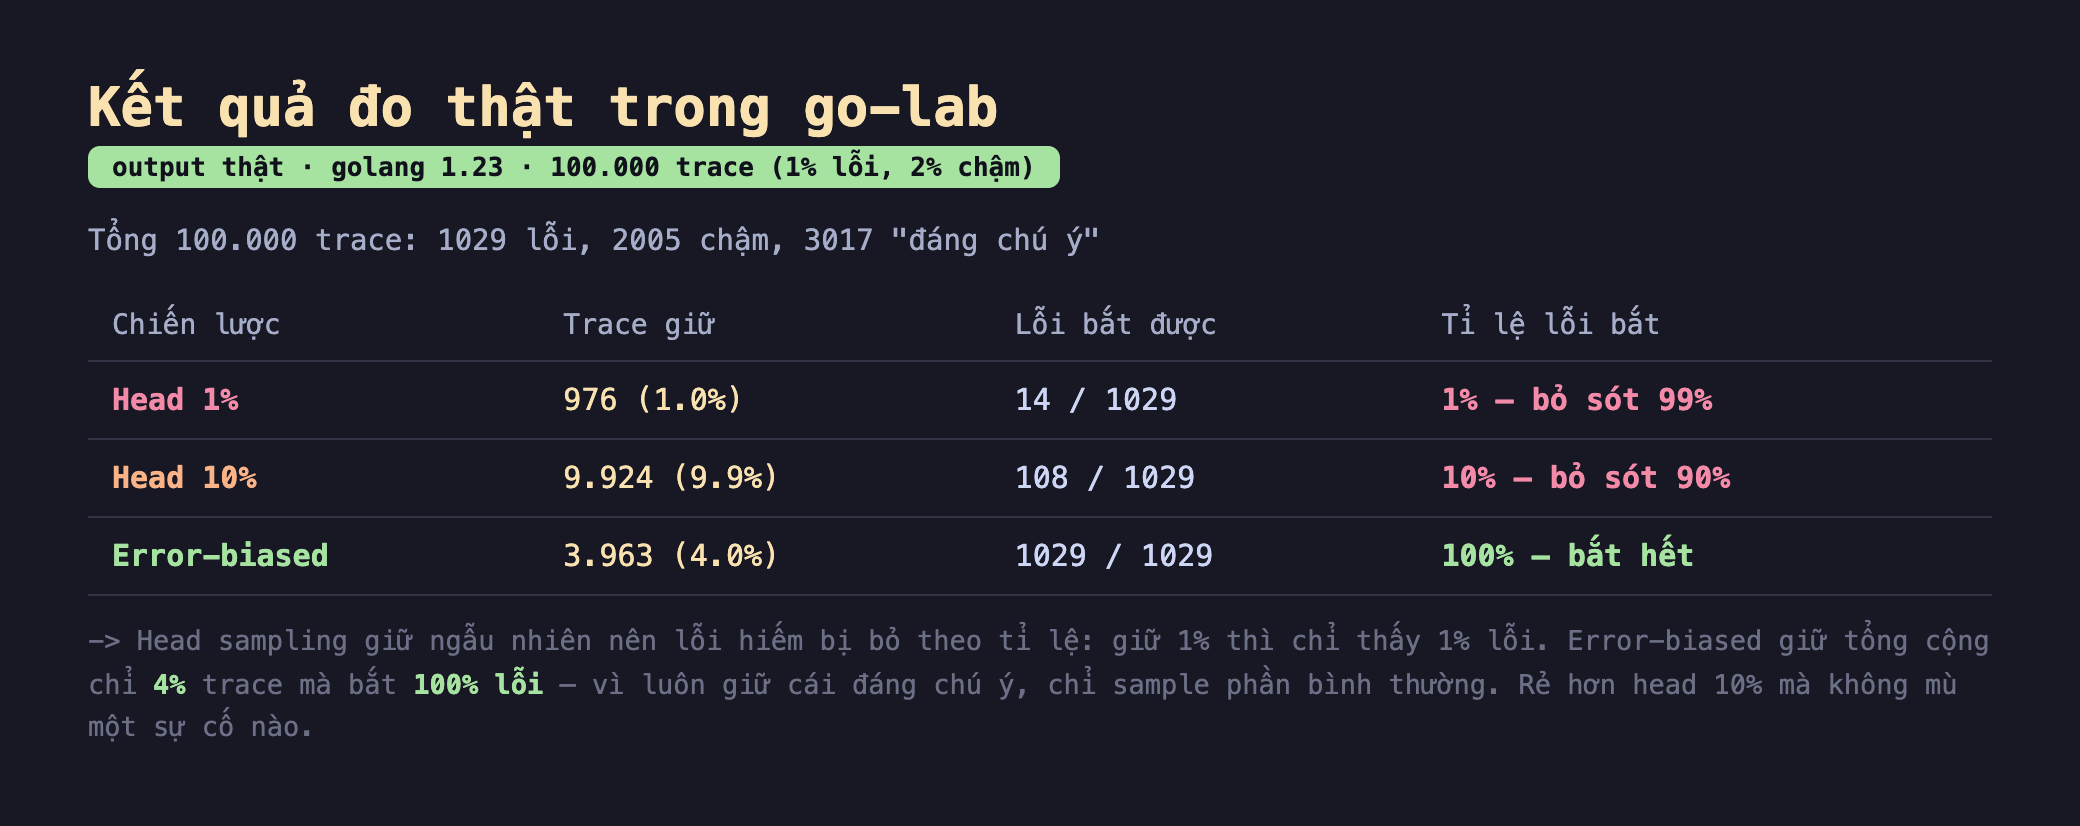
Hình 2: Kết quả thật — Head 1%: giữ 976 trace nhưng chỉ bắt 14/1029 lỗi (bỏ sót 99%); Head 10%: bắt 108/1029 (bỏ sót 90%); Error-biased: giữ tổng cộng chỉ 3.963 (4%) mà bắt 1029/1029 lỗi = 100%.
Con số phơi bày khiếm khuyết và lời giải:
- Head sampling bỏ sót lỗi đúng theo tỉ lệ giữ. Giữ 1% ngẫu nhiên → chỉ bắt 14/1029 lỗi (1%). Giữ 10% → bắt 108/1029 (10%). Đây là hệ quả toán học không thể tránh: nếu giữ ngẫu nhiên p%, bạn thấy p% mọi thứ, gồm cả p% số lỗi. Với head sampling 1% — cấu hình rất phổ biến để tiết kiệm — bạn mù 99% sự cố. Đúng lúc điều tra một lỗi cụ thể, khả năng cao trace của nó đã bị vứt.
- Error-biased bắt trọn lỗi với chi phí thấp. Bằng cách luôn giữ trace lỗi/chậm và chỉ sample 1% phần bình thường, chiến lược này giữ tổng cộng chỉ 4% trace (3.963 cái) mà bắt 100% lỗi (1029/1029). So sánh trực tiếp: nó rẻ hơn head 10% (giữ 4% vs 9.9%) và bắt lỗi tốt hơn vô cùng (100% vs 10%). Không có đánh đổi ở đây — nó thắng cả hai chiều, vì nó nhìn vào cái đáng giá thay vì tung đồng xu mù.
Đánh đổi cần cân nhắc
Tail sampling bắt lỗi tốt nhưng phải buffer — đó là cái giá thật. Điểm yếu của error-biased/tail sampling: để quyết định "trace này có lỗi không", bạn phải chờ trace kết thúc. Nghĩa là phải giữ (buffer) toàn bộ span của trace trong bộ nhớ cho tới khi request xong, rồi mới quyết định giữ hay bỏ. Với trace ngắn thì ổn, nhưng với trace dài (hoặc phân tán qua nhiều service, mỗi service sinh span vào thời điểm khác nhau), việc buffer này tốn RAM và phức tạp — thường cần một tầng thu thập riêng (collector) gom span rồi mới lấy mẫu. Head sampling không có vấn đề này vì quyết ngay từ đầu. Đây là đánh đổi kinh điển: đơn giản+rẻ (head) vs chính xác+phức tạp (tail).
Consistent sampling để trace không đứt xuyên service. Trong hệ phân tán, một request đi qua nhiều service, mỗi service tự quyết sample. Nếu chúng quyết độc lập ngẫu nhiên, service A giữ span của nó còn service B vứt span của mình → bạn có trace đứt đoạn, vô dụng. Lời giải là consistent sampling: quyết định giữ/bỏ dựa trên chính trace_id (ví dụ hash trace_id rồi so ngưỡng) — mọi service thấy cùng trace_id sẽ ra cùng quyết định, nên hoặc giữ toàn bộ trace hoặc bỏ toàn bộ, không bao giờ đứt. Đây là lý do trace_id (phần 2) lại quan trọng: nó không chỉ để nối, mà còn để sample nhất quán.
Metric KHÔNG sample — chỉ log/trace sample. Một hiểu lầm nguy hiểm là đem sampling áp cho metric. Đừng. Metric (counter, histogram) đã là dữ liệu tổng hợp — request_total là tổng mọi request, nếu bạn chỉ đếm 1% rồi nhân 100 thì sai số lớn và mất chính xác, nhất là với sự kiện hiếm (lỗi). Metric rẻ sẵn (vài chuỗi số, như phần 3-5) nên không cần sample. Sampling chỉ dành cho log và trace — dữ liệu chi tiết per-event mới đắt. Nhớ ranh giới: đếm thì đếm hết (metric), chi tiết thì lấy mẫu (log/trace).
Ba ý mang về
- Head sampling ngẫu nhiên bỏ sót lỗi đúng theo tỉ lệ giữ: đo thật, giữ 1% thì chỉ bắt 14/1029 lỗi (bỏ sót 99%), giữ 10% bắt 108/1029 (bỏ sót 90%) — vì lỗi hiếm chỉ được giữ với xác suất p, đúng lúc điều tra sự cố thì trace đã bị vứt.
- Error-biased (tail) bắt trọn lỗi với chi phí thấp hơn: đo thật, luôn giữ trace lỗi/chậm + sample 1% phần bình thường → giữ tổng cộng chỉ 4% mà bắt 100% lỗi (1029/1029) — rẻ hơn head 10% và không mù một sự cố nào, vì nhìn vào nội dung thay vì tung đồng xu.
- Cái giá là buffer, và biết ranh giới: tail sampling phải giữ toàn trace tới khi xong mới quyết (tốn RAM, cần collector); dùng consistent sampling theo trace_id để trace không đứt xuyên service; và metric KHÔNG sample (đã tổng hợp, rẻ) — chỉ log/trace mới sample.
Nguồn
- OpenTelemetry — Sampling (head vs tail): https://opentelemetry.io/docs/concepts/sampling/
- Honeycomb — Sampling strategies for observability: https://docs.honeycomb.io/manage-data-volume/sample/
- W3C — Trace Context (trace_id cho consistent sampling): https://www.w3.org/TR/trace-context/
Phần sau là bài tổng kết cả loạt: ghép ba trụ cột log + metric + trace để chẩn đoán một sự cố từ đầu tới cuối, kèm một cây quyết định "gặp triệu chứng X thì nhìn trụ cột nào".
