Mười một phần trước của loạt Observability đi qua từng công cụ một: structured logging với slog, log correlation qua trace_id, metric với expvar và Prometheus, histogram và percentile, RED/USE, distributed tracing, pprof, runtime/metrics, cardinality, sampling. Nhưng người kỹ sư đứng trước một sự cố production lúc 3 giờ sáng không dùng từng cái rời rạc — họ dùng chúng nối tiếp, mỗi công cụ trả lời một câu hỏi rồi dẫn tới công cụ kế. Bài cuối này (phần 12) ghép tất cả lại thành một quy trình chẩn đoán mạch lạc.
Chìa khoá là hiểu ba trụ cột của observability không phải ba lựa chọn thay thế nhau, mà là ba lớp trả lời ba câu hỏi khác nhau: metric — "có vấn đề không, tổng thể thế nào?"; trace — "chậm/lỗi ở chặng nào của một request?"; log — "điều gì đã xảy ra trong chặng đó?". Không có cái nào thay được cái nào, và một cuộc điều tra tốt đi qua cả ba theo đúng thứ tự đó. Bài này đo thật một sự cố đi trọn hành trình đó.
Cơ chế: ba trụ cột và cây quyết định
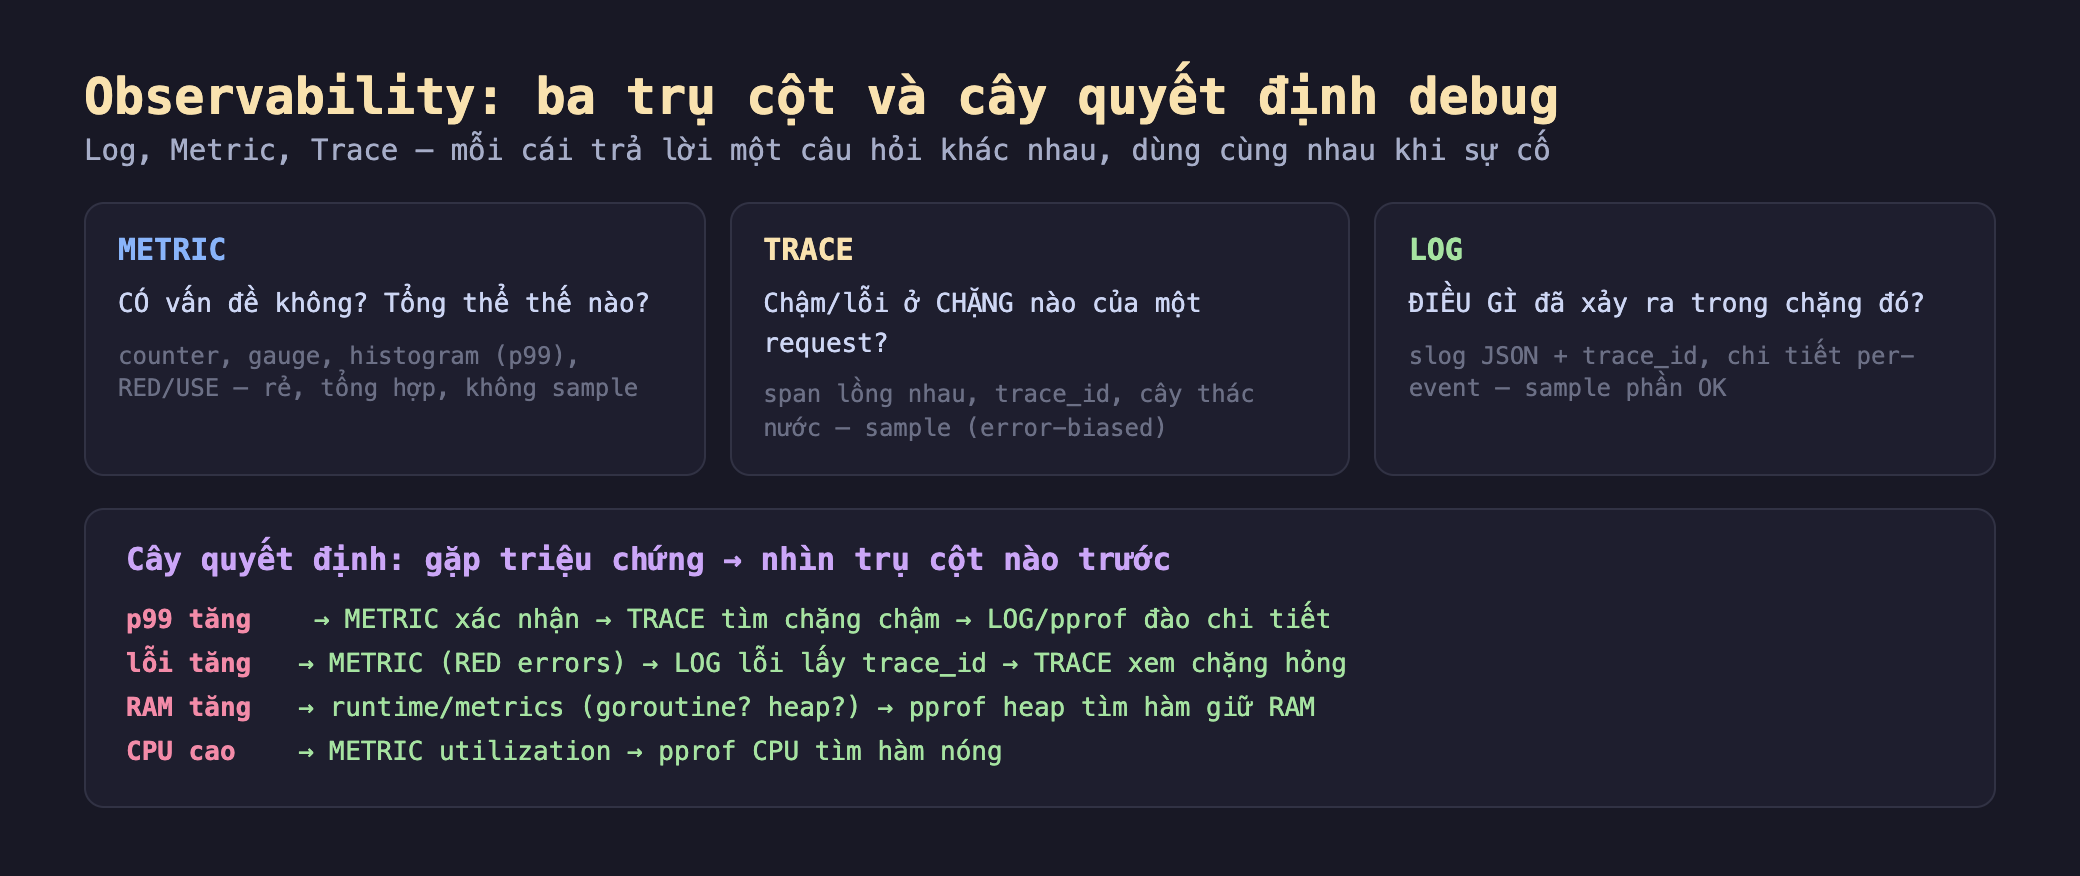
Hình 1: Ba trụ cột — metric (có vấn đề không?), trace (chặng nào?), log (điều gì?) — và cây quyết định: mỗi triệu chứng dẫn tới một chuỗi trụ cột. p99 tăng → metric → trace → log/pprof; lỗi tăng → metric → log → trace; RAM tăng → runtime/metrics → pprof heap; CPU cao → metric → pprof CPU.
Cây quyết định là thứ đáng in ra dán lên tường. Điểm chung: metric luôn là điểm khởi đầu (nó rẻ, tổng hợp, luôn bật, cho biết có chuyện gì), rồi tuỳ triệu chứng mà đi tiếp tới trace (khoanh vùng theo request) hay pprof (khoanh vùng theo hàm), và log là nơi đào chi tiết cuối cùng.
Đo thật trong go-lab: một sự cố qua ba trụ cột
Mình dựng trong go-lab (golang 1.23) một handler nhỏ gọi dbQuery, được trang bị cả ba trụ cột cùng lúc: ghi metric (counter + latency), tạo span (trace) truyền trace_id, và log JSON có trace_id. dbQuery cố ý 5% chậm (120ms) và 3% lỗi. Tung 2000 request rồi chẩn đoán đúng như khi có sự cố thật.
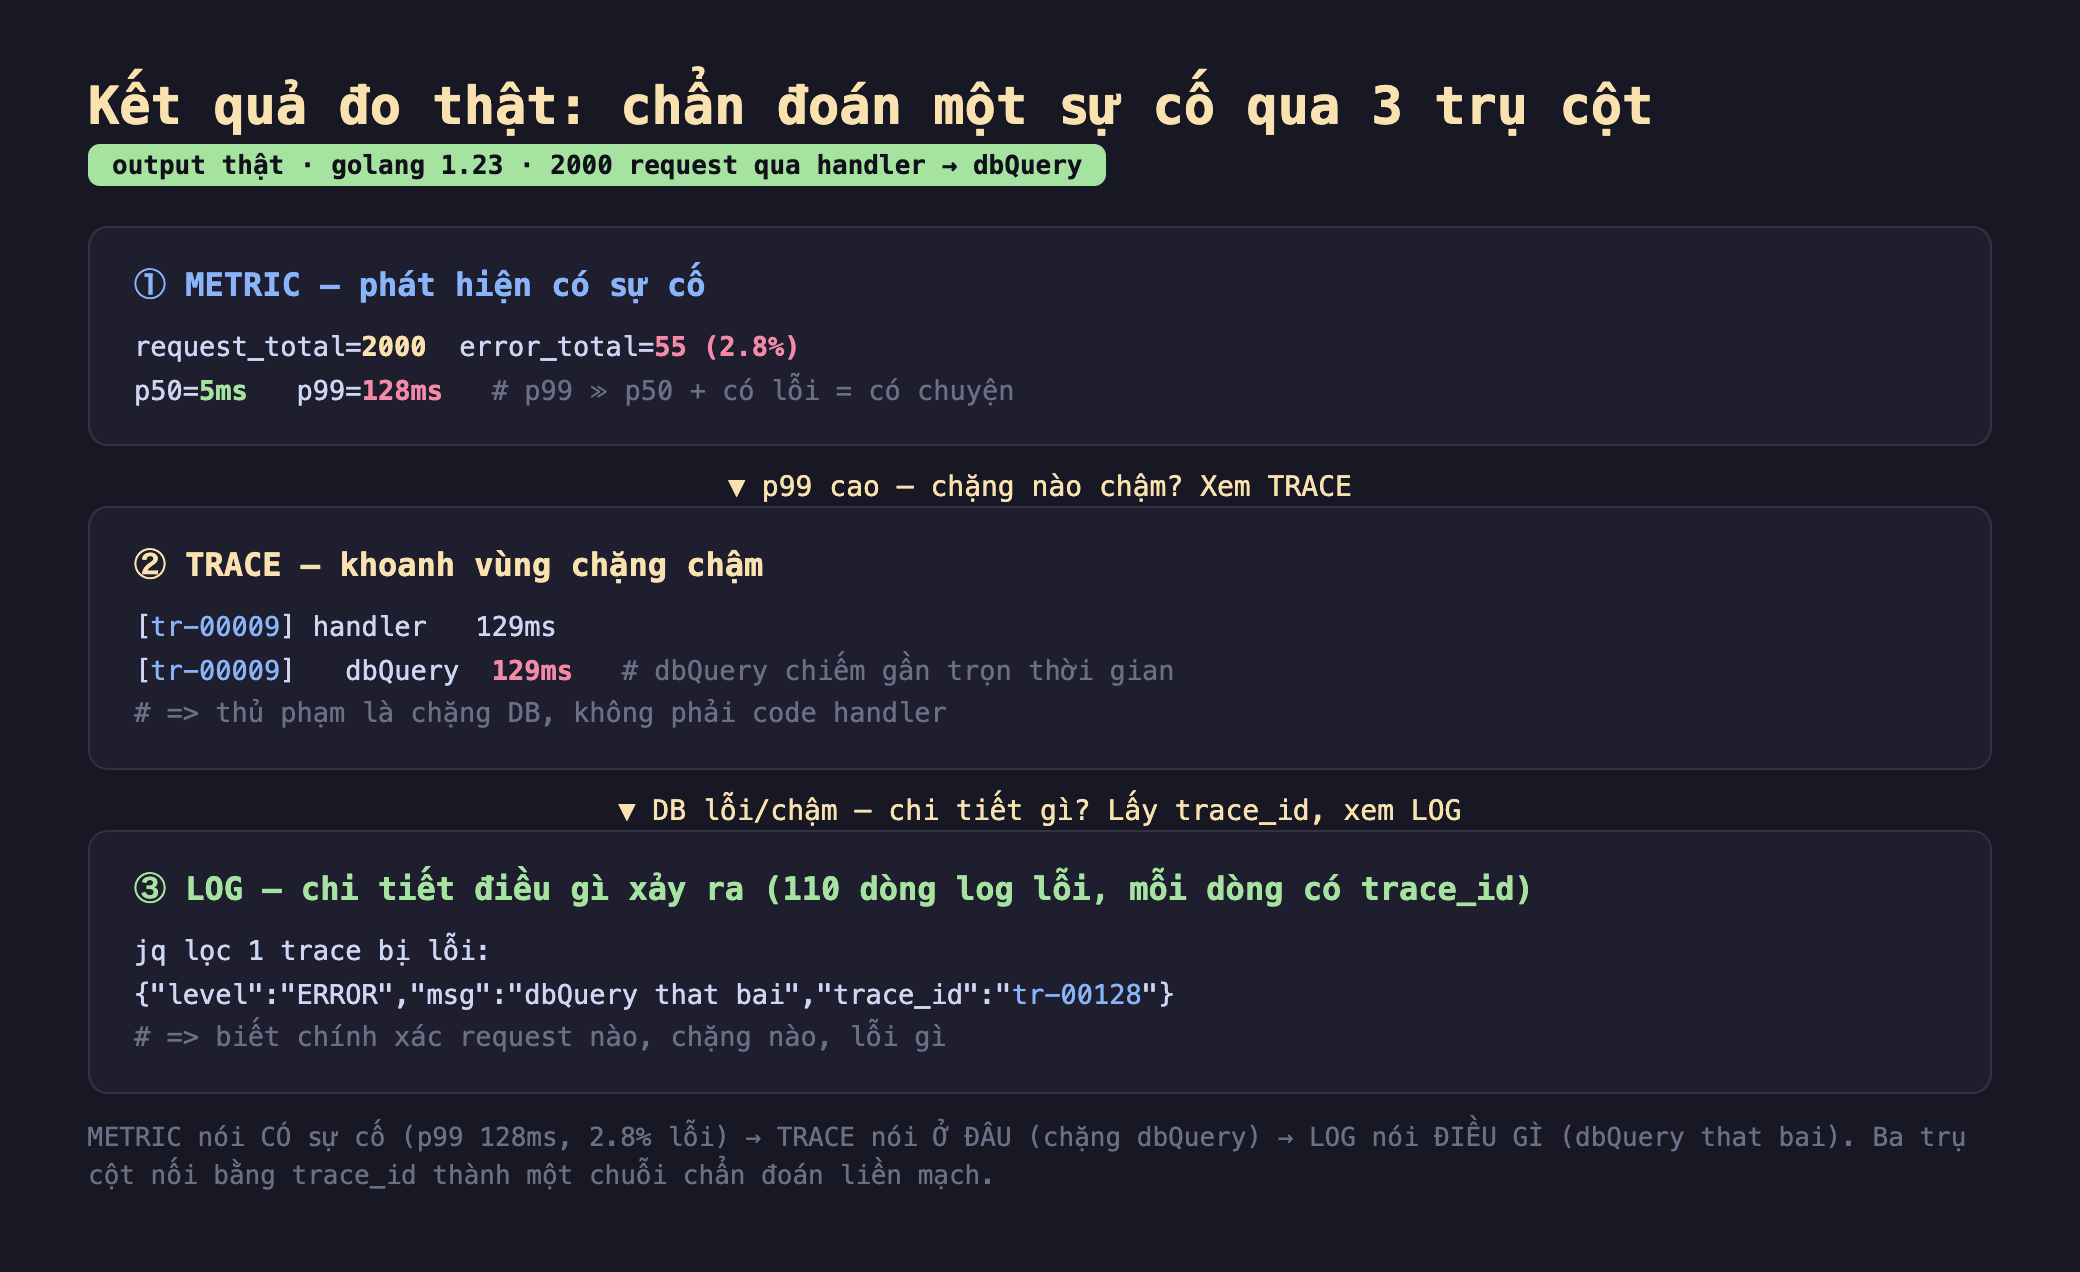
Hình 2: Kết quả thật — ① METRIC: 2000 request, 55 lỗi (2.8%), p50=5ms nhưng p99=128ms (có sự cố); ② TRACE: trace tr-00009 cho thấy dbQuery 129ms chiếm gần trọn handler 129ms (thủ phạm là DB); ③ LOG: 110 dòng log lỗi, lọc một trace_id ra chính xác dbQuery that bai.
Đây là quy trình chẩn đoán thật, từng bước một:
- ① METRIC phát hiện sự cố. Nhìn dashboard: p50 chỉ 5ms (đa số request nhanh) nhưng p99 lên 128ms, và tỉ lệ lỗi 2.8%. Hai tín hiệu này — p99 lệch xa p50 (như bài histogram phần 4) và error rate khác 0 (như RED phần 6) — nói rằng có sự cố, nhưng chưa nói ở đâu. Metric là radar: nó báo có mục tiêu, không nói mục tiêu là gì.
- ② TRACE khoanh vùng chặng. Lấy một trace chậm (tr-00009), xem cây span:
handler129ms, trong đódbQuerychiếm 129ms — gần như toàn bộ. Ngay lập tức biết thủ phạm là chặng database, không phải code trong handler. Không phải đoán, không phải rải log khắp nơi — trace chỉ thẳng chặng cần điều tra (như phần 7). - ③ LOG đào chi tiết. Giờ biết là dbQuery, lấy trace_id từ log lỗi và lọc:
{"level":"ERROR","msg":"dbQuery that bai","trace_id":"tr-00128"}. Log cho biết chính xác điều gì xảy ra — lỗi gì, ở request nào. Nhờ trace_id gắn xuyên suốt (phần 2), ba trụ cột nối liền: từ một con số p99 trên dashboard, lần được tới đúng dòng log của đúng request hỏng.
Đây là điều không trụ cột nào làm một mình: metric không biết chặng nào, trace không biết chi tiết lỗi, log một mình thì chìm trong hàng triệu dòng. Ghép lại, chúng thành một sợi dây dẫn từ "có gì đó sai" tới "đây chính xác là cái sai".
Cả loạt Observability dạy gì
Nhìn lại 12 phần, vài sợi chỉ xuyên suốt:
- Ba trụ cột bổ sung, không thay thế — và trace_id nối chúng. Metric để phát hiện và cảnh báo, trace để khoanh vùng, log để đào chi tiết.
trace_id(phần 2) là sợi chỉ chạy qua cả ba, biến chúng từ ba kho dữ liệu rời rạc thành một hệ thống chẩn đoán liền mạch. - Đo cái đúng, đừng đo tất cả. RED/USE (phần 6) chọn metric có kỷ luật; cardinality (phần 10) và sampling (phần 11) là hai mặt của cùng bài toán chi phí — observability không phải "ghi càng nhiều càng tốt" mà là "ghi đúng cái trả lời được câu hỏi lúc sự cố, với chi phí kham được".
- Trung bình nói dối, percentile nói thật. Bài học lặp lại nhiều lần: p99 (phần 4) mới phản ánh trải nghiệm tệ nhất; GC pause (phần 9) là thủ phạm giấu mặt sau p99; mean che giấu cả hai.
- Đo thật, đừng đoán. Từ pprof (phần 8) "đừng đoán hàm nào chậm, đo" tới toàn bộ tinh thần loạt bài: mọi con số trong 12 phần đều đo thật trong container, và nhiều kết quả đi ngược trực giác (log chuỗi nhanh hơn slog, histogram sai số tới 34%, head sampling bỏ sót 99% lỗi). Observability tồn tại chính vì trực giác con người về hệ thống phân tán thường sai — hãy để dữ liệu dẫn đường.
Ba ý mang về
- Ba trụ cột trả lời ba câu hỏi khác nhau, dùng nối tiếp: metric ("có vấn đề không?"), trace ("chặng nào?"), log ("điều gì?"); đo thật một sự cố đi trọn — p99=128ms + 2.8% lỗi (metric) → dbQuery 129ms là thủ phạm (trace) →
dbQuery that bai(log) — nối liền bằng trace_id. - Cây quyết định dẫn đường lúc sự cố: luôn khởi đầu từ metric, rồi p99 tăng → trace → log/pprof; lỗi tăng → log lấy trace_id → trace; RAM tăng → runtime/metrics → pprof heap; CPU cao → pprof CPU — mỗi triệu chứng có một lối đi rõ ràng.
- Observability là đo đúng cái với chi phí kham được, để dữ liệu dẫn đường: chọn metric có kỷ luật (RED/USE), kiểm soát chi phí (cardinality, sampling), nhìn percentile không nhìn trung bình, và luôn đo thật thay vì đoán — vì trực giác về hệ phân tán thường sai.
Nguồn
- Google SRE Book — Monitoring Distributed Systems: https://sre.google/sre-book/monitoring-distributed-systems/
- Cindy Sridharan — Distributed Systems Observability (ba trụ cột): https://www.oreilly.com/library/view/distributed-systems-observability/9781492033431/
- OpenTelemetry — Observability primer: https://opentelemetry.io/docs/concepts/observability-primer/
Cảm ơn bạn đã theo hết 12 phần của loạt "Observability cho lập trình viên". Từ dòng log slog đầu tiên tới quy trình chẩn đoán ghép ba trụ cột ở bài này, hy vọng bạn đã có một bộ công cụ đo thật để khi hệ thống trục trặc — điều chắc chắn sẽ xảy ra — bạn không phải đoán trong bóng tối, mà lần theo dữ liệu tới đúng nguyên nhân.
