Ở phần 5, ta thấy label (như method, status) làm metric mạnh hơn hẳn — cắt lát dữ liệu theo nhiều chiều, trả lời "bao nhiêu POST lỗi 500". Nhưng cũng ở đó có một cảnh báo được lặp đi lặp lại: label là con dao hai lưỡi, và lưỡi kia rất sắc. Nó tên là cardinality explosion — bùng nổ số chiều — và nó là nguyên nhân số một làm sập các hệ thống Prometheus trong thực tế.
Câu chuyện quen thuộc: một kỹ sư muốn "theo dõi request theo người dùng", nên thêm label user_id vào counter. Code chạy hoàn hảo trên máy dev với vài user. Deploy lên production với hàng triệu user, và vài giờ sau Prometheus ngốn hết RAM rồi chết — kéo theo toàn bộ hệ giám sát mù lúc bạn cần nó nhất. Vấn đề không phải code sai, mà là hiểu sai bản chất toán học của label. Bài này (phần 10 loạt Observability) đo thật sự bùng nổ đó và cho thấy vì sao nó xảy ra.
Cơ chế: cardinality là TÍCH, không phải tổng
Điểm cốt tử phải khắc vào đầu: mỗi tổ hợp giá trị label duy nhất tạo ra một chuỗi thời gian (time series) riêng biệt, và metric store phải lưu-giữ-cập nhật từng chuỗi đó độc lập. Số chuỗi = tích số giá trị khả dĩ của mọi label:
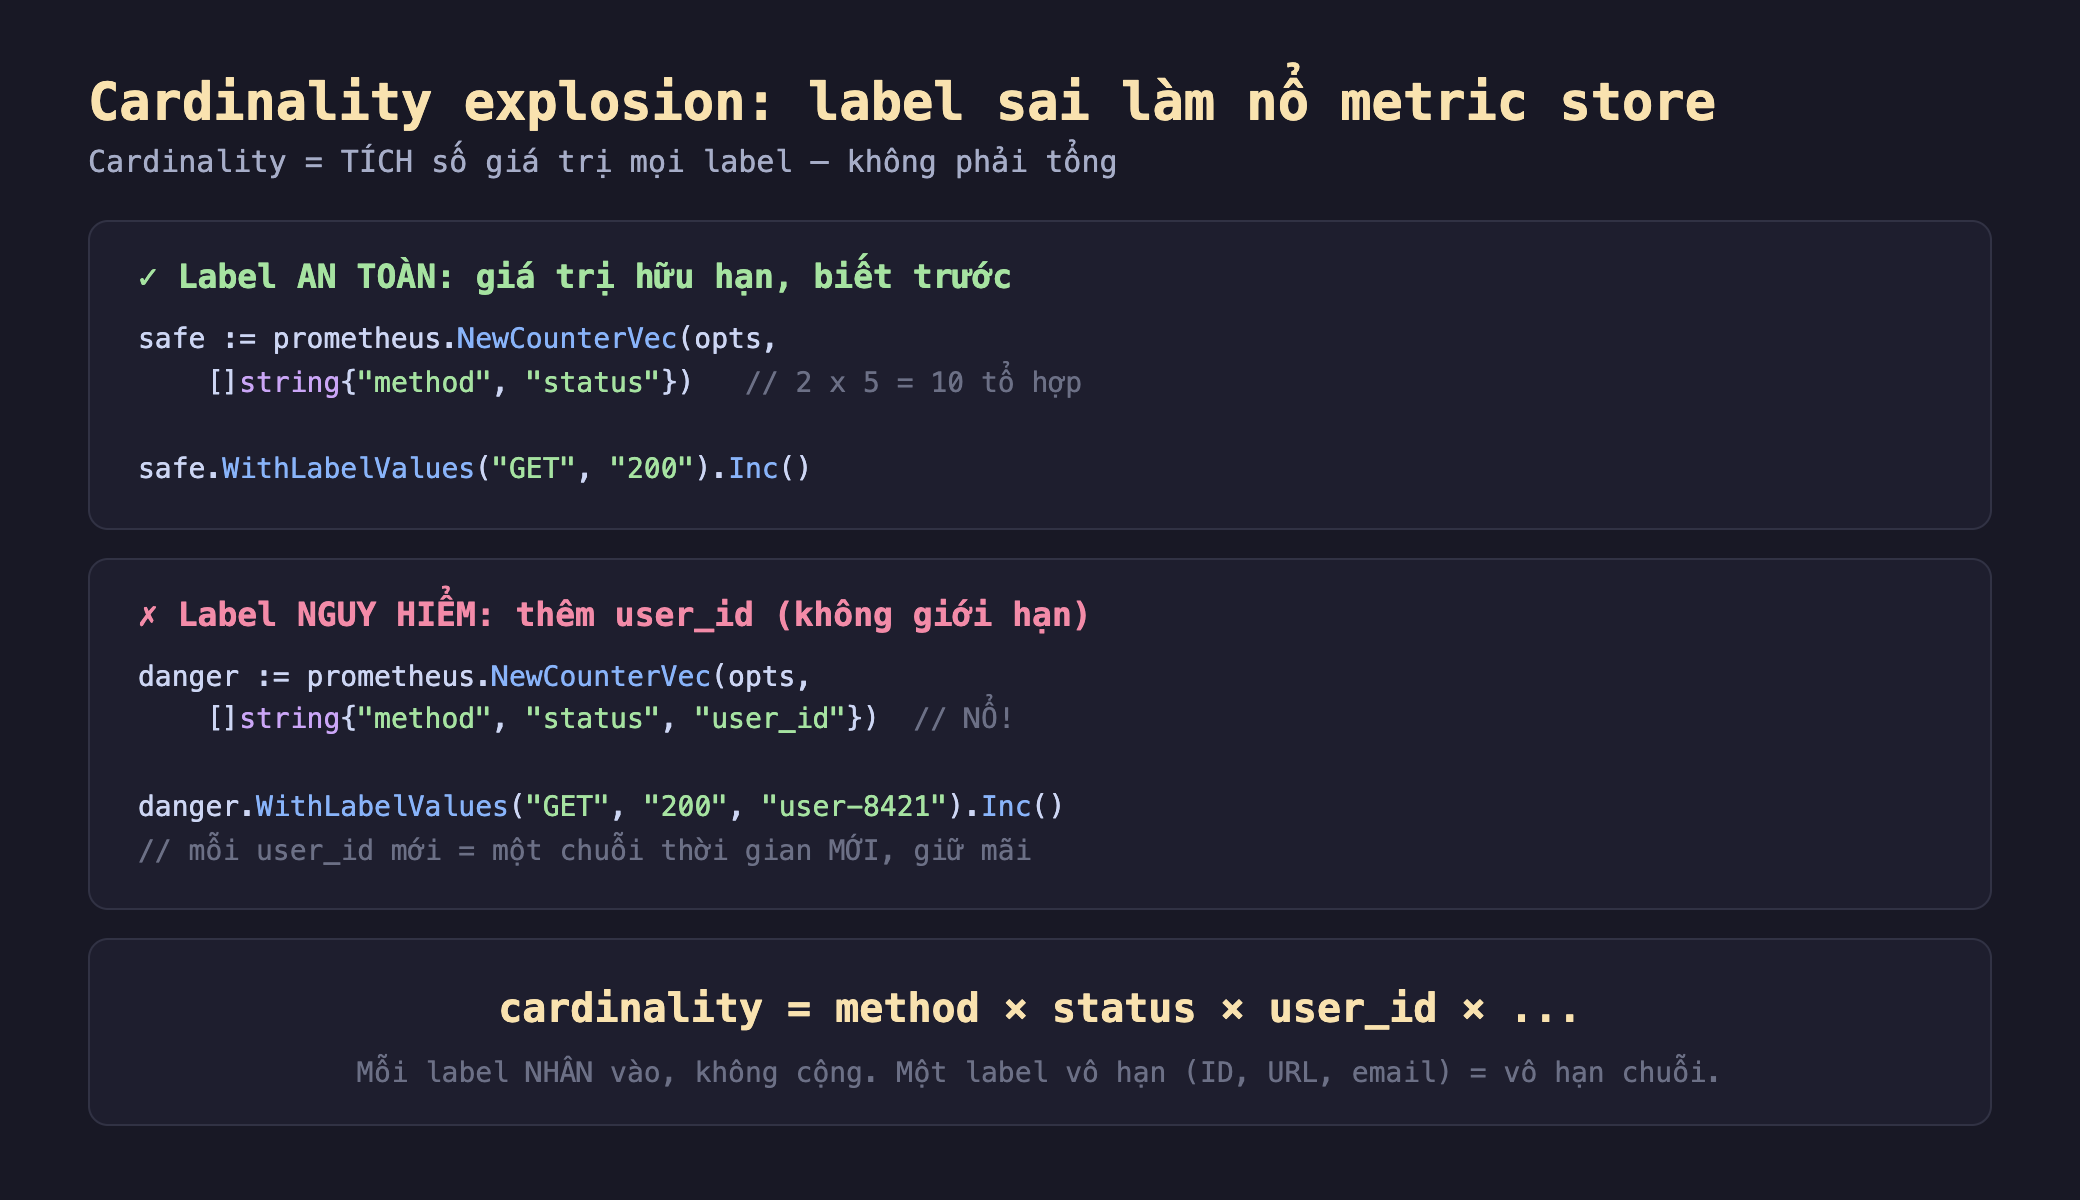
Hình 1: Label an toàn {method, status} = 2×5 = 10 tổ hợp cố định. Thêm user_id (không giới hạn) là mỗi user mới sinh một chuỗi thời gian mới, giữ mãi. Công thức: cardinality = method × status × user_id × ... — mỗi label nhân vào, không cộng; một label vô hạn = vô hạn chuỗi.
Chữ "tích" là mấu chốt. Nhiều người trực giác nghĩ thêm một label "cộng thêm chút dữ liệu", nhưng thực ra nó nhân toàn bộ cardinality hiện có với số giá trị của label mới. Một label với 1000 giá trị không thêm 1000 chuỗi — nó nhân số chuỗi hiện tại lên 1000 lần.
Đo thật trong go-lab
Mình chạy trong go-lab (golang 1.23, client_golang) hai counter, đếm số chuỗi thời gian thực sự sinh ra qua /metrics: một với label an toàn {method, status}, một thêm user_id với 2000 người dùng.
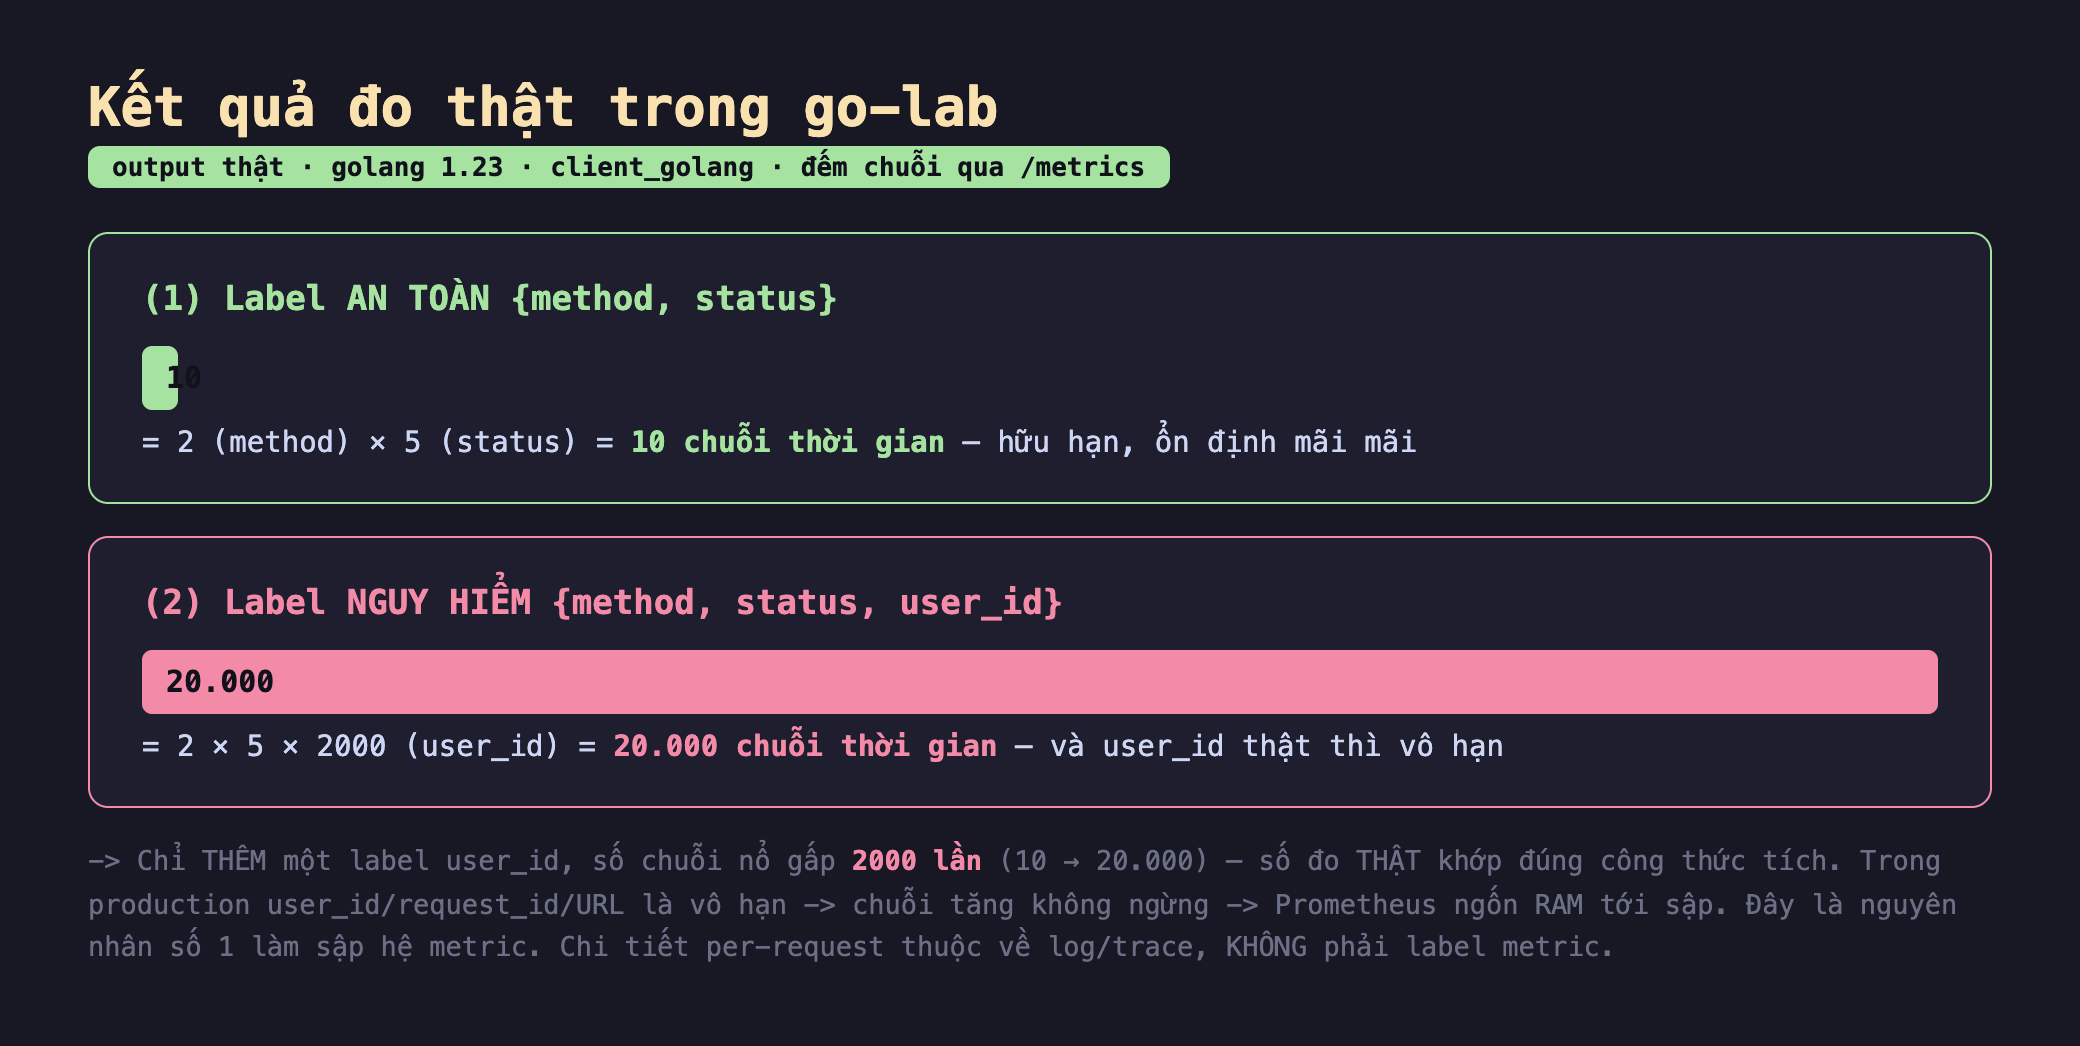
Hình 2: Kết quả thật — label an toàn {method, status} sinh 10 chuỗi (2×5); thêm user_id (2000 giá trị) sinh 20.000 chuỗi (2×5×2000) — chỉ một label làm số chuỗi nổ đúng 2000 lần, số đo khớp chính xác công thức tích.
Con số nói thẳng:
- Label an toàn: 10 chuỗi, ổn định mãi mãi.
method(2 giá trị) ×status(5 giá trị) = đúng 10 chuỗi. Con số này không đổi dù có 10 hay 10 tỷ request đi qua — vì tập giá trị label là hữu hạn và biết trước. Đây là label dùng đúng cách. - Thêm user_id: 20.000 chuỗi, nổ 2000 lần. Chỉ thêm một label
user_idvới 2000 giá trị, số chuỗi nhảy từ 10 lên 20.000 — đúng bằng 2×5×2000, khớp chính xác công thức tích. Và đây mới là 2000 user trong demo; production có hàng triệu user, mỗi user một chuỗi, chuỗi tăng không ngừng theo mỗi user mới ghé thăm. Không có điểm dừng — tới khi Prometheus ngốn hết RAM và sập. - Số đo khớp lý thuyết chính xác. Mình cố ý sinh đủ tổ hợp để số chuỗi đo được (20.000) khớp đúng công thức — không phải ước lượng. Đây là bản chất toán học, không phải hên xui: mỗi tổ hợp label duy nhất là một chuỗi phải lưu.
Đánh đổi cần cân nhắc
ID, URL, email — tuyệt đối không làm label. Đây là quy tắc cứng, không có ngoại lệ mềm. user_id, request_id, trace_id, session_id, email, IP, URL đầy đủ tham số — tất cả có số giá trị không giới hạn (unbounded), và bất kỳ cái nào làm label đều dẫn tới bùng nổ. Nếu bạn thấy mình muốn gắn một trong những thứ đó làm label, đó là tín hiệu bạn đang hỏi sai công cụ: chi tiết per-request thuộc về log và trace (phần 1, 2, 7), nơi mỗi request là một bản ghi độc lập rẻ tiền. Metric là để tổng hợp — chỉ dùng label cho các chiều có tập giá trị nhỏ, hữu hạn, biết trước (method, status code, region, tên endpoint đã chuẩn hoá).
Cẩn thận cả những label "có vẻ hữu hạn". Một số label không rõ ràng vô hạn nhưng vẫn nguy hiểm: đường dẫn URL chưa chuẩn hoá (/user/123/profile, /user/456/profile... — mỗi id một giá trị) phải được gộp thành mẫu (/user/:id/profile) trước khi làm label. Mã lỗi tự do từ hệ thống ngoài, tên host trong cụm lớn, phiên bản client — đều có thể phình ngoài dự kiến. Trước khi thêm bất kỳ label nào, tự hỏi: "giá trị này có chặn trên rõ ràng không, và chặn đó có nhỏ không?". Không chắc thì đừng thêm.
Đặt giới hạn và giám sát chính cardinality. Vì đây là lỗi dễ mắc và hậu quả nặng, các hệ metric hiện đại cho phép đặt trần cardinality (giới hạn số chuỗi mỗi metric, bỏ bớt khi vượt) và cảnh báo khi số chuỗi tăng bất thường. Bật những cái này như một lưới an toàn — vì một label sai lọt vào có thể sập hệ thống trước khi ai kịp review code. Bản thân "số chuỗi thời gian đang lưu" nên là một metric bạn theo dõi: nó tăng đột biến là dấu hiệu ai đó vừa thêm một label độc.
Ba ý mang về
- Cardinality là TÍCH số giá trị mọi label, không phải tổng: đo thật, label an toàn
{method, status}= 2×5 = 10 chuỗi ổn định; thêm một labeluser_id(2000 giá trị) → 20.000 chuỗi, nổ đúng 2000 lần, khớp chính xác công thức — mỗi label nhân vào cardinality hiện có. - ID/URL/email không bao giờ làm label: chúng có số giá trị vô hạn, làm label là chuỗi tăng không ngừng tới khi metric store ngốn hết RAM và sập — đây là nguyên nhân số 1 làm sập Prometheus; chi tiết per-request thuộc về log/trace, không phải metric.
- Chỉ dùng label cho tập giá trị nhỏ, hữu hạn, biết trước: chuẩn hoá URL thành mẫu (
/user/:id) trước khi làm label; cảnh giác cả label "có vẻ hữu hạn"; và đặt trần cardinality + giám sát số chuỗi như lưới an toàn, vì một label sai có thể sập hệ thống trước khi ai kịp review.
Nguồn
- Prometheus — Naming and labels (cẩn trọng cardinality): https://prometheus.io/docs/practices/naming/#labels
- Grafana — What are cardinality and cardinality explosion: https://grafana.com/blog/2022/02/15/what-are-cardinality-spikes-and-why-do-they-matter/
- Prometheus — Instrumentation best practices (use labels): https://prometheus.io/docs/practices/instrumentation/#use-labels
Phần sau ta giải bài toán chi phí đã nhắc nhiều lần: sampling — làm sao giảm khối lượng log/trace khổng lồ mà vẫn thấy được sự cố, đo thật tỉ lệ giữ lại và đánh đổi giữa chi phí và độ phủ.
