Các phần trước đo ứng dụng — request, latency, lỗi. Nhưng bên dưới ứng dụng Go là một runtime làm rất nhiều việc thầm lặng: lên lịch goroutine, quản lý heap, chạy garbage collector. Khi runtime này gặp vấn đề — goroutine rò rỉ chất đống, heap phình mãi, GC dừng-thế-giới quá lâu — ứng dụng của bạn chậm hoặc chết mà các metric ứng dụng có thể không chỉ ra nguyên nhân. Bạn thấy p99 latency thỉnh thoảng nhảy vọt, nhưng vì sao? Rất có thể là GC pause. Bạn thấy RAM tăng mãi, nhưng do đâu? Rất có thể là goroutine rò rỉ.
Go cho phép quan sát chính runtime từ bên trong qua gói runtime/metrics (thư viện chuẩn, không cần gì thêm). Nó cho biết số goroutine đang sống, kích thước heap, số lần GC, thời gian GC dừng thế giới, và hàng chục chỉ số khác. Đây là những "dấu hiệu sinh tồn" mà mọi dịch vụ Go production nên expose. Bài này (phần 9 loạt Observability) đo thật chúng, và cho thấy cách dùng chúng để bắt một trong những lỗi Go nguy hiểm nhất: rò rỉ goroutine.
Cơ chế: đọc metric runtime bằng một lời gọi
runtime/metrics dùng một API thống nhất: bạn khai một danh sách metrics.Sample với tên metric (dạng đường dẫn có đơn vị, ví dụ /sched/goroutines:goroutines), gọi metrics.Read, rồi đọc giá trị. Một số metric là số vô hướng (goroutine, heap bytes), một số là histogram (GC pause).
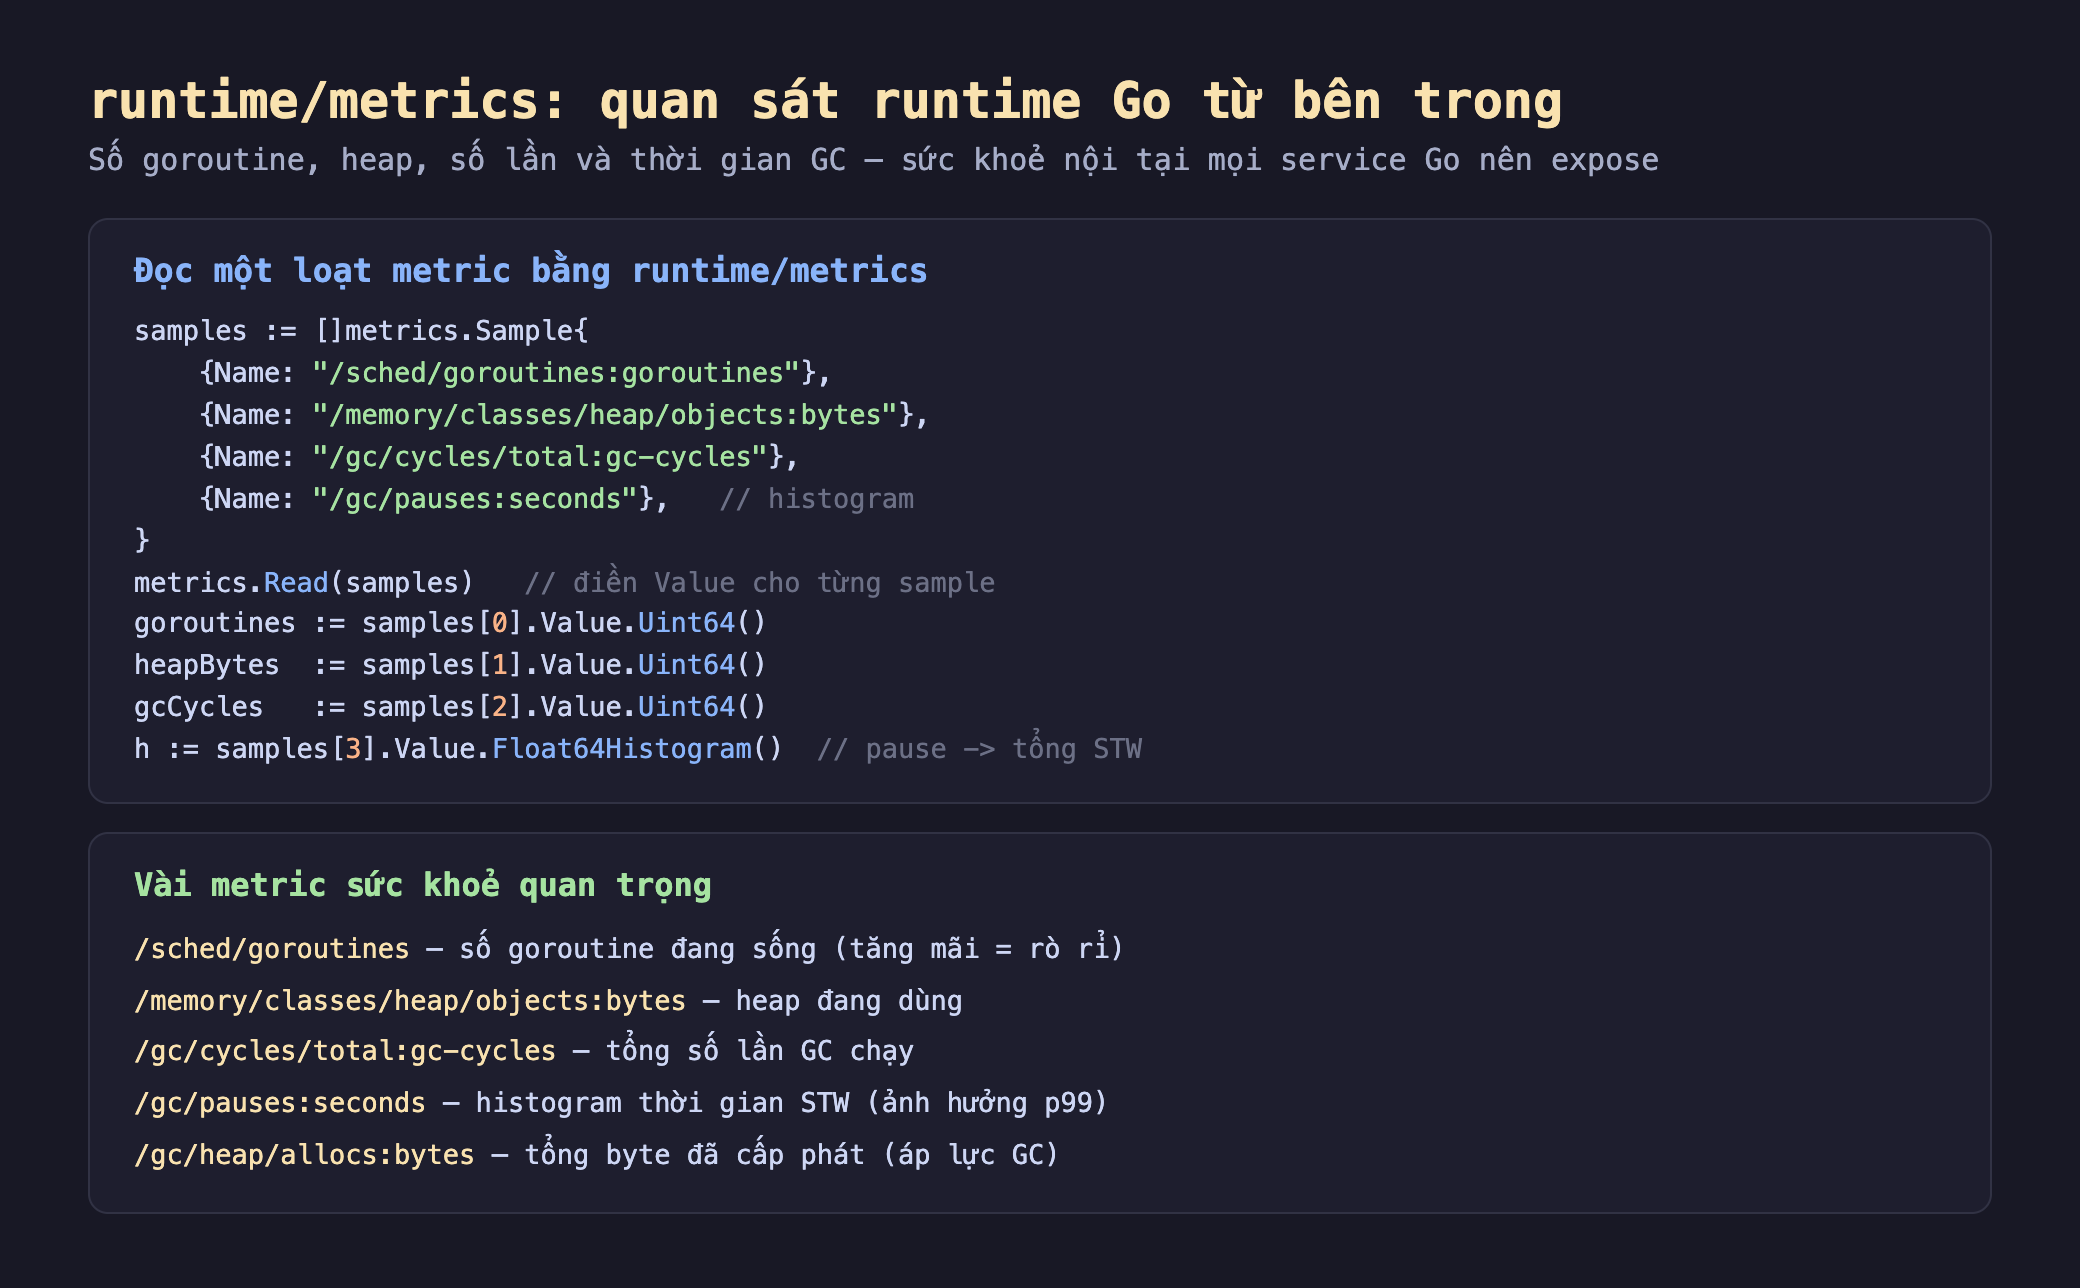
Hình 1: runtime/metrics dùng metrics.Read điền giá trị cho danh sách Sample theo tên. Vài metric sức khoẻ quan trọng: /sched/goroutines (tăng mãi = rò rỉ), heap objects, /gc/cycles/total (số lần GC), /gc/pauses:seconds (histogram STW ảnh hưởng p99), /gc/heap/allocs:bytes (áp lực GC).
Đo thật trong go-lab
Mình chạy trong go-lab (golang 1.23): đọc metric trước, rồi tạo tải — sinh 5000 goroutine đang sống (chờ trên một channel chưa đóng) và cấp phát ~1.3GB để kích GC — rồi đọc sau. Cuối cùng thả các goroutine và đọc lại.
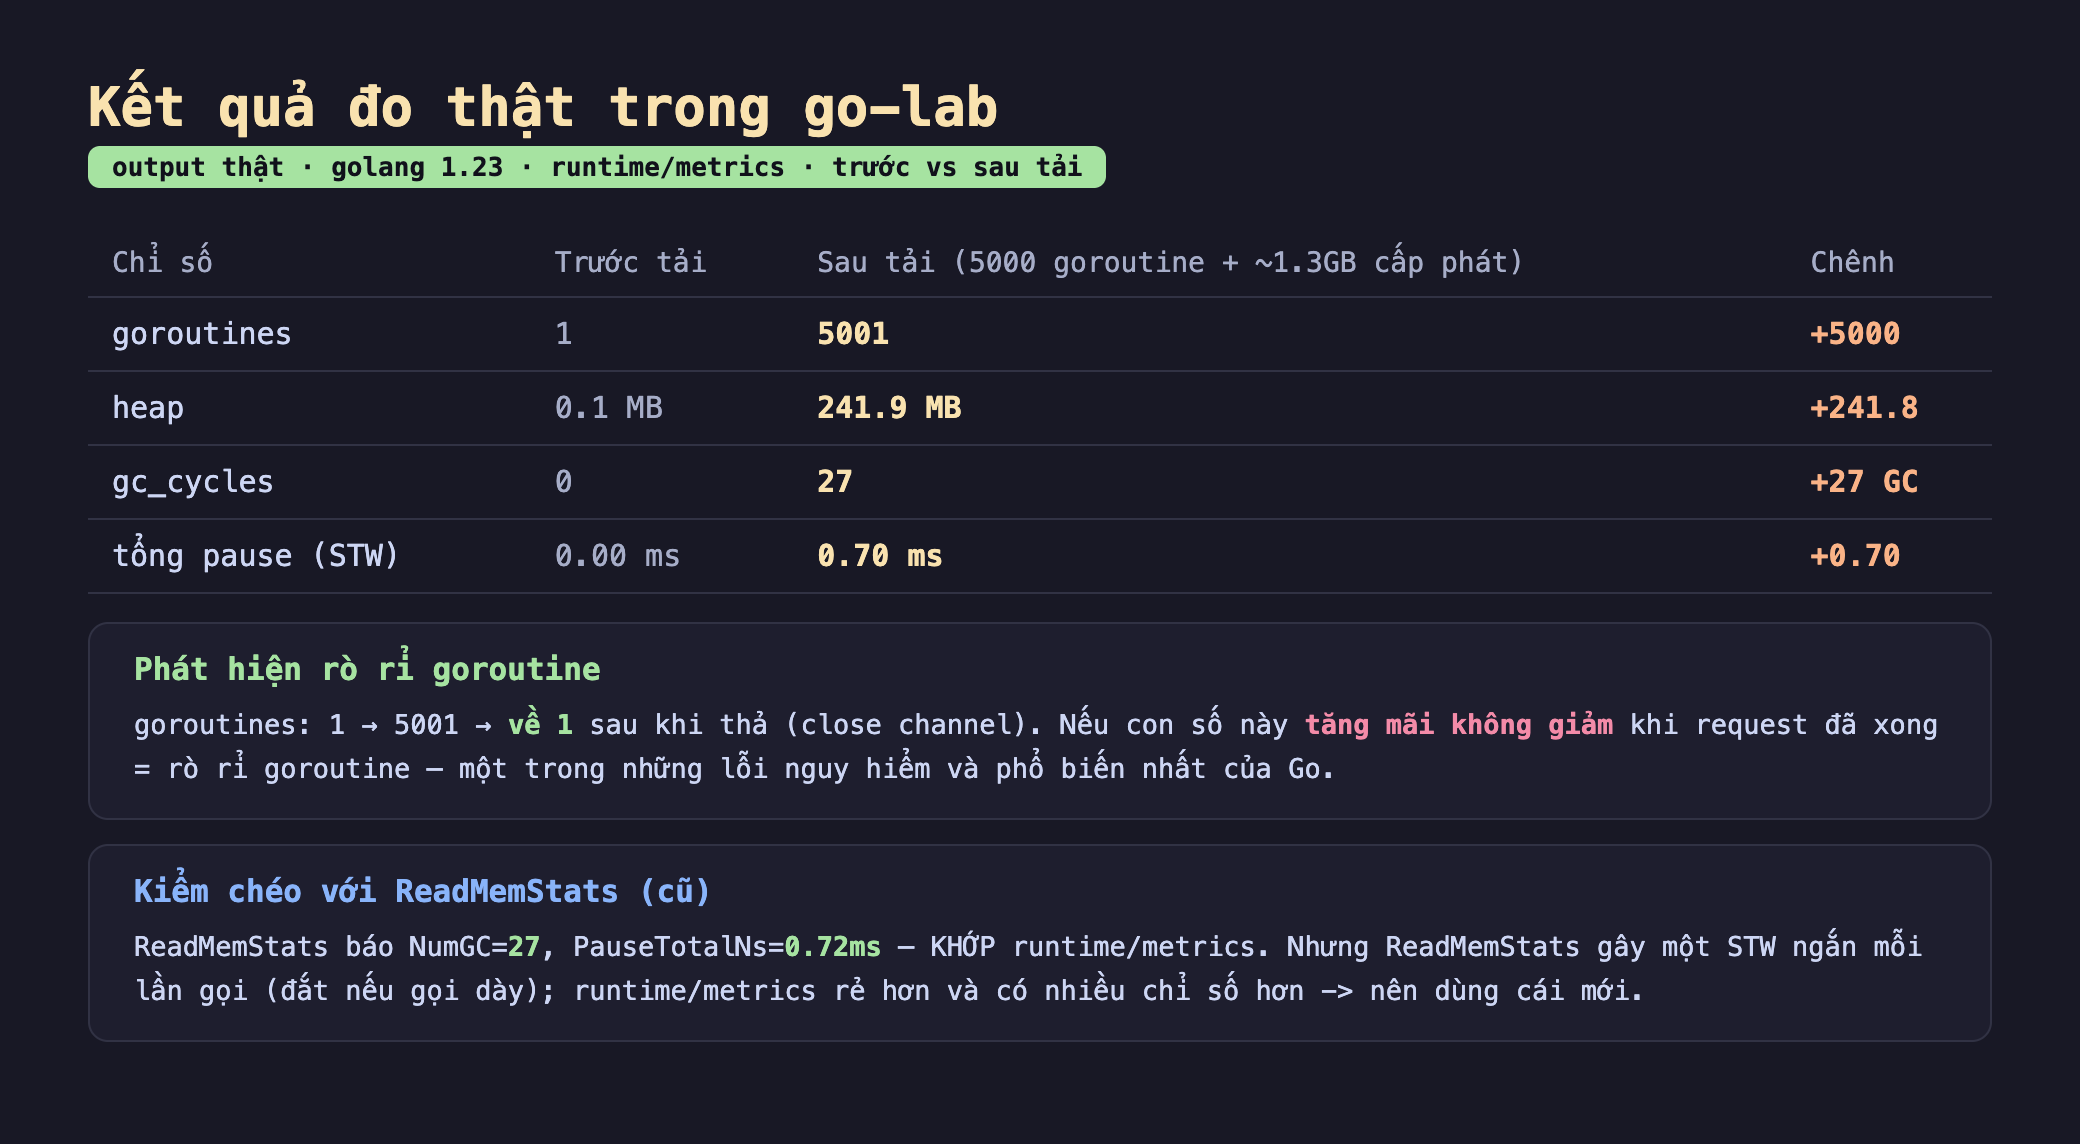
Hình 2: Kết quả thật — sau tải: goroutines 1→5001, heap 0.1→241.9MB, GC cycles 0→27, tổng STW pause 0→0.70ms; thả ra thì goroutines về 1 (không rò rỉ); ReadMemStats kiểm chéo khớp (NumGC=27, pause 0.72ms).
Đọc kết quả:
- Bốn dấu hiệu sinh tồn cùng phản ứng với tải. goroutines nhảy từ 1 lên 5001 (đúng 5000 goroutine mình tạo + 1 main), heap lên 241.9MB, GC chạy 27 lần để dọn ~1.3GB đã cấp phát, và tổng thời gian dừng-thế-giới là 0.70ms. Mỗi con số kể một khía cạnh: có bao nhiêu việc đang chạy, dùng bao nhiêu RAM, GC làm việc nhiều thế nào.
- Bắt rò rỉ goroutine tại chỗ. Đây là điểm giá trị nhất. goroutines đi 1 → 5001 → về 1 sau khi mình
close(block)thả chúng. Trong một dịch vụ thật, nếu bạn thấy/sched/goroutinestăng mãi không giảm dù request đã xử lý xong, đó là rò rỉ goroutine — goroutine bị kẹt (chờ channel không ai gửi, chờ lock, chờ mạng không timeout) và tích tụ vô hạn, ăn dần RAM tới khi sập. Đây là một trong những lỗi phổ biến và khó chịu nhất của Go, và metric này là cách phát hiện sớm nhất. - runtime/metrics và ReadMemStats khớp nhau. Kiểm chéo bằng
runtime.ReadMemStats(API cũ) cho NumGC=27 và PauseTotalNs=0.72ms — trùng khớp với runtime/metrics. Điều này xác nhận số liệu đúng, đồng thời dẫn tới một điểm quan trọng ở phần đánh đổi.
Đánh đổi cần cân nhắc
GC pause là thứ trực tiếp ảnh hưởng p99 — theo dõi nó. Tổng STW 0.70ms nghe nhỏ, nhưng nó phân bố thành nhiều lần pause rải rác. Mỗi lần GC dừng thế giới, mọi request đang xử lý đều đứng hình trong khoảnh khắc đó — và nếu một request xui xẻo trúng ngay lúc GC pause, latency của nó tăng vọt. Đây thường là thủ phạm giấu mặt sau các "latency spike" bí ẩn ở p99 (như bài histogram phần 4): p50 đẹp nhưng p99 xấu, mà code chẳng có gì chậm — vì đuôi latency là các request trúng GC pause. Theo dõi /gc/pauses và giảm áp lực GC (bớt cấp phát, dùng sync.Pool, giảm số object) là cách cải thiện p99 mà tối ưu code thuần không đụng tới.
runtime/metrics rẻ hơn ReadMemStats — ưu tiên cái mới. Hai API cùng cho số liệu khớp nhau, nhưng khác nhau ở chi phí. runtime.ReadMemStats gây một lần stop-the-world ngắn mỗi lần gọi (nó cần dừng để chụp nhất quán) — vô hại nếu gọi thi thoảng, nhưng nếu bạn expose metric mỗi giây (hay bị scrape dày), những STW đó cộng dồn thành chính vấn đề bạn đang cố đo. runtime/metrics (từ Go 1.16) được thiết kế rẻ hơn, không STW cho phần lớn metric, và có nhiều chỉ số hơn (hàng chục, gồm cả scheduler, mutex). Với code mới, dùng runtime/metrics; ReadMemStats chỉ nên dùng khi cần một trường nó chưa có.
Expose runtime metric ra Prometheus là chuẩn cho service Go. Bạn không phải tự đọc và tự vẽ. Thư viện client_golang (phần 5) có sẵn collector đọc runtime metric và expose qua /metrics — chỉ cần đăng ký collectors.NewGoCollector() là có ngay goroutine count, heap, GC stats trên dashboard. Mọi dịch vụ Go production nên bật cái này: khi sự cố xảy ra, ba câu hỏi đầu tiên thường là "goroutine có rò rỉ không?", "heap có phình không?", "GC có quá tải không?" — và ba metric này trả lời ngay.
Ba ý mang về
- runtime/metrics cho dấu hiệu sinh tồn của runtime Go: đo thật, sau tải goroutines 1→5001, heap 0.1→241.9MB, GC 0→27 lần, STW 0→0.70ms — bốn chỉ số cho biết có bao nhiêu việc chạy, dùng bao nhiêu RAM, GC làm việc thế nào; đọc tất cả bằng một
metrics.Read. - Số goroutine là cách bắt rò rỉ goroutine: đo thật goroutines đi 1→5001→về 1 sau khi thả; nếu con số này tăng mãi không giảm khi request đã xong = rò rỉ goroutine (goroutine kẹt chờ channel/lock/mạng), một trong những lỗi Go nguy hiểm và phổ biến nhất.
- GC pause ảnh hưởng p99, và dùng đúng API: STW pause là thủ phạm giấu mặt sau latency spike ở p99 — theo dõi
/gc/pausesvà giảm áp lực GC; dùngruntime/metrics(rẻ, nhiều chỉ số) thayReadMemStats(gây STW mỗi lần gọi); expose quaclient_golangGoCollector là chuẩn cho mọi service Go.
Nguồn
- Go — Package runtime/metrics: https://pkg.go.dev/runtime/metrics
- Go — A Guide to the Go Garbage Collector: https://go.dev/doc/gc-guide
- Prometheus — Go runtime metrics (GoCollector): https://pkg.go.dev/github.com/prometheus/client_golang/prometheus/collectors#NewGoCollector
Phần sau ta mổ xẻ cái bẫy đã nhắc nhiều lần: cardinality explosion — một label đặt sai (user_id, request_id) sinh ra hàng triệu chuỗi thời gian làm nổ tung metric store, đo thật số chuỗi sinh ra và cách phòng.
