Có một câu nói kinh điển trong tối ưu hiệu năng: "đừng đoán, hãy đo". Lý do là trực giác của lập trình viên về chỗ nào chậm gần như luôn sai — bạn dành cả buổi tối ưu một hàm mà hoá ra nó chỉ chiếm 2% thời gian, trong khi thủ phạm thật nằm ở một chỗ chẳng ai ngờ. Phần 7 (tracing) cho biết chặng nào của request chậm, nhưng bên trong một chặng — một hàm xử lý — thì hàm con nào ngốn CPU, dòng nào cấp phát bộ nhớ nhiều nhất? Đó là việc của profiling.
Go có một trong những bộ profiler tốt nhất tích hợp sẵn: pprof. Nó không phải công cụ ngoài — gói runtime/pprof nằm trong thư viện chuẩn, và go tool pprof đi kèm mọi bản cài Go. pprof lấy mẫu chương trình đang chạy và cho biết chính xác hàm nào tiêu tốn CPU (CPU profile) hay giữ bộ nhớ (heap profile). Bài này (phần 8 loạt Observability) chạy thật cả hai loại profile và — quan trọng không kém — giải thích cách đọc chúng, vì hiểu sai hai cột flat/cum là nhầm thủ phạm.
Cơ chế: lấy mẫu CPU và chụp heap
CPU profile hoạt động bằng sampling: khoảng 100 lần/giây, runtime dừng chương trình một chớp và ghi lại stack đang chạy. Sau vài giây, hàm nào xuất hiện trong nhiều mẫu nhất chính là hàm ngốn CPU nhất. Vì chỉ lấy mẫu (không đo từng lời gọi), chi phí rất nhẹ — đủ nhẹ để chạy cả trên production.
Heap profile thì khác: nó chụp ảnh tức thời của bộ nhớ đang được cấp phát, cho biết hàm nào đã cấp phát (và đang giữ) bao nhiêu bộ nhớ.
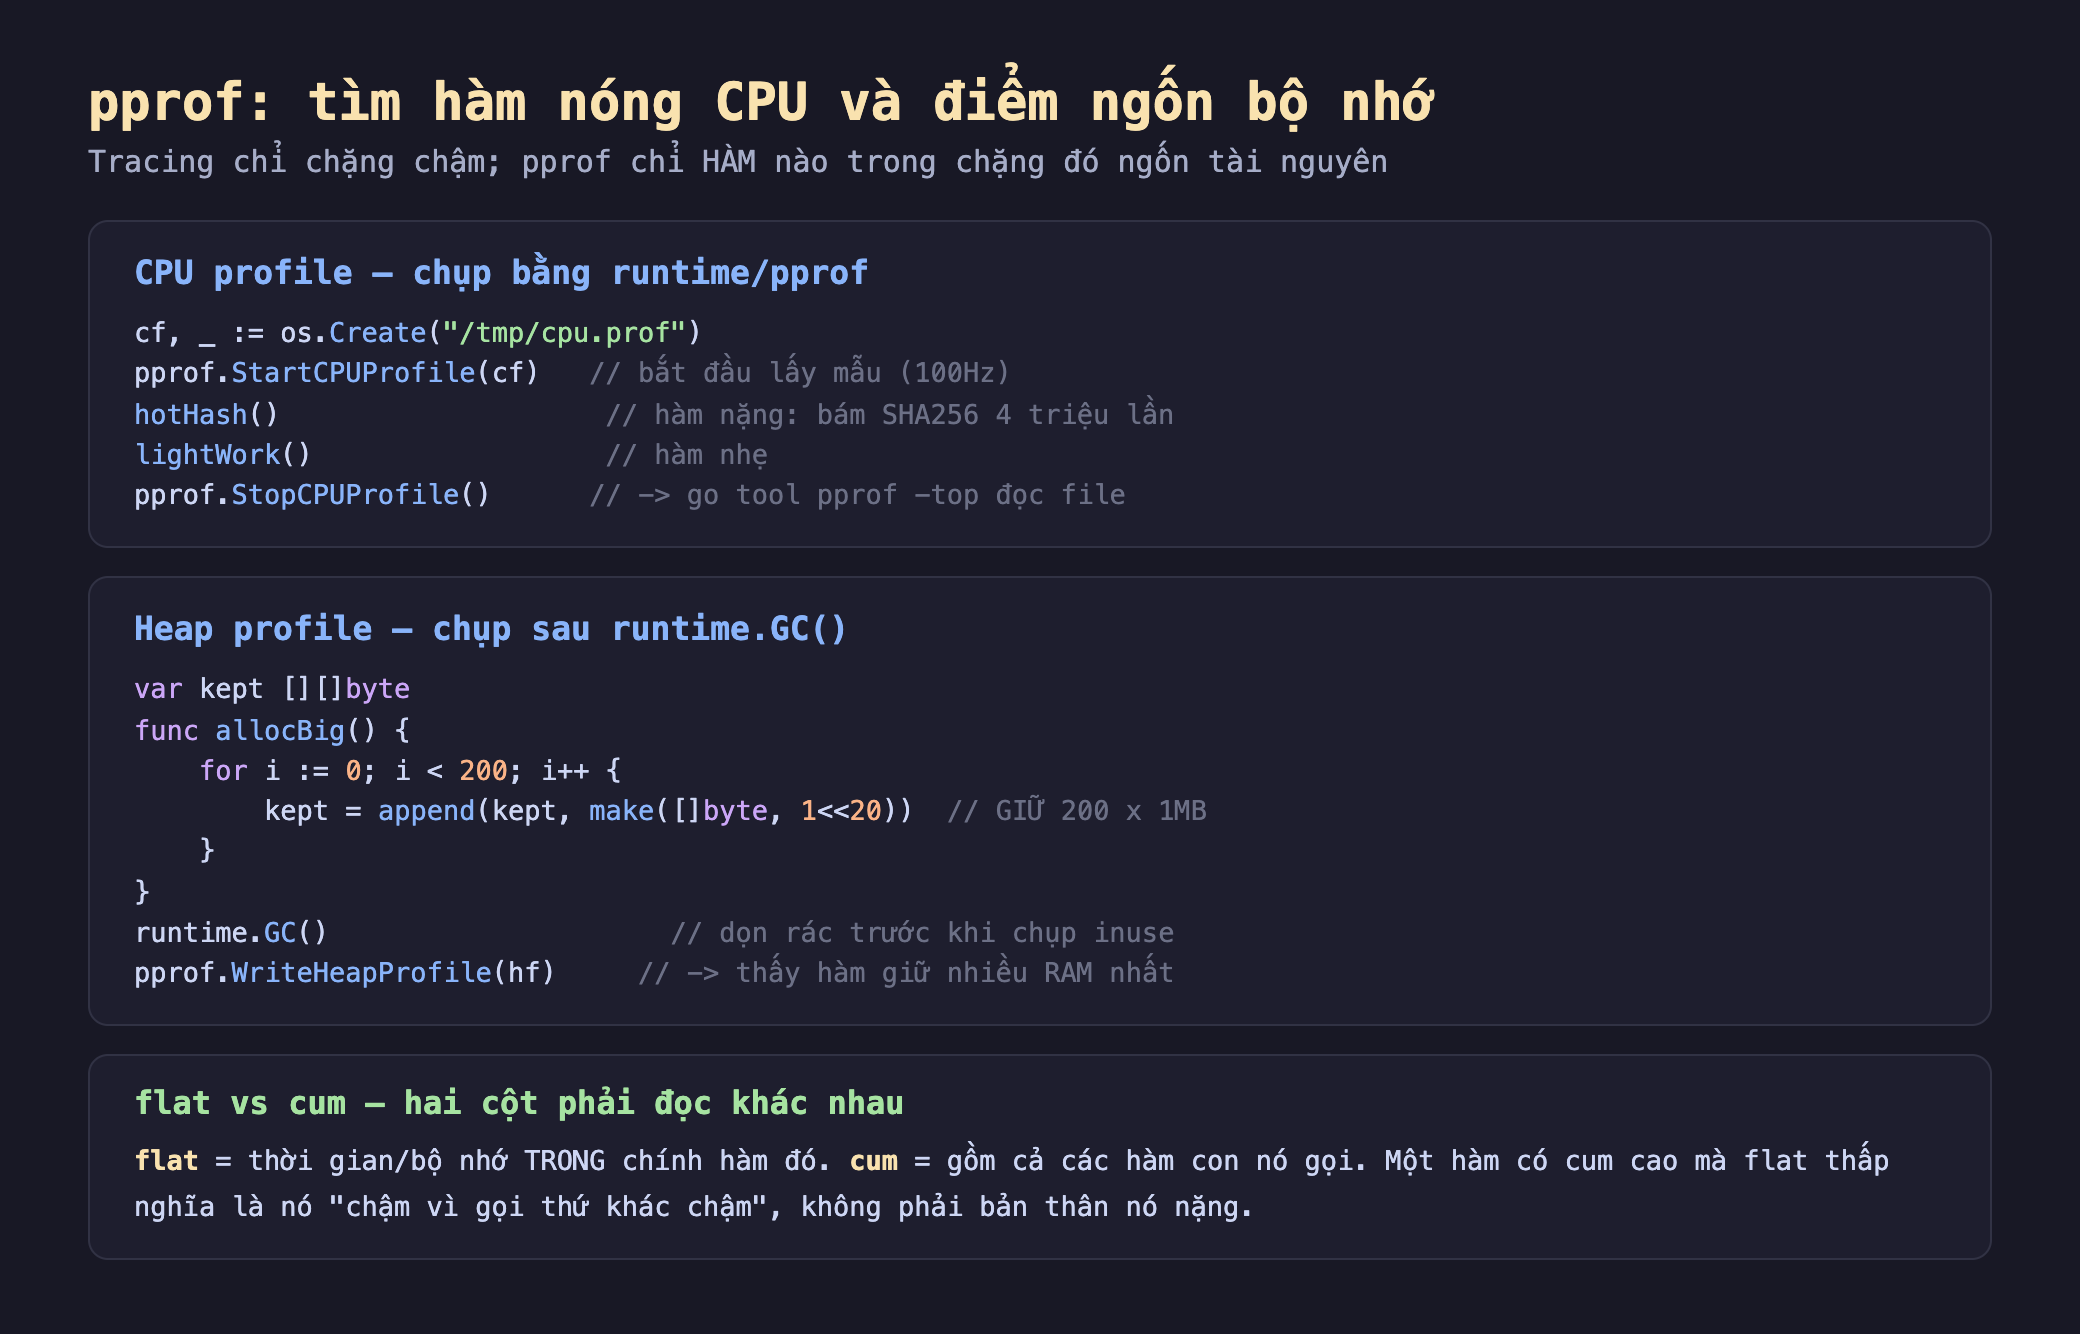
Hình 1: CPU profile — pprof.StartCPUProfile/StopCPUProfile bọc quanh đoạn cần đo (lấy mẫu 100Hz). Heap profile — runtime.GC() rồi pprof.WriteHeapProfile để chụp bộ nhớ đang giữ. Và điểm dễ nhầm: flat là chi phí trong chính hàm, cum gồm cả hàm con nó gọi.
Đo thật trong go-lab
Mình viết trong go-lab (golang 1.23) một chương trình có: một hàm CPU-nặng cố ý (hotHash — băm SHA256 bốn triệu lần) cạnh một hàm nhẹ (lightWork); và một hàm giữ nhiều bộ nhớ (allocBig — giữ 200 slice 1MB = 200MB) cạnh một hàm cấp phát rồi bỏ (allocSmall). Rồi chụp cả hai profile và đọc bằng go tool pprof -top.
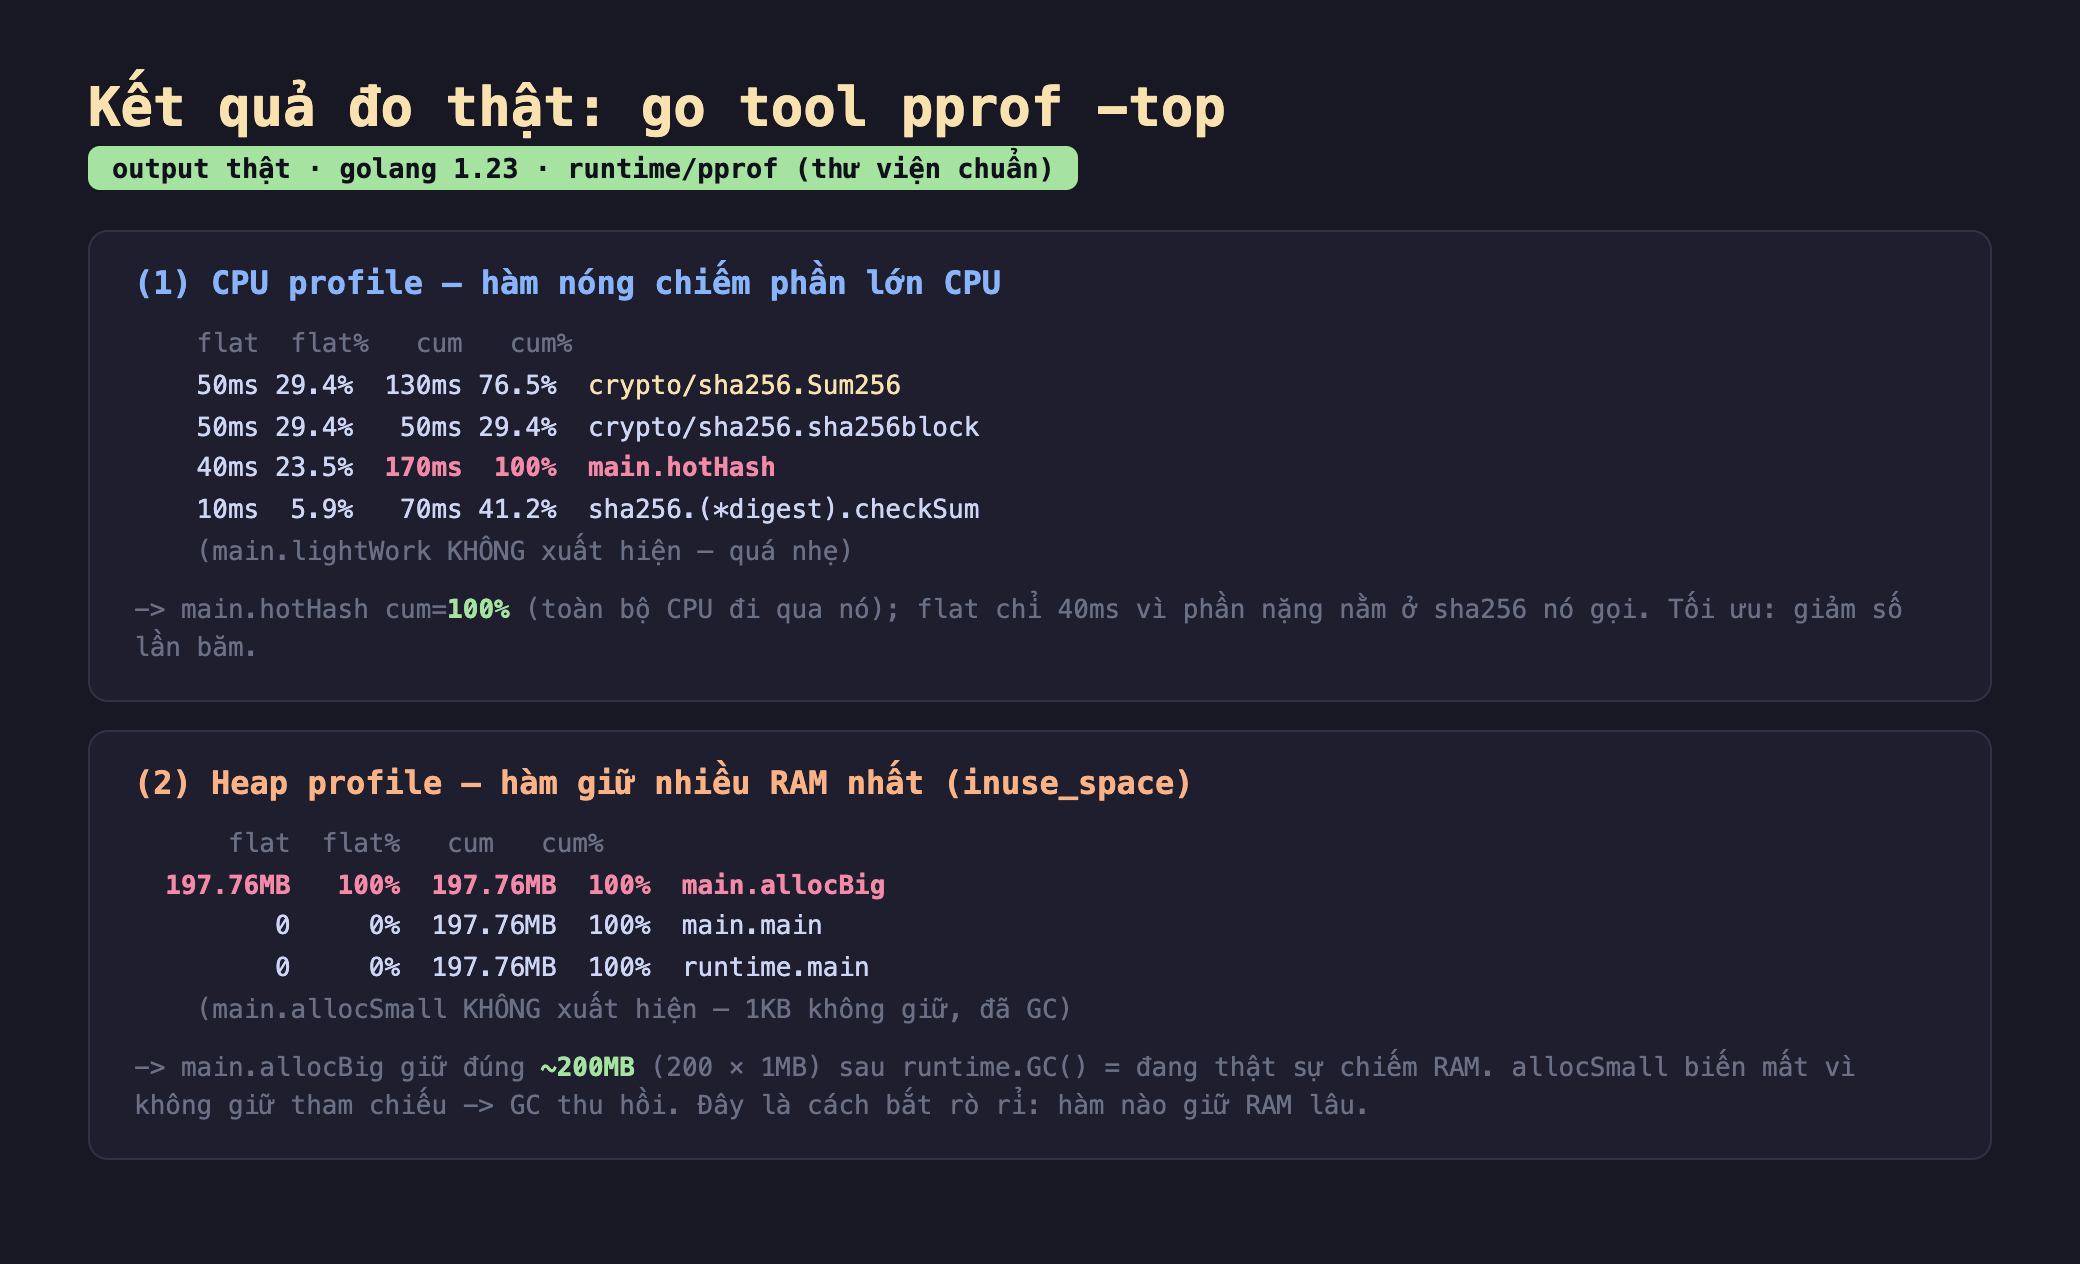
Hình 2: Kết quả thật — CPU profile: main.hotHash cum 100% (flat 40ms), sha256.Sum256 cum 76.5%, lightWork không xuất hiện; heap profile: main.allocBig giữ 197.76MB (100%), allocSmall biến mất vì đã bị GC.
Đọc kết quả:
- CPU: hàm nóng lộ ngay.
main.hotHashcó cum=100% — toàn bộ thời gian CPU đi qua nó. Đáng chú ý làflatcủa nó chỉ 40ms (23.5%), trong khisha256.Sum256có flat 50ms và cum 76.5%. Điều này nói:hotHashkhông tự nó nặng, mà nặng vì gọi sha256 nhiều. Vàmain.lightWorkkhông xuất hiện — nó quá nhẹ, không lọt vào mẫu nào. Đây chính là "đừng đoán, hãy đo" trong hành động: profile chỉ thẳng chỗ đáng tối ưu (giảm số lần băm) và loại chỗ không đáng (lightWork). - Heap: hàm giữ RAM lộ ngay.
main.allocBigchiếm 197.76MB = 100% bộ nhớ đang giữ (đúng 200 × 1MB). CònallocSmall— cấp phát 1KB nhưng không giữ tham chiếu — không xuất hiện, vì đã bị GC thu hồi trước khi chụp (mình gọiruntime.GC()trước). Đây là cách bắt rò rỉ bộ nhớ: chụp heap sau GC, hàm nào vẫn giữ nhiều RAM là hàm đáng nghi. - flat vs cum là chìa khoá đọc đúng.
flat= chi phí trong chính hàm (không tính hàm con).cum= gồm cả hàm con. Nhìn cum để biết "toàn bộ nhánh này tốn bao nhiêu"; nhìn flat để biết "hàm nào tự nó tốn". Nhầm hai cột dẫn tới tối ưu sai chỗ — ví dụ thấymain.hotHashcum 100% mà lao vào tối ưu code trong nó thì vô ích, vì flat chỉ 40ms; chỗ thật sự tốn là sha256.
Đánh đổi cần cân nhắc
CPU profile là sampling — hàm siêu ngắn có thể lọt. Vì chỉ lấy mẫu ~100 lần/giây, một hàm chạy rất nhanh nhưng gọi cực nhiều lần có thể bị đánh giá thấp, hoặc một hàm ngắn tình cờ không rơi vào mẫu nào (như lightWork biến mất). Sampling đánh đổi độ chính xác tuyệt đối lấy chi phí thấp — nó rất tốt để tìm hàm nóng lớn, nhưng đừng tin nó tới từng phần trăm cho các hàm nhỏ. Với đo chính xác từng lời gọi cần công cụ khác (tracing/benchmark), nhưng cho 90% trường hợp "tìm thủ phạm chính", sampling là đủ và đúng.
Phải profile khi tải THẬT — profile lúc rảnh là vô nghĩa. Đây là sai lầm phổ biến: profile một chương trình đang không làm gì, rồi kết luận. CPU profile chỉ có ý nghĩa khi chương trình đang chịu tải giống production — vì hàm nóng lúc tải cao có thể hoàn toàn khác lúc rảnh. Với dịch vụ đang chạy, dùng net/http/pprof: import nó là có ngay endpoint /debug/pprof/ để thu profile của tiến trình đang phục vụ thật, không cần dừng hay build lại. (Và như mọi endpoint debug — /debug/vars, /metrics — phải bảo vệ nó, đừng hở ra Internet.)
Heap profile: phân biệt inuse và alloc. Mặc định go tool pprof xem inuse_space — bộ nhớ đang giữ tại lúc chụp (tốt để tìm rò rỉ, như demo). Nhưng có loại khác alloc_space — tổng bộ nhớ đã từng cấp phát (kể cả đã giải phóng). Hai câu hỏi khác nhau: "cái gì đang giữ RAM?" (inuse — tìm rò rỉ) vs "cái gì tạo áp lực GC bằng cách cấp phát liên tục?" (alloc — tìm chỗ cấp phát nóng gây GC nhiều). Dùng -sample_index=alloc_space khi điều tra GC, inuse_space khi điều tra rò rỉ. Chọn nhầm là trả lời nhầm câu hỏi.
Ba ý mang về
- Đừng đoán hàm nào chậm — pprof đo trực tiếp: đo thật, CPU profile chỉ
main.hotHashcum 100% (vàlightWorkbiến mất vì quá nhẹ), heap profile chỉmain.allocBiggiữ 197.76MB (vàallocSmallbiến mất vì đã GC) — profiler loại bỏ phỏng đoán, chỉ thẳng chỗ đáng tối ưu. - flat vs cum phải đọc đúng kẻo tối ưu nhầm chỗ:
flatlà chi phí trong chính hàm,cumgồm cả hàm con;hotHashcum 100% nhưng flat chỉ 40ms — chỗ nặng thật là sha256 nó gọi, không phải code trong hotHash. - pprof là sampling, cần đúng bối cảnh: CPU profile nhẹ nhờ lấy mẫu 100Hz nhưng hàm siêu ngắn có thể lọt; phải profile khi tải thật (dùng
net/http/pprofcho tiến trình production, và bảo vệ endpoint); heap phân biệtinuse_space(tìm rò rỉ) vàalloc_space(tìm áp lực GC).
Nguồn
- Go — Package runtime/pprof: https://pkg.go.dev/runtime/pprof
- Go Blog — Profiling Go Programs: https://go.dev/blog/pprof
- Go — net/http/pprof (profile tiến trình đang chạy): https://pkg.go.dev/net/http/pprof
Phần sau ta quan sát chính runtime Go từ bên trong: gói runtime/metrics cho biết số goroutine, kích thước heap, số lần và thời gian GC — những chỉ số sức khoẻ nội tại mà mọi dịch vụ Go nên expose.
