Metric (phần 3-6) rất giỏi trả lời "có chậm không" — p99 latency của endpoint này là 500ms. Nhưng nó bất lực trước câu hỏi tiếp theo, cũng là câu quan trọng nhất: "chậm ở chặng nào?". Một request web hiện đại đi qua nhiều bước — xác thực, gọi database, gọi cache, gọi service khác — và khi tổng thời gian là 500ms, metric không nói cho bạn biết 450ms trong đó nằm ở đâu. Bạn phải đoán, hoặc rải log khắp nơi rồi ghép tay.
Tracing — trụ cột thứ ba của observability — sinh ra để trả lời chính xác câu đó. Ý tưởng: mỗi chặng của request được bọc trong một span (đo thời gian của chặng đó), các span lồng nhau theo quan hệ cha-con, tất cả cùng một trace_id (nối tiếp từ phần 2). Ghép lại thành một cây span — một "biểu đồ thác nước" cho thấy request đi qua đâu và mỗi chặng ngốn bao lâu. Bài này (phần 7 loạt Observability) tự cài một tracer tối giản trong Go để thấy rõ cơ chế, không cần backend nào.
Cơ chế: span lồng nhau qua context
Một span ghi lại: traceID (chung cho cả request), spanID (định danh chặng này), parentID (trỏ về span cha), name, và thời gian (start, dur). Chìa khoá để span lồng đúng là dùng lại chính cơ chế của phần 2: truyền span hiện tại qua context.Context. Khi bắt đầu một span mới, nó nhìn vào context xem có span cha không — nếu có, nó lấy traceID của cha và đặt parentID = spanID của cha; nếu không, nó là span gốc.
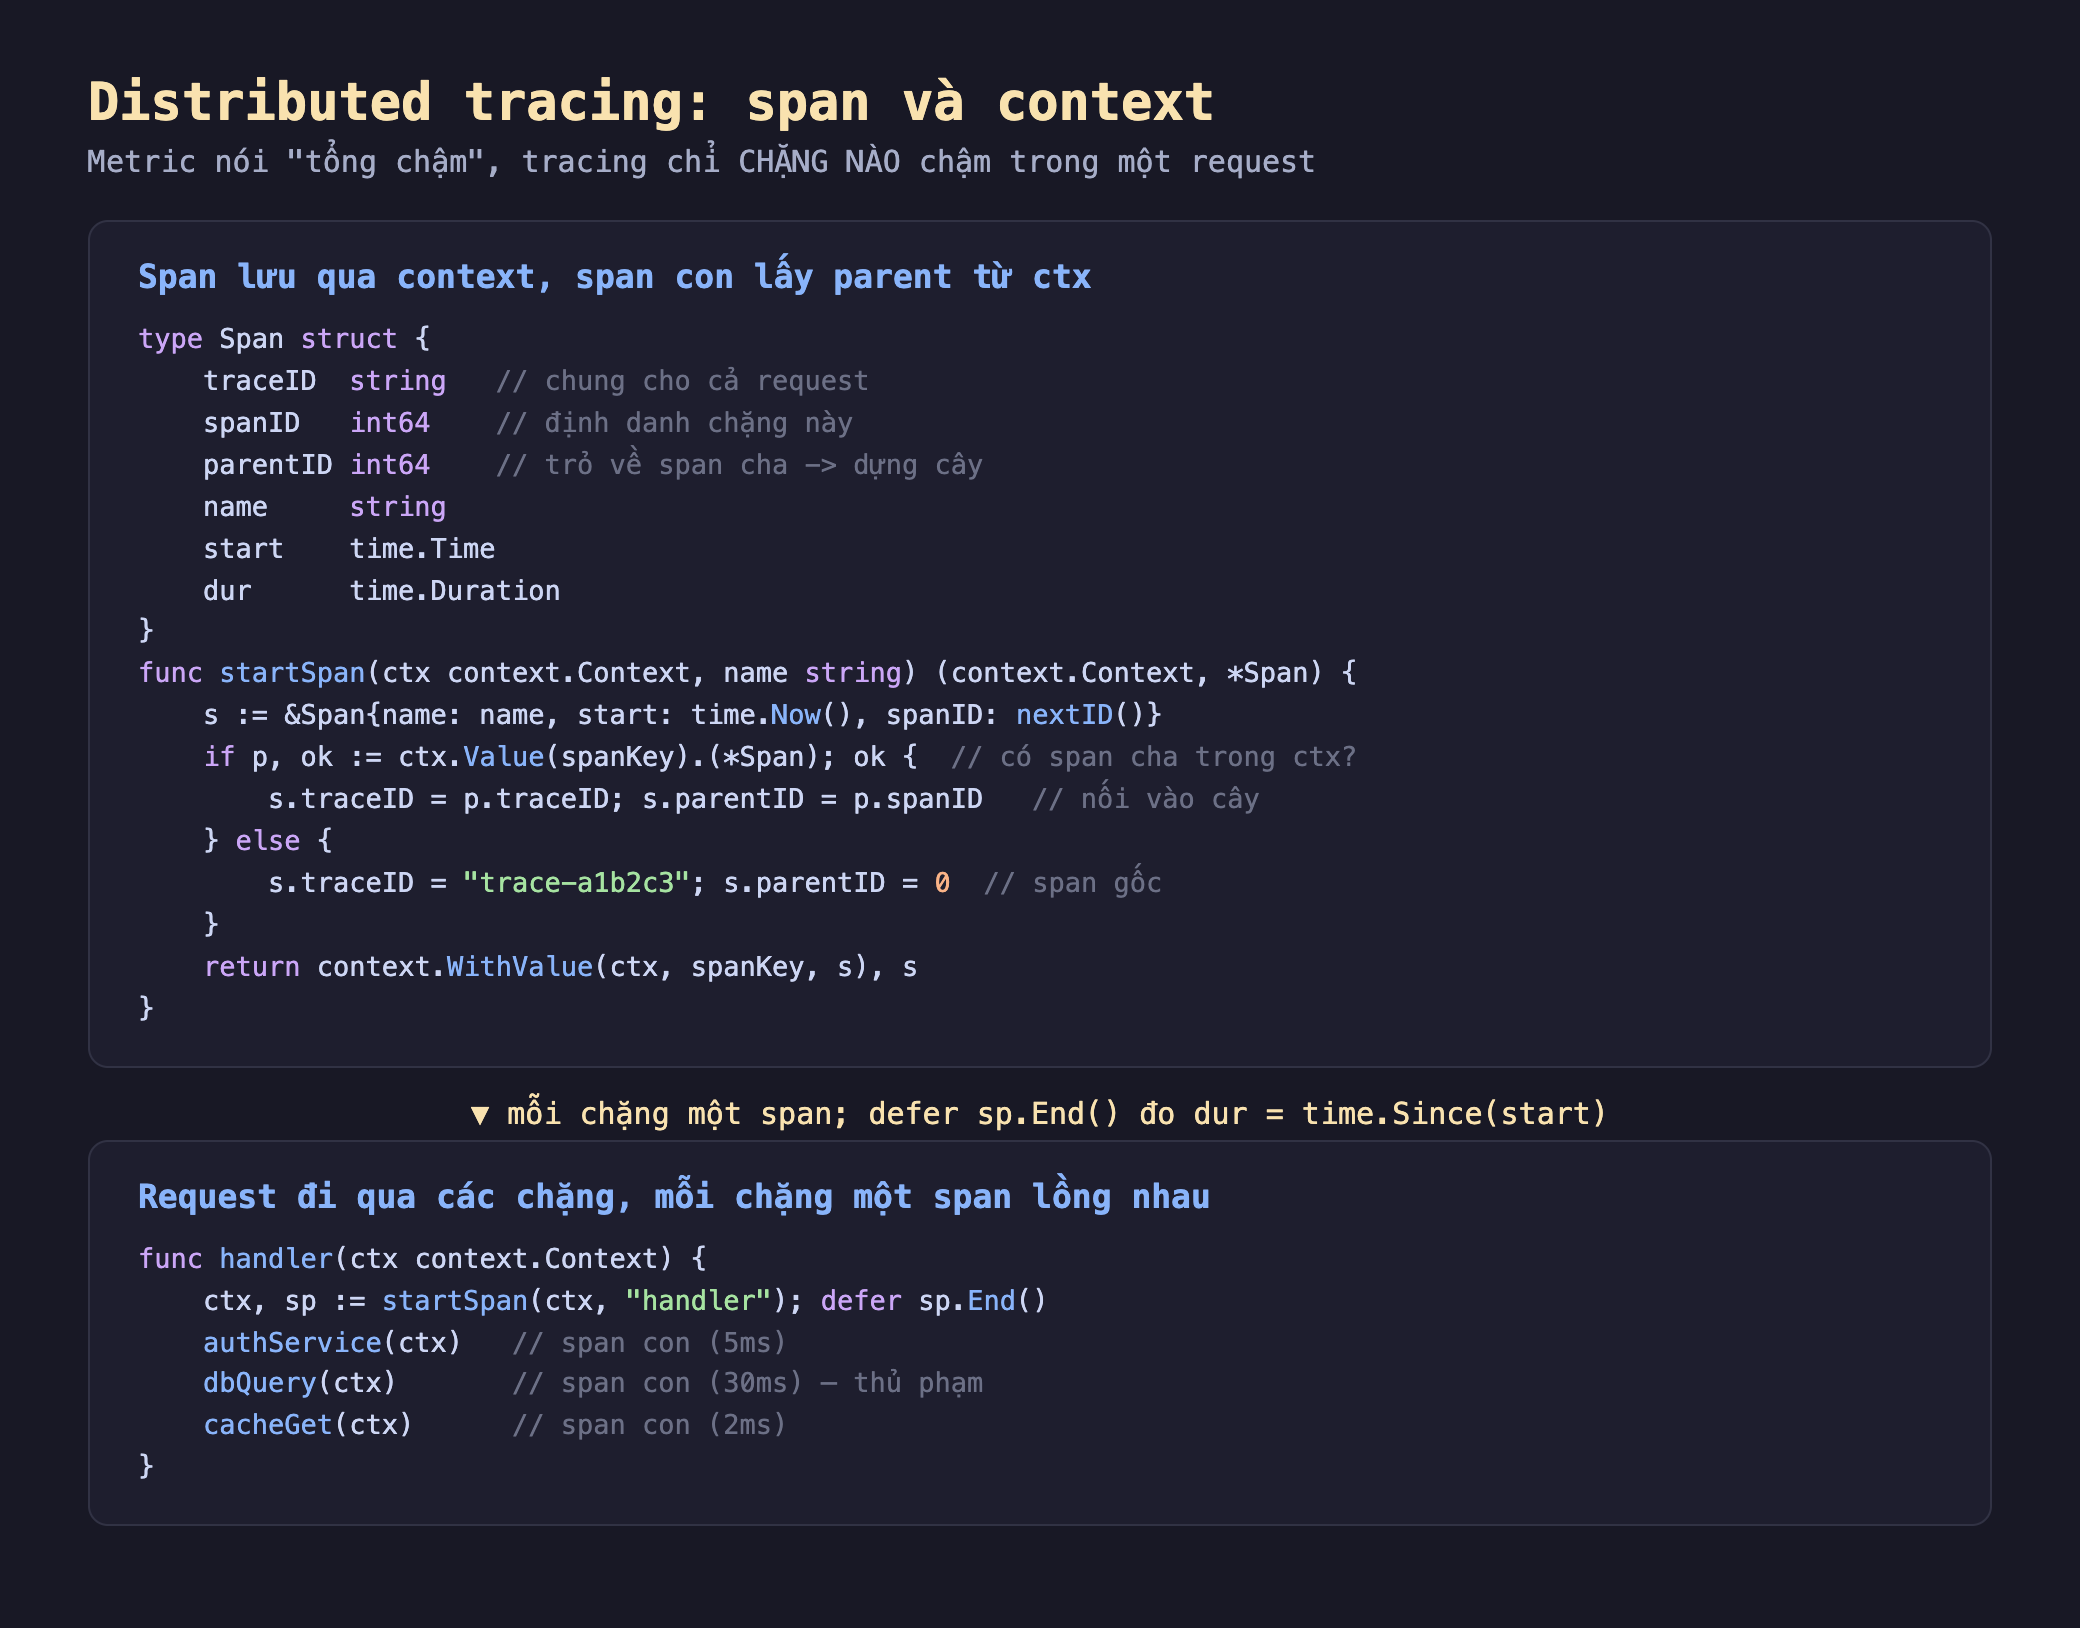
Hình 1: Span ghi traceID/spanID/parentID + thời gian; startSpan lấy span cha từ context — nếu có thì nối vào cây (cùng traceID, parentID = spanID cha), nếu không thì là span gốc. Mỗi chặng gọi startSpan rồi defer sp.End() để đo dur = time.Since(start).
Đây chính là lý do phần 2 (context propagation) là nền tảng: tracing là context propagation, chỉ thêm việc đo thời gian và ghi quan hệ cha-con. Nếu context được truyền xuyên suốt, cây span dựng lên chính xác một cách tự nhiên.
Đo thật trong go-lab
Mình tự cài tracer tối giản trên trong go-lab (golang 1.23) — không cần backend, chỉ thu span vào một slice. Một request giả đi qua handler → gọi tuần tự authService (5ms) → dbQuery (30ms) → cacheGet (2ms). Mỗi hàm mở một span con. Sau đó in cây span với thời gian thật đo bằng time.Since.
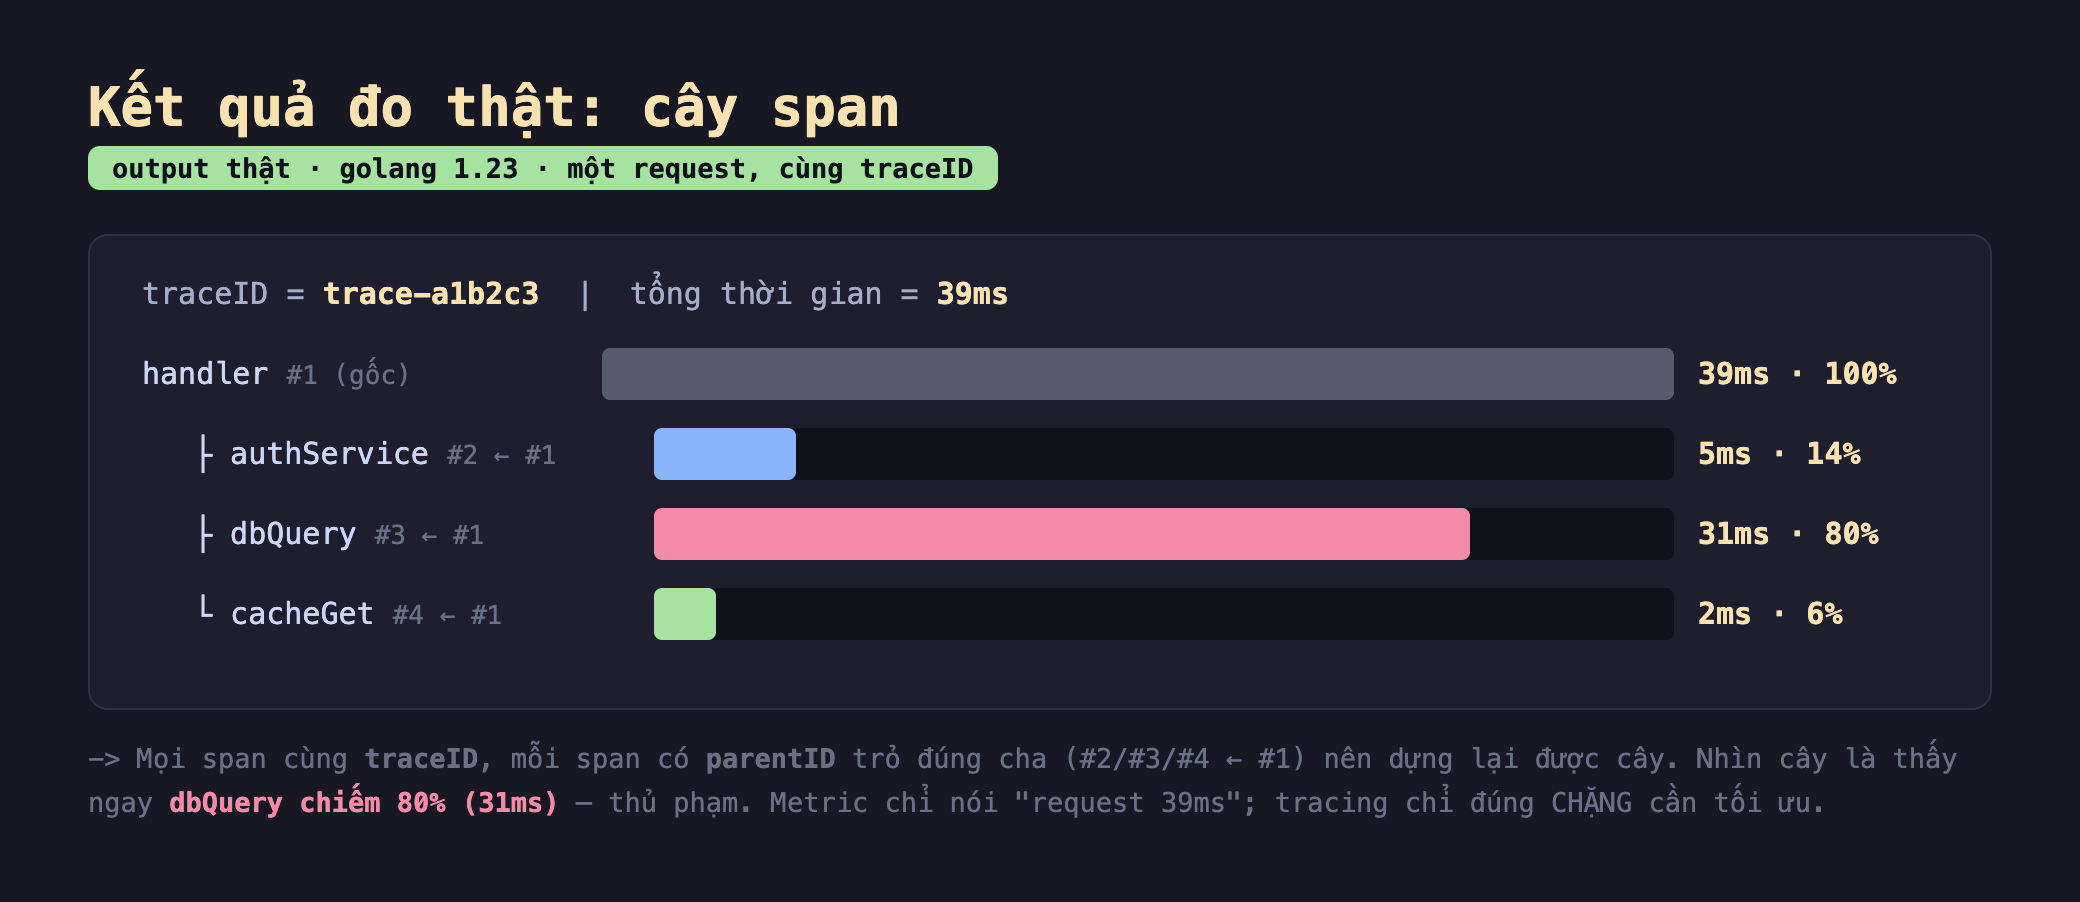
Hình 2: Kết quả thật — cây span của một request (tổng 39ms): handler gốc 100%, các span con authService 5ms (14%), dbQuery 31ms (80%), cacheGet 2ms (6%) — tất cả trỏ về cha #1. Nhìn cây là thấy ngay dbQuery là thủ phạm.
Cây span nói ngay điều mà metric không nói được:
- Thấy đúng chặng chậm. Tổng request 39ms — nếu chỉ có metric, bạn biết chừng đó. Nhưng cây span chỉ rõ:
dbQuerychiếm 31ms = 80% tổng thời gian, trong khiauthServicechỉ 5ms vàcacheGetchỉ 2ms. Không cần đoán: muốn giảm latency, tối ưudbQuery, không phí công vào hai chặng kia. - Quan hệ cha-con dựng lại cây. Mọi span cùng
traceID = trace-a1b2c3, và mỗi span con cóparentIDtrỏ đúng vềhandler(#1). Chính hai trường này cho phép một công cụ (hay ta) dựng lại cấu trúc lồng nhau từ một đống span rời rạc — kể cả khi span đến không theo thứ tự, hay đến từ nhiều máy khác nhau. - Waterfall là ngôn ngữ trực quan của tracing. Biểu đồ thác nước (mỗi span một thanh, độ dài tỉ lệ thời gian, thụt lề theo độ sâu) là cách các công cụ như Jaeger/Tempo hiển thị trace. Nhìn một cái là thấy chặng nào dài, chặng nào chạy song song, chặng nào nối tiếp.
Đánh đổi cần cân nhắc
Mỗi span tốn tài nguyên — nên cần sampling. Đây là cái giá thật của tracing: mỗi span là một bản ghi (id, tên, thời gian, thuộc tính) tốn RAM để giữ và băng thông để gửi về backend. Một request qua 20 chặng sinh 20 span; nhân với hàng triệu request là khối dữ liệu khổng lồ. Vì vậy production gần như luôn sampling — chỉ trace một phần request (ví dụ 1%), đủ để thấy bức tranh mà không sập chi phí. Cân bằng giữa "thấy đủ để chẩn đoán" và "không tốn quá nhiều" là cả một bài toán riêng (phần 11).
Span phải được kết thúc, kẻo rò. Mẫu chuẩn là ctx, sp := startSpan(...) rồi defer sp.End() ngay dòng sau. Quên End() là span không bao giờ đóng — rò bộ nhớ, và trace hiển thị sai (chặng đó "chạy mãi"). defer ngay sau khi tạo là kỷ luật bắt buộc, giống như defer file.Close(). Và như phần 2 nhấn mạnh: nếu quên truyền ctx xuống một hàm con, span của hàm đó sẽ mất cha (thành span mồ côi hoặc gốc sai), phá vỡ cây.
Tự cài tốt để hiểu, nhưng production dùng OpenTelemetry. Tracer tối giản ở đây tuyệt để hiểu cơ chế, nhưng thực tế nên dùng OpenTelemetry — chuẩn chung của ngành. Lý do: nó lo sẵn context propagation xuyên service (nhét trace context vào HTTP header traceparent như phần 2, để trace nối liền qua nhiều dịch vụ), có sẵn instrumentation cho các thư viện phổ biến (HTTP, gRPC, SQL), và xuất được sang các backend trực quan hoá (Jaeger, Tempo, Grafana) nơi bạn nhìn cây span thay vì đọc text. Tự cài chỉ chạy trong một tiến trình; sức mạnh thật của tracing là phân tán — thấy một request đi xuyên chục microservice.
Ba ý mang về
- Metric nói "có chậm", tracing chỉ "chậm ở chặng nào": đo thật, một request 39ms — cây span cho thấy
dbQuerychiếm 31ms = 80%,authService5ms,cacheGet2ms; không phải đoán, tối ưu đúng dbQuery. - Span lồng nhau qua context, nối bằng traceID + parentID: tracing là context propagation (phần 2) cộng đo thời gian; mọi span cùng
traceID, mỗi spanparentIDtrỏ về cha nên dựng lại được cây dù span đến rời rạc hay từ nhiều máy — hiển thị bằng biểu đồ thác nước. - Chi phí thật nên cần kỷ luật và công cụ chuẩn: mỗi span tốn RAM/băng thông nên production phải sampling (phần 11); luôn
defer sp.End()kẻo rò và vỡ cây; tự cài để hiểu nhưng dùng OpenTelemetry cho propagation xuyên service (headertraceparent) và backend trực quan hoá (Jaeger/Tempo).
Nguồn
- OpenTelemetry — Traces (spans, context propagation): https://opentelemetry.io/docs/concepts/signals/traces/
- OpenTelemetry Go — Getting started: https://opentelemetry.io/docs/languages/go/getting-started/
- Google — Dapper, a Large-Scale Distributed Systems Tracing Infrastructure: https://research.google/pubs/pub36356/
Phần sau ta chuyển từ "chặng nào chậm" sang "trong một chặng, hàm nào chậm": dùng pprof của Go để thu CPU profile và heap profile, tìm hàm ngốn CPU và điểm rò rỉ bộ nhớ ngay trong tiến trình đang chạy.
