Sau bốn phần về công cụ metric (expvar, histogram, Prometheus), giờ tới câu hỏi khó hơn công cụ: đo cái gì? Đây là chỗ nhiều đội mắc kẹt — hoặc đo quá ít (chỉ có "server còn sống không") rồi mù tịt lúc sự cố, hoặc đo quá nhiều (mọi biến, mọi hàm) khiến dashboard thành một mớ nhiễu, tín hiệu quan trọng chìm nghỉm, và cardinality nổ tung. Cần một cách chọn lọc metric có kỷ luật.
May thay, ngành đã đúc kết hai phương pháp luận ngắn gọn, bổ sung cho nhau. RED (Rate, Errors, Duration) — của Tom Wilkie — cho các thứ xử lý request (service, endpoint). USE (Utilization, Saturation, Errors) — của Brendan Gregg — cho tài nguyên (CPU, RAM, đĩa, connection pool, worker pool). Hai chữ E trùng nhau (đều đo lỗi), nhưng chúng nhìn hệ thống từ hai phía: RED nhìn từ người dùng, USE nhìn từ tài nguyên. Bài này (phần 6 loạt Observability) đo thật cả hai trên một service và cho thấy vì sao cần cả hai.
Cơ chế: RED cho service, USE cho tài nguyên
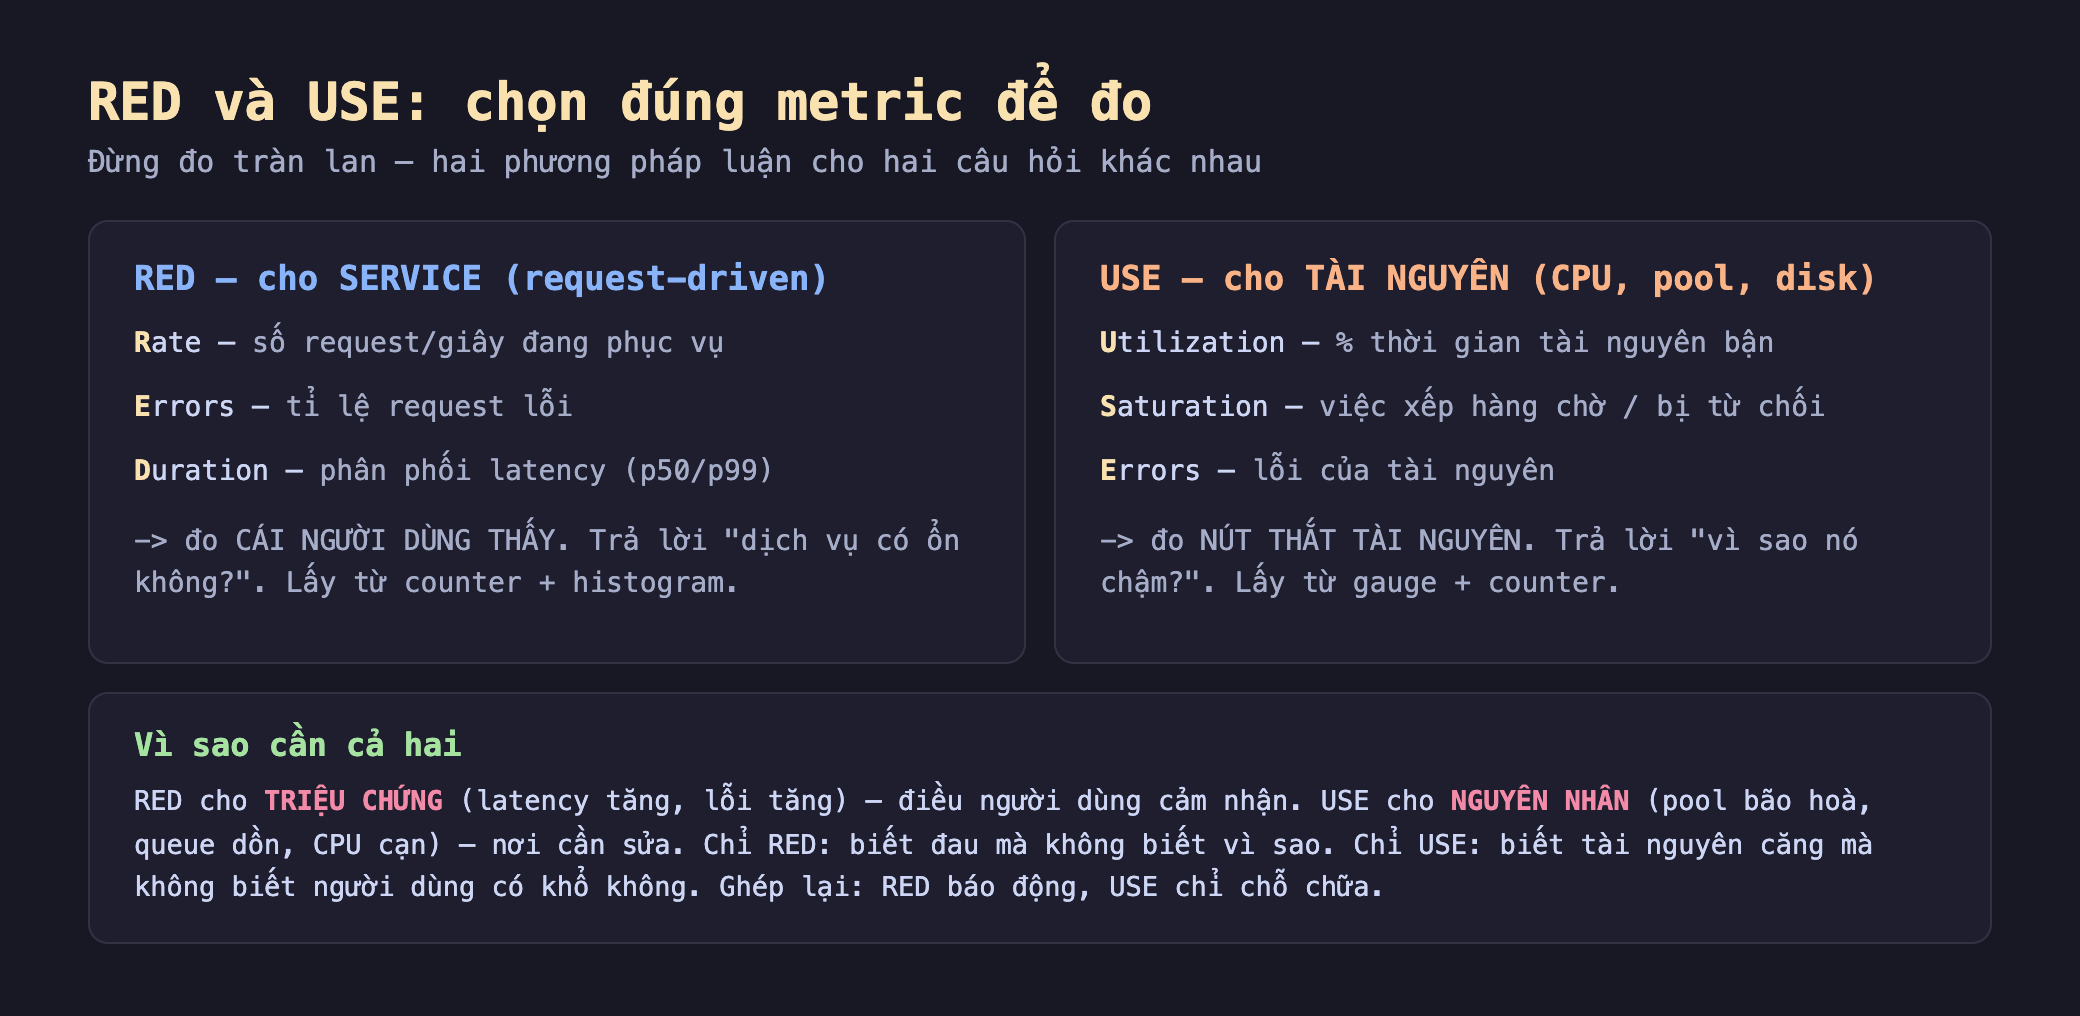
Hình 1: RED đo service từ góc người dùng — Rate (req/s), Errors (tỉ lệ lỗi), Duration (p50/p99), lấy từ counter + histogram. USE đo tài nguyên — Utilization (% bận), Saturation (xếp hàng/bị từ chối), Errors, lấy từ gauge + counter. RED cho triệu chứng, USE cho nguyên nhân.
Ý tưởng chọn lọc: với mỗi service bạn vận hành, đo ba con số RED. Với mỗi tài nguyên có giới hạn, đo ba con số USE. Không nhiều hơn cần thiết, không ít hơn đủ dùng. Cách này trả lời được hai câu hỏi tách bạch lúc sự cố: "dịch vụ có đang tệ với người dùng không?" (RED) và "tài nguyên nào là nút thắt?" (USE).
Đo thật trong go-lab
Mình dựng trong go-lab (golang 1.23) một service có worker pool 8 worker + hàng đợi (request chờ quá 20ms không có slot thì bị từ chối). Đo cả RED lẫn USE ở hai mức tải: thấp (~180 req/s, dưới năng lực) và cao (burst ~5000 req/s, vượt xa năng lực).
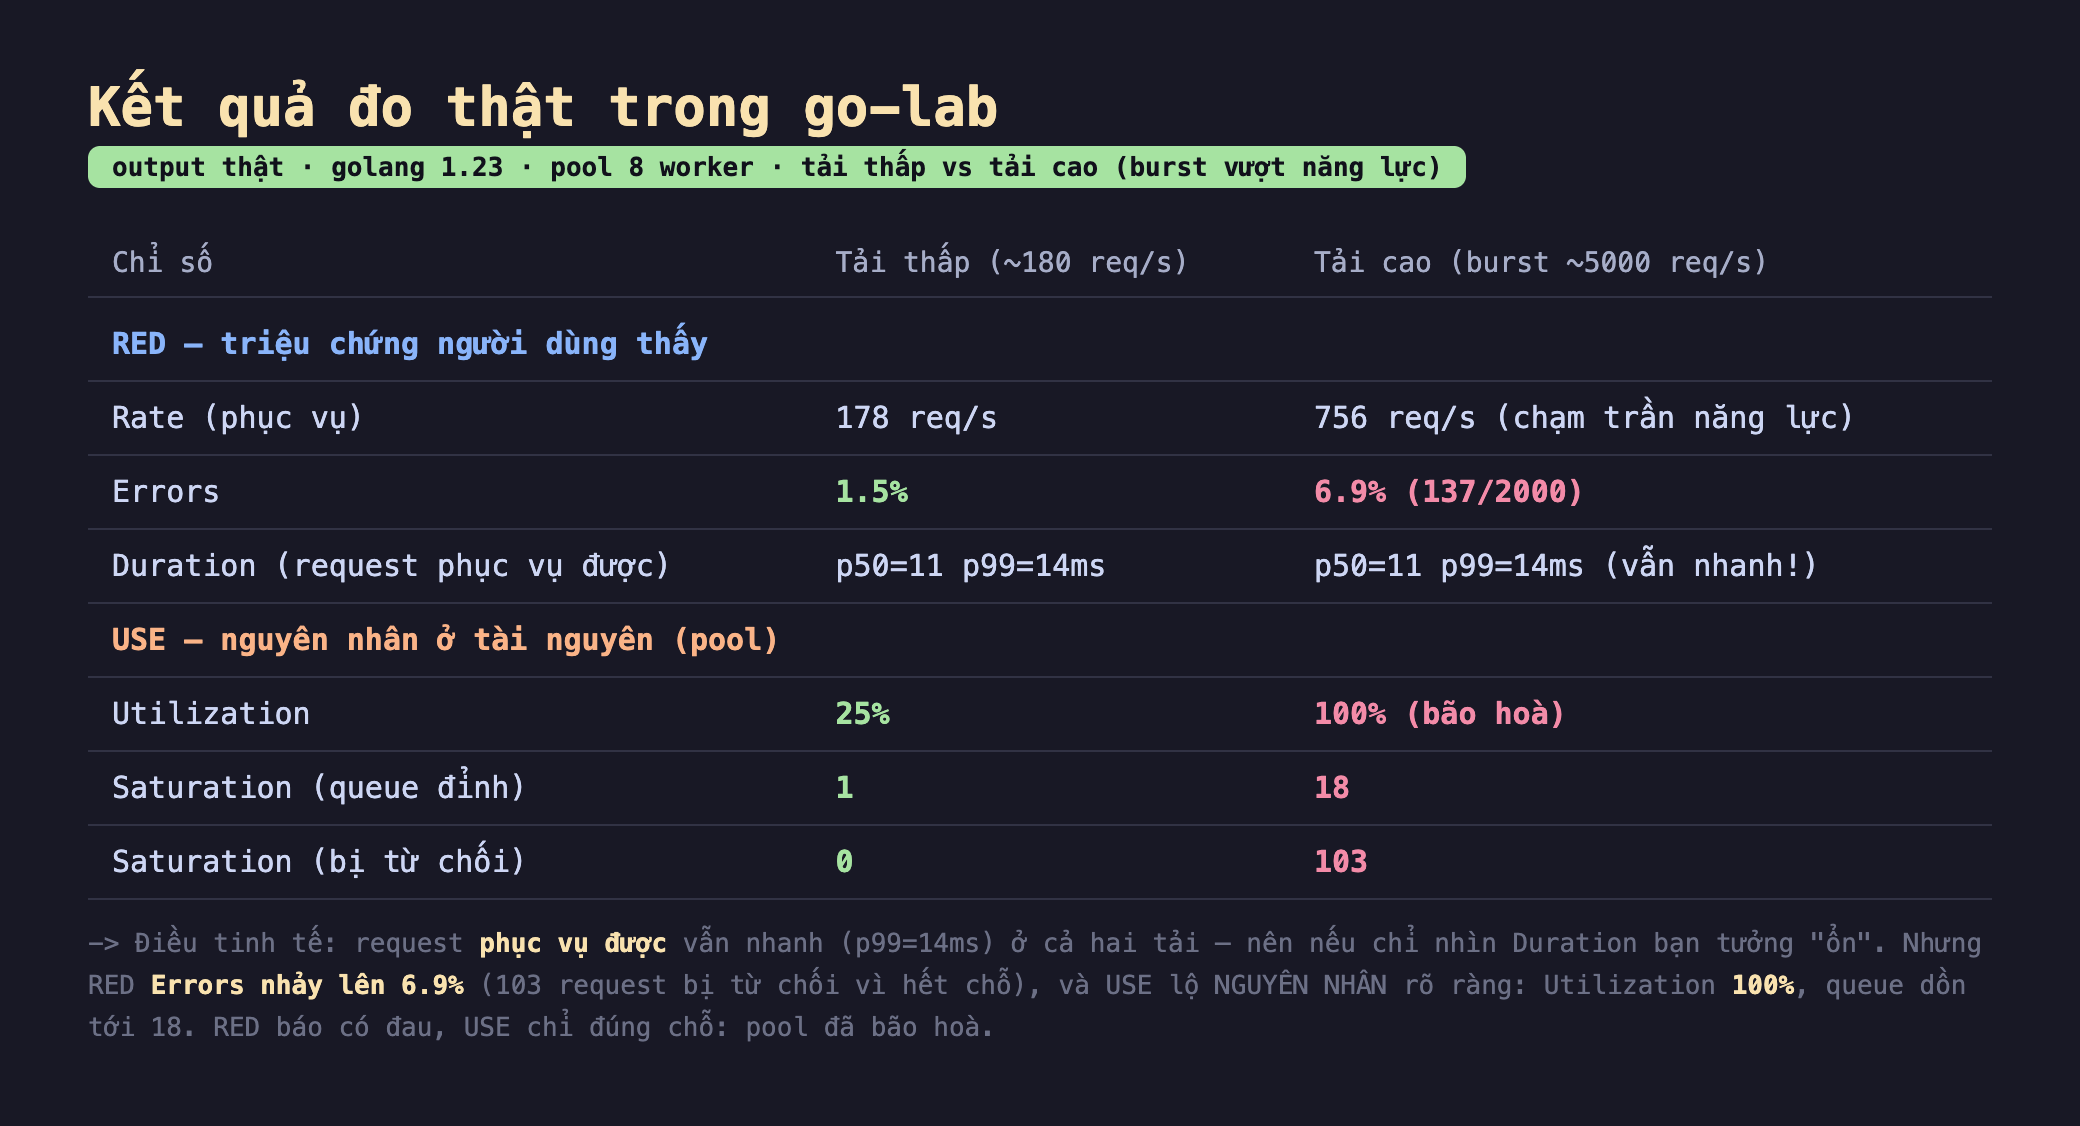
Hình 2: Kết quả thật — RED: khi tải tăng, Errors nhảy từ 1.5% lên 6.9% nhưng Duration của request phục vụ được vẫn p99=14ms; USE lộ nguyên nhân: Utilization từ 25% lên 100% (bão hoà), queue đỉnh từ 1 lên 18, bị từ chối từ 0 lên 103.
Kết quả kể một câu chuyện tinh tế và rất thực tế:
- Duration của request phục vụ được không tăng — đây là cái bẫy. Cả hai tải đều cho p50=11ms, p99=14ms. Nếu bạn chỉ nhìn Duration (như nhiều dashboard mặc định), bạn sẽ kết luận "dịch vụ vẫn nhanh, ổn cả". Nhưng đó là ảo giác: những request được phục vụ thì nhanh, còn nhiều request khác đã bị từ chối trước cả khi vào xử lý — chúng không có mặt trong thống kê latency.
- RED Errors mới bắt được cơn đau. Tỉ lệ lỗi nhảy từ 1.5% lên 6.9% — 103 request bị từ chối vì hết chỗ. Đây là tín hiệu RED cho thấy người dùng đang khổ, dù Duration im lặng. Bài học: trong ba chữ RED, đừng chỉ nhìn Duration; Errors thường là cái báo động sớm nhất khi hệ quá tải kiểu "từ chối bớt".
- USE chỉ thẳng nguyên nhân. RED nói "có 6.9% lỗi" nhưng không nói vì sao. USE trả lời ngay: Utilization của pool đạt 100% (mọi worker bận liên tục — bão hoà), queue chờ dồn tới 18, và 103 request bị từ chối. Rõ ràng: pool 8 worker đã cạn năng lực. Muốn sửa? Tăng worker, hoặc giảm thời gian xử lý mỗi request, hoặc thêm backpressure/autoscale. USE chỉ đúng chỗ để chữa.
Đây chính là lý do cần cả hai: RED một mình cho biết "có đau" nhưng không biết chữa ở đâu; USE một mình cho biết "pool căng" nhưng không biết người dùng có thực sự khổ không (có thể pool 100% mà vẫn phục vụ kịp, chưa ai bị từ chối). Ghép lại, chúng thành một cặp chẩn đoán hoàn chỉnh: RED báo động, USE định vị.
Đánh đổi cần cân nhắc
Đo tràn lan làm loãng tín hiệu và tốn cardinality. Cám dỗ lớn nhất là "đo hết cho chắc" — mọi biến, mọi hàm, mọi trạng thái. Kết quả phản tác dụng: dashboard hàng trăm biểu đồ khiến lúc sự cố bạn không biết nhìn đâu, và mỗi metric thừa (nhất là có label) tốn cardinality, tiền lưu trữ, và công sức bảo trì. RED/USE là bộ lọc: chỉ đo cái trả lời được câu hỏi bạn sẽ hỏi lúc 3 giờ sáng. Nếu một metric không giúp trả lời "người dùng có ổn không" hay "tài nguyên nào là nút thắt", cân nhắc bỏ nó.
RED và USE không phủ hết mọi thứ — chúng là điểm khởi đầu, không phải giới hạn. Hai phương pháp này tuyệt cho service và tài nguyên dạng chuẩn, nhưng có những thứ chúng không nắm: chất lượng dữ liệu, tính đúng đắn nghiệp vụ (đơn hàng có được xử lý đúng không?), các chỉ số sản phẩm. Với hệ thống hàng đợi/streaming, còn có phương pháp khác nhấn mạnh độ trễ tồn đọng (như tuổi message cũ nhất chưa xử lý). Dùng RED/USE làm nền, rồi bổ sung metric nghiệp vụ đặc thù — đừng coi chúng là danh sách đầy đủ.
Chọn "tài nguyên" nào để áp USE cũng là một quyết định. USE áp cho mọi tài nguyên có giới hạn, nhưng liệt kê hết tài nguyên trong một hệ thống thật không hề tầm thường: CPU, RAM, đĩa, băng thông mạng, connection pool DB, worker pool, file descriptor, thread... Bỏ sót một cái là bỏ sót một nút thắt tiềm tàng (như bài fd leak/RSS trong loạt Debug trước cho thấy). Cách làm: liệt kê tài nguyên có hạn theo đường đi của request, áp USE cho từng cái — chính công việc liệt kê đó đã là một bài tập chẩn đoán giá trị.
Ba ý mang về
- RED cho service, USE cho tài nguyên — chọn metric có kỷ luật: RED (Rate, Errors, Duration) đo từ góc người dùng; USE (Utilization, Saturation, Errors) đo từ góc tài nguyên; áp RED cho mỗi service, USE cho mỗi tài nguyên có giới hạn, không đo tràn lan.
- RED cho triệu chứng, USE cho nguyên nhân — cần cả hai: đo thật, khi pool quá tải, RED Errors nhảy từ 1.5% lên 6.9% (báo có đau) trong khi Duration request phục vụ vẫn p99=14ms (bẫy!); USE chỉ đúng nguyên nhân — Utilization 100%, queue 18, 103 bị từ chối.
- Đừng chỉ nhìn Duration, và đừng đo tràn lan: dưới kiểu quá tải "từ chối bớt", latency của request được phục vụ vẫn đẹp — Errors mới là báo động sớm; đo tràn lan làm loãng tín hiệu và nổ cardinality, nên chỉ đo cái trả lời được câu hỏi bạn sẽ hỏi lúc sự cố.
Nguồn
- Tom Wilkie — The RED Method: https://grafana.com/blog/2018/08/02/the-red-method-how-to-instrument-your-services/
- Brendan Gregg — The USE Method: https://www.brendangregg.com/usemethod.html
- Google SRE Book — The Four Golden Signals: https://sre.google/sre-book/monitoring-distributed-systems/#xref_monitoring_golden-signals
Phần sau ta sang trụ cột thứ ba — tracing: từ trace_id của phần 2, dựng các span lồng nhau truyền qua context để thấy một request đi qua những chặng nào và mỗi chặng tốn bao lâu, đo thật cây span.
