Phần 3 kết thúc với một giới hạn của expvar: nó chỉ có số vô hướng, không có label (không tách request_total theo endpoint/status) và không có histogram (không đo phân phối latency). Phần 4 cho thấy histogram và percentile quan trọng thế nào. Giờ ta ghép cả hai bằng công cụ chuẩn de-facto của ngành: Prometheus và thư viện client_golang cho Go. Đây là thứ chạy trong hầu hết hệ thống production hiện đại để thu metric.
Prometheus có hai phần: một thư viện client mà ứng dụng dùng để khai và ghi metric, expose chúng qua một endpoint HTTP (/metrics); và một server Prometheus định kỳ scrape (kéo) endpoint đó để thu số liệu về. Bài này (phần 5 loạt Observability) tập trung phần client trong Go — đo thật cách khai counter/histogram có label, và quan trọng là đọc định dạng exposition mà /metrics phơi ra, vì hiểu định dạng đó là hiểu Prometheus hoạt động thế nào.
Cơ chế: CounterVec, HistogramVec, và promhttp
client_golang cung cấp các kiểu metric có hậu tố Vec (vector) — nghĩa là có label. Một CounterVec với label method và status thực chất là một họ counter: mỗi tổ hợp giá trị label (GET+200, GET+500, POST+200...) là một counter riêng. Tương tự HistogramVec cho phép đo latency tách theo method.
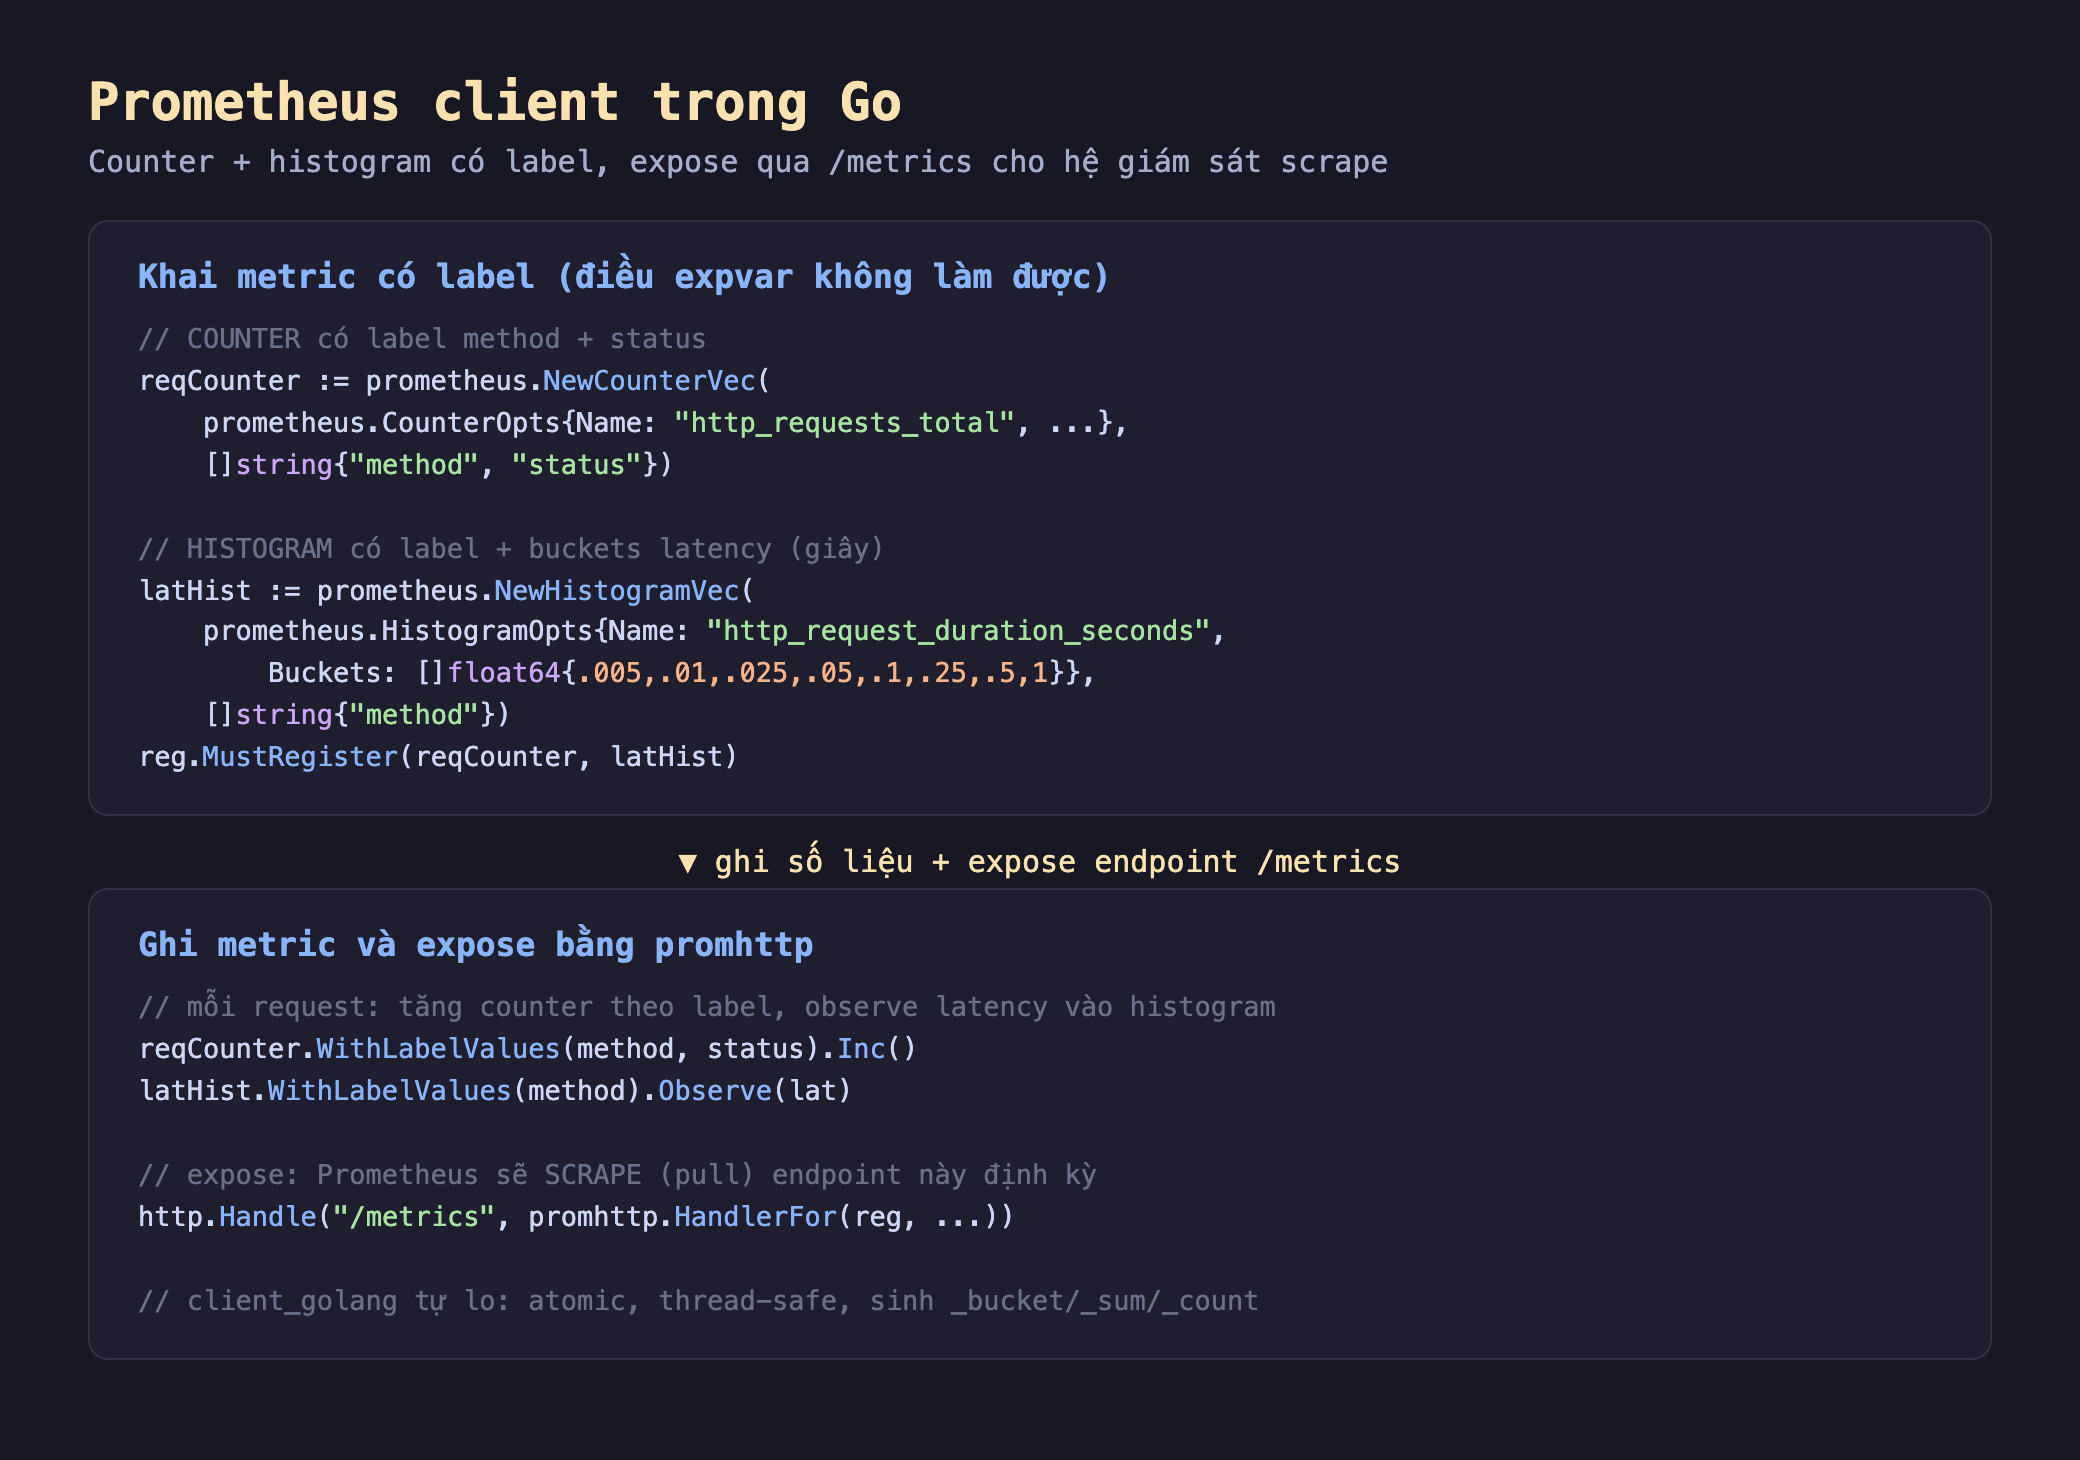
Hình 1: Khai CounterVec (label method, status) và HistogramVec (buckets latency) rồi MustRegister. Mỗi request gọi WithLabelValues(...).Inc() và .Observe(lat); endpoint /metrics phơi tất cả qua promhttp.HandlerFor. Thư viện tự lo atomic, thread-safe và sinh các dòng _bucket/_sum/_count.
Điểm hay: bạn không phải tự viết atomic (như bài expvar), không phải tự dựng histogram (như bài trước) — client_golang lo hết. Bạn chỉ khai metric, gọi Inc()/Observe(), và gắn promhttp.Handler vào /metrics.
Đo thật trong go-lab
Mình cài client_golang@v1.19.1 trong go-lab (golang 1.23; pin version này để hợp toolchain, và go mod tidy để kéo đủ dependency). Tung 1000 request giả (một nửa GET, một nửa POST; 5% lỗi 500; 5% latency đuôi dài), rồi curl /metrics đọc output thật.
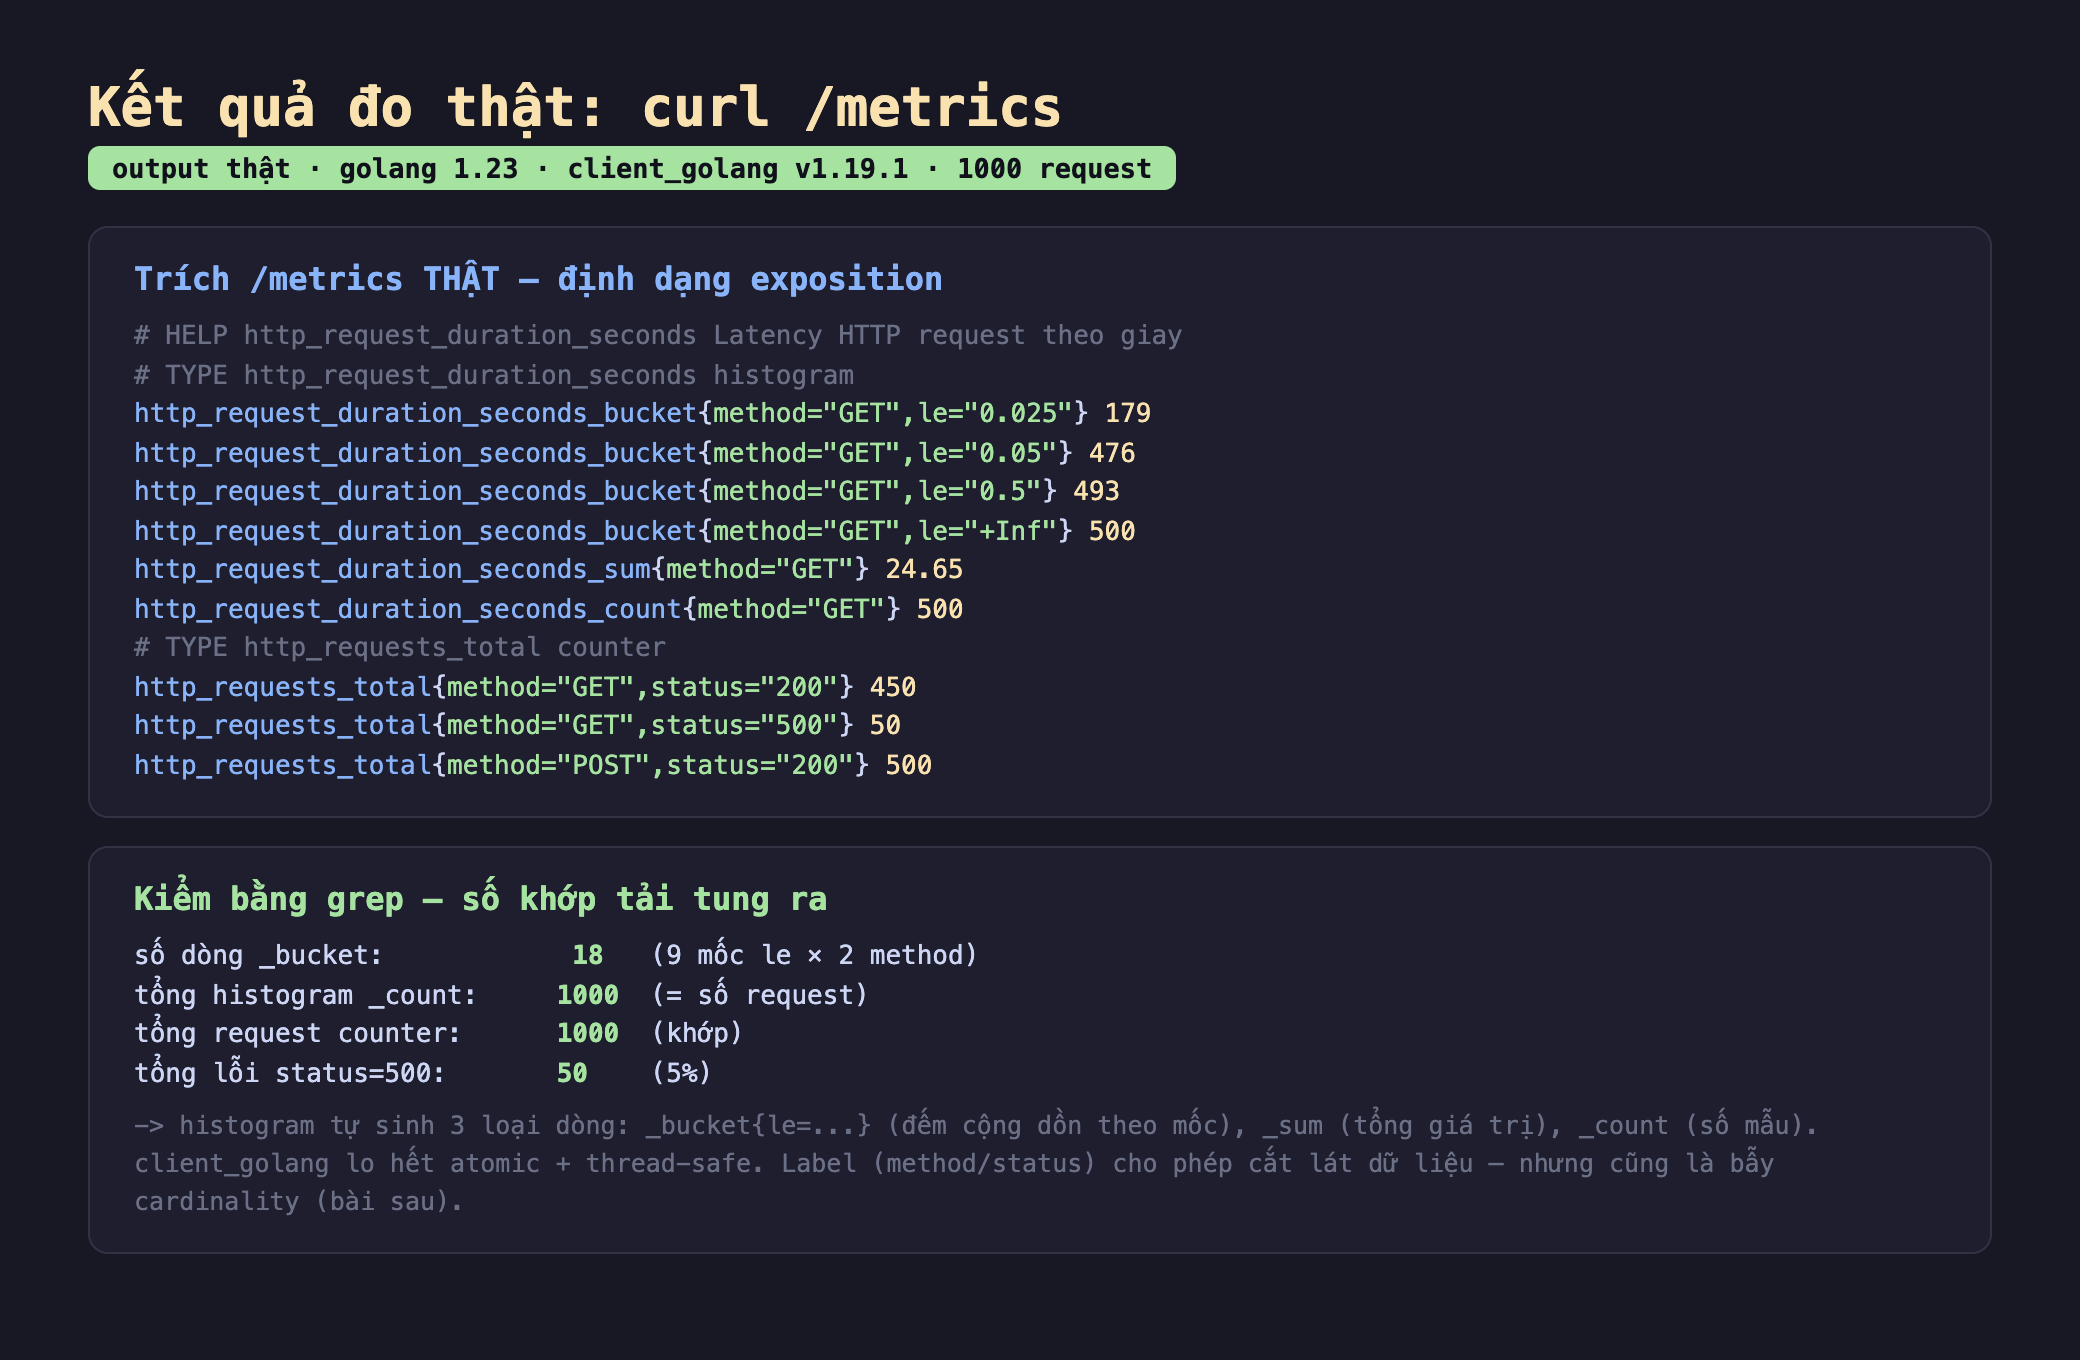
Hình 2: Kết quả thật — /metrics phơi định dạng exposition: mỗi metric có dòng # HELP/# TYPE, histogram tự sinh các dòng _bucket{le=...} (đếm cộng dồn), _sum, _count; counter tách theo label. Kiểm grep: 18 dòng _bucket (9 mốc × 2 method), tổng _count = 1000 (khớp số request), tổng counter = 1000, lỗi 500 = 50.
Đọc kỹ output thật cho thấy cách Prometheus tổ chức dữ liệu:
- Định dạng exposition là text đơn giản. Mỗi metric có
# HELP(mô tả) và# TYPE(counter/histogram/gauge), rồi các dòngtên_metric{label="giá trị"} số. Đây là định dạng mà Prometheus server đọc khi scrape — dễ đọc bằng mắt, dễ parse bằng máy. - Histogram tự nở thành nhiều dòng. Một
HistogramVecvới 8 bucket + labelmethodsinh ra rất nhiều dòng: mỗi_bucket{le="..."}là số mẫu cộng dồn ≤ mốc đó (le= "less than or equal"), cộngle="+Inf"(tổng), rồi_sum(tổng mọi giá trị) và_count(số mẫu). Đây chính là cấu trúc histogram của bài trước, giờ do thư viện sinh tự động — và từ_bucketnày Prometheus tính được percentile bằng hàmhistogram_quantile. - Số liệu khớp tải, kiểm được bằng grep. 18 dòng
_bucket(9 mốcle× 2method), tổng_count= 1000 (đúng số request), tổng counter = 1000, lỗi 500 = 50 (5%). Mọi con số nhất quán — vìclient_golangdùng atomic bên trong, không mất cập nhật dù nghìn goroutine cùng ghi.
Sức mạnh của label lộ rõ: cùng một metric http_requests_total, giờ bạn cắt lát được theo method và status — "bao nhiêu POST lỗi 500?" trả lời được ngay, điều expvar không làm nổi.
Đánh đổi cần cân nhắc
Label mạnh nhưng cardinality là cái bẫy chết người. Mỗi tổ hợp giá trị label tạo một chuỗi thời gian (time series) riêng trong Prometheus. method (2 giá trị) × status (vài giá trị) là an toàn. Nhưng nếu lỡ để một label có giá trị không giới hạn — user_id, request_id, url đầy đủ tham số — bạn tạo hàng triệu chuỗi thời gian, làm nổ bộ nhớ Prometheus và có thể sập cả hệ giám sát. Đây là lỗi phổ biến nhất khi dùng Prometheus, và nghiêm trọng tới mức có hẳn một bài riêng (phần 10). Quy tắc vàng: label chỉ dùng cho tập giá trị hữu hạn, biết trước (method, status code, region), không bao giờ cho ID hay giá trị tự do.
Bucket histogram cố định lúc khai — đổi là mất so sánh lịch sử. Bạn chọn Buckets khi khai HistogramVec, và chúng "đóng băng". Nếu sau này đổi bộ bucket (thêm/bớt mốc), dữ liệu cũ và mới không so sánh trực tiếp được nữa, và các truy vấn/dashboard dựa trên bucket cũ có thể vỡ. Vì vậy chọn bucket ngay từ đầu cho đúng dải latency quan trọng (như bài 4 nhấn mạnh) — đây là quyết định khó sửa về sau.
Mô hình pull (scrape) có đánh đổi so với push. Prometheus kéo metric bằng cách gọi /metrics định kỳ, thay vì ứng dụng đẩy metric đi. Pull có lợi: Prometheus tự biết target nào "sống" (scrape thất bại = target chết, thành một tín hiệu miễn phí), và ứng dụng không cần biết địa chỉ hệ giám sát. Nhưng pull khó với các job ngắn (chạy xong đã thoát trước khi bị scrape — cần Pushgateway) và với mạng mà Prometheus không gọi vào được (sau NAT/firewall). Hiểu mô hình để biết khi nào cần giải pháp bổ sung.
/metrics cũng cần bảo vệ. Giống /debug/vars của expvar, endpoint /metrics phơi thông tin nội bộ (tên endpoint, tỉ lệ lỗi, thậm chí gợi ý về kiến trúc). Trên production, đặt nó sau xác thực hoặc trên cổng/mạng nội bộ chỉ Prometheus truy cập được, đừng hở thẳng ra Internet.
Ba ý mang về
client_golangcho Go: counter/histogram có label, expose qua/metrics: đo thật,CounterVec+HistogramVeckhai vài dòng, thư viện lo atomic/thread-safe; tung 1000 request rồicurl /metricsthấy đúng định dạng exposition (# HELP/# TYPE,tên{label} giá trị), số liệu khớp tải (tổng count 1000, lỗi 50).- Histogram tự nở thành
_bucket/_sum/_count: mỗi_bucket{le="x"}là số mẫu cộng dồn ≤ x; đo thật 18 dòng_bucket(9 mốc × 2 method); từ đây Prometheus tính percentile bằnghistogram_quantile— chính là cơ chế histogram của bài trước, do thư viện sinh tự động. - Label mạnh nhưng cardinality là bẫy, và mô hình là pull: label chỉ dùng cho tập giá trị hữu hạn biết trước (method/status), tuyệt đối không cho ID/giá trị tự do (nổ chuỗi thời gian); bucket đóng băng lúc khai (đổi = mất so sánh lịch sử); Prometheus scrape (pull) nên tự biết target sống/chết, nhưng cần Pushgateway cho job ngắn; và
/metricsphải được bảo vệ.
Nguồn
- Prometheus — Go client library (client_golang): https://prometheus.io/docs/guides/go-application/
- Prometheus — Exposition formats: https://prometheus.io/docs/instrumenting/exposition_formats/
- Prometheus — Why pull rather than push: https://prometheus.io/docs/introduction/faq/#why-do-you-pull-rather-than-push
Phần sau ta lùi lại hỏi một câu quan trọng hơn công cụ: đo cái gì? Hai phương pháp luận RED (Rate, Errors, Duration) cho service và USE (Utilization, Saturation, Errors) cho tài nguyên giúp chọn đúng metric thay vì đo tràn lan.
