Có một con số mà gần như mọi dashboard đều hiển thị, và gần như luôn gây hiểu lầm: latency trung bình. "API của chúng ta phản hồi trung bình 45ms" — nghe thật yên tâm. Nhưng trung bình có một tật chết người với dữ liệu latency: nó bị đuôi kéo. Nếu 95% request nhanh 15ms nhưng 5% chậm 700ms (vì một query DB thỉnh thoảng chậm, một lần GC, một cái lock), trung bình sẽ nhảy lên ~45ms — một con số mà không một request nào thực sự trải nghiệm. Nhóm nhanh thấy 15ms, nhóm khổ thấy 700ms, và 45ms rơi vào khoảng trống giữa hai nhóm.
Đây là lý do các kỹ sư nghiêm túc về hiệu năng không nhìn trung bình, mà nhìn percentile: p50 (trung vị — một nửa nhanh hơn mức này), p95, p99 (1% chậm nhất chịu mức này). Và để đo percentile hiệu quả ở quy mô lớn — hàng triệu request, nhiều máy — công cụ là histogram. Bài này (phần 4 loạt Observability) đo thật vì sao trung bình nói dối, và histogram xấp xỉ percentile ra sao (kèm cái giá của sự xấp xỉ đó).
Cơ chế: percentile và histogram
Percentile trả lời câu hỏi đúng: "trải nghiệm tệ nhất của phần lớn người dùng là bao nhiêu?". p99 = 725ms nghĩa là 99% request nhanh hơn 725ms, và 1% chậm hơn — đó là những người dùng đang bực bội, và 1% của hàng triệu request là con số lớn.
Cách chính xác để tính percentile là giữ toàn bộ mẫu, sort, rồi lấy phần tử ở vị trí tương ứng. Nhưng giữ toàn bộ mẫu là bất khả thi ở quy mô production (hàng triệu số mỗi phút, nhân nhiều máy). Giải pháp là histogram: chia trục giá trị thành các bucket cố định, và chỉ đếm số mẫu rơi vào mỗi bucket — không giữ mẫu nào.
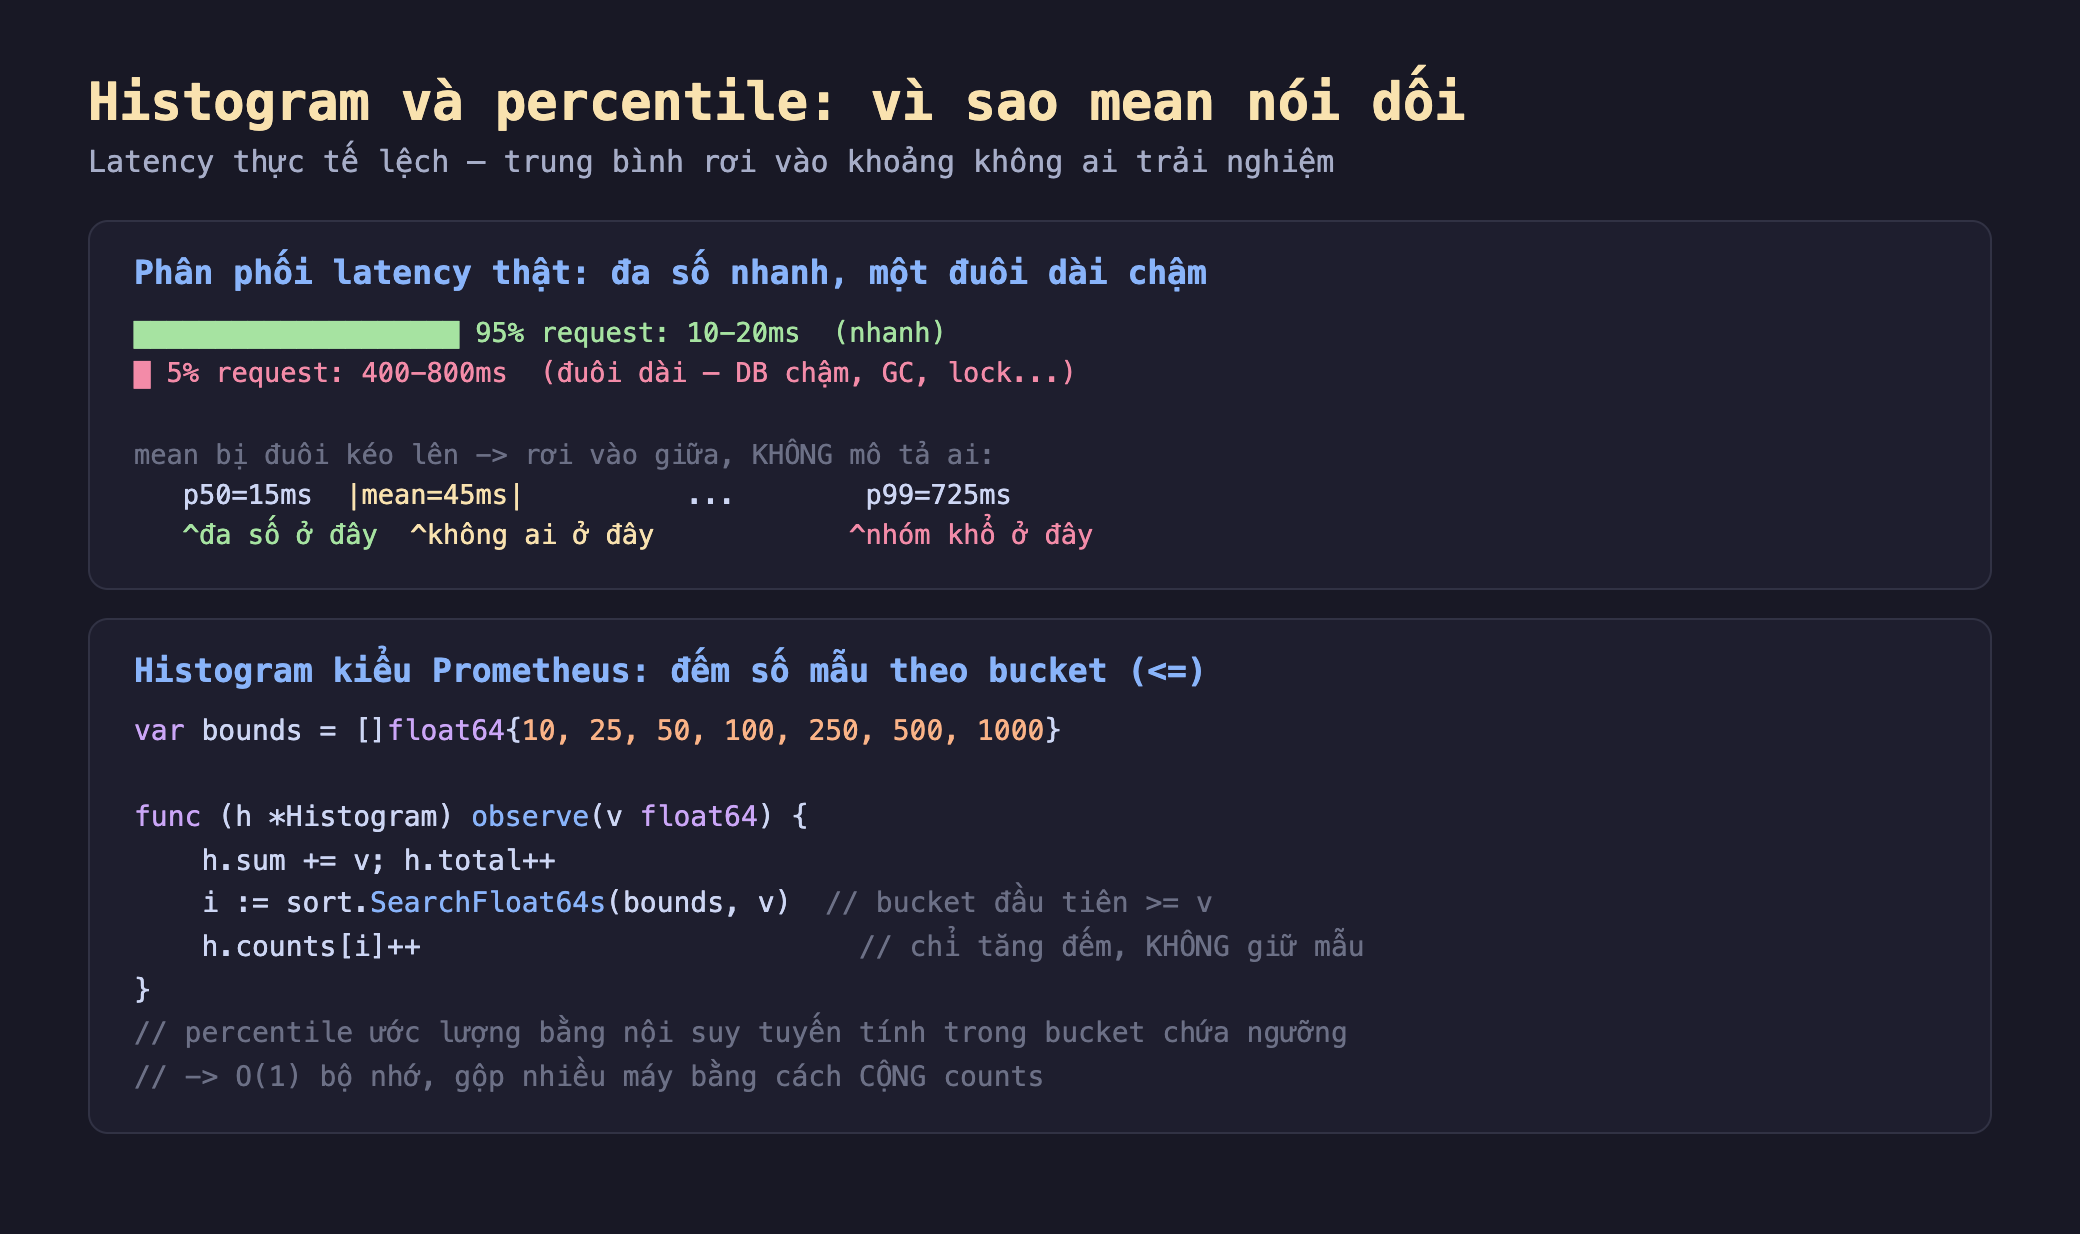
Hình 1: Latency thực tế lệch — 95% nhanh, 5% đuôi dài — khiến mean (45ms) rơi vào khoảng không ai trải nghiệm, giữa p50 (15ms) và p99 (725ms). Histogram kiểu Prometheus chia giá trị thành bucket (bounds), mỗi observe chỉ tăng đếm bucket tương ứng (không giữ mẫu), rồi ước lượng percentile bằng nội suy trong bucket chứa ngưỡng.
Vì histogram chỉ giữ số đếm cho mỗi bucket, nó tốn bộ nhớ cố định bất kể có bao nhiêu mẫu — và quan trọng không kém, hai histogram từ hai máy gộp được bằng cách cộng các đếm bucket tương ứng. Đây là lý do Prometheus và mọi hệ metric hiện đại dùng histogram cho latency.
Đo thật trong go-lab
Mình sinh 100.000 mẫu latency trong go-lab (golang 1.23) với phân phối lệch thật: 95% nhanh (10-20ms), 5% đuôi dài (400-800ms). Rồi so trung bình với percentile, và so percentile ước lượng từ histogram với percentile chính xác từ mảng đã sort.
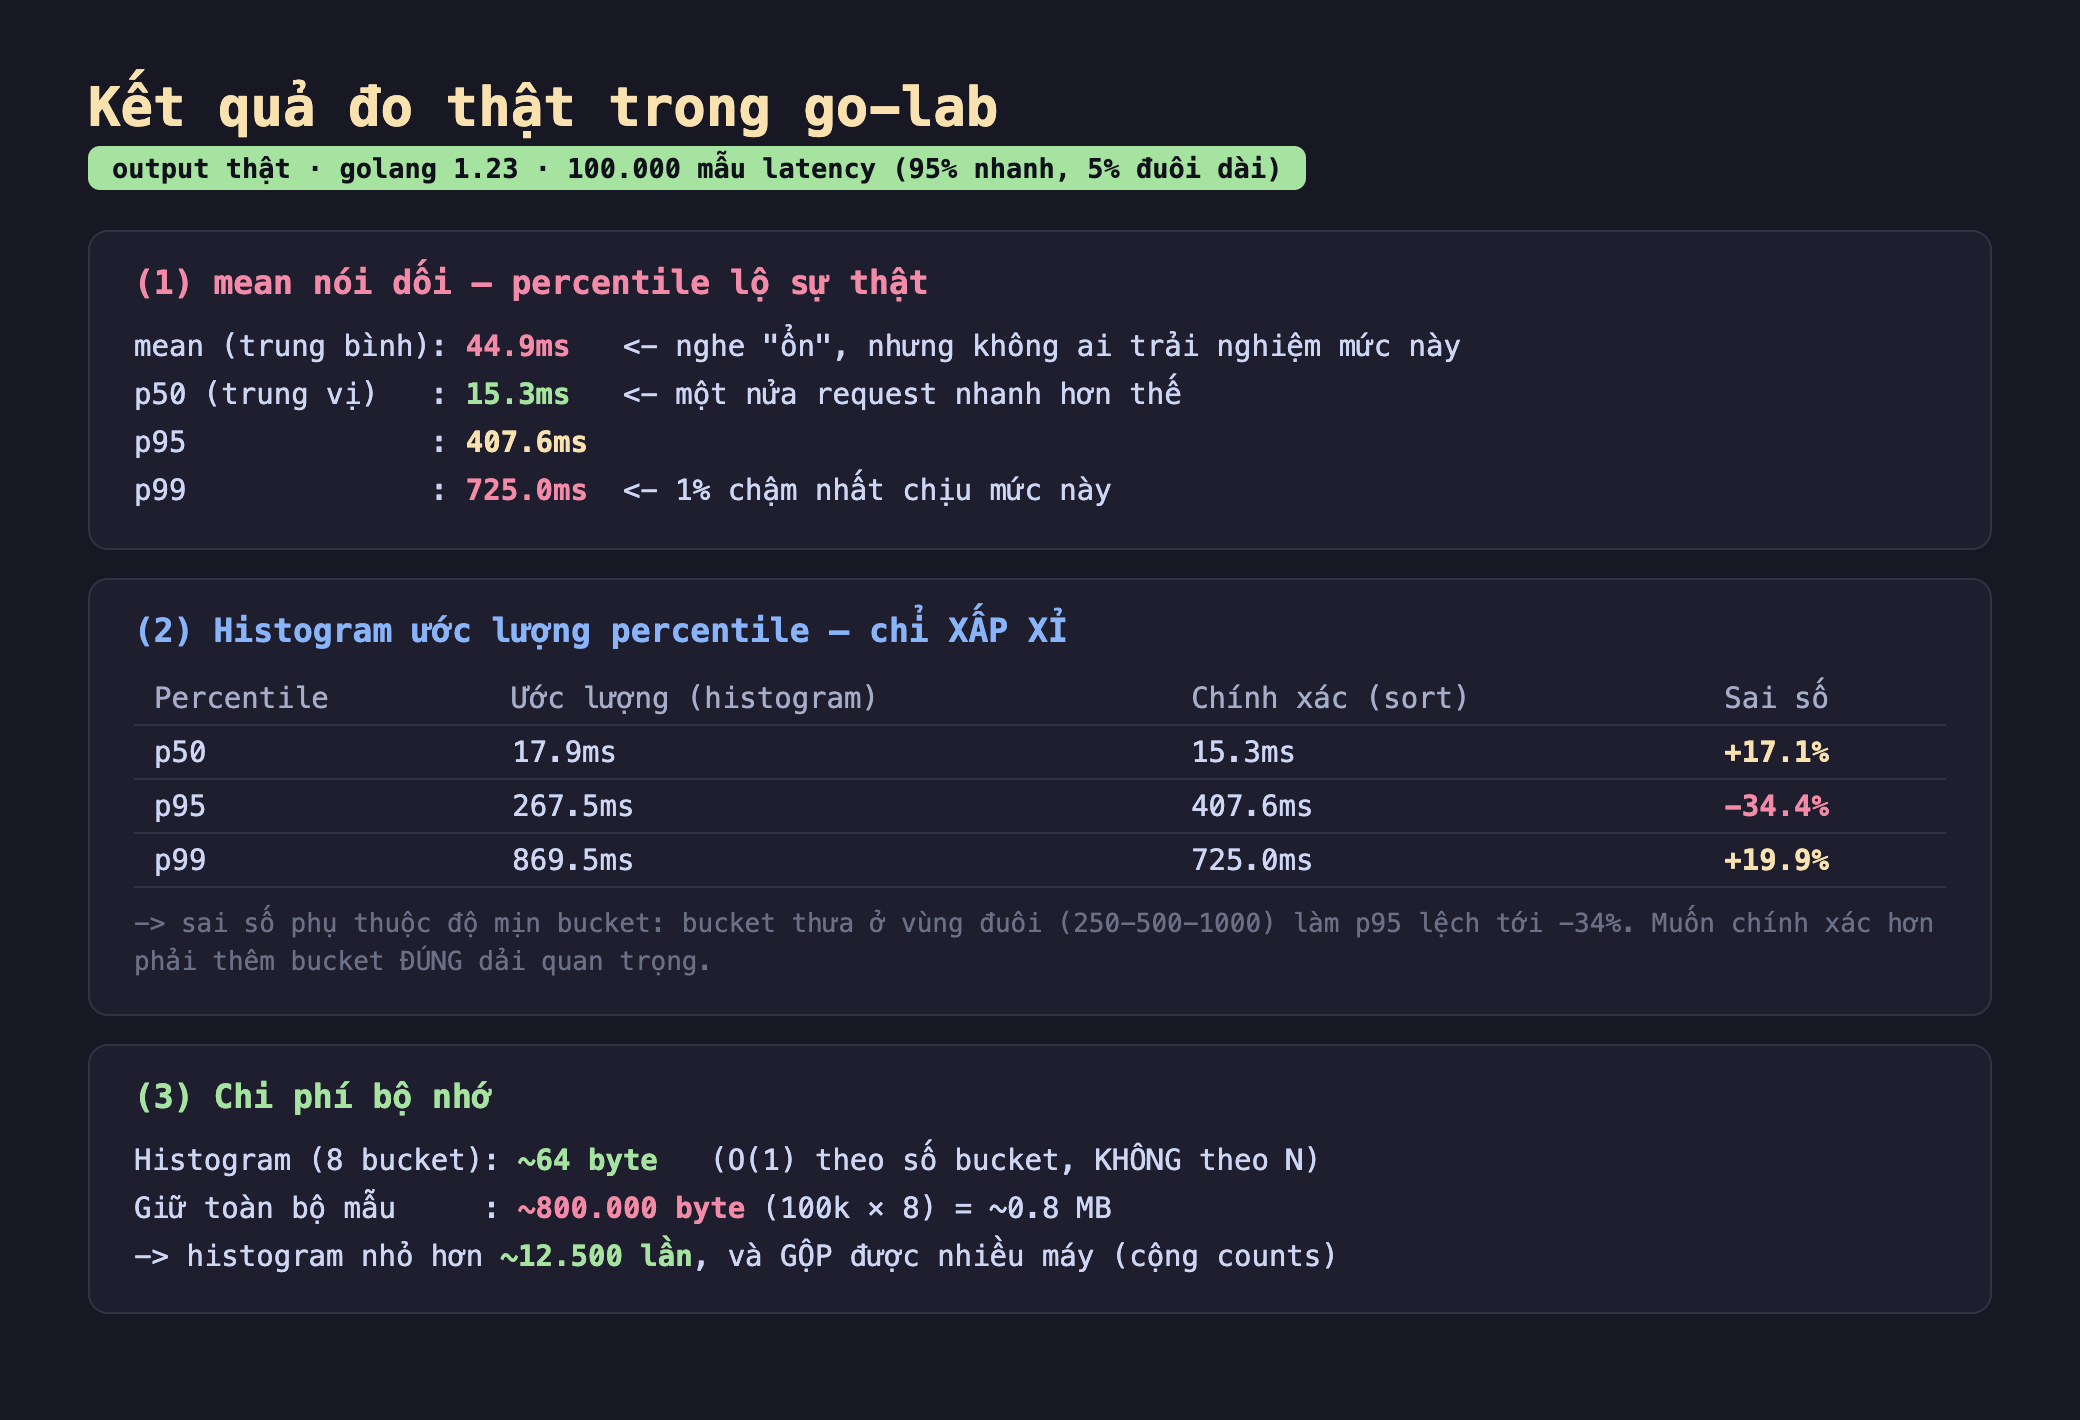
Hình 2: Kết quả thật — mean 44.9ms che giấu sự thật: p50 chỉ 15.3ms, p99 tới 725ms; histogram ước lượng percentile chỉ xấp xỉ (p50 +17.1%, p95 -34.4%, p99 +19.9%); và histogram tốn ~64 byte so với ~0.8MB giữ toàn bộ mẫu.
Ba tầng bài học từ số thật:
- Trung bình rơi vào khoảng trống. mean = 44.9ms, nhưng p50 (trung vị) chỉ 15.3ms — nghĩa là một nửa request nhanh hơn 15ms, đa số ở vùng nhanh. Còn p99 = 725ms — 1% chậm nhất chịu mức khủng khiếp đó. Con số 45ms không mô tả ai cả: nó không phải trải nghiệm của nhóm nhanh, cũng chẳng phải của nhóm khổ. Nếu bạn tối ưu dựa trên "trung bình 45ms", bạn đang nhắm vào một ảo ảnh.
- Histogram chỉ xấp xỉ — và sai số có thể lớn. Đây là điều phải nói thẳng: percentile ước lượng từ histogram không chính xác. p50 lệch +17.1%, p99 lệch +19.9%, và p95 lệch tới -34.4% (ước lượng 267ms trong khi thật là 407ms). Sai số lớn ở p95 đến từ chỗ các bucket vùng đuôi (250-500-1000) thưa: cả một khoảng giá trị rộng gộp vào một bucket, nội suy tuyến tính bên trong không bắt được hình dạng thật. Muốn chính xác hơn, phải đặt thêm bucket đúng dải giá trị quan trọng.
- Đổi lại là bộ nhớ cực nhỏ và gộp được. Histogram 8 bucket tốn ~64 byte — không đổi dù có 100 nghìn hay 100 tỷ mẫu. Giữ toàn bộ mẫu để tính chính xác tốn ~0.8MB cho 100k mẫu (và tăng tuyến tính). Histogram nhỏ hơn ~12.500 lần ở quy mô này, và quan trọng hơn: cộng counts của nhiều máy lại là ra histogram toàn hệ thống.
Đánh đổi cần cân nhắc
Chọn bucket đúng dải quan trọng — đây là quyết định thật, không phải mặc định. Như sai số -34% ở p95 cho thấy, chất lượng ước lượng phụ thuộc hoàn toàn vào việc bucket có mịn ở vùng bạn quan tâm hay không. Nếu SLO của bạn là "p99 < 300ms", bạn cần nhiều bucket quanh 300ms (ví dụ 200, 250, 300, 350, 400) chứ không phải nhảy 250→500→1000. Đặt bucket là một quyết định thiết kế: phải biết trước dải latency mình quan tâm. Bucket mặc định của thư viện hiếm khi tối ưu cho dịch vụ cụ thể của bạn.
Không bao giờ tính "trung bình của p99" giữa các máy. Đây là lỗi kinh điển và nguy hiểm. Nếu máy A báo p99=100ms và máy B báo p99=900ms, thì p99 toàn hệ thống không phải (100+900)/2 = 500ms — percentile không cộng trung bình được. Cách đúng: mỗi máy expose histogram (các đếm bucket), hệ giám sát cộng các histogram lại thành một histogram toàn cục, rồi mới tính p99 từ đó. Đây chính là lý do sâu xa vì sao ta dùng histogram thay vì chỉ báo con số p99 tính sẵn: chỉ histogram mới gộp được đúng. Báo "p99 tính sẵn" từ mỗi máy rồi lấy trung bình là ra một con số vô nghĩa.
Percentile chính xác cần giữ mẫu — chỉ dùng khi thật cần. Khi bạn thực sự cần percentile chính xác (ví dụ phân tích offline, kiểm định SLA nghiêm ngặt), phải giữ mẫu (hoặc dùng cấu trúc xấp xỉ cao cấp như t-digest/HDR histogram, cân bằng giữa chính xác và bộ nhớ). Nhưng cho giám sát real-time, histogram bucket cố định gần như luôn là lựa chọn đúng: sai số vài chục phần trăm ở percentile thường chấp nhận được để đổi lấy chi phí O(1) và khả năng gộp — miễn là bạn biết nó chỉ xấp xỉ và không tin nó tới từng mili giây.
Ba ý mang về
- Trung bình nói dối với latency vì bị đuôi kéo: đo thật, phân phối lệch cho mean 44.9ms nhưng p50 chỉ 15.3ms và p99 tới 725ms — trung bình rơi vào khoảng trống không ai trải nghiệm; luôn nhìn percentile (p50/p95/p99) để thấy cả nhóm nhanh lẫn nhóm khổ.
- Histogram ước lượng percentile với O(1) bộ nhớ nhưng chỉ xấp xỉ: đo thật, histogram 8 bucket tốn ~64 byte (nhỏ hơn ~12.500 lần so với giữ toàn bộ mẫu 0.8MB) và gộp được nhiều máy, đổi lại percentile chỉ gần đúng — p95 lệch tới -34% vì bucket vùng đuôi quá thưa.
- Bucket phải đặt đúng dải, và percentile không cộng trung bình được: chọn bucket mịn quanh ngưỡng SLO quan trọng; và tuyệt đối không lấy "trung bình của p99" giữa các máy — phải gộp histogram (cộng counts) rồi mới tính percentile toàn cục, đó là lý do sâu xa để dùng histogram.
Nguồn
- Prometheus — Histograms and summaries: https://prometheus.io/docs/practices/histograms/
- Gil Tene — How NOT to Measure Latency (percentile & coordinated omission): https://www.infoq.com/presentations/latency-response-time/
- Go — sort.SearchFloat64s: https://pkg.go.dev/sort#SearchFloat64s
Phần sau ta dùng thư viện Prometheus client cho Go: expose counter và histogram thật qua endpoint /metrics, xem định dạng phơi bày (exposition format) trông thế nào, và hiểu cách một hệ giám sát scrape số liệu đó.
