Hai phần đầu loạt bài nói về log — trụ cột trả lời câu hỏi "chuyện gì đã xảy ra với request này". Nhưng log không trả lời tốt một câu hỏi khác, quan trọng không kém: "hệ thống đang thế nào tổng thể?" — bao nhiêu request/giây, bao nhiêu đang xử lý, tỉ lệ lỗi bao nhiêu. Đọc log để trả lời những câu đó là đếm hàng triệu dòng, tốn kém và chậm. Đây là việc của metric — trụ cột thứ hai của observability: những con số được tổng hợp liên tục, rẻ để lưu và nhanh để truy vấn.
Metric có vài loại cơ bản, và hiểu đúng loại nào cho việc gì là nền tảng. Hai loại dùng nhiều nhất: counter (bộ đếm chỉ tăng — tổng số request, tổng lỗi) và gauge (đồng hồ lên xuống — số request đang xử lý, dung lượng RAM, số kết nối mở). Go có sẵn gói expvar trong thư viện chuẩn để làm việc này mà không cần thư viện ngoài. Bài này (phần 3 loạt Observability) đo thật hai loại metric đó — và nhân tiện chứng minh một điều mà nhiều người biết trên lý thuyết nhưng chưa thấy tận mắt: đếm đồng thời mà không atomic thì mất dữ liệu khủng khiếp.
Cơ chế: counter chỉ tăng, gauge lên xuống
Khác biệt giữa hai loại nằm ở ngữ nghĩa, và nó quyết định bạn đọc chúng ra sao:
- Counter là một số chỉ đi lên:
request_total,error_total,bytes_sent. Bản thân giá trị tuyệt đối ít ý nghĩa (5 triệu request kể từ lúc khởi động thì sao?); cái có ý nghĩa là tốc độ tăng của nó — hệ giám sát lấy hiệu hai lần đọc (delta) chia thời gian để ra "request/giây". - Gauge là một số lên xuống tự do:
inflight(số request đang xử lý),memory_bytes,open_connections. Ở đây giá trị tuyệt đối tại một thời điểm mới là cái ta quan tâm — "ngay bây giờ có bao nhiêu request đang chạy".
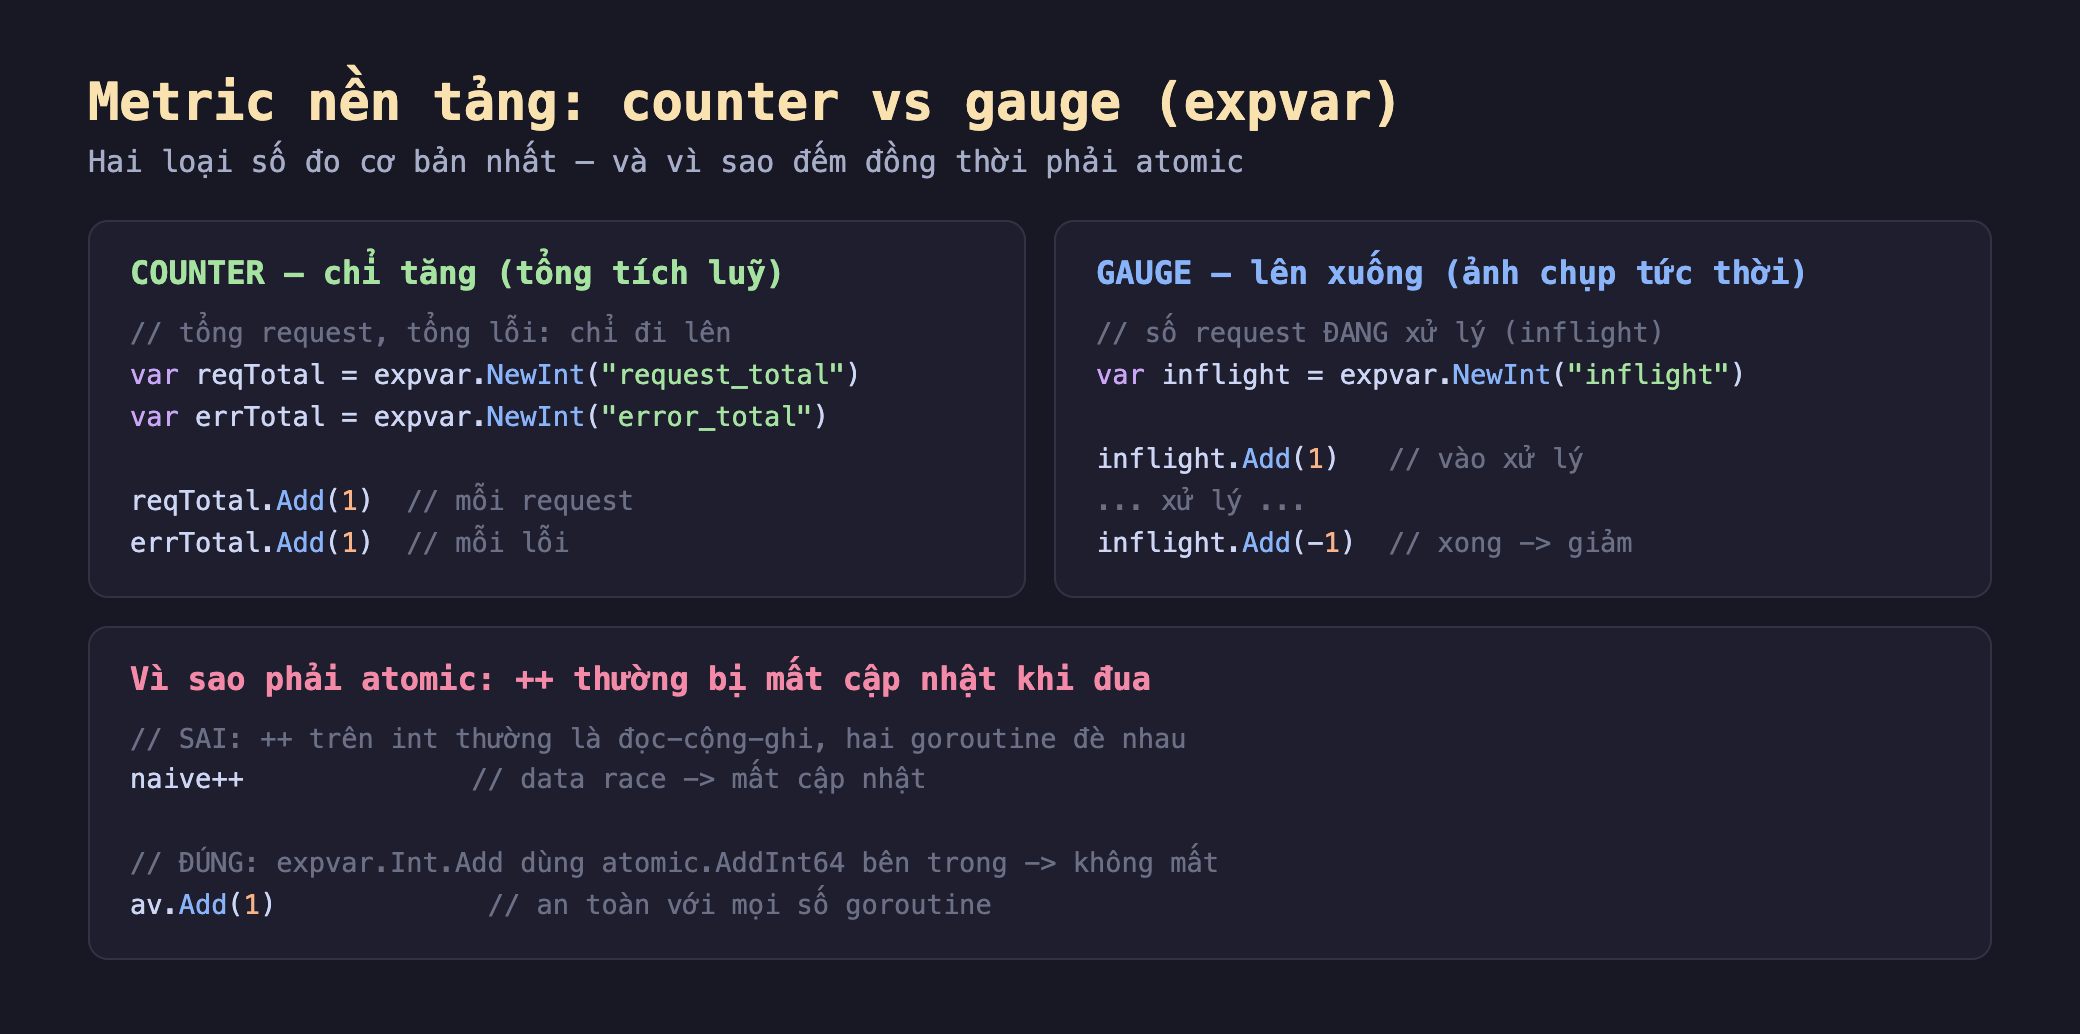
Hình 1: Counter (expvar.NewInt + Add(1)) cho tổng tích luỹ như request_total, error_total; gauge (inflight.Add(1) khi vào, Add(-1) khi xong) cho mức tức thời. Và điểm cốt tử: ++ trên int thường là data race mất cập nhật, còn expvar.Int.Add dùng atomic.AddInt64 bên trong nên an toàn.
expvar làm hai việc: cung cấp kiểu expvar.Int (và Float, Map, String) an toàn đồng thời, và tự động expose tất cả metric đã đăng ký qua endpoint HTTP /debug/vars dưới dạng JSON. Bạn khai một expvar.NewInt("ten"), gọi .Add() khắp nơi, và metric hiện ra ở /debug/vars mà không cần viết thêm gì.
Đo thật trong go-lab
Mình chạy trong go-lab (golang 1.23): tung 5000 request qua 50 worker song song, mỗi request tăng counter và tăng/giảm gauge inflight quanh lúc xử lý. Rồi mình chạy riêng một phép thử đồng thời khắc nghiệt để đo sự mất mát của việc đếm không atomic.
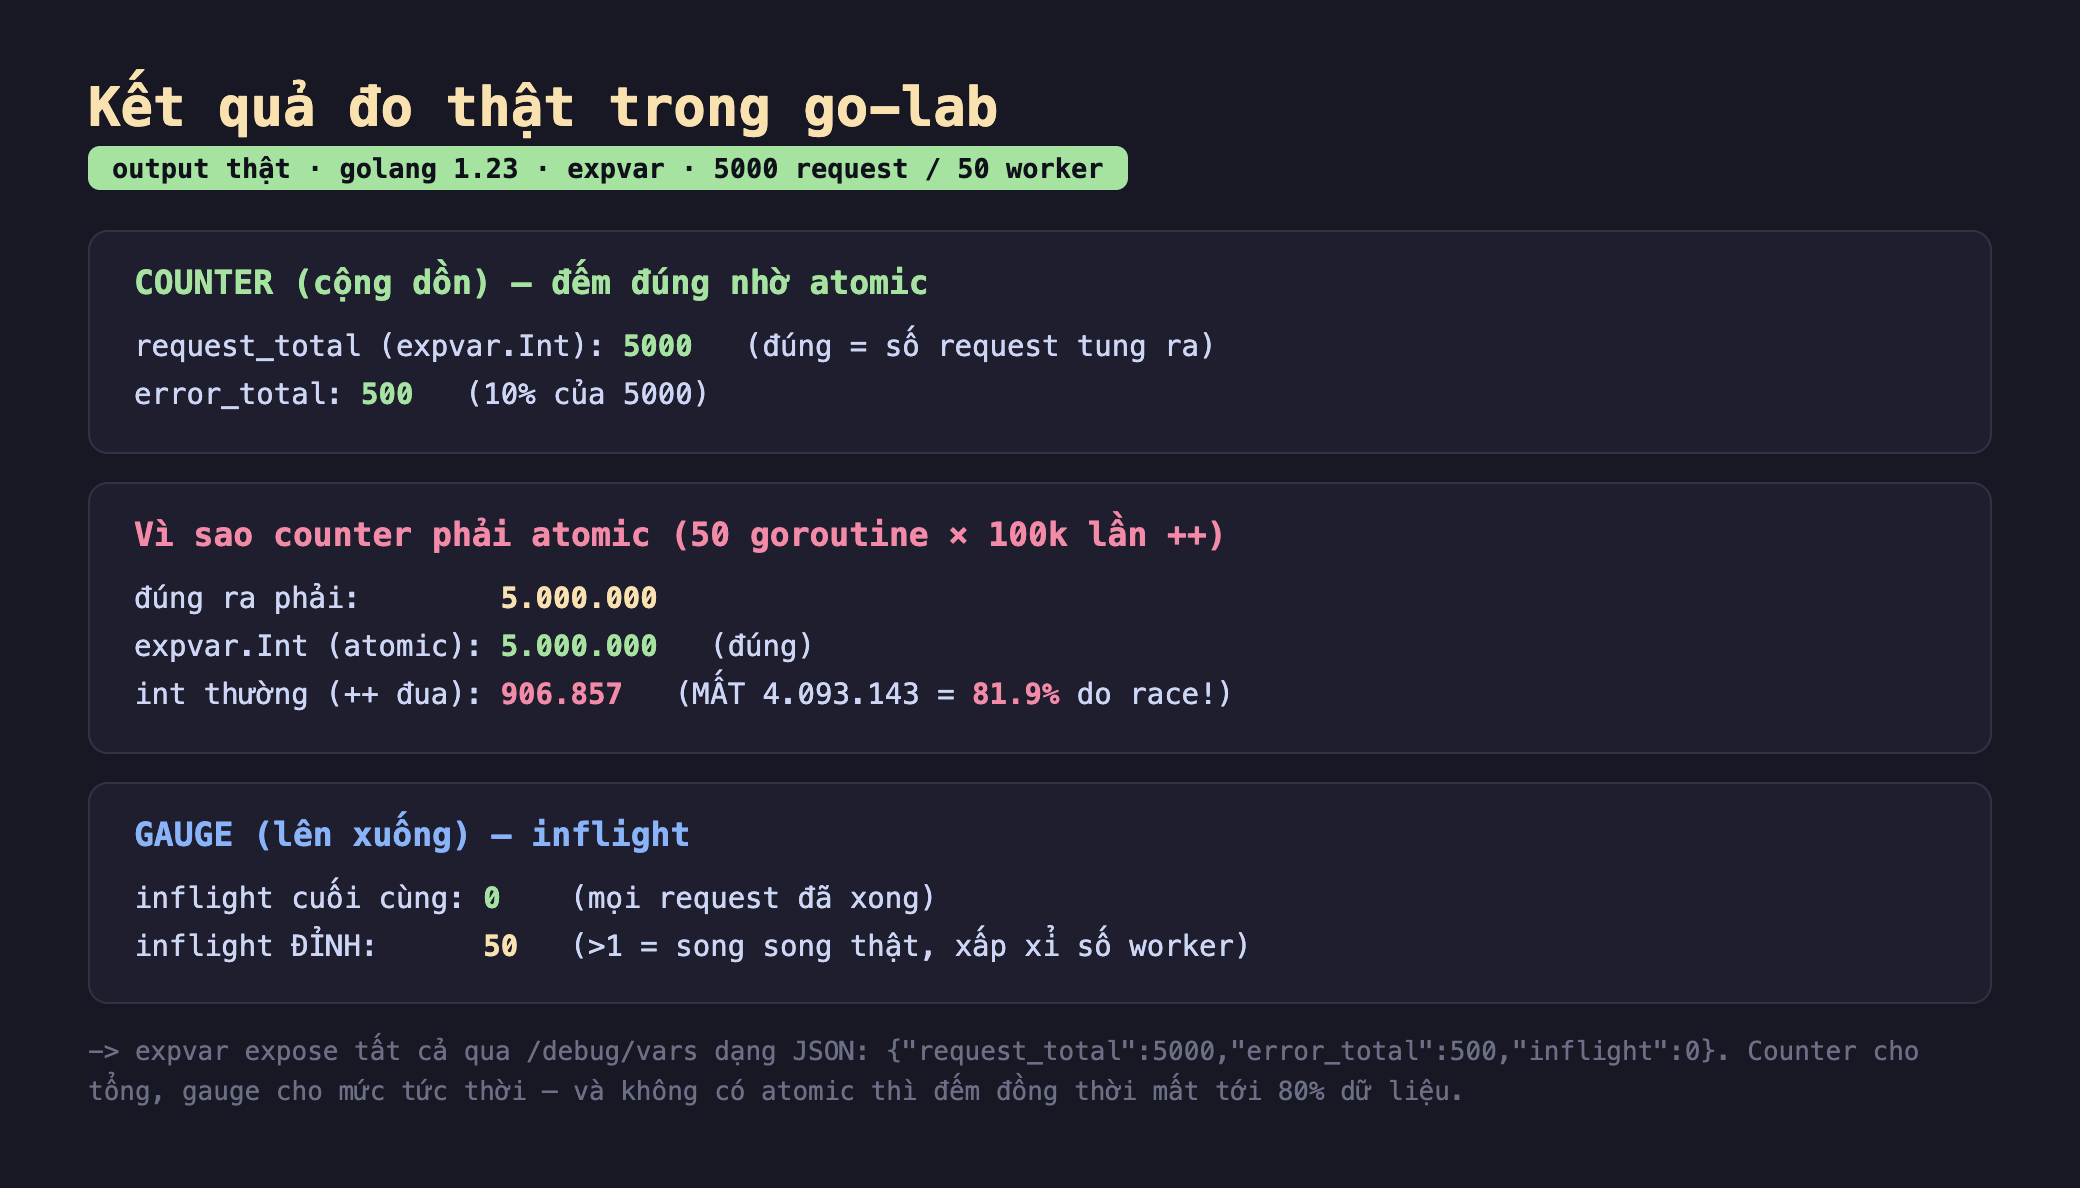
Hình 2: Kết quả thật — counter request_total = 5000 (đúng số request), error_total = 500; phép thử đồng thời: đúng ra 5.000.000, expvar.Int atomic đếm đúng 5.000.000, còn int thường ++ chỉ được 906.857 — mất 81.9%; gauge inflight về 0 cuối cùng, đỉnh 50 (song song thật).
Ba điều rút ra từ số thật:
- Counter đếm chính xác nhờ atomic.
request_totalbằng đúng 5000 dù 50 worker cùng gọiAdd(1)liên tục.error_total= 500 (đúng 10%).expvar.Intdùngatomic.AddInt64bên trong, nên mỗi lầnAddlà một thao tác nguyên tử không bị đè. - Không atomic thì mất tới 81.9%. Đây là con số gây sốc nhất. Cho 50 goroutine mỗi cái
++một biếnintthường 100.000 lần (tổng đáng lẽ 5 triệu), kết quả chỉ còn 906.857 — mất hơn 4 triệu cập nhật. Vìnaive++thực ra là ba bước đọc → cộng → ghi, và khi hai goroutine đọc cùng giá trị rồi cùng ghi, một cập nhật biến mất. Ở mức tương tranh cao, phần lớn cập nhật rơi rụng. Đây không phải lỗi hiếm gặp lý thuyết — nó là 80% dữ liệu bốc hơi. - Gauge phản ánh mức tức thời.
inflighttăng khi request vào, giảm khi xong; cuối cùng về 0 (mọi request đã kết thúc), và đỉnh đạt 50 — đúng bằng số worker, xác nhận có song song thật sự. Một gauge inflight cao kéo dài là dấu hiệu hệ thống đang ùn.
Toàn bộ metric này expose qua /debug/vars dạng JSON {"request_total":5000,"error_total":500,"inflight":0} — một hệ giám sát chỉ cần gọi endpoint đó định kỳ là có số liệu.
Đánh đổi cần cân nhắc
Counter phải monotonic, và hệ giám sát phải chịu được reset. Counter chỉ tăng — nhưng khi tiến trình khởi động lại, nó về 0. Điều này không phải lỗi: các hệ như Prometheus tính rate bằng cách lấy delta giữa hai lần đọc, và có logic phát hiện khi giá trị tụt (reset) để không tính ra rate âm. Vì vậy đừng bao giờ "sửa" counter bằng cách tự reset nó giữa chừng, cũng đừng dùng gauge cho thứ vốn là counter — bạn sẽ làm hỏng phép tính rate. Quy tắc: cái gì bản chất tích luỹ thì là counter, để hệ giám sát lo phần delta.
Gauge chỉ là ảnh chụp — đọc giữa chừng có thể lệch. Một gauge cho giá trị tại thời điểm đọc. Nếu inflight dao động nhanh, hai lần đọc cách nhau vài mili giây có thể ra số rất khác, và bạn có thể "bỏ lỡ" một đỉnh ngắn giữa hai lần lấy mẫu. Để bắt đỉnh, hoặc lấy mẫu dày hơn, hoặc dùng một metric riêng theo dõi giá trị lớn nhất (như peakInflight trong demo, cập nhật bằng compare-and-swap). Đừng kết luận "hệ thống chưa bao giờ quá 50 inflight" chỉ vì các lần đọc rời rạc không thấy cao hơn.
/debug/vars là công khai — đừng expose ra Internet. expvar tự đăng ký handler /debug/vars vào http.DefaultServeMux ngay khi bạn import nó. Endpoint này phơi toàn bộ metric (và cả cmdline, memstats mặc định) cho bất kỳ ai gọi được — rò rỉ thông tin nội bộ về hệ thống. Trên production, đặt nó sau xác thực, hoặc phục vụ trên một cổng nội bộ riêng chỉ hệ giám sát truy cập được, không bao giờ hở thẳng ra ngoài.
expvar đơn giản nhưng thiếu label và histogram. Đây là giới hạn thật khiến expvar hiếm khi đủ cho production nghiêm túc. Nó chỉ có số vô hướng — không có label (không thể tách request_total theo endpoint hay status một cách gọn), và không có histogram (không đo được phân phối latency, p99). Với những thứ đó cần Prometheus client (phần 5). expvar tốt để hiểu khái niệm counter/gauge và cho các công cụ nhỏ, nhưng hệ thống thật thường cần nhiều hơn.
Ba ý mang về
- Metric là trụ cột trả lời "hệ thống thế nào tổng thể", với hai loại nền tảng: counter (chỉ tăng —
request_total, đọc bằng tốc độ tăng) và gauge (lên xuống —inflight, đọc bằng giá trị tức thời);expvarcung cấp cả hai và expose qua/debug/vars. - Đếm đồng thời bắt buộc atomic — bằng chứng đo thật: 50 goroutine
++một int thường 100k lần mỗi cái làm mất 81.9% số đếm (906.857 thay vì 5 triệu), trong khiexpvar.Int(dùngatomic.AddInt64) đếm đúng tuyệt đối;++không phải một thao tác nguyên tử. - Mỗi loại có luật riêng, và expvar có giới hạn: counter phải monotonic (để hệ giám sát tính delta, chịu được reset khi restart), gauge chỉ là ảnh chụp (có thể lỡ đỉnh giữa hai lần đọc);
/debug/varscông khai nên đừng hở ra Internet; và expvar thiếu label/histogram nên production thường cần Prometheus.
Nguồn
- Go — Package expvar: https://pkg.go.dev/expvar
- Go — sync/atomic: https://pkg.go.dev/sync/atomic
- Prometheus — Metric types (counter, gauge): https://prometheus.io/docs/concepts/metric_types/
Phần sau ta giải quyết câu hỏi mà counter và gauge không trả lời được: phân phối của latency. Vì sao "latency trung bình 50ms" có thể che giấu một thảm hoạ, và làm sao đo p50/p99 bằng histogram để thấy sự thật.
