Phần 2 cho thấy RLE ngây thơ thất bại với text vì text không có run dài. Nhưng text vẫn có dư thừa — chỉ là kiểu khác: một số ký tự xuất hiện thường xuyên hơn hẳn ký tự khác. Trong tiếng Anh, khoảng trắng và e áp đảo, còn z, q hiếm. Vậy tại sao lại phí 8 bit như nhau cho mọi ký tự? Đây chính là ý tưởng của Huffman coding (David Huffman, 1952): gán mã ngắn cho ký tự phổ biến, mã dài cho ký tự hiếm, sao cho trung bình mỗi ký tự tốn ít bit hơn. Và điều đẹp đẽ: Huffman tối ưu cho kiểu mã hóa này, tiến sát tới giới hạn entropy order-0 mà phần 1 đã đo. Bài này (phần 3 loạt Nén) tự cài Huffman và đo khoảng cách tới bức tường entropy.
Cơ chế: mã độ dài thay đổi, prefix-free
Ý tưởng cốt lõi là mã độ dài thay đổi (variable-length code): thay vì mọi ký tự 8 bit cố định, ký tự càng phổ biến càng được mã ngắn. Nhưng có một ràng buộc: mã phải prefix-free — không mã nào là tiền tố của mã khác. Nếu e = 01 thì không mã nào được bắt đầu bằng 01; nhờ vậy khi giải mã, đọc bit tới đâu khớp mã là biết ngay ký tự, không nhập nhằng.
Cách bảo đảm prefix-free: dựng một cây nhị phân, mỗi ký tự nằm ở một lá, và đường đi từ gốc tới lá (trái=0, phải=1) chính là mã. Vì lá không nằm trên đường tới lá khác, mã tự động prefix-free. Câu hỏi còn lại: dựng cây thế nào để mã ngắn nhất có thể? Huffman trả lời bằng một thuật toán tham lam tinh tế: liên tục gộp hai node có tần suất nhỏ nhất thành một node cha.
h = [[freq, i, sym] for ...]; heapq.heapify(h)
while len(h) > 1:
    lo = heapq.heappop(h); hi = heapq.heappop(h)   # 2 tần suất nhỏ nhất
    heapq.heappush(h, [lo[0]+hi[0], cnt, (lo, hi)]) # gộp thành node cha
Ký tự hiếm bị gộp sớm, chìm sâu xuống đáy cây → mã dài. Ký tự phổ biến gộp muộn, ở gần gốc → mã ngắn. Dùng heap (hàng đợi ưu tiên) để luôn lấy hai tần suất nhỏ nhất hiệu quả.
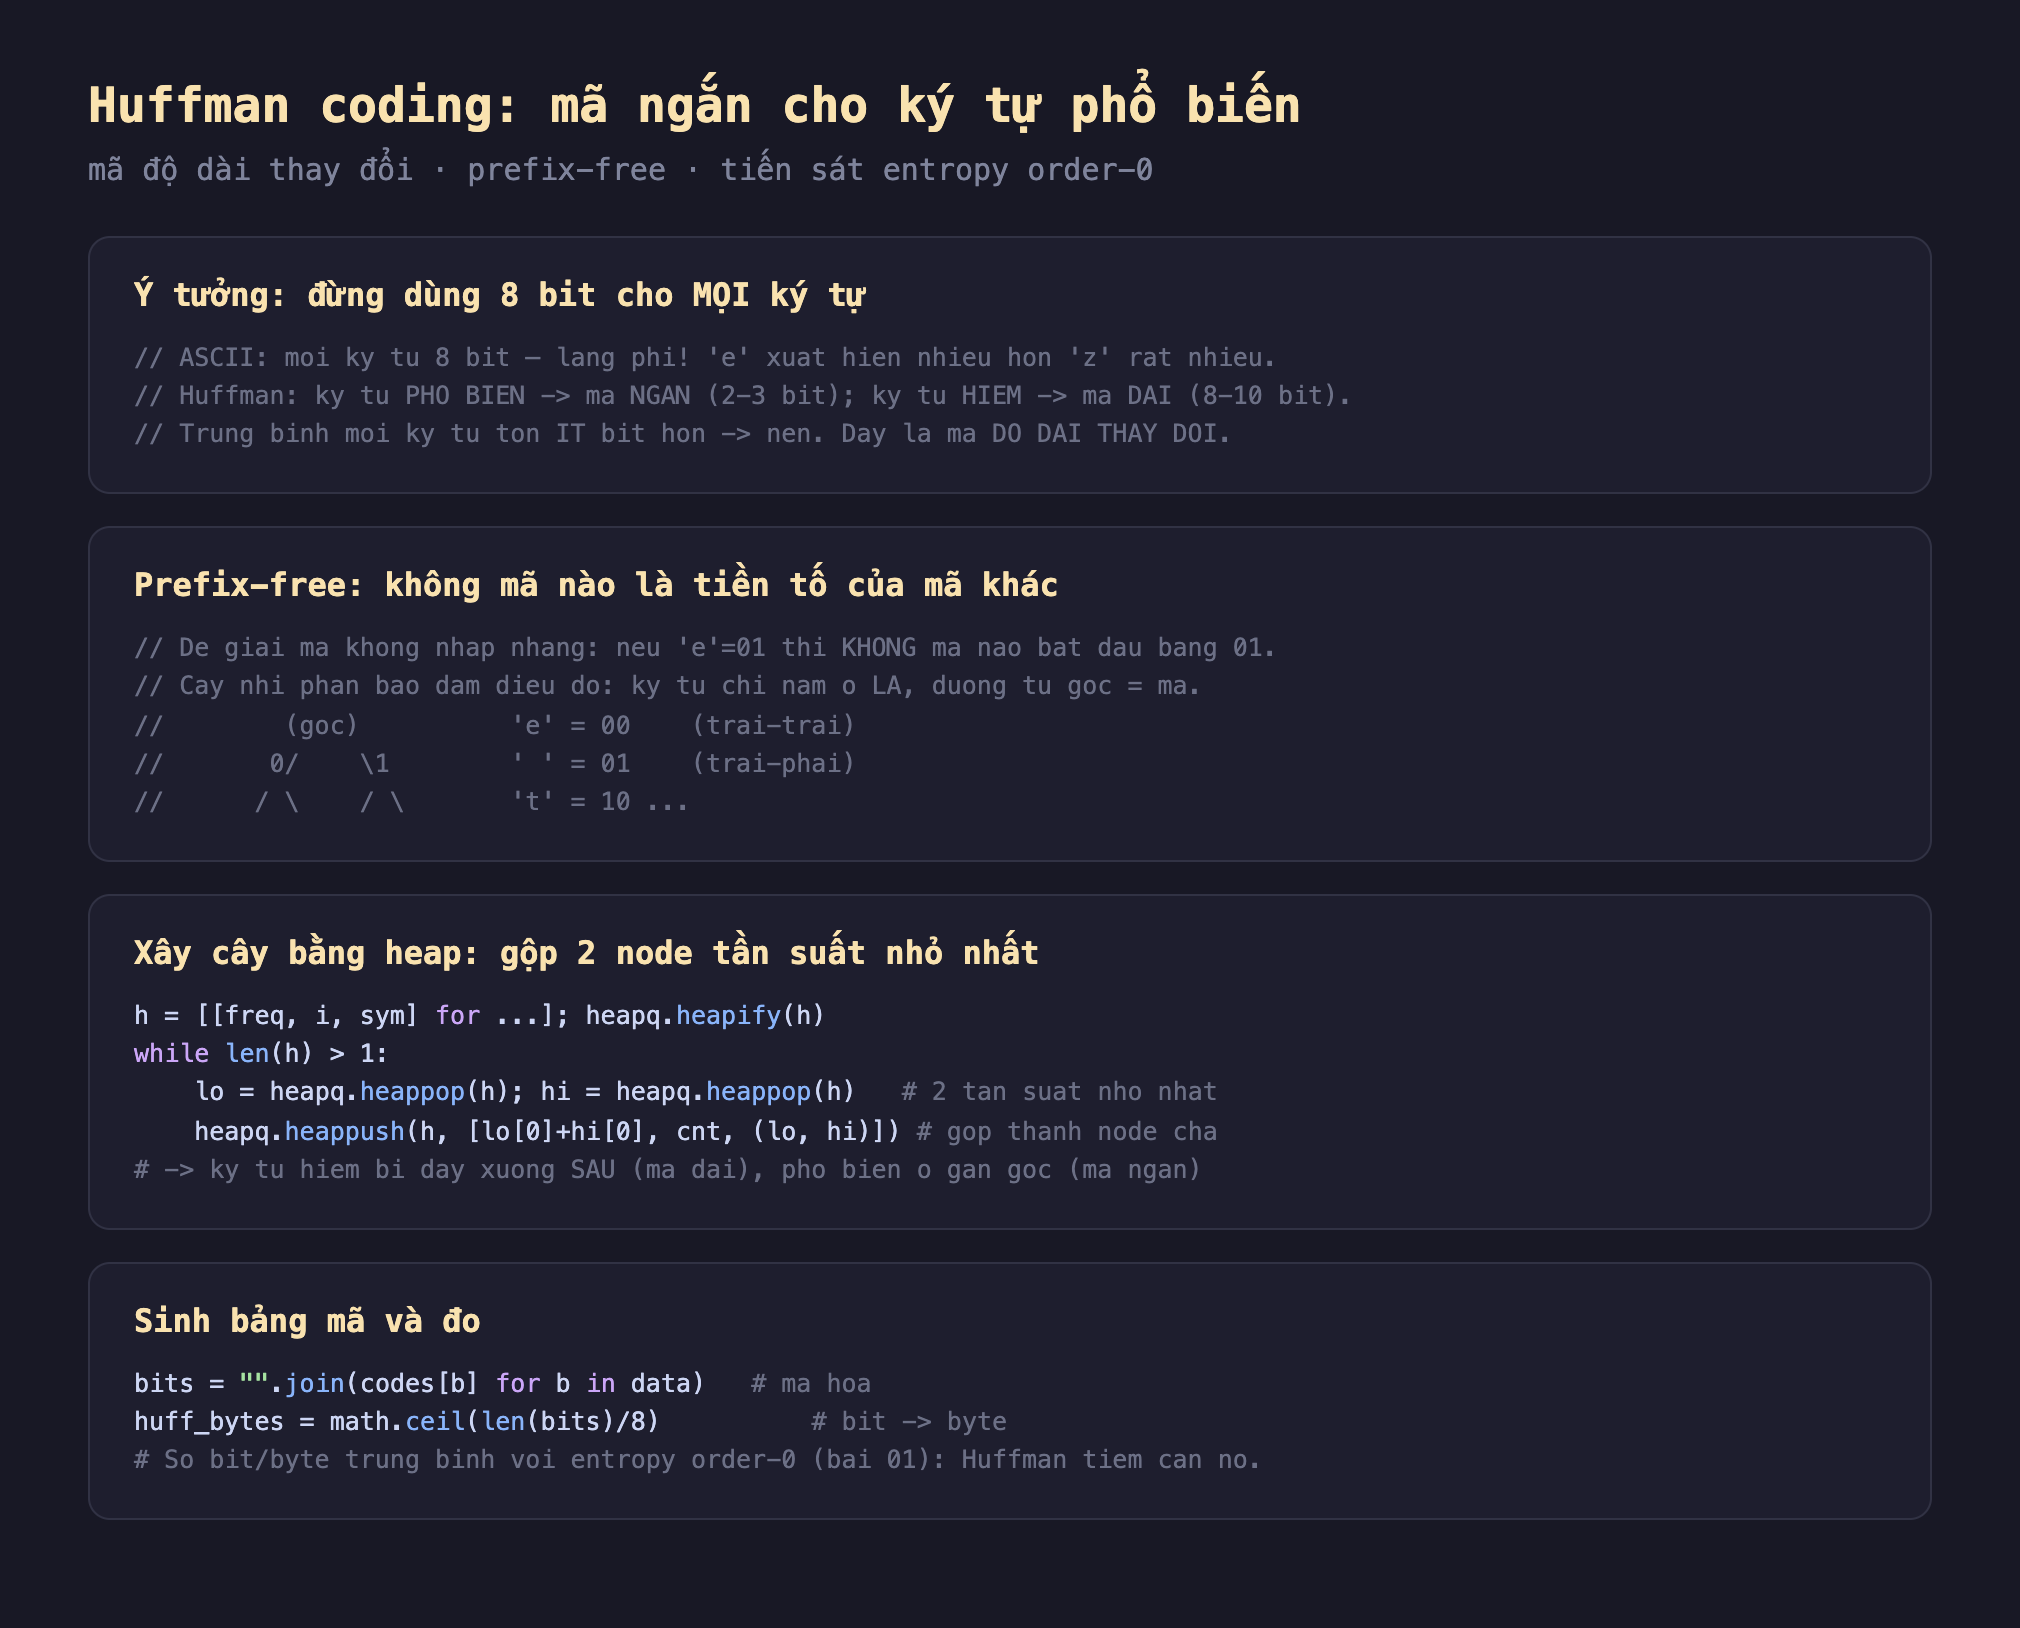
Hình 1: Huffman gán mã độ dài thay đổi (phổ biến ngắn, hiếm dài), prefix-free nhờ cây nhị phân (ký tự ở lá, đường gốc-tới-lá = mã); xây cây bằng cách liên tục gộp hai node tần suất nhỏ nhất qua heap.
Đo thật: tiến sát sàn entropy đúng 0.026 bit
Mình tự cài Huffman, đếm tần suất trên một khối text (tiếng Anh + Việt, 120.600 byte), sinh bảng mã, đo tổng số bit, và so với entropy order-0:
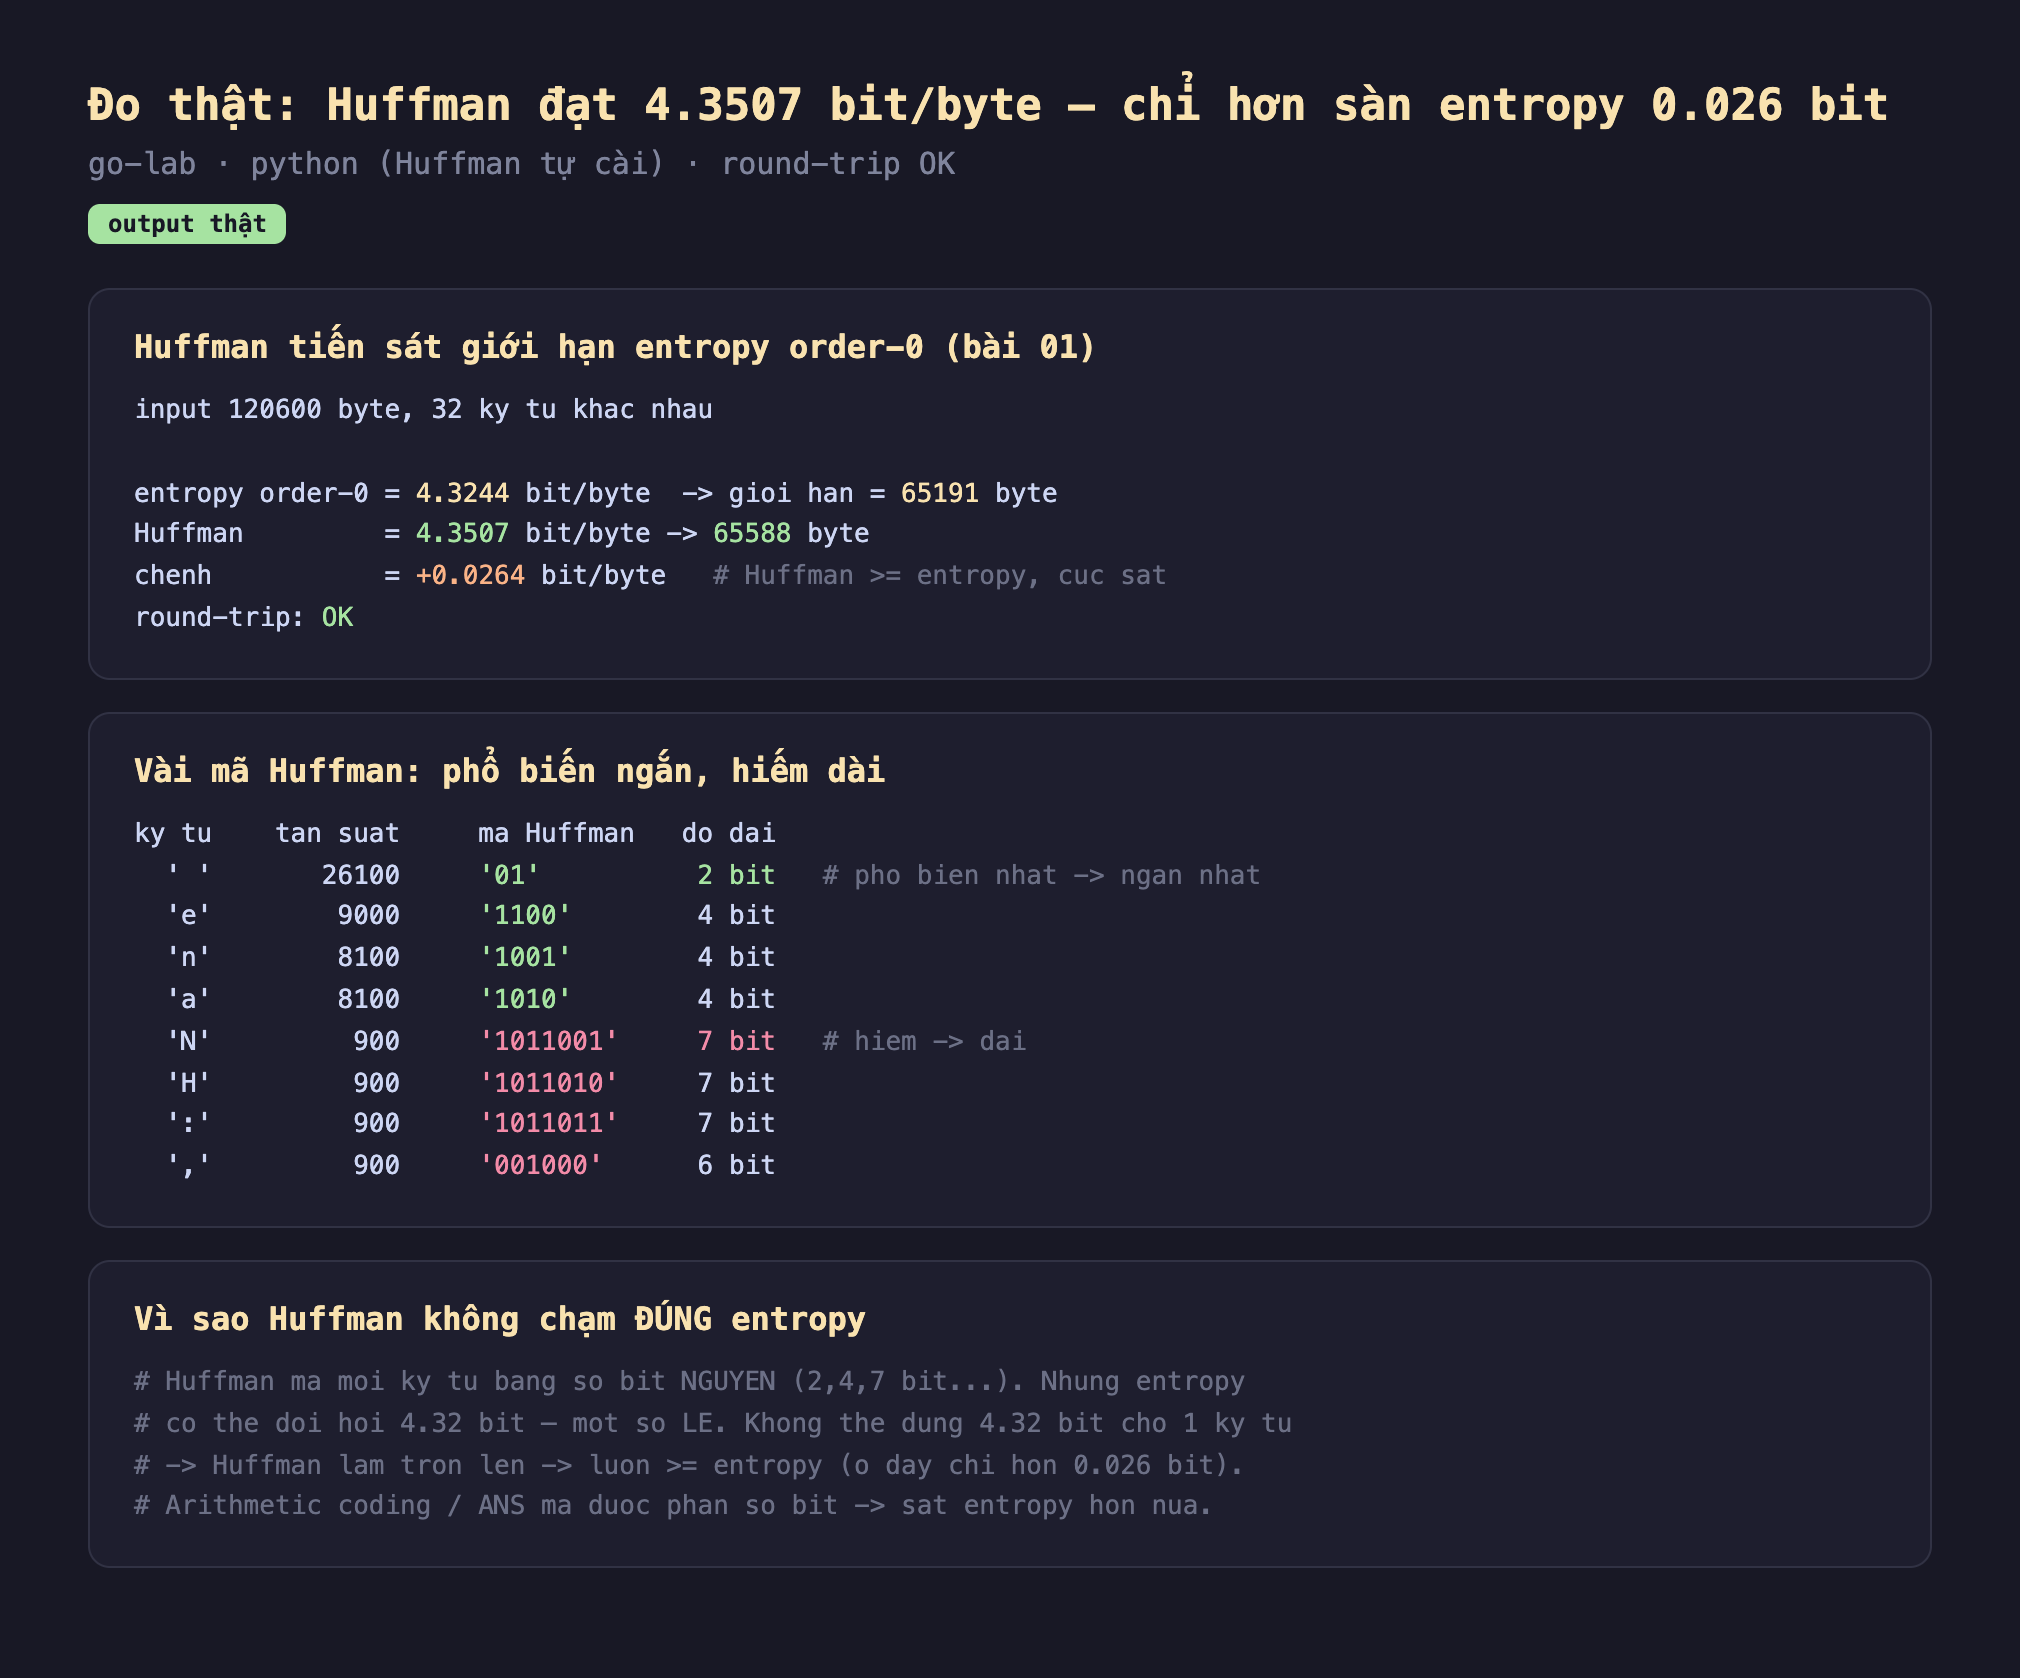
Hình 2: Chạy thật — text 120.600 byte (32 ký tự): entropy order-0 = 4.3244 bit/byte (giới hạn 65191B), Huffman = 4.3507 bit/byte (65588B), chênh chỉ +0.0264 bit/byte; mã: ' ' (tần suất 26100) = 2 bit, e/n/a = 4 bit, ký tự hiếm N/H/: = 7 bit; round-trip OK.
- Mã ngắn cho phổ biến, dài cho hiếm — đúng như thiết kế: khoảng trắng (phổ biến nhất, 26.100 lần) được mã ngắn nhất
01(2 bit);e,n,ađược 4 bit; còn các ký tự hiếm (N,H,:— mỗi cái 900 lần) bị đẩy xuống 7 bit. Nhìn bảng mã là thấy ngay nguyên lý: bit dành cho ký tự tỉ lệ nghịch với tần suất của nó. - Tiến sát entropy đúng 0.026 bit: đây là điểm đẹp nhất. Entropy order-0 (giới hạn lý thuyết của mọi mã hóa theo tần suất từng ký tự) là
4.3244bit/byte. Huffman đạt4.3507bit/byte — chỉ cao hơn sàn đúng 0.0264 bit/byte. Trên 120.600 byte, chênh lệch là 65588 vs 65191 byte — chưa tới 1%. Huffman gần như chạm đáy của thứ mà mã-theo-ký-tự có thể làm. - Vì sao không chạm đúng entropy: Huffman mã mỗi ký tự bằng số bit nguyên (2, 4, 7...). Nhưng entropy có thể đòi hỏi một ký tự tốn
4.32bit — một số lẻ. Không thể dùng "4.32 bit" cho một ký tự (bit là đơn vị nguyên), nên Huffman phải làm tròn lên, khiến nó luôn≥entropy. Khoảng chênh nhỏ này (0.026 bit ở đây) chính là "thuế làm tròn". Các thuật toán như arithmetic coding và ANS mã hóa được cả phân số bit nên tiến sát entropy hơn nữa — đó là lý do các định dạng hiện đại (zstd, một số codec) dùng chúng thay Huffman thuần.
Đánh đổi cần cân nhắc
Huffman chỉ khai thác tần suất, không khai thác lặp lại. Nó là mã hóa order-0: chỉ nhìn tần suất từng byte, mù với các đoạn lặp (như phần 1 đã thấy, LZ77 xuống dưới cả sàn order-0). Text lặp "the the the" với Huffman thuần không được lợi gì từ sự lặp — mỗi từ vẫn mã theo tần suất ký tự. Đó là lý do gzip kết hợp LZ77 (loại lặp, phần 4) rồi mới Huffman (mã tần suất, phần 5): hai thứ bù nhau.
Phải lưu kèm bảng mã (cây Huffman) — tốn thêm chỗ. Bên giải mã cần biết mã của từng ký tự để bung ngược. Với dữ liệu nhỏ, chi phí lưu bảng mã có thể lớn hơn phần tiết kiệm được — Huffman lỗ. Cách xử lý: dùng canonical Huffman (chỉ cần lưu độ dài mã mỗi ký tự, tái dựng cây từ đó — gọn hơn nhiều), hoặc dùng bảng mã cố định thỏa thuận trước (như DEFLATE có chế độ "fixed Huffman"). Với dữ liệu lớn, chi phí bảng mã không đáng kể.
Arithmetic coding / ANS sát entropy hơn nhưng phức tạp và từng vướng bằng sáng chế. Chúng bỏ ràng buộc "mỗi ký tự số bit nguyên", mã cả luồng thành một số, nên tiến rất sát entropy. Nhưng chúng chậm hơn và phức tạp hơn Huffman, và arithmetic coding từng bị vướng bằng sáng chế nhiều năm (một lý do Huffman phổ biến hơn trong lịch sử). Ngày nay ANS (Asymmetric Numeral Systems, dùng trong zstd và Facebook) cho tốc độ gần Huffman mà tỉ lệ gần arithmetic — nên đang thay thế dần Huffman thuần.
Ba ý mang về
- Huffman gán mã ngắn cho ký tự phổ biến, dài cho hiếm: đo thật khoảng trắng (26.100 lần) được mã 2 bit, ký tự hiếm (900 lần) được 7 bit; prefix-free nhờ cây nhị phân dựng bằng cách gộp hai node tần suất nhỏ nhất qua heap.
- Tiến sát entropy order-0 nhưng không chạm đúng: đo thật Huffman đạt 4.3507 bit/byte, chỉ hơn sàn entropy 4.3244 đúng 0.026 bit — vì mã mỗi ký tự phải là số bit nguyên, không dùng được "4.32 bit"; arithmetic coding/ANS mã phân số bit nên sát hơn.
- Huffman chỉ là một nửa câu chuyện: nó khai thác tần suất nhưng mù với lặp lại, và phải lưu kèm bảng mã (dùng canonical Huffman cho gọn) — đó là lý do gzip kết hợp LZ77 (phần 4) rồi Huffman (phần 5), hai thứ bù nhau.
Nguồn
- David Huffman — A Method for the Construction of Minimum-Redundancy Codes (1952): https://ieeexplore.ieee.org/document/4051119
- Python docs — heapq (hàng đợi ưu tiên): https://docs.python.org/3/library/heapq.html
- Wikipedia — Huffman coding: https://en.wikipedia.org/wiki/Huffman_coding
Phần sau ta sang nửa còn lại: LZ77 — thay vì mã theo tần suất, nó tìm các đoạn lặp lại và thay chúng bằng tham chiếu ngược "quay lại N byte, chép M byte", cơ chế nền của gzip và gần như mọi thuật toán nén hiện đại.
