Phần 3 kết thúc với một hạn chế lớn của Huffman: nó chỉ khai thác tần suất từng ký tự, hoàn toàn mù với sự lặp lại. Một văn bản chứa câu "nén dữ liệu" mười lần thì Huffman vẫn mã từng ký tự theo tần suất, không tận dụng được rằng cả câu đã xuất hiện trước đó. Đây chính là khoảng trống mà LZ77 (Abraham Lempel và Jacob Ziv, 1977) lấp: thay vì mã theo ký tự, nó tìm các đoạn lặp lại và thay chúng bằng một tham chiếu ngược — đại ý "quay lại N byte, chép M byte". Ý tưởng đơn giản này là nền tảng của gzip, zlib, zstd, LZ4 và gần như mọi thuật toán nén đa dụng hiện đại. Bài này (phần 4 loạt Nén) tự cài LZ77 và xem tận mắt các tham chiếu ngược bắt được đoạn lặp thế nào.
Cơ chế: literal và match trong cửa sổ trượt
LZ77 quét dữ liệu từ trái sang phải, và tại mỗi vị trí, nó nhìn lại cửa sổ trượt (sliding window) — vùng dữ liệu vừa đi qua — để tìm xem đoạn sắp tới đã từng xuất hiện chưa. Kết quả là một dãy token, mỗi token thuộc một trong hai loại:
- Literal (
L byte): một ký tự chưa từng thấy (hoặc không đủ để tạo match) → ghi nguyên. - Match (
M (distance, length)): đoạn sắp tới trùng với một đoạn đã thấy → thay bằng cặp (lùi bao nhiêu byte, chép bao nhiêu byte).
Càng nhiều match dài, càng ít token, càng nén tốt. Cửa sổ trượt là "trí nhớ" của thuật toán: chỉ tìm khớp trong phạm vi cửa sổ đó (ví dụ 4KB, 32KB).
def lz77_encode(data, window=4096, max_len=255, min_match=3):
    while i < n:
        # tìm khớp DÀI NHẤT trong cửa sổ [i-window, i)
        for j in range(max(0, i-window), i):
            ...  # đếm số byte trùng từ j và từ i
        if best_len >= min_match:
            tokens.append(("M", best_dist, best_len)); i += best_len
        else:
            tokens.append(("L", data[i])); i += 1
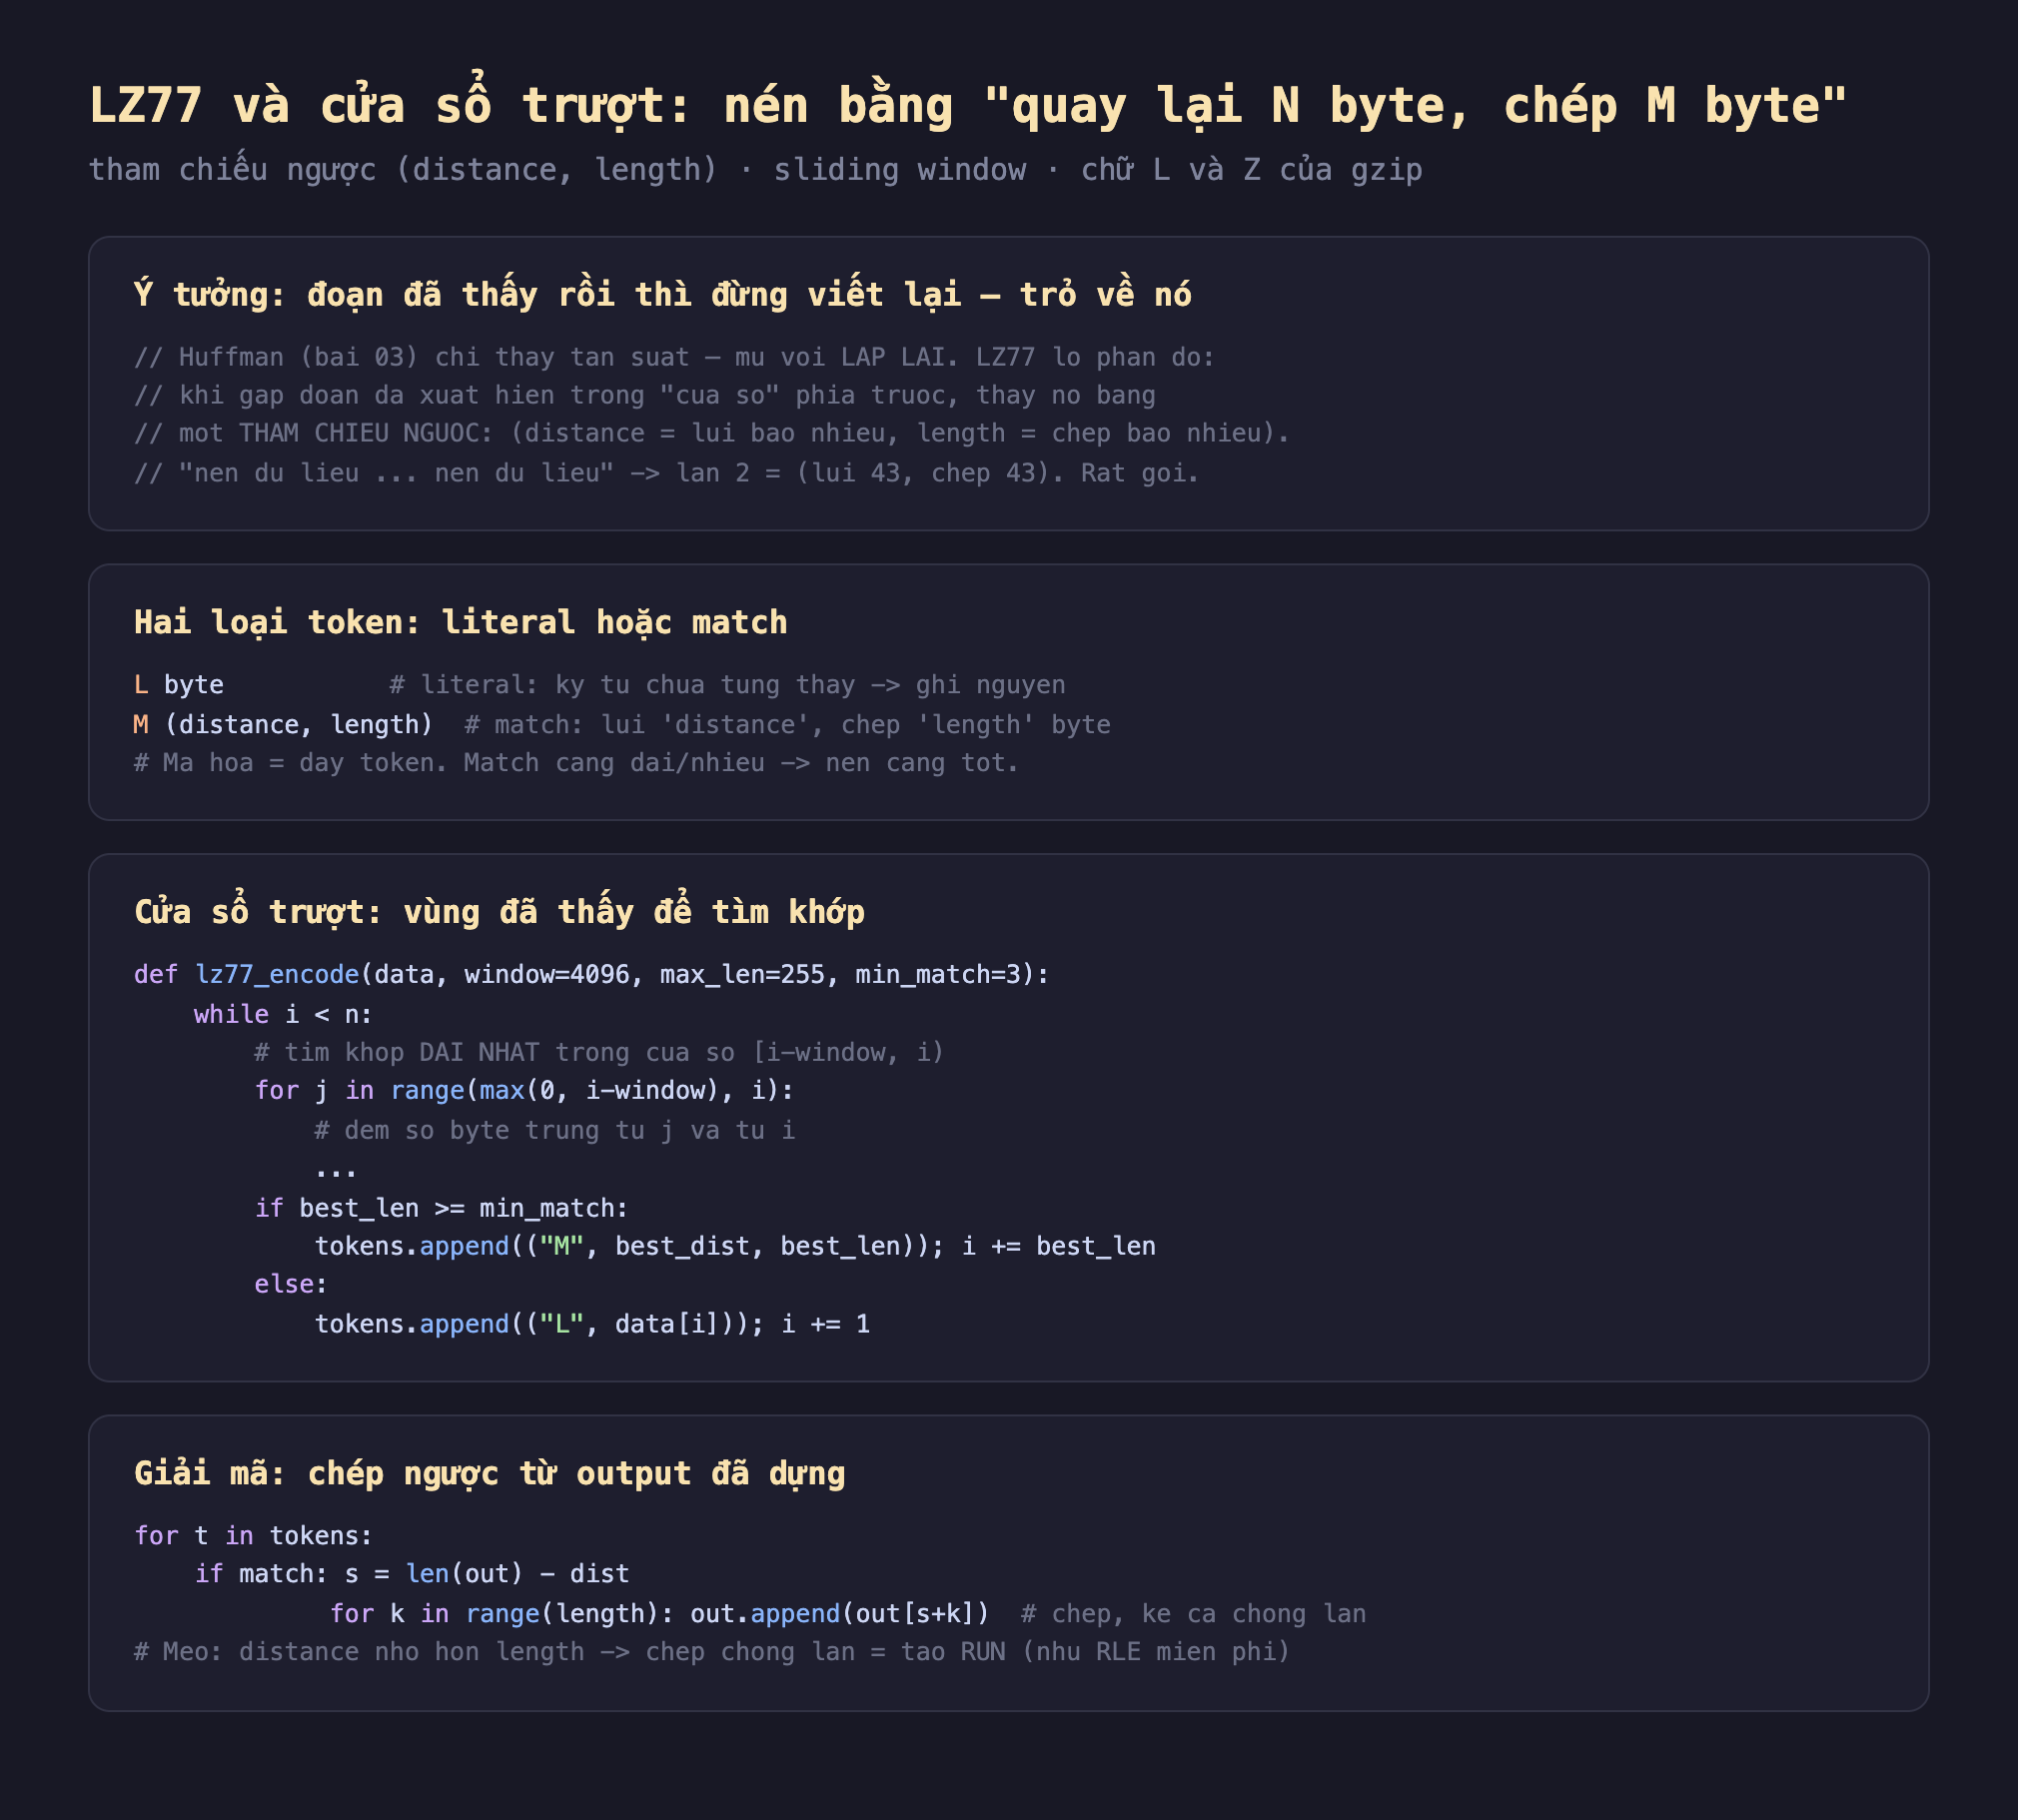
Hình 1: LZ77 quét dữ liệu, tìm khớp dài nhất trong cửa sổ trượt (vùng đã thấy); sinh dãy token literal (L byte) hoặc match (M (distance, length) = lùi distance, chép length); giải mã chép ngược từ output đã dựng, kể cả chép chồng lấn.
Giải mã đơn giản đến bất ngờ: đọc từng token, literal thì ghi thẳng, match thì chép ngược từ chính output đã dựng. Có một mẹo đẹp: khi distance < length, phép chép chồng lấn lên chính nó — tạo ra một run lặp (như RLE miễn phí). Ví dụ match (distance=1, length=100) chép byte trước đó 100 lần → nén một run 100 ký tự bằng một token.
Đo thật: một token thay 51 byte
Mình tự cài LZ77, chạy trên một đoạn văn có câu lặp lại, kiểm round-trip, và in các token:
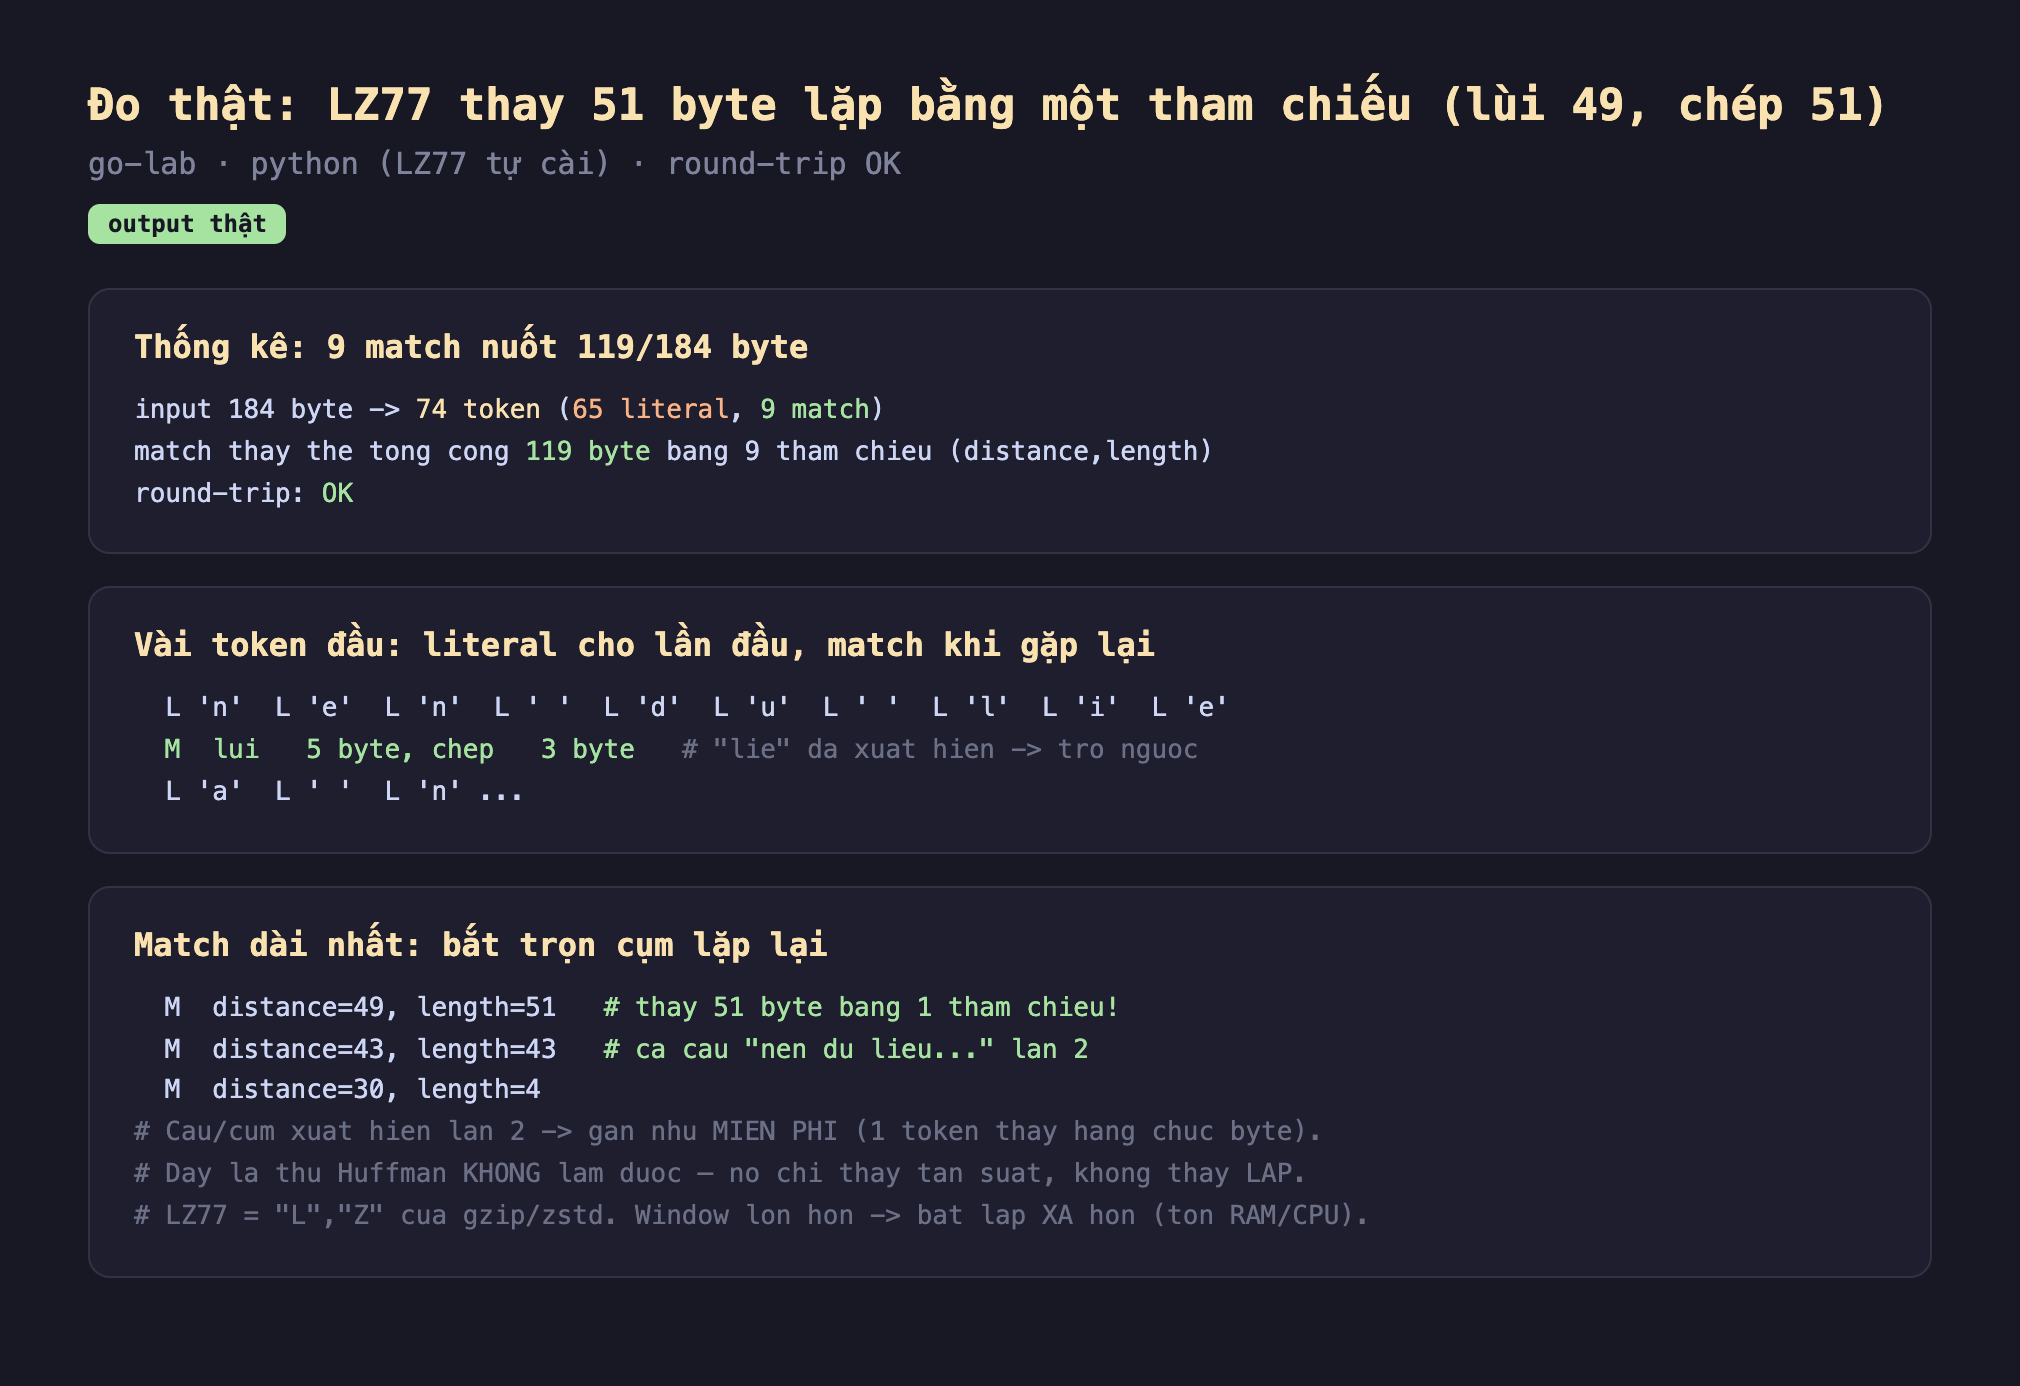
Hình 2: Chạy thật — 184 byte → 74 token (65 literal, 9 match); 9 match thay tổng cộng 119 byte; các token đầu là literal (lần đầu xuất hiện) rồi match; match dài nhất distance=49, length=51 (thay 51 byte bằng một tham chiếu), distance=43, length=43 (cả câu "nen du lieu..." lần 2); round-trip OK.
- Literal cho lần đầu, match khi gặp lại: mười token đầu đều là literal (
L 'n',L 'e'...) vì đó là lần đầu các ký tự xuất hiện — chưa có gì trong cửa sổ để trỏ về. Rồi token thứ 11 là match(lùi 5, chép 3): cụm"lie"đã xuất hiện 5 byte trước, nên trỏ ngược thay vì ghi lại. - Một tham chiếu nuốt trọn cả câu: điểm ấn tượng nhất là các match dài.
distance=49, length=51nghĩa là "lùi 49 byte, chép 51 byte" — thay 51 byte bằng một tham chiếu. Đó chính là câu lặp lại lần hai.distance=43, length=43bắt trọn câu"nen du lieu la nghe thuat loai bo du thua."xuất hiện lần thứ hai. Chín match như vậy nuốt 119/184 byte dữ liệu — thay hơn một nửa văn bản bằng chín con trỏ ngược. - Đây là thứ Huffman không làm được: Huffman nhìn văn bản này chỉ thấy "ký tự n, e, u... với tần suất X" và mã theo đó — nó không thấy rằng cả câu lặp lại. LZ77 thấy và khai thác. Đó là lý do hai thuật toán bù nhau, và gzip dùng cả hai (phần 5): LZ77 loại lặp trước, rồi Huffman mã phần còn lại theo tần suất.
Đánh đổi cần cân nhắc
Cửa sổ càng lớn bắt được lặp càng xa — nhưng tốn RAM và CPU. Cửa sổ trượt quyết định LZ77 "nhớ" được bao xa: cửa sổ 32KB (như gzip) chỉ tìm khớp trong 32KB gần nhất, nên hai đoạn giống nhau cách xa hơn 32KB không được nén. Các thuật toán hiện đại (zstd, xz/LZMA) dùng cửa sổ lớn hơn nhiều (hàng MB) để bắt lặp xa, nhưng phải trả bằng bộ nhớ (giữ cửa sổ) và thời gian (tìm khớp trong không gian lớn hơn). Đây là một trong những nút chỉnh chính khi cân bằng tỉ lệ nén với tài nguyên (phần 6, 7).
Tìm khớp dài nhất là phần đắt nhất — và là nơi các thuật toán khác nhau. Cài ngây thơ ở trên quét mọi vị trí trong cửa sổ cho mỗi byte → rất chậm (O(n·window)). Các thư viện thật dùng cấu trúc dữ liệu thông minh (hash chain, cây hậu tố, hash table của zstd) để tìm khớp nhanh. Chất lượng của bộ tìm khớp — nó chịu bỏ công tìm khớp dài nhất hay chỉ khớp đủ tốt — chính là khác biệt lớn giữa các mức nén (gzip -1 vs -9, phần 6) và giữa các thuật toán.
LZ77 một mình chưa phải là bản nén cuối. Bản thân các token (distance, length, literal) vẫn cần được mã hóa thành bit — và chúng cũng có phân phối lệch (distance nhỏ phổ biến hơn). Nên các thuật toán thực chồng một tầng mã entropy (Huffman trong DEFLATE, ANS trong zstd) lên trên đầu ra LZ77. LZ77 loại lặp, tầng entropy loại dư thừa tần suất của chính các token — hai tầng cho tỉ lệ nén tốt hơn hẳn một tầng.
Ba ý mang về
- LZ77 thay đoạn lặp bằng tham chiếu ngược (distance, length): đo thật một token
distance=49, length=51thay trọn 51 byte, 9 match nuốt 119/184 byte của một đoạn văn lặp câu; round-trip verified — đây là cơ chế "quay lại N byte, chép M byte". - LZ77 bắt lặp lại — thứ Huffman không thấy: đo thật cả câu lặp lần hai bị thay bằng một tham chiếu, trong khi Huffman (phần 3) chỉ mã theo tần suất ký tự; hai thuật toán bù nhau, gzip dùng cả hai.
- Cửa sổ và bộ tìm khớp là nút chỉnh chính: cửa sổ lớn bắt lặp xa hơn nhưng tốn RAM/CPU; tìm khớp dài nhất là phần đắt nhất và là nơi các mức nén/thuật toán khác nhau; và LZ77 luôn được chồng thêm một tầng mã entropy (Huffman/ANS) để nén tiếp các token.
Nguồn
- Lempel & Ziv — A Universal Algorithm for Sequential Data Compression (1977): https://ieeexplore.ieee.org/document/1055714
- Wikipedia — LZ77 and LZ78: https://en.wikipedia.org/wiki/LZ77_and_LZ78
- zlib — technical details: https://www.zlib.net/feldspar.html
Phần sau ta ghép hai mảnh lại: DEFLATE — thuật toán của gzip và zlib — chính là LZ77 (phần 4) chồng lên Huffman (phần 3); ta sẽ mổ xẻ định dạng gzip thật và đo từng tầng đóng góp bao nhiêu.
