Sau khi hiểu entropy là bức tường (phần 1), giờ ta bắt đầu leo — với thuật toán nén đơn giản nhất tồn tại: run-length encoding (RLE). Ý tưởng ngây thơ đến mức một lập trình viên mới học cũng nghĩ ra: nếu một ký tự lặp lại nhiều lần liên tiếp, đừng ghi nó nhiều lần — ghi một lần kèm số lần lặp. AAAAA thành (5, A). Nhưng chính sự ngây thơ đó dạy một bài học sâu sắc về nén: không có thuật toán nào tốt cho mọi loại dữ liệu. RLE thắng ngoạn mục trên dữ liệu hợp với nó, và thua thảm hại — thậm chí làm dữ liệu to ra — trên dữ liệu không hợp. Bài này (phần 2 loạt Nén) tự cài RLE và đo cả hai mặt bằng số thật.
Cơ chế: một "run" thành một cặp
Một run là một dãy ký tự giống nhau liên tiếp. RLE quét dữ liệu, gộp mỗi run thành một cặp (số lần, giá trị):
AAAAABBB (8 byte) → (5,A)(3,B) (4 byte, dùng 1 byte cho count + 1 cho value)
Càng nhiều run dài, càng tiết kiệm. Mã hóa và giải mã đều chỉ vài dòng — RLE cực nhanh, không cần bảng tần suất hay từ điển như các thuật toán sau.
def rle_encode(data):
    out = bytearray(); i = 0; n = len(data)
    while i < n:
        v = data[i]; run = 1
        while i+run < n and data[i+run] == v and run < 255:
            run += 1                      # đếm độ dài run (tối đa 255)
        out.append(run); out.append(v)    # ghi (số_lần, giá_trị)
        i += run
    return bytes(out)
Giải mã là bung ngược: mỗi cặp (count, value) thành value lặp count lần. Luôn phải kiểm round-trip: rle_decode(rle_encode(d)) == d.
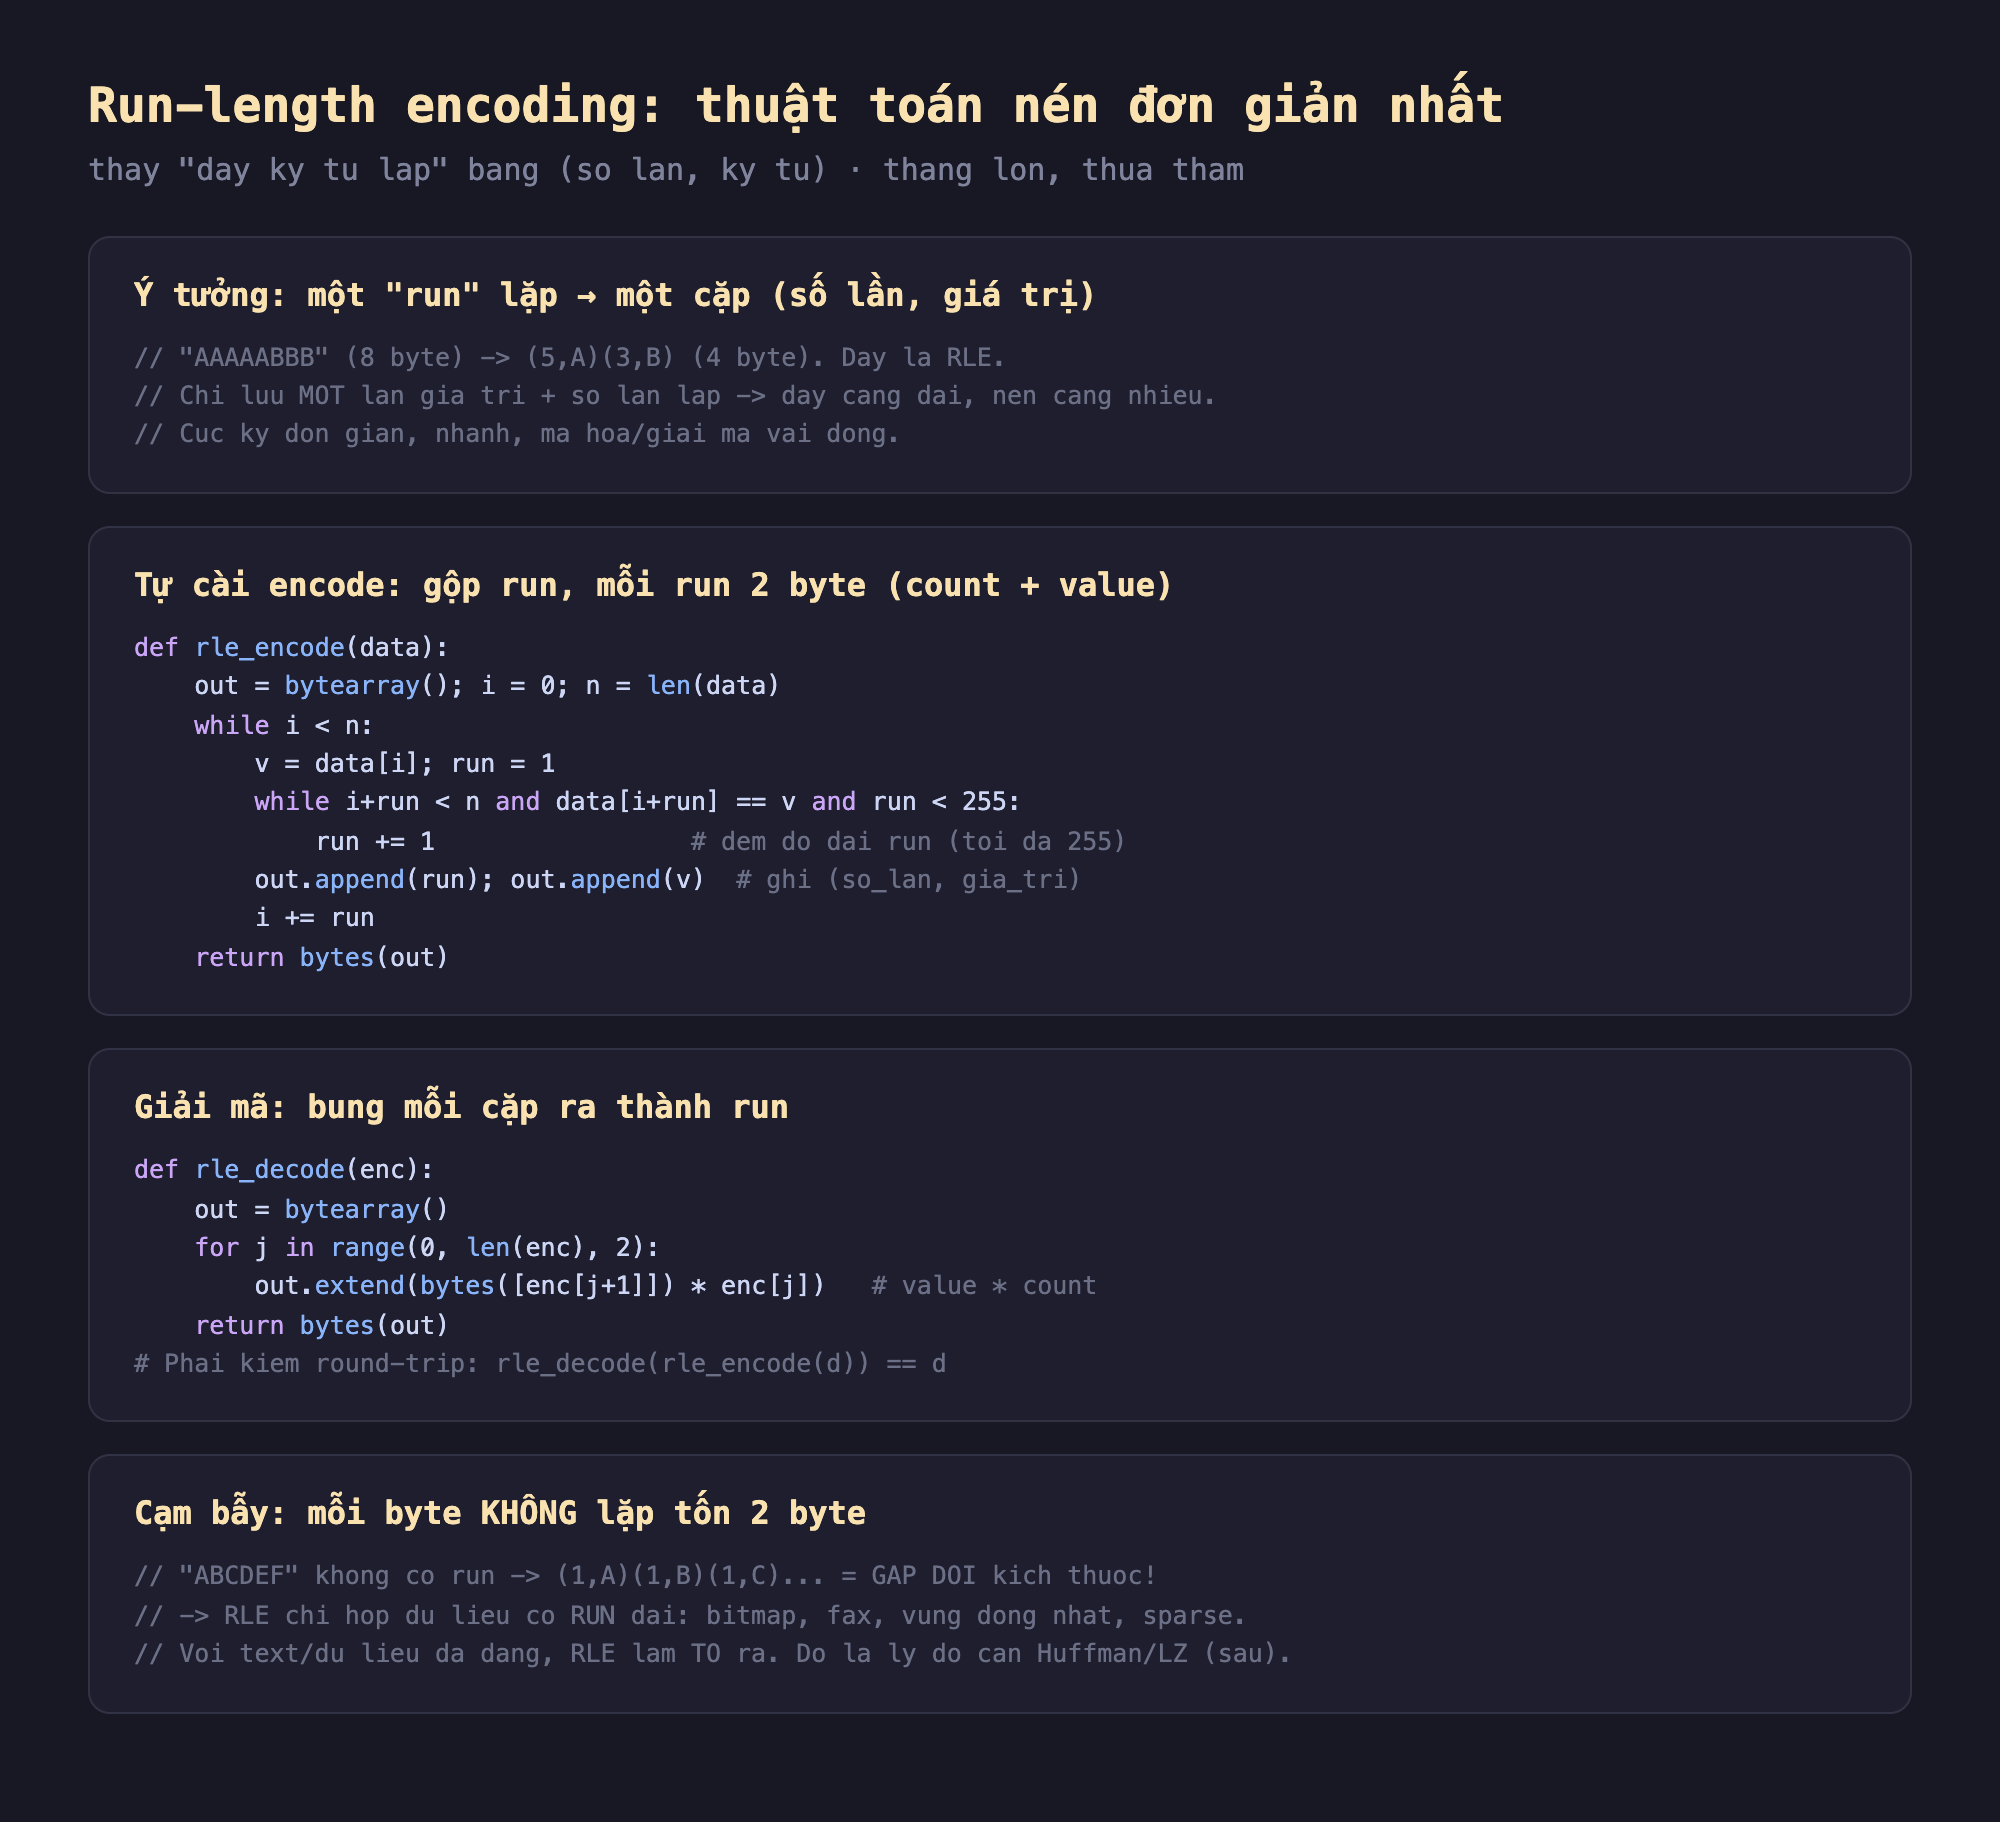
Hình 1: RLE gộp mỗi run (dãy ký tự giống nhau liên tiếp) thành cặp (số lần, giá trị); encode/decode chỉ vài dòng; cạm bẫy là mỗi byte không lặp tốn 2 byte, nên ABCDEF (không run) bị gấp đôi kích thước.
Đo thật: RLE thắng đậm ở đâu, thua thảm ở đâu
Mình tự cài RLE, kiểm round-trip, rồi đo trên ba loại dữ liệu (so thêm với gzip):
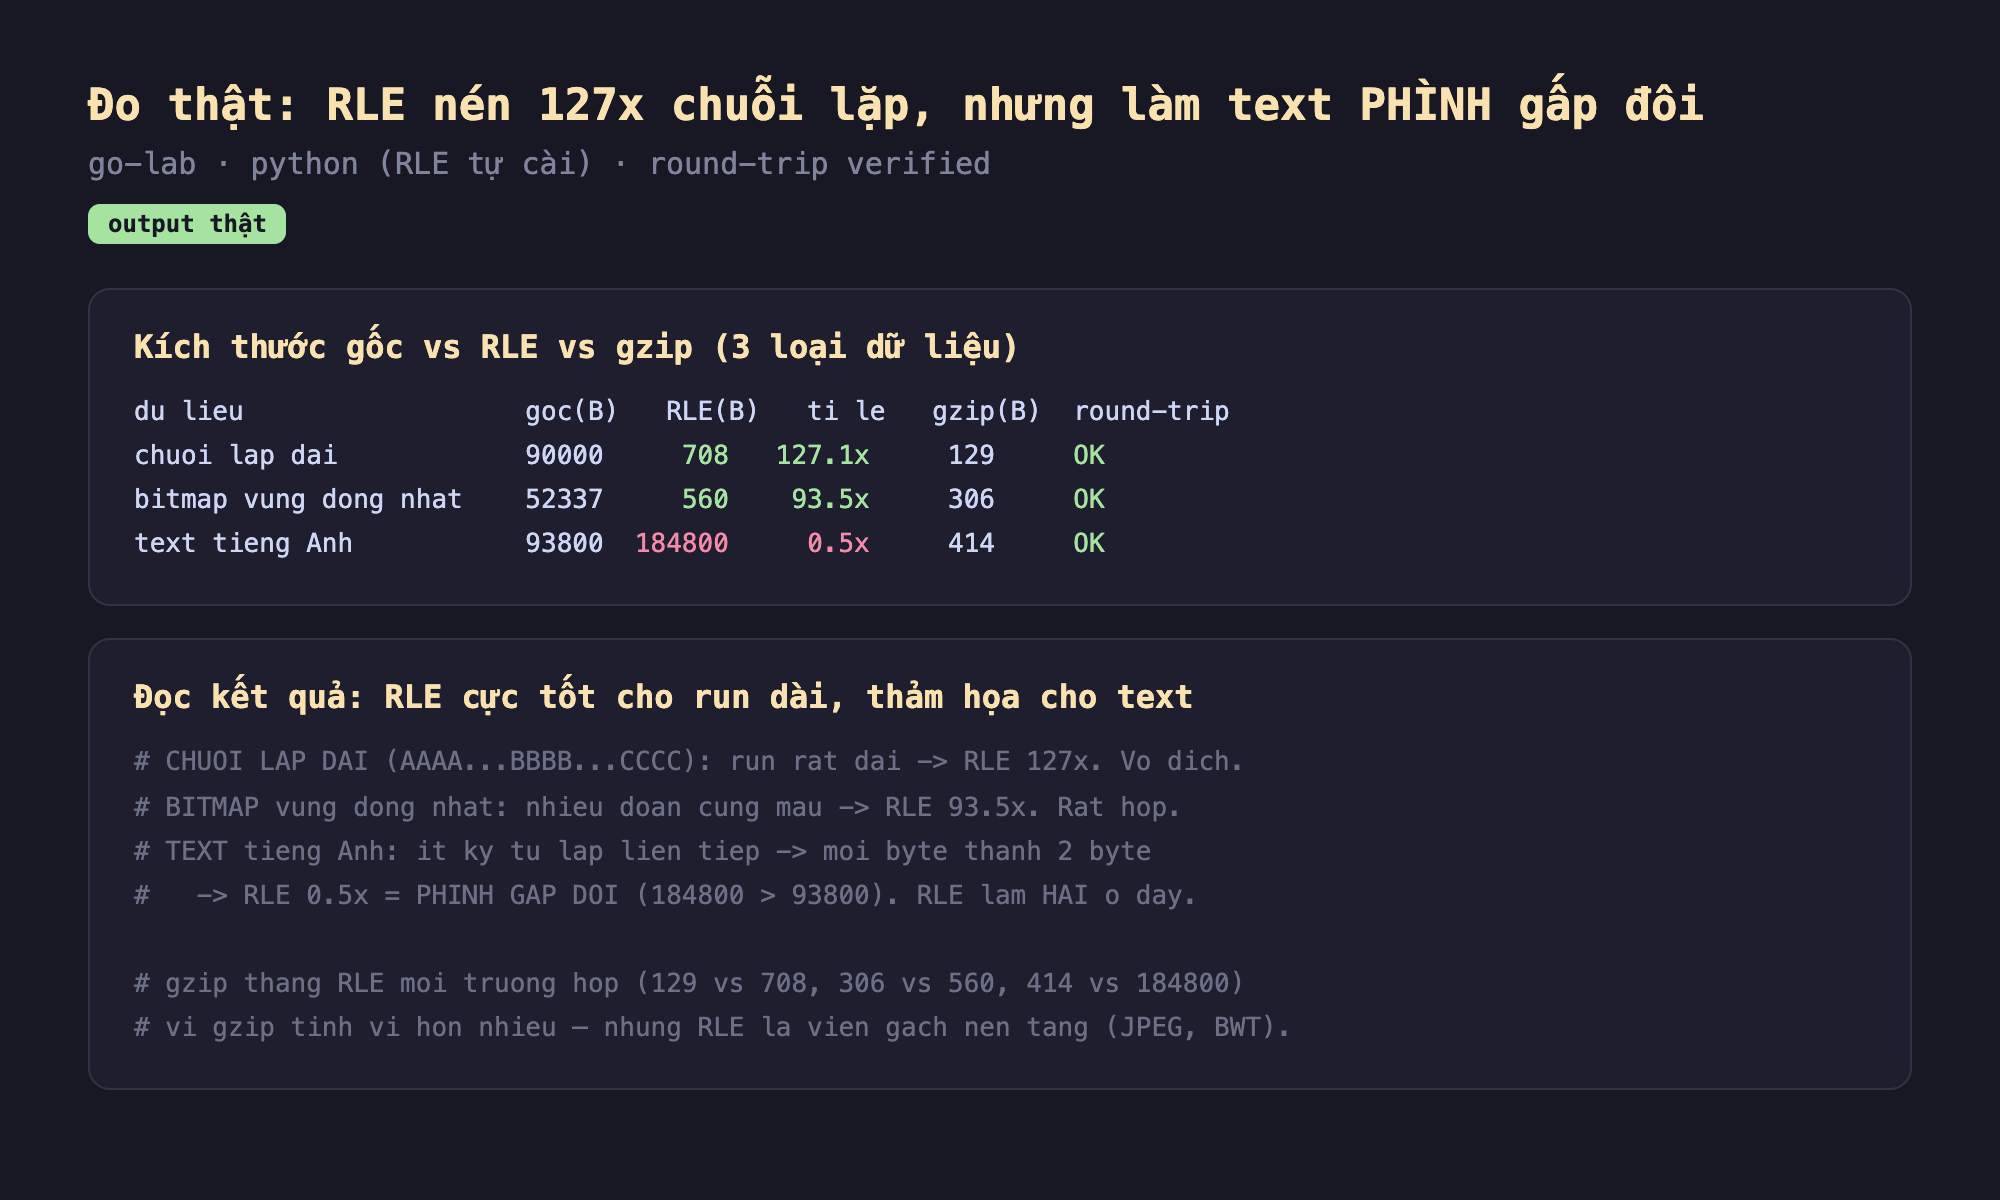
Hình 2: Chạy thật — chuỗi lặp dài 90000B → RLE 708B (127.1x); bitmap vùng đồng nhất 52337B → RLE 560B (93.5x); text tiếng Anh 93800B → RLE 184800B (0.5x — phình gấp đôi); round-trip đúng cả ba; gzip thắng RLE mọi trường hợp (129/306/414B).
- Chuỗi lặp dài — RLE vô địch: khối
AAAA...BBBB...CCCC(mỗi ký tự lặp hàng chục nghìn lần) nén từ 90.000 xuống 708 byte — tỉ lệ 127x. Đúng địa hình của RLE: run cực dài, mỗi run gộp thành vài byte. - Bitmap vùng đồng nhất — rất hợp: dữ liệu mô phỏng ảnh có nhiều vùng cùng màu (fax, biểu tượng, ảnh trắng-đen) nén từ 52.337 xuống 560 byte (93.5x). Đây là lý do RLE lịch sử được dùng cho fax và ảnh bitmap: những dữ liệu đó đầy run dài.
- Text tiếng Anh — thảm họa, phình gấp đôi: đây là bài học đắt giá. Text bình thường hiếm khi có ký tự lặp liên tiếp (
Compression...— không có run nào dài). Nên mỗi byte đơn lẻ bị RLE biến thành hai byte ((1, C)(1, o)(1, m)...), làm dữ liệu phình gấp đôi: 93.800 → 184.800 byte (tỉ lệ 0.5x). RLE không chỉ vô dụng ở đây — nó làm hại. - gzip thắng mọi nơi (nhưng đó là chuyện đương nhiên): gzip nén tốt hơn RLE cả ba trường hợp (129 vs 708, 306 vs 560, 414 vs 184800) vì nó kết hợp LZ77 và Huffman (phần 5) — tinh vi hơn nhiều. Nhưng đừng vì thế coi thường RLE: nó là viên gạch nền tảng mà các thuật toán hiện đại dùng bên trong.
Đánh đổi cần cân nhắc
RLE chỉ dùng khi bạn biết chắc dữ liệu có run dài. Nếu áp RLE lên dữ liệu đa dạng (text, dữ liệu nhị phân trộn), nó làm to ra và bạn mất trắng. Quy tắc: chỉ dùng RLE cho dữ liệu sparse (nhiều số 0 liên tiếp), bitmap vùng đồng nhất, hoặc dữ liệu đã qua một phép biến đổi tạo ra run (như BWT ở dưới). Một cách an toàn là thử RLE và chỉ giữ kết quả nếu nó nhỏ hơn bản gốc (thêm một cờ đánh dấu "đã nén hay chưa").
RLE là thành phần bên trong các thuật toán lớn, không phải giải pháp độc lập. JPEG dùng RLE để nén các hệ số DCT (nơi có nhiều số 0 liên tiếp sau khi lượng tử hóa). PNG dùng một dạng lọc rồi DEFLATE. Burrows-Wheeler Transform (trong bzip2) sắp xếp lại dữ liệu để tạo ra run dài, rồi mới RLE + Huffman. Nên hiểu RLE không phải để dùng nó một mình, mà để hiểu các thuật toán lớn hơn hoạt động thế nào.
Có nhiều biến thể RLE tránh phình. Cài đơn giản ở trên luôn tốn 2 byte mỗi run kể cả run độ dài 1. Các biến thể thực tế dùng cờ escape (chỉ đánh dấu run khi đủ dài, còn lại chép nguyên) hoặc mã hóa thông minh hơn để không bao giờ làm dữ liệu to hơn quá nhiều. PackBits (dùng trong TIFF) là một ví dụ: nó xen kẽ "đoạn lặp" và "đoạn chép nguyên" để xử lý cả dữ liệu có run lẫn không.
Ba ý mang về
- RLE thay run lặp bằng (số lần, giá trị) — đơn giản và cực nhanh: đo thật nén chuỗi lặp 90.000 byte còn 708 byte (127x), bitmap vùng đồng nhất còn 93.5x; round-trip verified; hợp nhất cho dữ liệu có run dài (fax, bitmap, sparse).
- Không hợp thì làm HẠI: đo thật text tiếng Anh 93.800 byte bị RLE phình thành 184.800 byte (0.5x) vì mỗi byte không lặp tốn 2 byte — minh chứng "không thuật toán nào tốt cho mọi dữ liệu"; chỉ dùng RLE khi biết chắc có run dài.
- RLE là viên gạch nền của thuật toán lớn: gzip thắng RLE mọi trường hợp, nhưng RLE được dùng bên trong JPEG (hệ số DCT), bzip2 (sau BWT), TIFF (PackBits) — hiểu RLE để hiểu các hệ thống nén hiện đại.
Nguồn
- Wikipedia — Run-length encoding: https://en.wikipedia.org/wiki/Run-length_encoding
- Apple — PackBits (biến thể RLE trong TIFF): https://en.wikipedia.org/wiki/PackBits
- Python docs — gzip: https://docs.python.org/3/library/gzip.html
Phần sau ta lên một bậc: Huffman coding — thay vì gộp run, nó gán mã ngắn cho ký tự phổ biến và mã dài cho ký tự hiếm, tiến sát giới hạn entropy order-0 mà phần 1 đã đo.
