Nén dữ liệu nghe như phép thuật: cùng một tệp mà "co" lại còn một phần mười, rồi "nở" ra y nguyên. Nhưng phép thuật đó có một bức tường không thể vượt, và bức tường ấy là toán học thuần túy: entropy của Claude Shannon. Trước khi học bất kỳ thuật toán nén cụ thể nào (Huffman, LZ77, gzip ở các phần sau), phải hiểu entropy — vì nó trả lời câu hỏi nền tảng: một khối dữ liệu có thể co lại tới đâu, và vì sao có dữ liệu không co được chút nào. Bài này (phần 1 loạt Nén) đo thật để thấy bức tường entropy hiện ra bằng con số: dữ liệu càng ngẫu nhiên càng khó nén, và dữ liệu hoàn toàn ngẫu nhiên thì gzip còn làm nó to ra.
Nén là loại bỏ dư thừa
Mọi thuật toán nén không-mất-mát đều dựa trên một sự thật: dữ liệu thực có cấu trúc, tức là không phải mọi tổ hợp bit đều xuất hiện với xác suất như nhau. Trong tiếng Việt, chữ n phổ biến hơn z rất nhiều; trong một tệp JSON, chuỗi {"id": lặp đi lặp lại. Sự "không đều" và "lặp lại" đó chính là dư thừa — và nén là nghệ thuật diễn đạt cùng thông tin bằng ít bit hơn nhờ loại bỏ dư thừa.
Entropy đo lượng thông tin trung bình mỗi ký tự mang theo, tính bằng bit:
H = -Σ p(x) · log₂ p(x) # p(x) = tần suất của ký tự x
Hcao → các ký tự xuất hiện đều nhau, khó đoán ký tự tiếp theo → khó nén.Hthấp → vài ký tự áp đảo, dễ đoán → dễ nén.H = 8 bit/byte→ tối đa: mỗi byte "bất ngờ" như nhau → không nén được.
Định lý Shannon nói: không thuật toán không-mất-mát nào có thể nén xuống dưới H bit trung bình mỗi ký tự. Đó là bức tường.
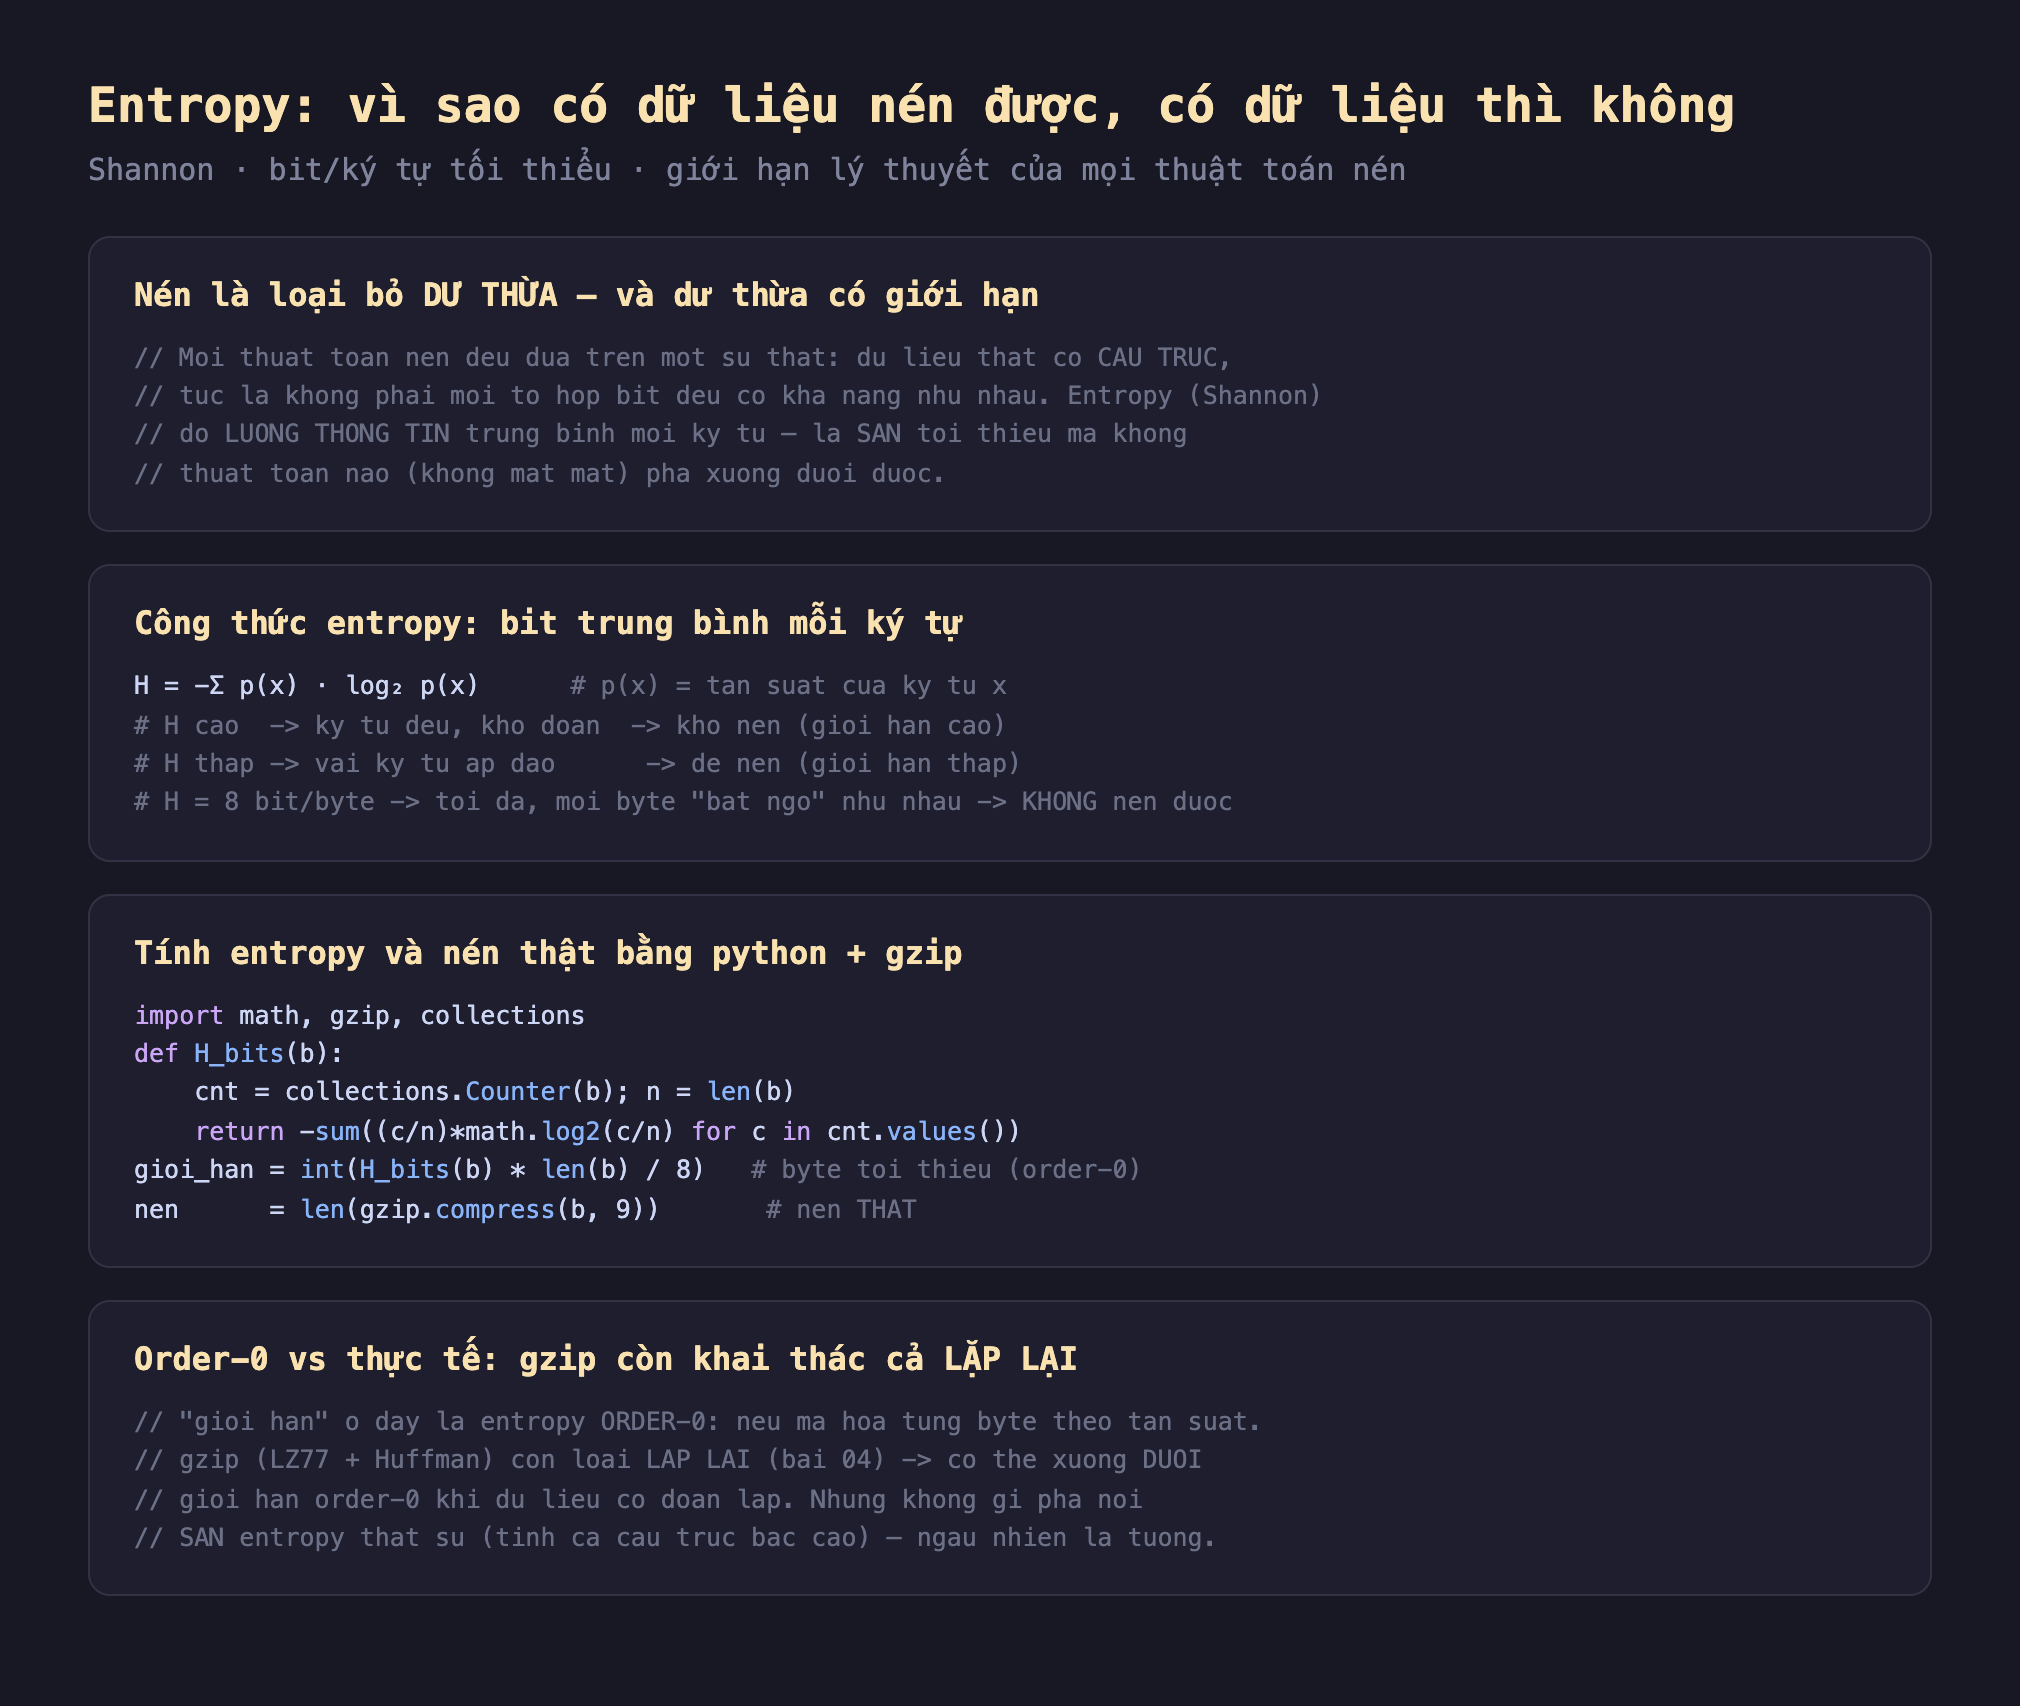
Hình 1: Nén = loại bỏ dư thừa; entropy Shannon H = -Σ p(x)·log₂ p(x) đo bit trung bình mỗi ký tự — là sàn tối thiểu; H=8 bit/byte là tối đa (không nén được); gzip có thể xuống dưới giới hạn entropy order-0 vì còn khai thác cả sự lặp lại.
Đo thật: entropy quyết định nén được bao nhiêu
Mình tính entropy (bằng python) và nén thật (bằng gzip -9) bốn loại dữ liệu, mỗi loại 90.000 byte:
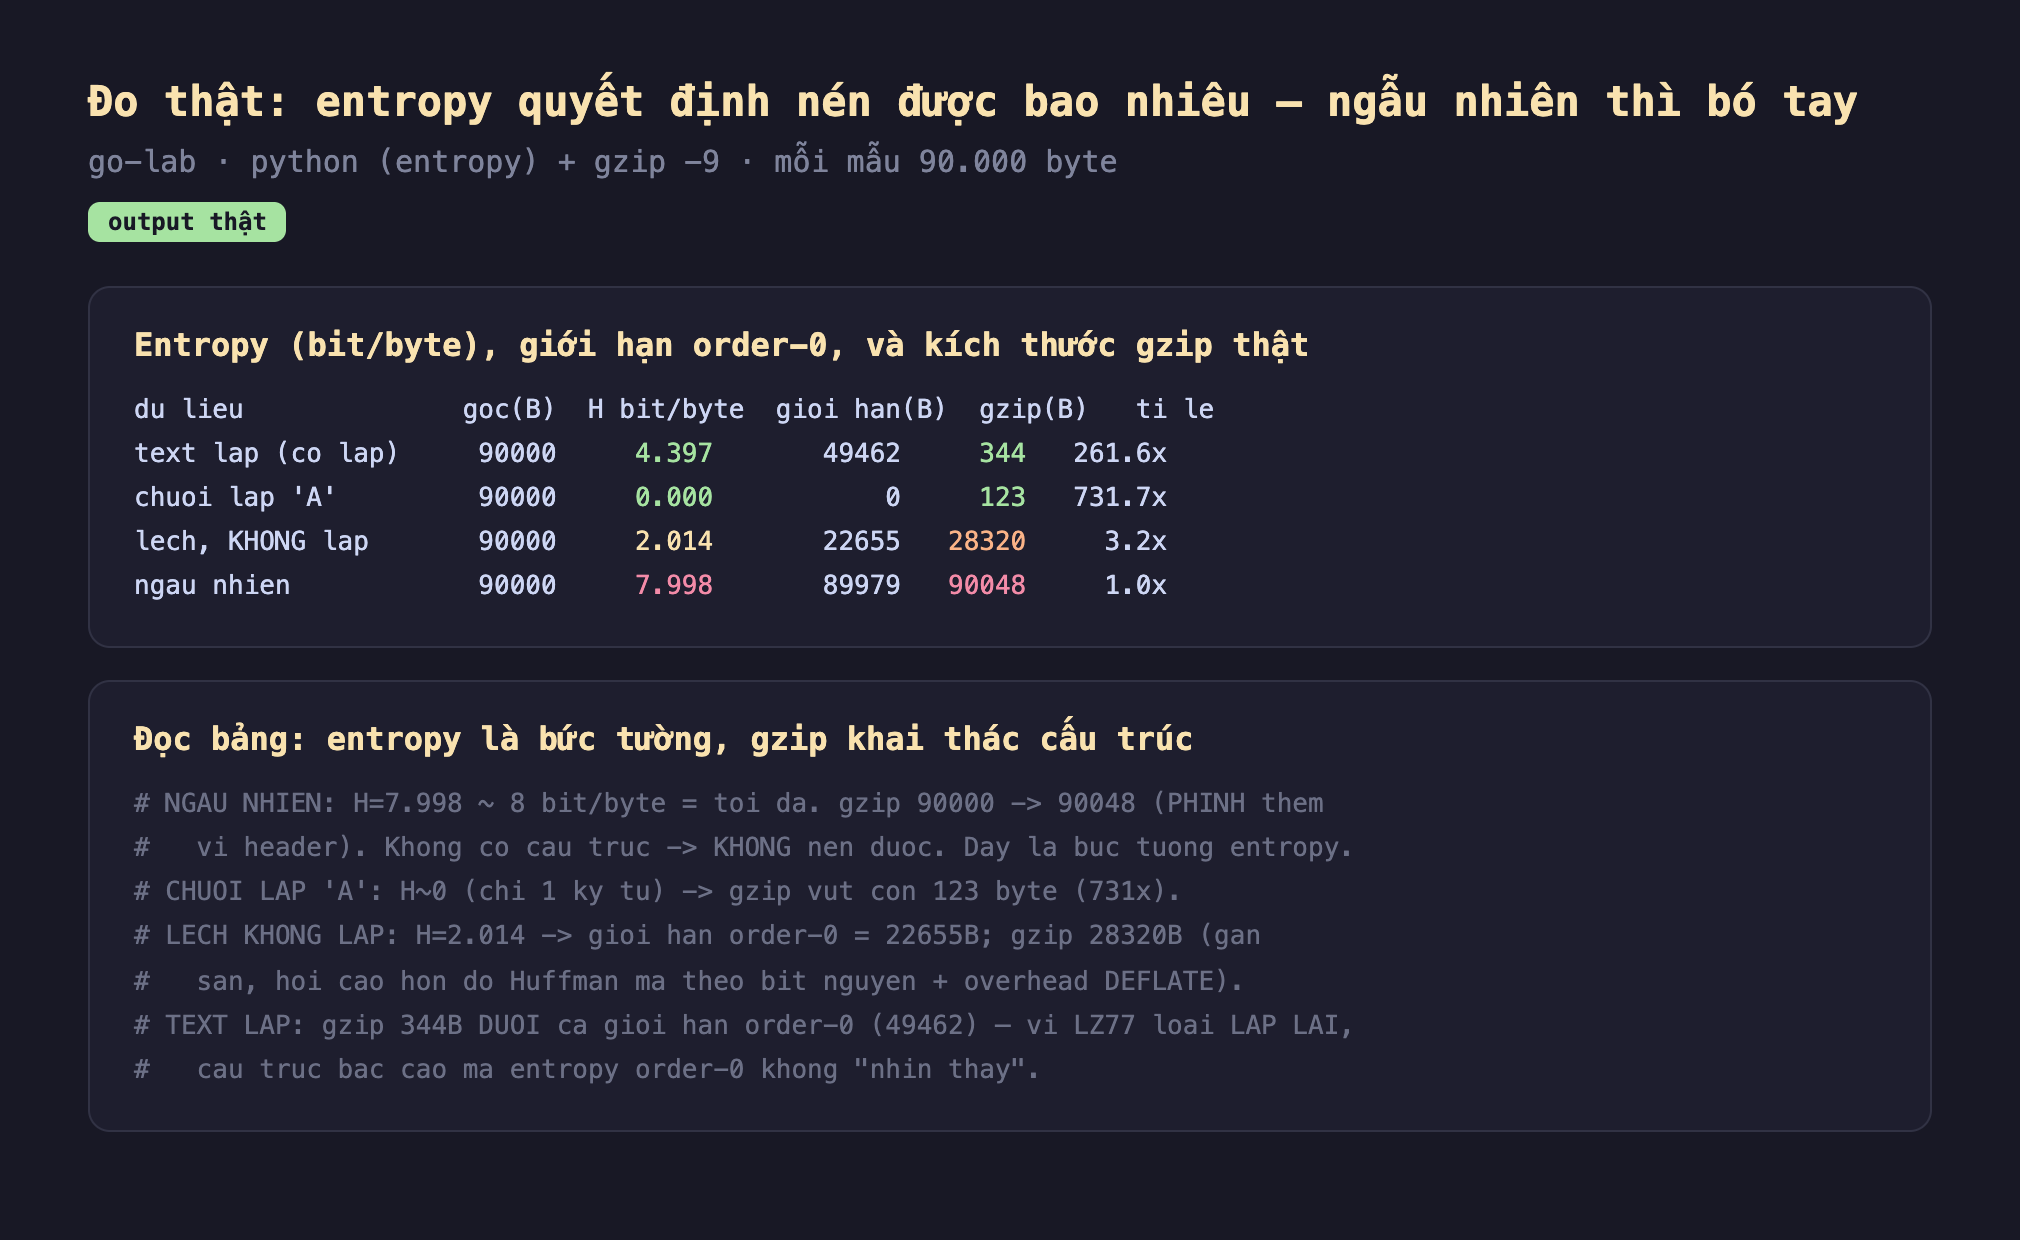
Hình 2: Chạy thật — chuỗi lặp 'A' (H≈0) gzip còn 123 byte (731x); "lệch không lặp" (H=2.014) gzip 28320B gần giới hạn order-0 22655B; text lặp gzip 344B (dưới giới hạn order-0 nhờ LZ77); ngẫu nhiên (H=7.998) gzip 90000→90048 byte (phình thêm, không nén được).
- Ngẫu nhiên = bức tường entropy: 90.000 byte từ
os.urandomcó entropy7.998— gần sát 8 bit/byte tối đa. Không có ký tự nào phổ biến hơn, không có đoạn nào lặp lại. gzip không những không nén được mà còn làm nó to ra:90000 → 90048byte (thêm 48 byte header/overhead). Đây là minh chứng trực tiếp cho định lý Shannon: khi entropy đã tối đa, không còn dư thừa nào để loại, mọi nỗ lực nén chỉ tổ thêm overhead. (Đây cũng là lý do nén một tệp đã nén — hay dữ liệu mã hóa — gần như vô ích.) - Entropy thấp = nén khủng: chuỗi 90.000 chữ
'A'có entropy0(chỉ một ký tự, không có "bất ngờ" nào). gzip vụt nó còn 123 byte — tỉ lệ 731x. Toàn bộ thông tin là "chữ A, lặp 90.000 lần", diễn đạt được bằng vài chục byte. - gzip gần sàn order-0 khi không có lặp lại: dữ liệu "lệch, KHÔNG lặp" (mỗi byte rút độc lập từ phân phối thiên lệch) có entropy
2.014, cho giới hạn order-0 là22655byte. gzip đạt28320byte — gần sàn nhưng hơi cao hơn (~1.25x), vì Huffman mã theo bit nguyên và DEFLATE có overhead khối. Không có đoạn lặp để LZ77 khai thác, nên gzip chủ yếu dựa vào tần suất, và tiệm cận nhưng không chạm đúng sàn lý thuyết. - gzip xuống dưới sàn order-0 khi có lặp lại: text tiếng Anh lặp có entropy order-0
4.397(giới hạn49462byte), nhưng gzip chỉ ra344byte — thấp hơn giới hạn order-0 hàng trăm lần. Không mâu thuẫn Shannon: entropy order-0 chỉ tính tần suất từng byte, còn dữ liệu này có cấu trúc bậc cao (cả câu lặp lại) mà LZ77 (phần 4) khai thác được. Bức tường entropy thật (tính cả cấu trúc bậc cao) vẫn còn đó, chỉ là thấp hơn nhiều so với ước lượng order-0.
Đánh đổi cần cân nhắc
Entropy order-0 là ước lượng, không phải giới hạn cuối. Con số H tính theo tần suất từng byte (order-0) dễ tính nhưng đánh giá cao giới hạn thật, vì nó bỏ qua mọi tương quan giữa các byte. Giới hạn thật (entropy của nguồn, tính cả cấu trúc bậc cao) thấp hơn và khó tính chính xác. Khi bạn thấy gzip nén dưới entropy order-0, đó không phải phép màu — chỉ là order-0 không "nhìn thấy" hết cấu trúc. Dùng entropy order-0 như một ước lượng nhanh về giới hạn trên, đừng coi là con số tuyệt đối.
Không nén dữ liệu đã nén hoặc đã mã hóa. Vì nén tốt đẩy dữ liệu tới gần entropy tối đa (trông như ngẫu nhiên), nén lại lần hai gần như vô ích và có thể làm to hơn — đúng như ca ngẫu nhiên ở trên. Tương tự, dữ liệu mã hóa (encrypted) trông ngẫu nhiên nên không nén được. Trong pipeline, luôn nén trước, mã hóa sau — đảo lại là mất hết khả năng nén.
Đo entropy trước khi kỳ vọng tỉ lệ nén. Nếu bạn đang thiết kế hệ thống và cần biết "dữ liệu này nén được bao nhiêu", tính entropy (hoặc đơn giản là chạy thử gzip trên mẫu thật) trước, thay vì hứa hẹn tỉ lệ. Dữ liệu log lặp lại có thể nén 100x; dữ liệu đã là số ngẫu nhiên/hash thì đừng mong nén. Entropy cho bạn kỳ vọng thực tế.
Ba ý mang về
- Entropy là bức tường của nén: đo thật dữ liệu ngẫu nhiên (H=7.998 bit/byte ≈ tối đa) không nén được — gzip làm 90.000 byte phình thành 90.048; không có dư thừa thì không có gì để nén, đúng định lý Shannon.
- Entropy thấp = dư thừa nhiều = nén khủng: đo thật chuỗi lặp một ký tự (H≈0) gzip còn 123 byte (731x); tỉ lệ nén tỉ lệ nghịch với entropy của dữ liệu.
- gzip khai thác nhiều hơn tần suất order-0: đo thật với text lặp, gzip xuống dưới giới hạn entropy order-0 (344B vs 49462B) nhờ loại bỏ lặp lại (LZ77) — entropy order-0 chỉ là ước lượng giới hạn trên, không phải sàn tuyệt đối; và nhớ nén trước mã hóa sau.
Nguồn
- Claude Shannon — A Mathematical Theory of Communication (1948): https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf
- Python docs — gzip: https://docs.python.org/3/library/gzip.html
- Wikipedia — Entropy (information theory): https://en.wikipedia.org/wiki/Entropy_(information_theory)
Phần sau ta bắt đầu với thuật toán nén đơn giản nhất: run-length encoding (RLE) — nén chuỗi lặp bằng cách ghi "ký tự và số lần", và đo xem nó thắng đậm ở đâu, thua thảm ở đâu.
