Ô tìm kiếm là thứ ai cũng dùng, nhưng đằng sau nó là một bài toán khó ở quy mô lớn: tìm một từ trong hàng triệu tài liệu, tức thì. Cách ngây thơ — LIKE '%từ%' — phải đọc từng tài liệu để kiểm, tức O(n) và không index được. Elasticsearch (và thư viện Lucene bên dưới) giải bằng inverted index. Bài này mổ xẻ nguyên lý đó và dựng thật trong PostgreSQL (tsvector + GIN) để đo trực tiếp — vì Postgres FTS dùng chính cấu trúc inverted index.
Bài toán: LIKE phải quét cả bảng
LIKE '%unicornrare%' có % ở đầu nên B-tree index vô dụng (index chỉ giúp khi biết tiền tố). Postgres buộc phải seq scan — đọc và kiểm từng dòng:
SELECT * FROM docs WHERE noi_dung LIKE '%unicornrare%'; -- quét cả 500.000 dòng
Với 500 nghìn tài liệu còn tạm; với hàng trăm triệu thì mỗi tìm kiếm là một cơn ác mộng I/O.
Cách giải: inverted index (từ → danh sách tài liệu)
Ý tưởng cốt lõi của Lucene/Elasticsearch: thay vì lưu "tài liệu → các từ", lật ngược thành "từ → danh sách tài liệu chứa nó" (posting list). Tìm một từ giờ là tra thẳng danh sách, không quét gì. PostgreSQL có sẵn cấu trúc này: kiểu tsvector (tách từ, chuẩn hoá) + index GIN (chính là một inverted index):
ALTER TABLE docs ADD COLUMN tsv tsvector;
UPDATE docs SET tsv = to_tsvector('simple', noi_dung);   -- tách từ, chuẩn hoá
CREATE INDEX docs_tsv_gin ON docs USING GIN (tsv);        -- GIN = inverted index
Truy vấn full-text dùng toán tử @@, đi qua GIN:
SELECT * FROM docs WHERE tsv @@ to_tsquery('simple', 'unicornrare');
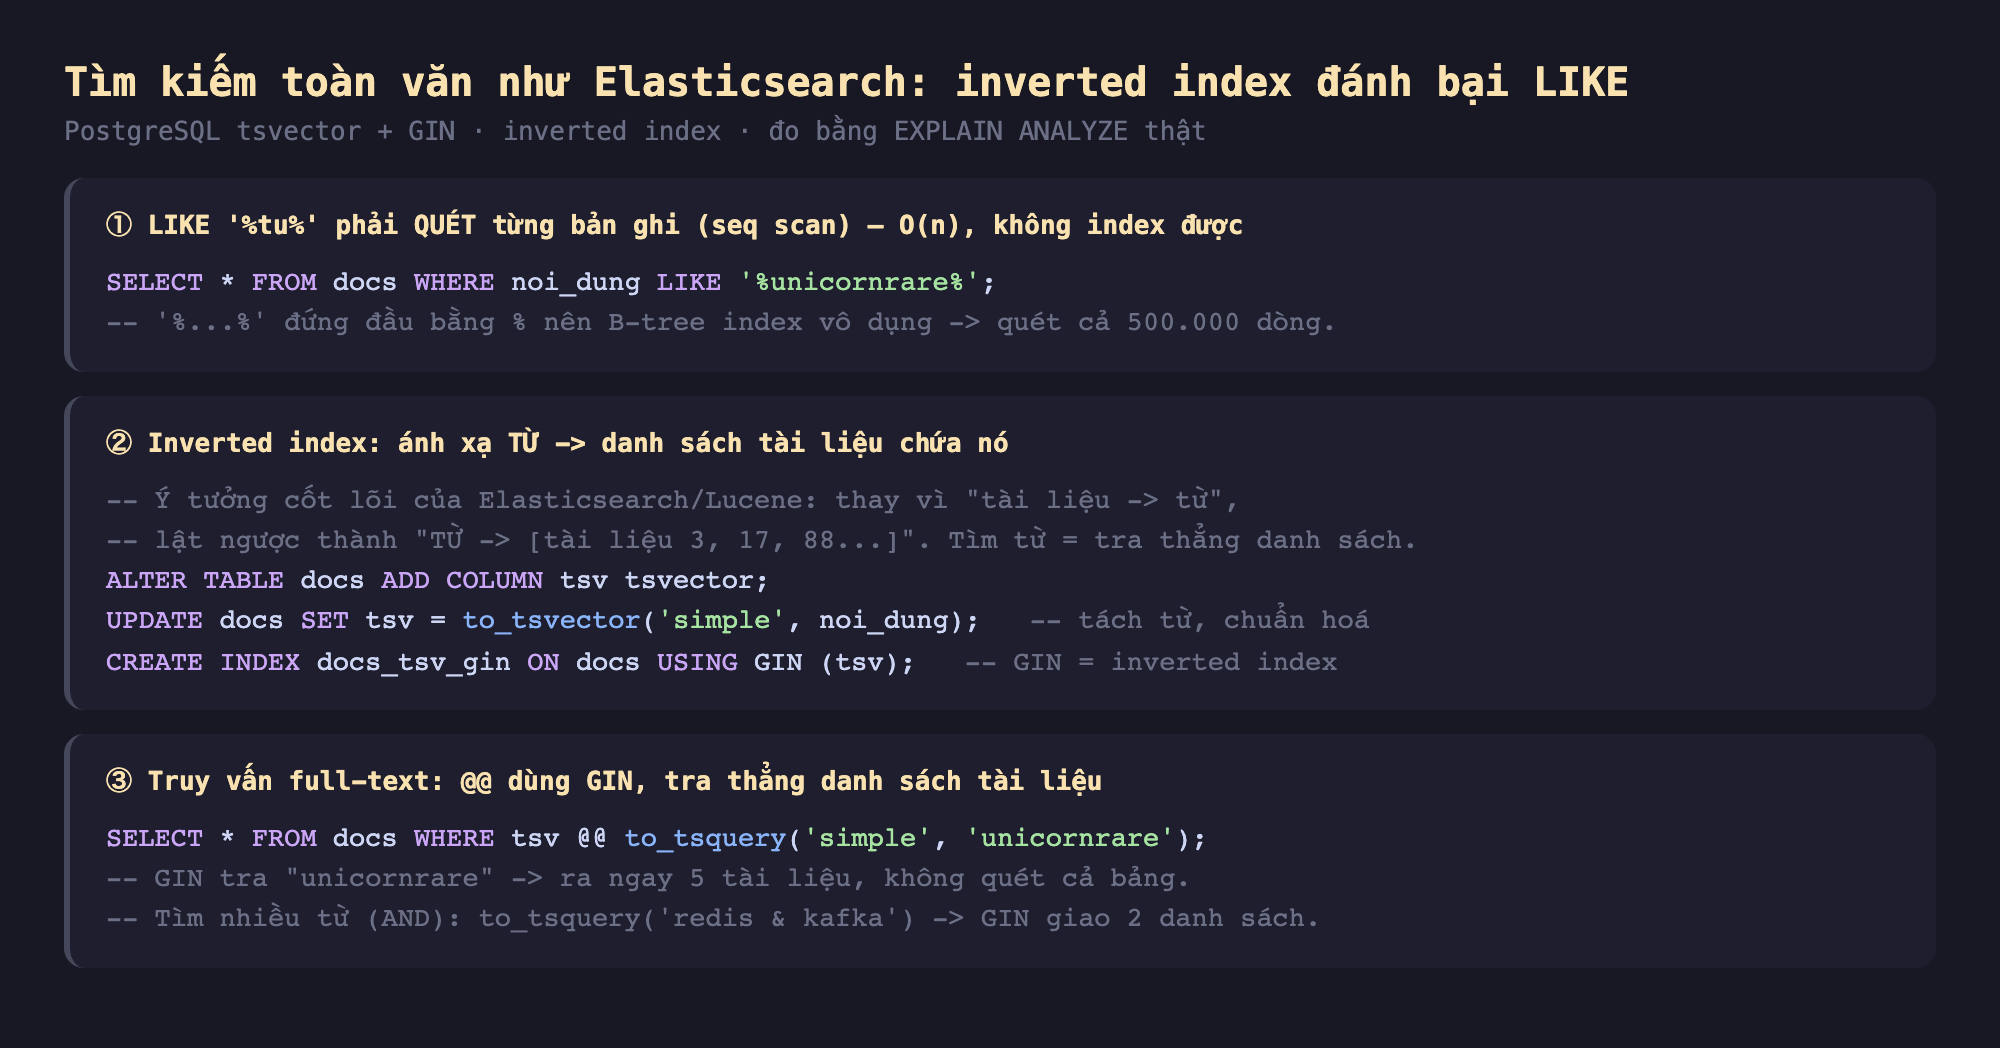
Hình 1: LIKE %từ% buộc seq scan (không index được); inverted index (GIN của Postgres) ánh xạ từ → danh sách tài liệu, to_tsvector tách từ như analyzer của Elasticsearch, @@ tra thẳng qua GIN.
Đo THẬT trong PostgreSQL
Ta nạp 500.000 tài liệu (mỗi cái ~12 từ ngẫu nhiên), thêm một từ hiếm unicornrare vào đúng 5 tài liệu, rồi so LIKE vs GIN bằng EXPLAIN ANALYZE:
LIKE '%unicornrare%'             -> Parallel Seq Scan (quét 500k)
   Execution Time: 39,319 ms
tsv @@ to_tsquery('unicornrare') -> Bitmap Index Scan (GIN)
   Execution Time: 0,036 ms
>> GIN nhanh hơn ~1.092× (39,319 ms / 0,036 ms), CÙNG kết quả (5 = 5)
Cùng câu trả lời (cả hai tìm đúng 5 tài liệu), nhưng inverted index nhanh hơn ~1.092 lần — vì nó tra thẳng thay vì quét. Quan trọng: GIN không bỏ sót (LIKE count = GIN count = 5); index chỉ nhanh hơn, không đổi kết quả. Tìm nhiều từ (AND) cũng nhanh vì GIN giao các posting list:
to_tsquery('redis & kafka & postgres') -> 18.743 tài liệu trong 20,566 ms
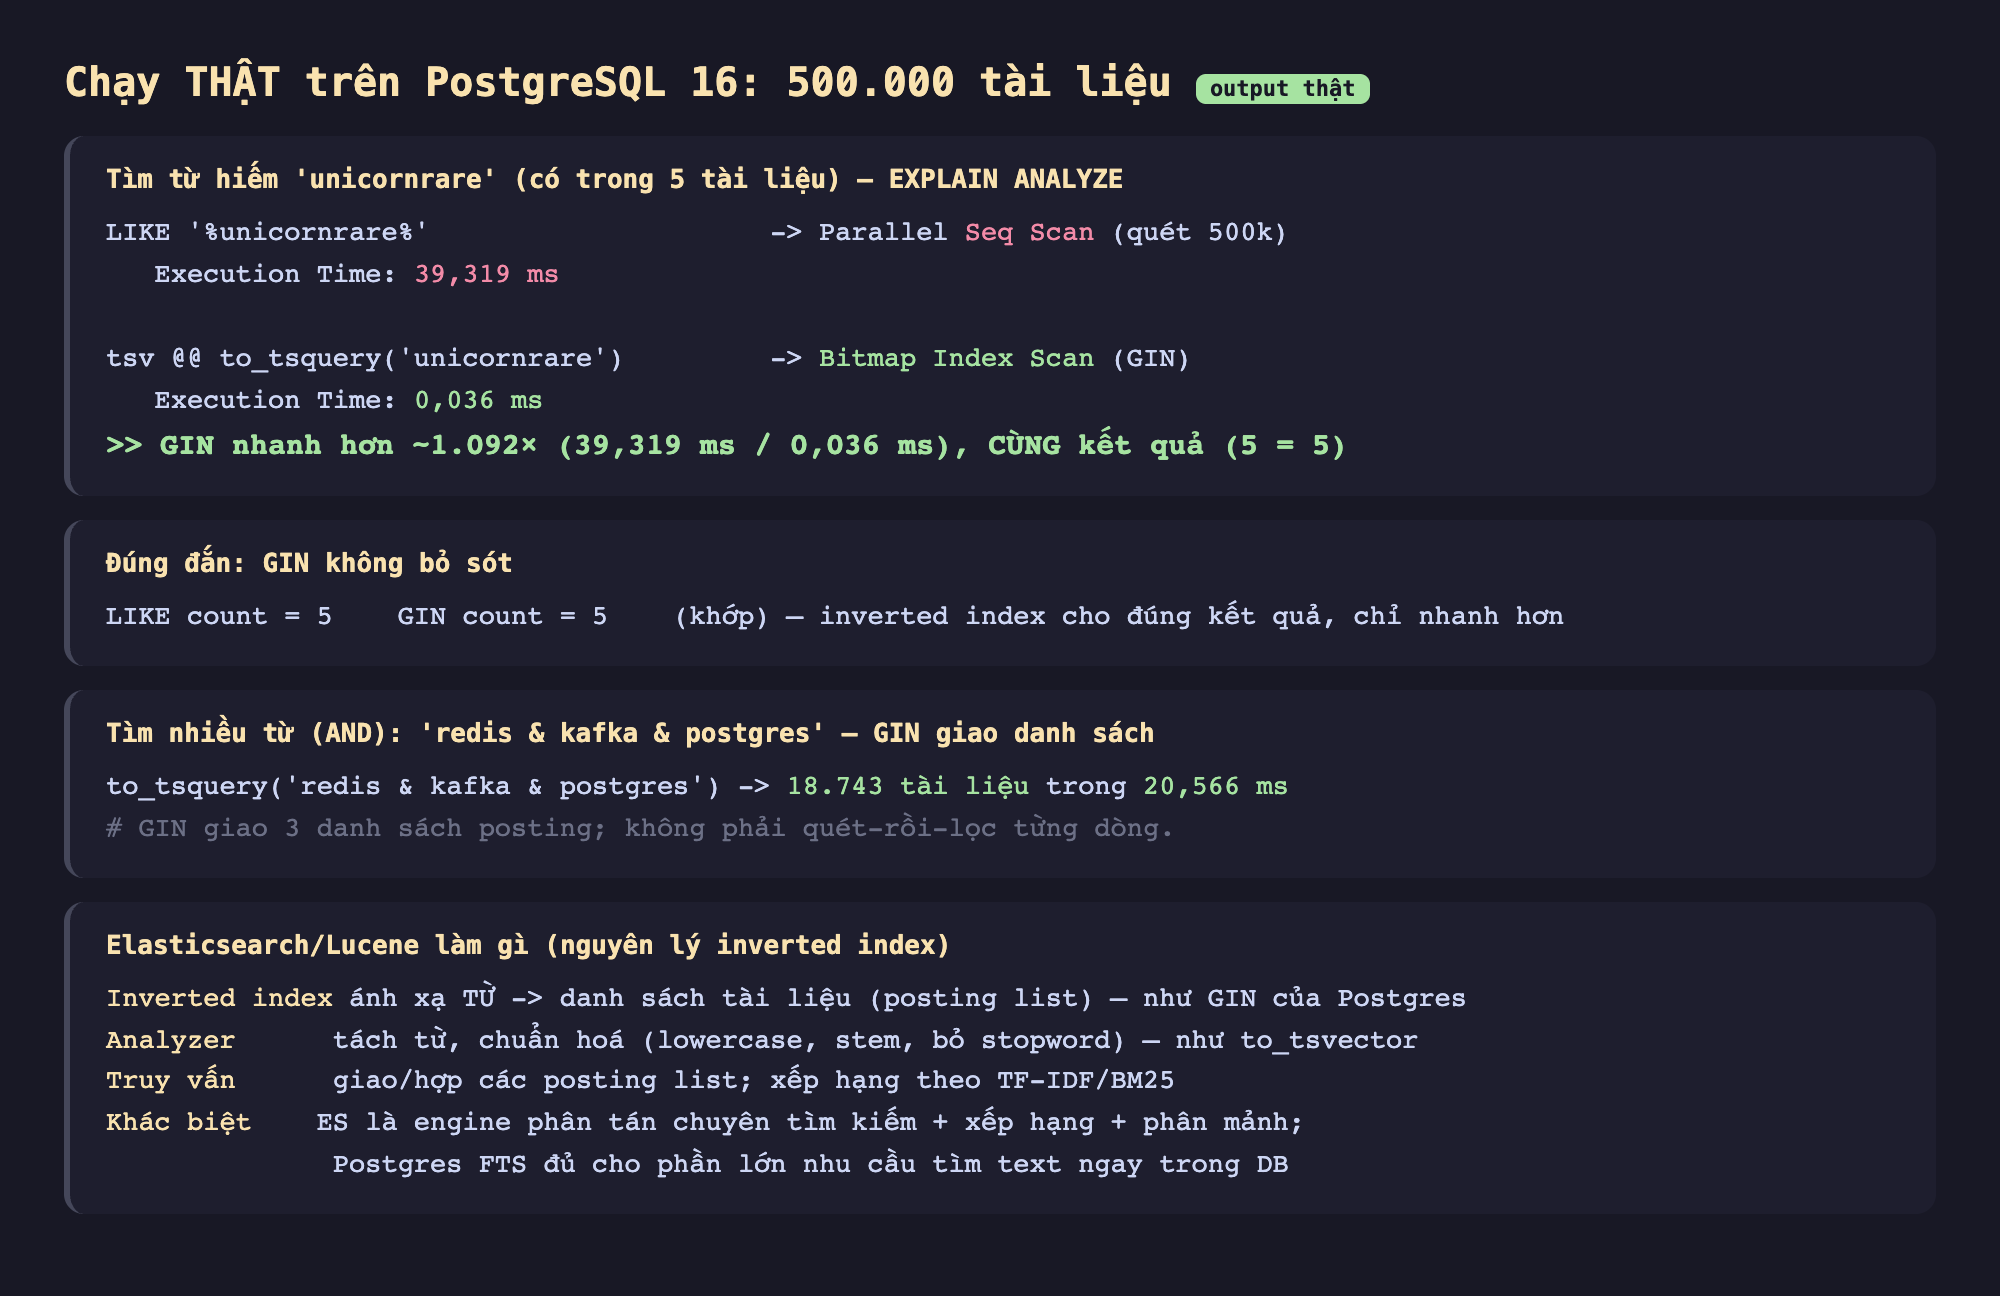
Hình 2: Chạy thật trên PostgreSQL — LIKE seq scan 39,319ms vs GIN inverted index 0,036ms (~1.092×), cùng 5 kết quả; AND ba từ giao posting list 20,566ms/18.743 tài liệu. Kèm nguyên lý inverted index của Elasticsearch/Lucene.
Elasticsearch làm gì hơn Postgres FTS
Nguyên lý giống nhau, nhưng Elasticsearch là engine tìm kiếm phân tán chuyên dụng:
- Analyzer mạnh hơn: tách từ đa ngôn ngữ, stemming, đồng nghĩa, n-gram —
to_tsvectorcủa Postgres làm phần cốt lõi (lowercase, stem, bỏ stopword) nhưng ES linh hoạt hơn nhiều. - Xếp hạng liên quan (relevance) bằng BM25/TF-IDF là mặc định — ES sinh ra để trả "kết quả liên quan nhất", không chỉ "khớp hay không". Postgres có
ts_ranknhưng đơn giản hơn. - Phân tán và phân mảnh sẵn có: ES chia index ra nhiều shard trên nhiều node, sao chép, và gộp kết quả — quy mô mà một Postgres đơn không với tới.
Bài học: cùng một cấu trúc dữ liệu (inverted index) là nền của cả hai; ES thêm lớp phân tán + xếp hạng chuyên biệt. Với phần lớn nhu cầu "tìm text trong app", Postgres FTS đủ và tránh phải vận hành thêm một hệ.
Đánh đổi cần cân nhắc
Inverted index tốn chỗ và tốn ghi. Phải lưu thêm cấu trúc (tsvector + GIN) và cập nhật nó mỗi lần dữ liệu đổi — ghi chậm hơn, tốn đĩa hơn. GIN đặc biệt chậm ghi (có thể hoãn bằng fastupdate). Đổi tốc độ đọc lấy chi phí ghi + lưu trữ.
Không giúp cho mọi kiểu tìm. Inverted index tra theo từ (token). Tìm chuỗi con giữa từ (LIKE '%ana%' khớp 'banana') thì FTS không làm — cần trigram (pg_trgm) hoặc công cụ khác. Chọn cấu trúc theo kiểu truy vấn.
FTS ≠ engine tìm kiếm đầy đủ. Nếu cần relevance tinh vi, gợi ý (autocomplete), highlight, phân tích log quy mô lớn, thì ES/OpenSearch đáng công vận hành. Đừng nhảy sang ES chỉ vì "cần tìm kiếm" khi Postgres FTS đủ — nhưng cũng đừng ép Postgres làm việc của một search engine phân tán.
Ba ý mang về
- LIKE '%từ%' không mở rộng được:
%đầu chuỗi khiến B-tree vô dụng, buộc seq scan cả bảng — đo thật 39,319ms trên 500k tài liệu chỉ để tìm 5. - Inverted index (từ → danh sách tài liệu) là lời giải: PostgreSQL
tsvector+ GIN cho cùng kết quả nhưng nhanh hơn ~1.092× (0,036ms), không bỏ sót, và xử lý AND nhiều từ bằng giao posting list — chính cấu trúc mà Elasticsearch/Lucene dùng. - Cùng nguyên lý, khác quy mô: Postgres FTS đủ cho tìm text trong app; Elasticsearch thêm analyzer mạnh, xếp hạng BM25 và phân tán/phân mảnh — chọn theo nhu cầu, và nhớ inverted index đánh đổi chi phí ghi/lưu trữ lấy tốc độ đọc.
Nguồn
- Elastic — Inverted index / Lucene: https://www.elastic.co/blog/found-elasticsearch-from-the-bottom-up
- PostgreSQL Docs — Full Text Search & GIN: https://www.postgresql.org/docs/current/textsearch.html
Phần sau ta xét cách Stack Overflow chia tải nhiều máy chủ bằng HAProxy — dựng thật với nhiều backend và xem health check tự loại máy chủ hỏng.
