Trong các kho kiểu LSM (Bigtable, Cassandra, ScyllaDB, RocksDB), dữ liệu nằm rải trong nhiều file SSTable trên đĩa. Để đọc một khoá, hệ phải hỏi từng SSTable "khoá này có ở đây không?". Nếu khoá không tồn tại, ta tốn I/O tra hết mà chẳng thấy gì — và đọc "miss" là chuyện rất thường xuyên. Google Bigtable giải bằng một cấu trúc tí hon: bloom filter. Bài này mổ xẻ nó và dựng thật bằng RedisBloom.
Bài toán: tra đĩa cho khoá không tồn tại là lãng phí lớn
Bloom filter trả lời một câu hỏi thành viên với hai đặc tính lệch nhau:
- Nói "KHÔNG có" → chắc chắn không có (không bao giờ âm giả).
- Nói "có thể có" → có thể có, cũng có thể nhầm (dương giả, tỉ lệ nhỏ điều chỉnh được).
Đúng loại câu trả lời ta cần để gác cửa trước khi chạm đĩa: nếu bloom nói "không", ta an toàn bỏ qua SSTable đó — khỏi đọc đĩa. Nếu nói "có thể", mới tra đĩa (thi thoảng tra thừa vì dương giả).
Cách giải: dựng thật bằng RedisBloom
RedisBloom (module bf của Redis) cho ta một bloom filter thật với vài lệnh:
redis-cli BF.RESERVE keys_bloom 0.01 1000000   # FP mục tiêu 1%, sức chứa 1 triệu
redis-cli BF.ADD keys_bloom "key:12345"        # đánh dấu khoá tồn tại
Mẫu dùng — bloom gác cửa trước khi chạm đĩa:
func doc(key):
    if BF.EXISTS keys_bloom key == 0:
        return KHONG_TON_TAI       # bloom nói KHÔNG -> chắc chắn không có, KHỎI tra đĩa
    return traDia(key)             # bloom nói CÓ THỂ -> mới tra đĩa (có thể dương giả)
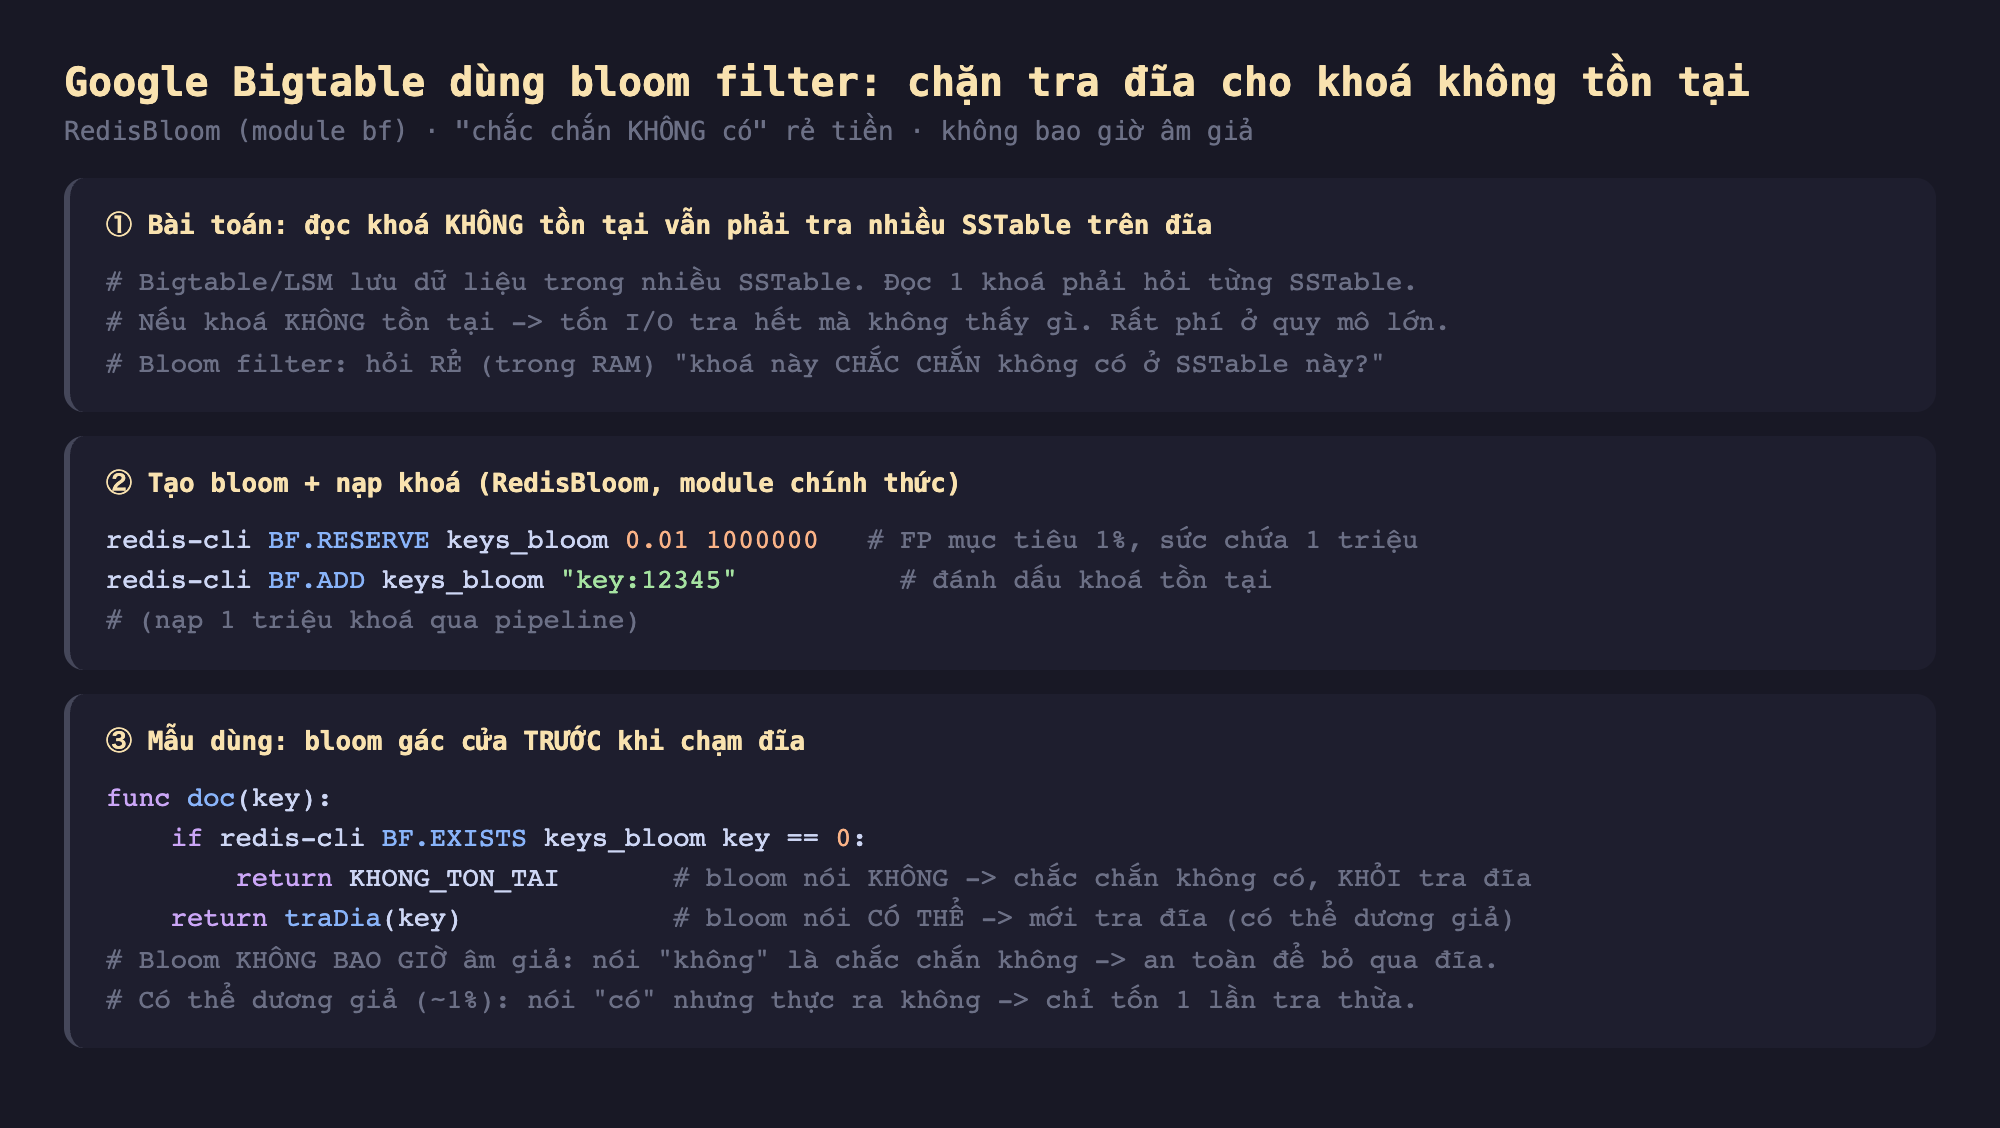
Hình 1: Bloom filter gác cửa trước khi chạm đĩa — BF.EXISTS nói "không" thì bỏ qua SSTable (khỏi đọc đĩa); nói "có thể" mới tra. Không bao giờ âm giả nên "không" là an toàn tuyệt đối.
Đo THẬT trên RedisBloom
Ta nạp 1 triệu khoá vào một bloom filter thật (FP mục tiêu 1%) và đo ba điều.
Dương giả — kiểm 100.000 khoá không tồn tại:
dương giả (khoá không có bị báo "có"): 501 / 100.000 = 0,501% (mục tiêu 1%)
~0,5% lần bloom nói nhầm "có thể có" → chỉ tốn một lần tra đĩa thừa, không sai kết quả (tra đĩa rồi thấy không có, trả về đúng). Không bao giờ âm giả — kiểm 10.000 khoá tồn tại:
khoá tồn tại nhận đúng: 10.000 / 10.000 (âm giả = 0)
Không một khoá tồn tại nào bị bỏ sót → bloom nói "KHÔNG" là chắc chắn không, nên an toàn để bỏ qua tra đĩa. Bộ nhớ — bloom vs một SET chứa cùng 1 triệu khoá (MEMORY USAGE thật):
bloom filter    : 1.378.616 byte  (~1,3 MB)
SET 1 triệu khoá: 56.388.728 byte  (~54 MB)
>> Bloom nhỏ hơn ~41× — đủ nhỏ để giữ trong RAM cho MỌI SSTable
Đây là điểm cốt lõi: bloom nhỏ đến mức có thể giữ một cái cho mỗi SSTable ngay trong RAM. Một lần tra RAM (rẻ) thay cho một lần tra đĩa (đắt) cho phần lớn các đọc "miss".
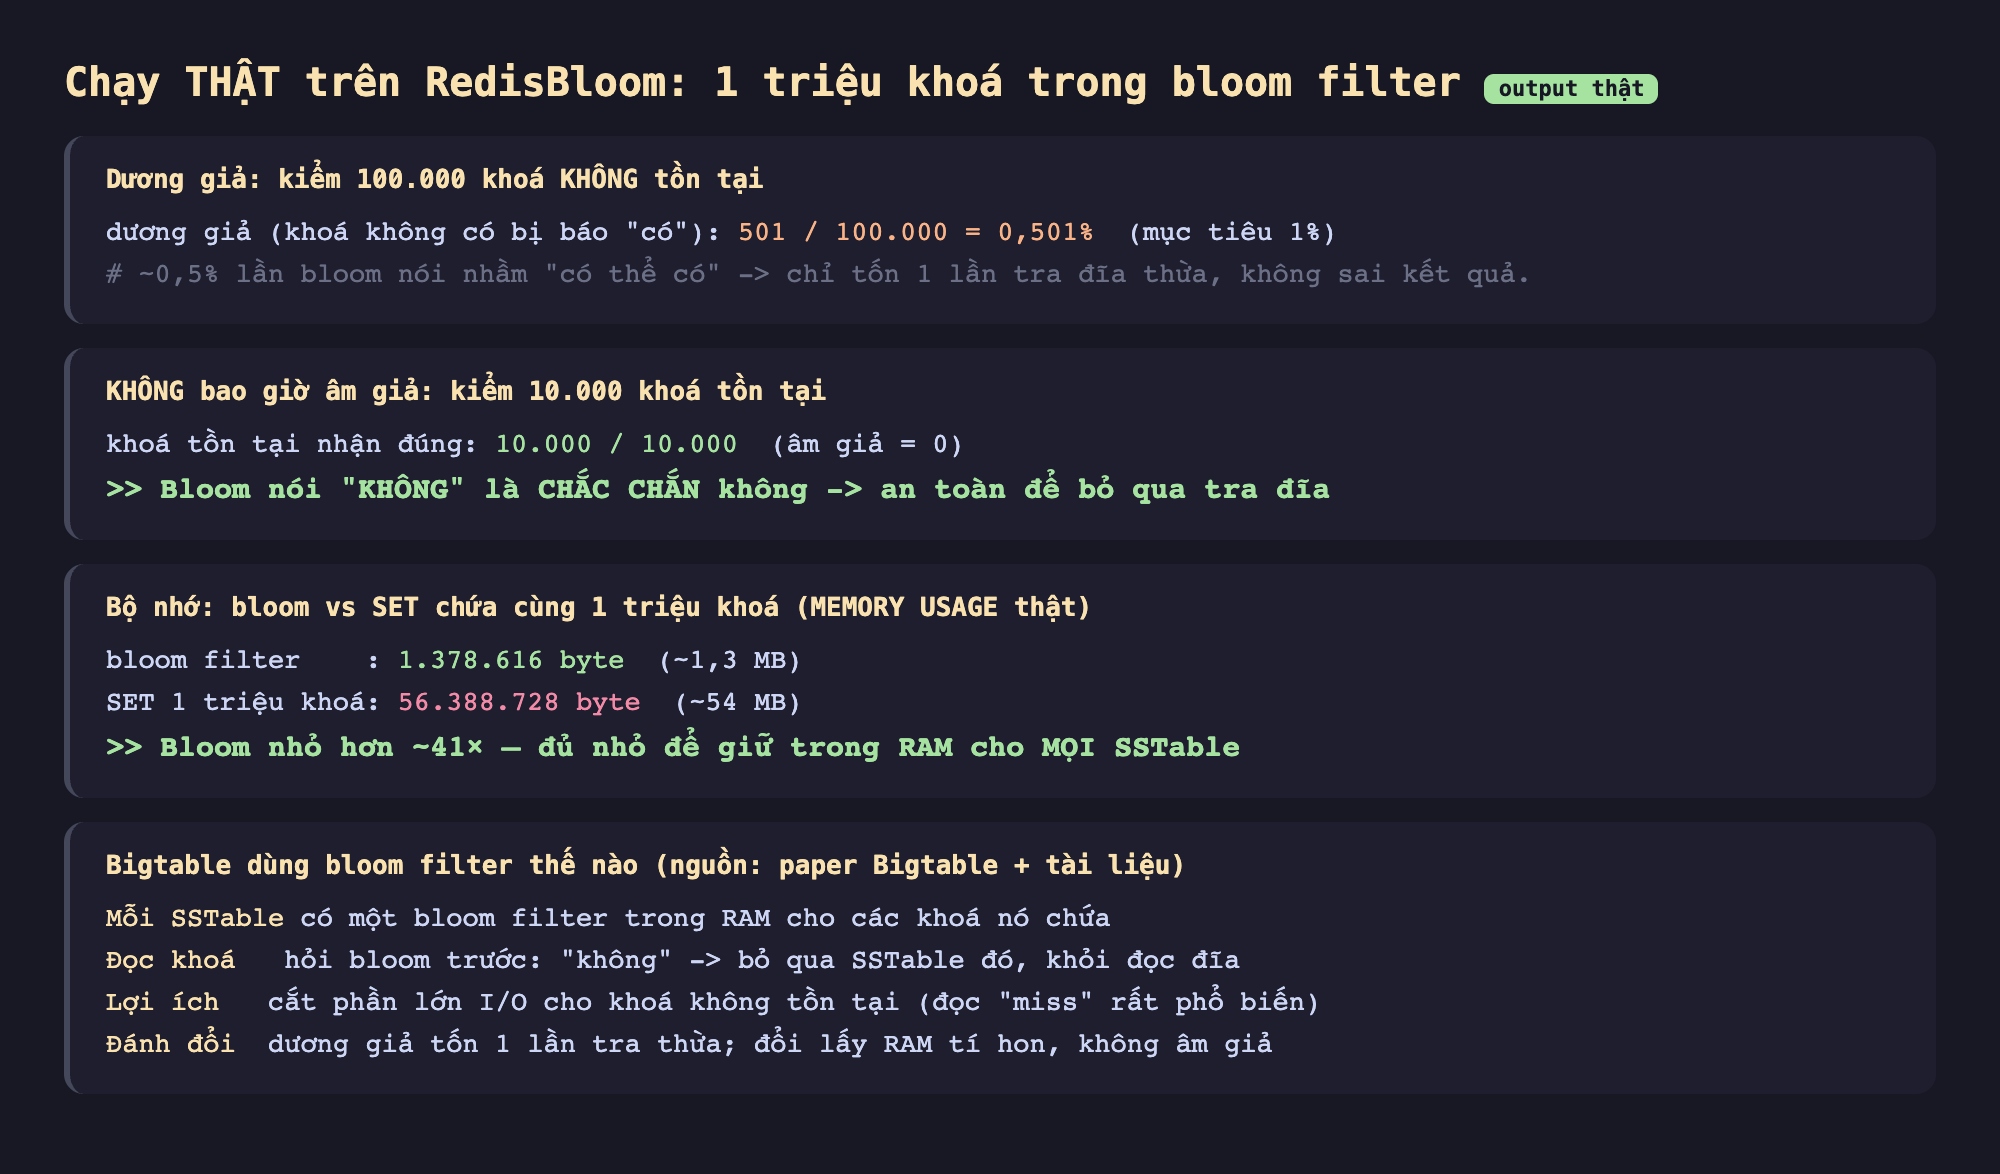
Hình 2: Chạy thật trên RedisBloom — dương giả 0,501% (dưới mục tiêu 1%), 0 âm giả, và bloom (1,38MB) nhỏ hơn SET (54MB) ~41×. Kèm cách Bigtable đặt bloom cho mỗi SSTable.
Bigtable dùng nó thế nào (và vì sao đánh đổi này đáng)
Theo paper Bigtable, mỗi SSTable có một bloom filter cho tập khoá nó chứa, giữ trong bộ nhớ. Khi đọc một khoá, Bigtable hỏi bloom trước; nếu "không", bỏ qua SSTable đó mà không đọc đĩa. Vì đọc "miss" (khoá không tồn tại, hoặc không ở SSTable này) cực phổ biến trong LSM (dữ liệu rải nhiều tầng), bloom cắt được phần lớn I/O vô ích. Đánh đổi cực có lợi: một cấu trúc ~1MB đổi lấy việc tránh hàng loạt lần đọc đĩa hàng mili-giây.
Đánh đổi cần cân nhắc
Tỉ lệ dương giả đổi lấy bộ nhớ. FP thấp hơn (0,1% thay vì 1%) cần nhiều bit hơn mỗi phần tử → bloom to hơn. Đây là đường cong đánh đổi: chọn FP theo mức "tra thừa" chấp nhận được. RedisBloom cho đặt FP mục tiêu lúc BF.RESERVE.
Bloom cơ bản không xoá được phần tử. Bloom filter chuẩn chỉ thêm và hỏi, không xoá (xoá một bit có thể phá phần tử khác). Với dữ liệu đổi thường xuyên, cần biến thể (counting bloom, hoặc dựng lại filter khi SSTable được nén lại — đúng cách LSM làm khi compaction).
Phải ước lượng sức chứa trước. Bloom nhồi quá số phần tử dự kiến thì FP tăng vọt. BF.RESERVE cần ước lượng số phần tử; RedisBloom có scaling bloom (tự nới) nhưng đánh đổi bộ nhớ/tốc độ. Ước lượng sai sức chứa là lỗi thường gặp.
Ba ý mang về
- Đọc khoá không tồn tại là lãng phí I/O lớn trong LSM-store, và bloom filter gác cửa rẻ tiền: nói "KHÔNG" là chắc chắn không (đo thật 0 âm giả trên 10.000 khoá) → an toàn bỏ qua tra đĩa.
- Bloom đổi một tỉ lệ dương giả nhỏ lấy bộ nhớ tí hon: đo thật dương giả 0,5% (chỉ tốn 1 lần tra thừa, không sai kết quả) và nhỏ hơn một SET tương đương ~41× (1,3MB vs 54MB) — đủ nhỏ để giữ một bloom cho mỗi SSTable trong RAM.
- Bigtable đặt bloom cho mỗi SSTable để cắt phần lớn I/O cho đọc miss — một cấu trúc ~1MB tránh hàng loạt đọc đĩa; nhưng phải chọn FP hợp lý, ước lượng sức chứa đúng, và dựng lại filter khi dữ liệu đổi (compaction).
Nguồn
- Chang et al. — Bigtable: A Distributed Storage System for Structured Data (Google, OSDI 2006): https://research.google/pubs/pub27898/
- RedisBloom Docs — Bloom filter (BF.RESERVE/BF.ADD/BF.EXISTS): https://redis.io/docs/latest/develop/data-types/probabilistic/bloom-filter/
Phần sau ta xét cách tìm kiếm toàn văn như Elasticsearch đánh bại LIKE bằng inverted index — dựng thật trong PostgreSQL và đo bằng EXPLAIN ANALYZE.
