Khi dữ liệu được chia ra hàng nghìn shard, một câu hỏi tưởng tầm thường trở nên khó: cấp ID duy nhất cho mỗi bản ghi thế nào? Dùng auto-increment của một DB trung tâm thì DB đó thành nút thắt (mọi ghi phải qua nó); dùng UUID ngẫu nhiên thì mất tính sắp-thời-gian và tốn chỗ. Instagram giải bằng một ID 64 bit gói ba thông tin, sinh ngay trong mỗi Postgres shard. Bài này mổ xẻ scheme đó và dựng thật trong PostgreSQL.
Bài toán: ID duy nhất, sắp thời gian, không điểm trung tâm
Ba yêu cầu mâu thuẫn nhau:
- Duy nhất toàn cục — dù sinh song song trên nhiều shard, không được trùng.
- Sắp theo thời gian — để "lấy bài mới nhất" chỉ cần
ORDER BY id, và index không bị phân mảnh ngẫu nhiên. - Không điểm sinh trung tâm — không có service/DB nào là nút thắt cho mọi lần tạo bản ghi.
Cách giải: gói 3 thông tin vào 64 bit
Instagram (blog kỹ thuật của họ) chia 64 bit thành:
| 41 bit timestamp (ms) | 13 bit shard id | 10 bit sequence |
  41 bit ms -> ~69 năm    13 bit -> 8192 shard   10 bit -> 1024 ID/shard/MỖI ms
Vì ID bắt đầu bằng timestamp, so sánh ID chính là so sánh thời gian → ORDER BY id = ORDER BY created_at. 13 bit shard nằm giữa nên từ một ID bất kỳ, bóc ra được shard chứa dữ liệu. 10 bit sequence là bộ đếm cục bộ mỗi shard, cho 1024 ID mỗi mili-giây mỗi shard mà không đụng shard khác.
Instagram sinh ID ngay trong Postgres bằng PL/pgSQL, không cần service ID riêng:
CREATE FUNCTION insta.next_id(shard_id int) RETURNS bigint AS $$
DECLARE
    our_epoch bigint := 1704067200000;   -- epoch tuỳ chỉnh (2024-01-01)
    seq_id bigint; now_millis bigint; result bigint;
BEGIN
    SELECT nextval('insta.id_seq') % 1024 INTO seq_id;                     -- 10 bit
    SELECT floor(extract(epoch FROM clock_timestamp())*1000) INTO now_millis;
    result := (now_millis - our_epoch) << 23;   -- 41 bit timestamp, dịch trái 23
    result := result | (shard_id << 10);        -- 13 bit shard, dịch trái 10
    result := result | seq_id;                  -- 10 bit sequence
    RETURN result;
END; $$ LANGUAGE plpgsql;
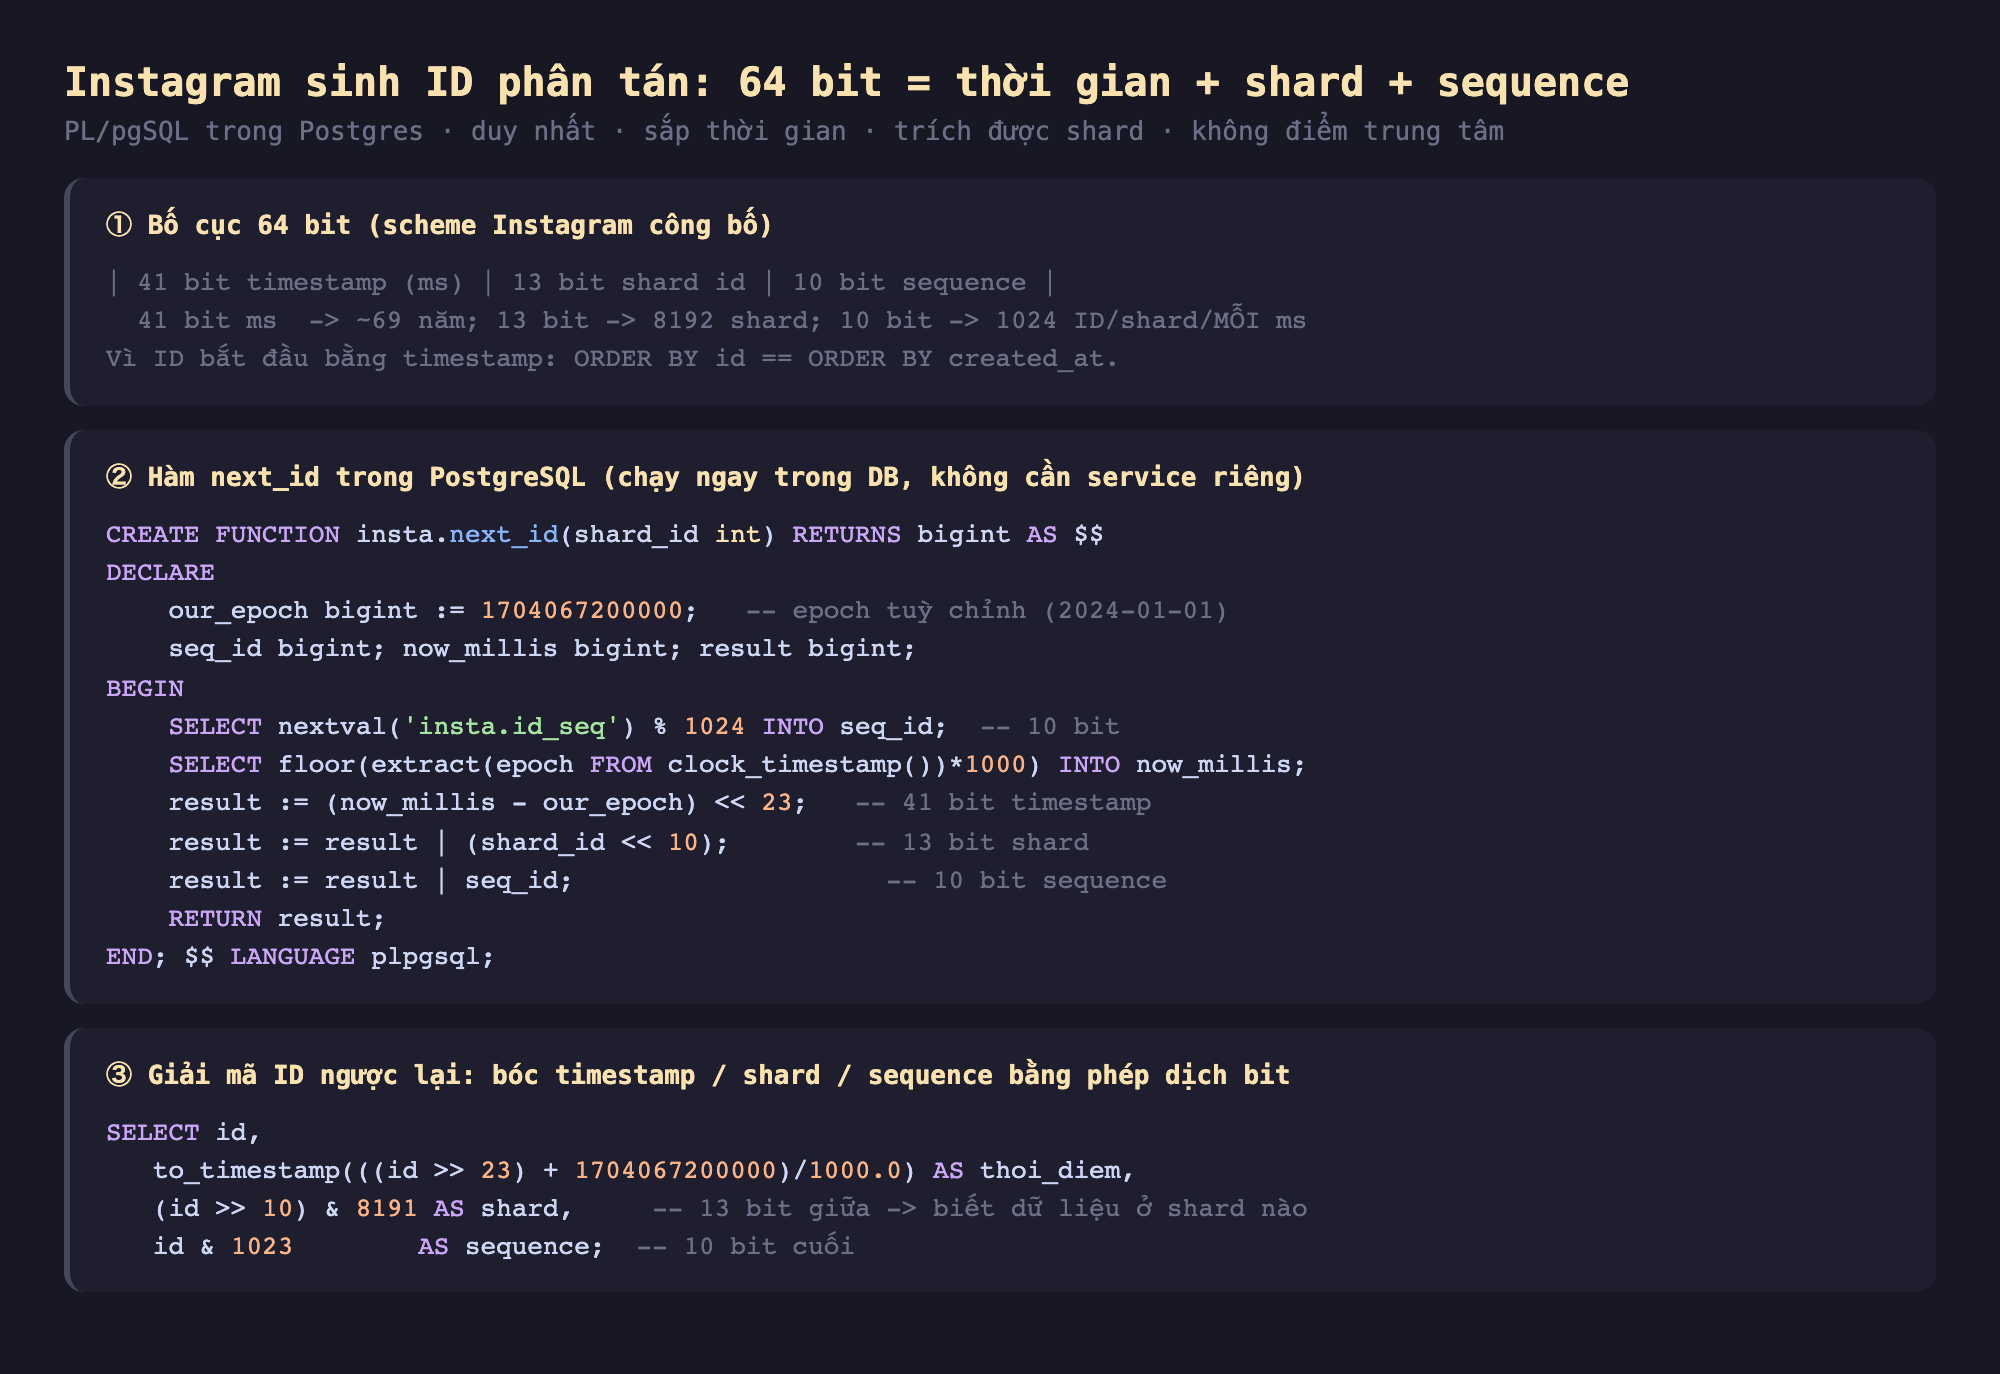
Hình 1: Bố cục 64 bit của Instagram (41 timestamp + 13 shard + 10 sequence), hàm next_id PL/pgSQL sinh ID ngay trong Postgres, và cách giải mã ID ngược lại bằng phép dịch bit.
Đo THẬT trong PostgreSQL
Ta cài đúng hàm trên vào một Postgres 16 thật và chạy.
ID tăng dần theo thời gian (5 ID liên tiếp trên shard 5):
727049252785624065
727049252785624066
727049252785624067
727049252785624068
727049252785624069
Giải mã một ID ngược lại — bóc đúng 3 phần:
id                 | thoi_diem                  | shard | sequence
727049253087651846 | 2026-09-30 03:17:04.929+00 |  42   |    6
Chỉ từ con số ID, biết chính xác: sinh lúc nào, ở shard nào, thứ tự thứ mấy. Duy nhất và định tuyến — sinh 50.000 ID trên nhiều shard, tất cả không trùng, và trích được shard từ bất kỳ ID nào:
Sinh 50.000 ID: tổng=50000  duy_nhất=50000   (không trùng)
Trích shard (id >> 10) & 8191:
  727049441420255063 -> shard 7
  727049441420338008 -> shard 88
  727049441421511513 -> shard 1234
Cầm một ID là biết ngay hỏi shard nào — không cần một bảng tra trung tâm (ID → shard). Đó là điểm tinh tế: sharding cần biết "dữ liệu ở đâu", và Instagram nhét thông tin đó vào chính khoá chính.
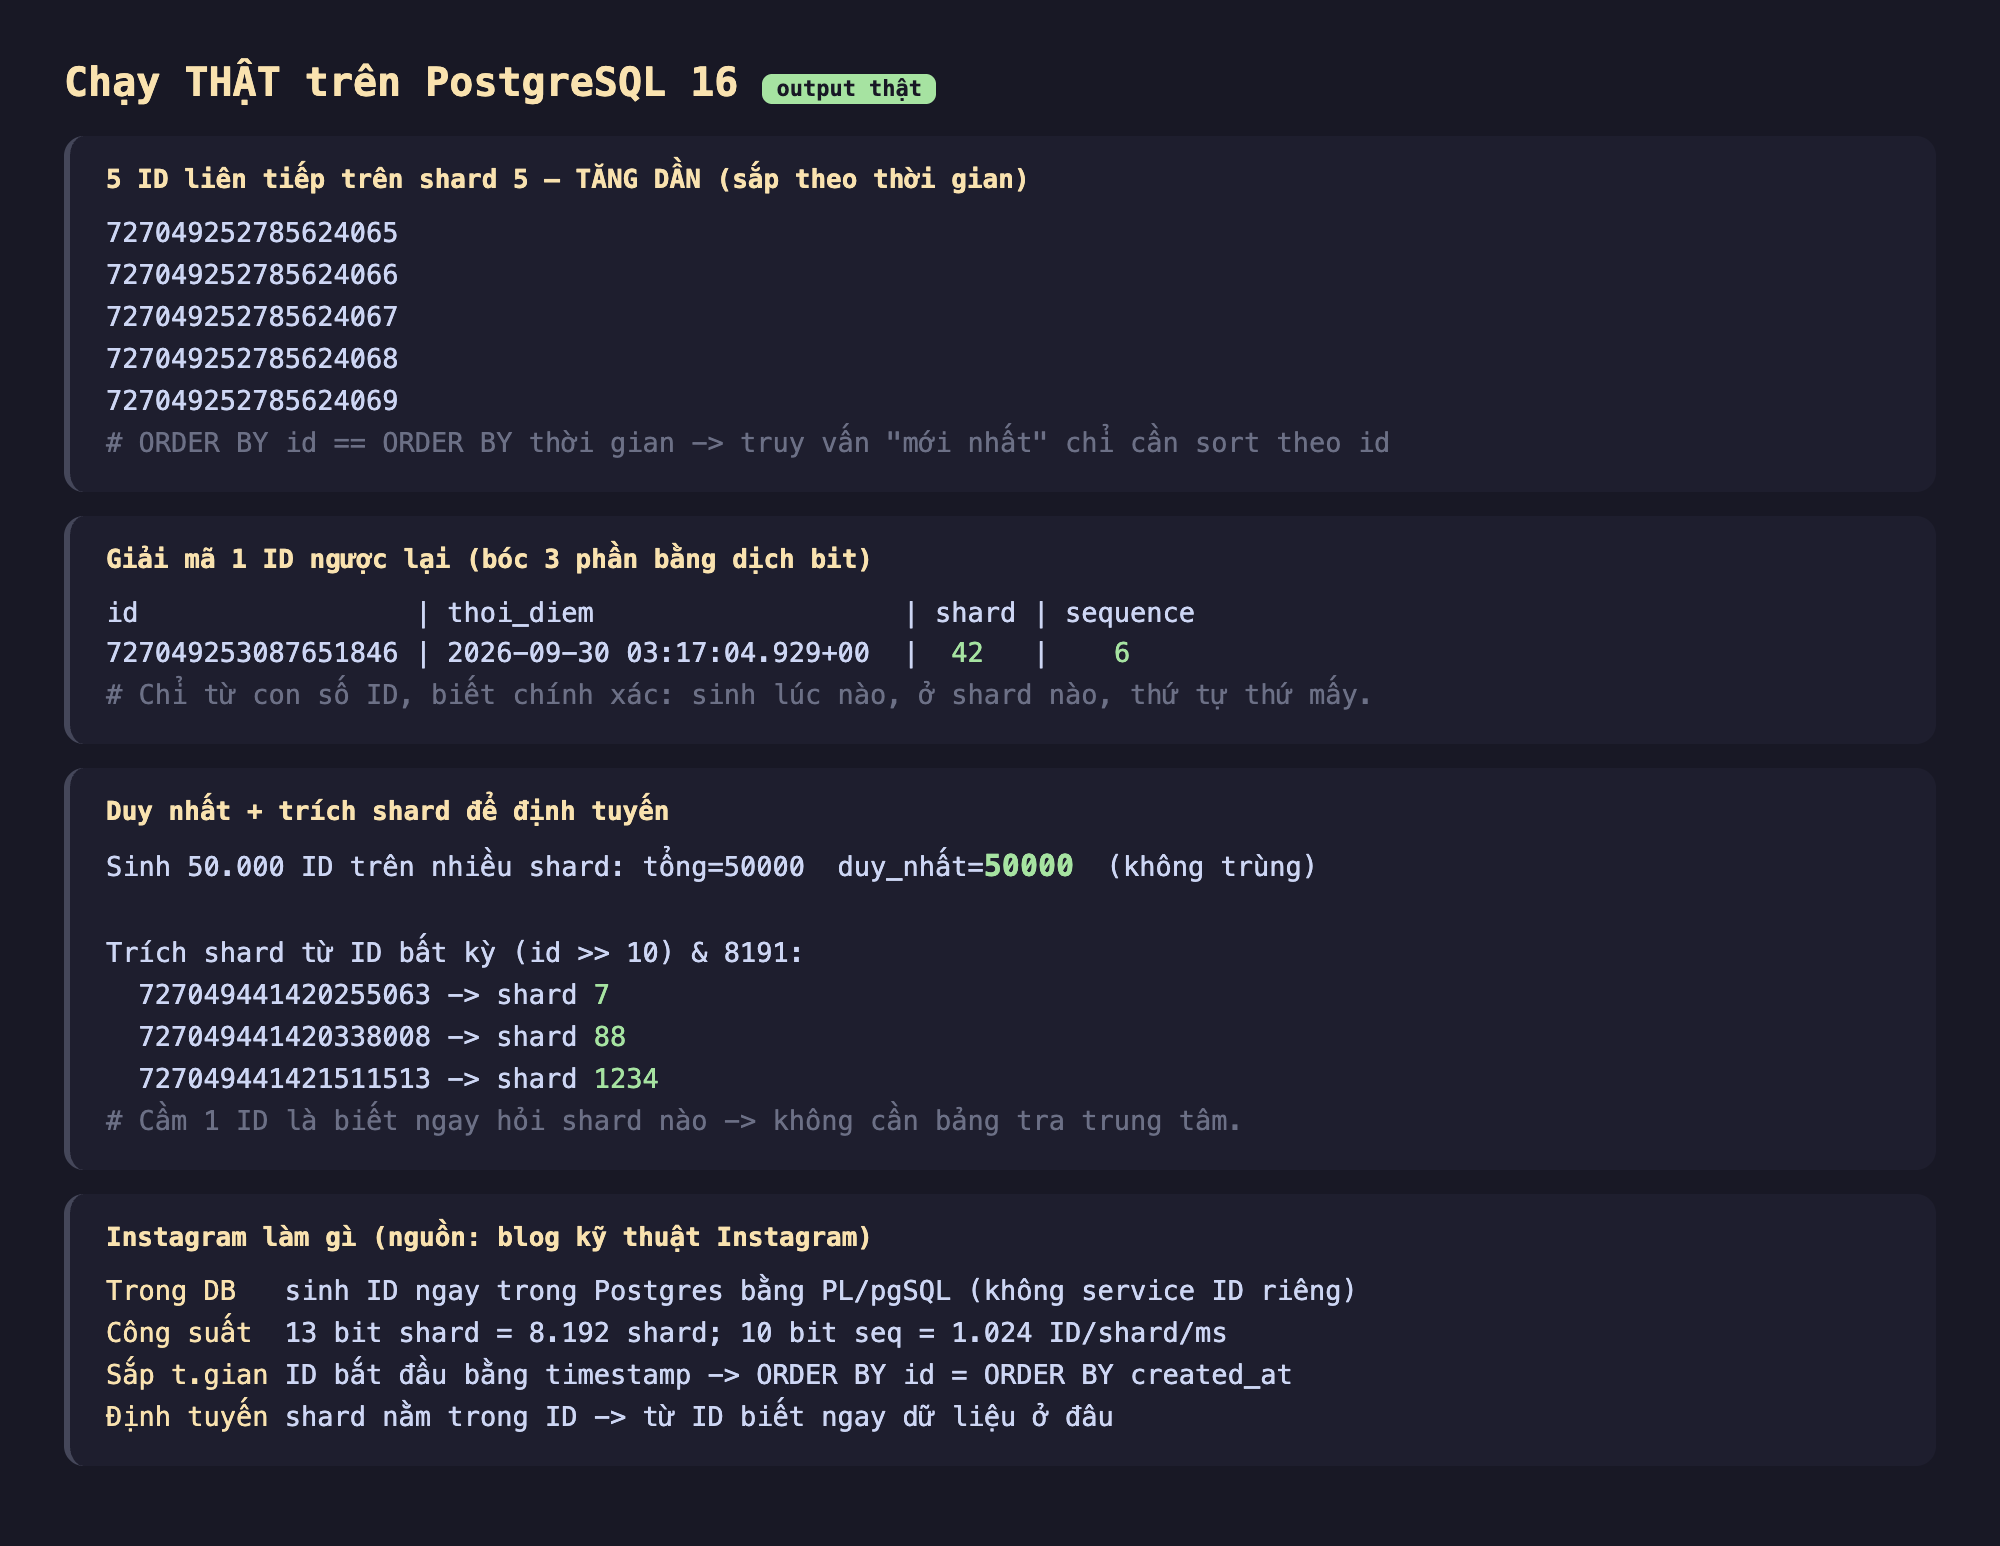
Hình 2: Chạy thật trên PostgreSQL 16 — ID tăng theo thời gian, giải mã ra (thời điểm, shard 42, seq 6), 50.000 ID không trùng, trích shard từ ID bất kỳ. Kèm cách Instagram làm.
Đánh đổi cần cân nhắc
Phụ thuộc đồng hồ. Vì 41 bit đầu là thời gian, đồng hồ chạy lùi (NTP điều chỉnh) có thể sinh ID nhỏ hơn ID trước — phá tính đơn điệu. Instagram sinh trong DB nên dùng đồng hồ của DB; hệ phân tán kiểu Snowflake phải xử lý clock skew (chờ, hoặc từ chối). Đây là cái giá của "nhét timestamp vào ID".
Giới hạn cứng của số bit. 10 bit sequence = tối đa 1024 ID/shard/ms; vượt là phải chờ ms sau (hoặc tràn seq). 13 bit shard = tối đa 8192 shard. Các giới hạn này đủ cho Instagram nhưng là cố định — chọn cách chia bit là cam kết dài hạn, đổi về sau rất đau.
ID lộ thông tin. Vì giải mã được thời điểm và shard, ID không nên dùng làm định danh công khai nếu bạn không muốn lộ "tạo lúc nào", "hệ có bao nhiêu shard", hay tốc độ tạo bản ghi (đếm sequence). Nhiều hệ dùng ID nội bộ kiểu này nhưng phơi ra ngoài một mã khác.
Ba ý mang về
- Sharding cần ID duy nhất mà không có điểm sinh trung tâm: Instagram gói 41 bit timestamp + 13 bit shard + 10 bit sequence vào 64 bit, sinh ngay trong Postgres bằng PL/pgSQL — đo thật 50.000 ID không trùng dù sinh trên nhiều shard.
- Nhét timestamp vào đầu ID cho sắp-thời-gian miễn phí:
ORDER BY id=ORDER BY created_at— đo thật ID tăng dần theo thời gian; "lấy mới nhất" không cần cột thời gian riêng. - Nhét shard vào ID cho định tuyến không cần bảng tra: từ bất kỳ ID nào bóc ra shard (đo thật shard 7/88/1234) — nhưng đổi lại phụ thuộc đồng hồ, giới hạn bit cố định, và ID lộ thông tin.
Nguồn
- Instagram Engineering — Sharding & IDs at Instagram: https://instagram-engineering.com/sharding-ids-at-instagram-1cf5a71e5a5c
- Wikipedia — Snowflake ID (họ ID cùng nguyên lý): https://en.wikipedia.org/wiki/Snowflake_ID
Phần sau ta xét một cấu trúc tí hon cứu vô số lượt tra đĩa: bloom filter trong Google Bigtable — dựng thật bằng RedisBloom và đo tỉ lệ dương giả cùng bộ nhớ.
