Hai sự thật va nhau ở mọi hệ thống lớn: một máy chủ không chịu nổi tải (nên phải nhiều máy), và máy chủ thì có lúc chết (nên không được phụ thuộc một cái nào). Lớp giải cả hai là load balancer. Bài này mổ xẻ cách một bộ cân bằng tải như HAProxy (Stack Overflow nổi tiếng chạy trên HAProxy) chia tải và tự loại máy chủ hỏng, rồi dựng thật HAProxy với nhiều backend để xem failover xảy ra trực tiếp.
Bài toán: chia tải, và đừng gửi request vào máy đã chết
Load balancer đứng trước nhiều backend, nhận mọi request và phân phối. Nó phải làm hai việc:
- Chia tải theo một thuật toán (đều, hoặc theo tải hiện tại).
- Health check: liên tục kiểm mỗi backend còn sống không; nếu chết thì ngừng gửi request vào đó — mà người dùng không thấy lỗi.
Cách giải: HAProxy round-robin + health check
Cấu hình HAProxy khai backend và cách kiểm sức khoẻ:
frontend fe
  bind :80
  default_backend be
backend be
  balance roundrobin              # chia đều lần lượt; hoặc leastconn, source...
  option httpchk GET /            # health check: GET / định kỳ
  server b1 be1:5678 check inter 500 fall 2 rise 1
  server b2 be2:5678 check inter 500 fall 2 rise 1
  server b3 be3:5678 check inter 500 fall 2 rise 1
check inter 500 = kiểm mỗi 500ms; fall 2 = hỏng 2 lần liên tiếp thì đánh DOWN; rise 1 = khoẻ lại 1 lần thì đưa vào lại pool. HAProxy tự làm toàn bộ, không cần can thiệp tay.
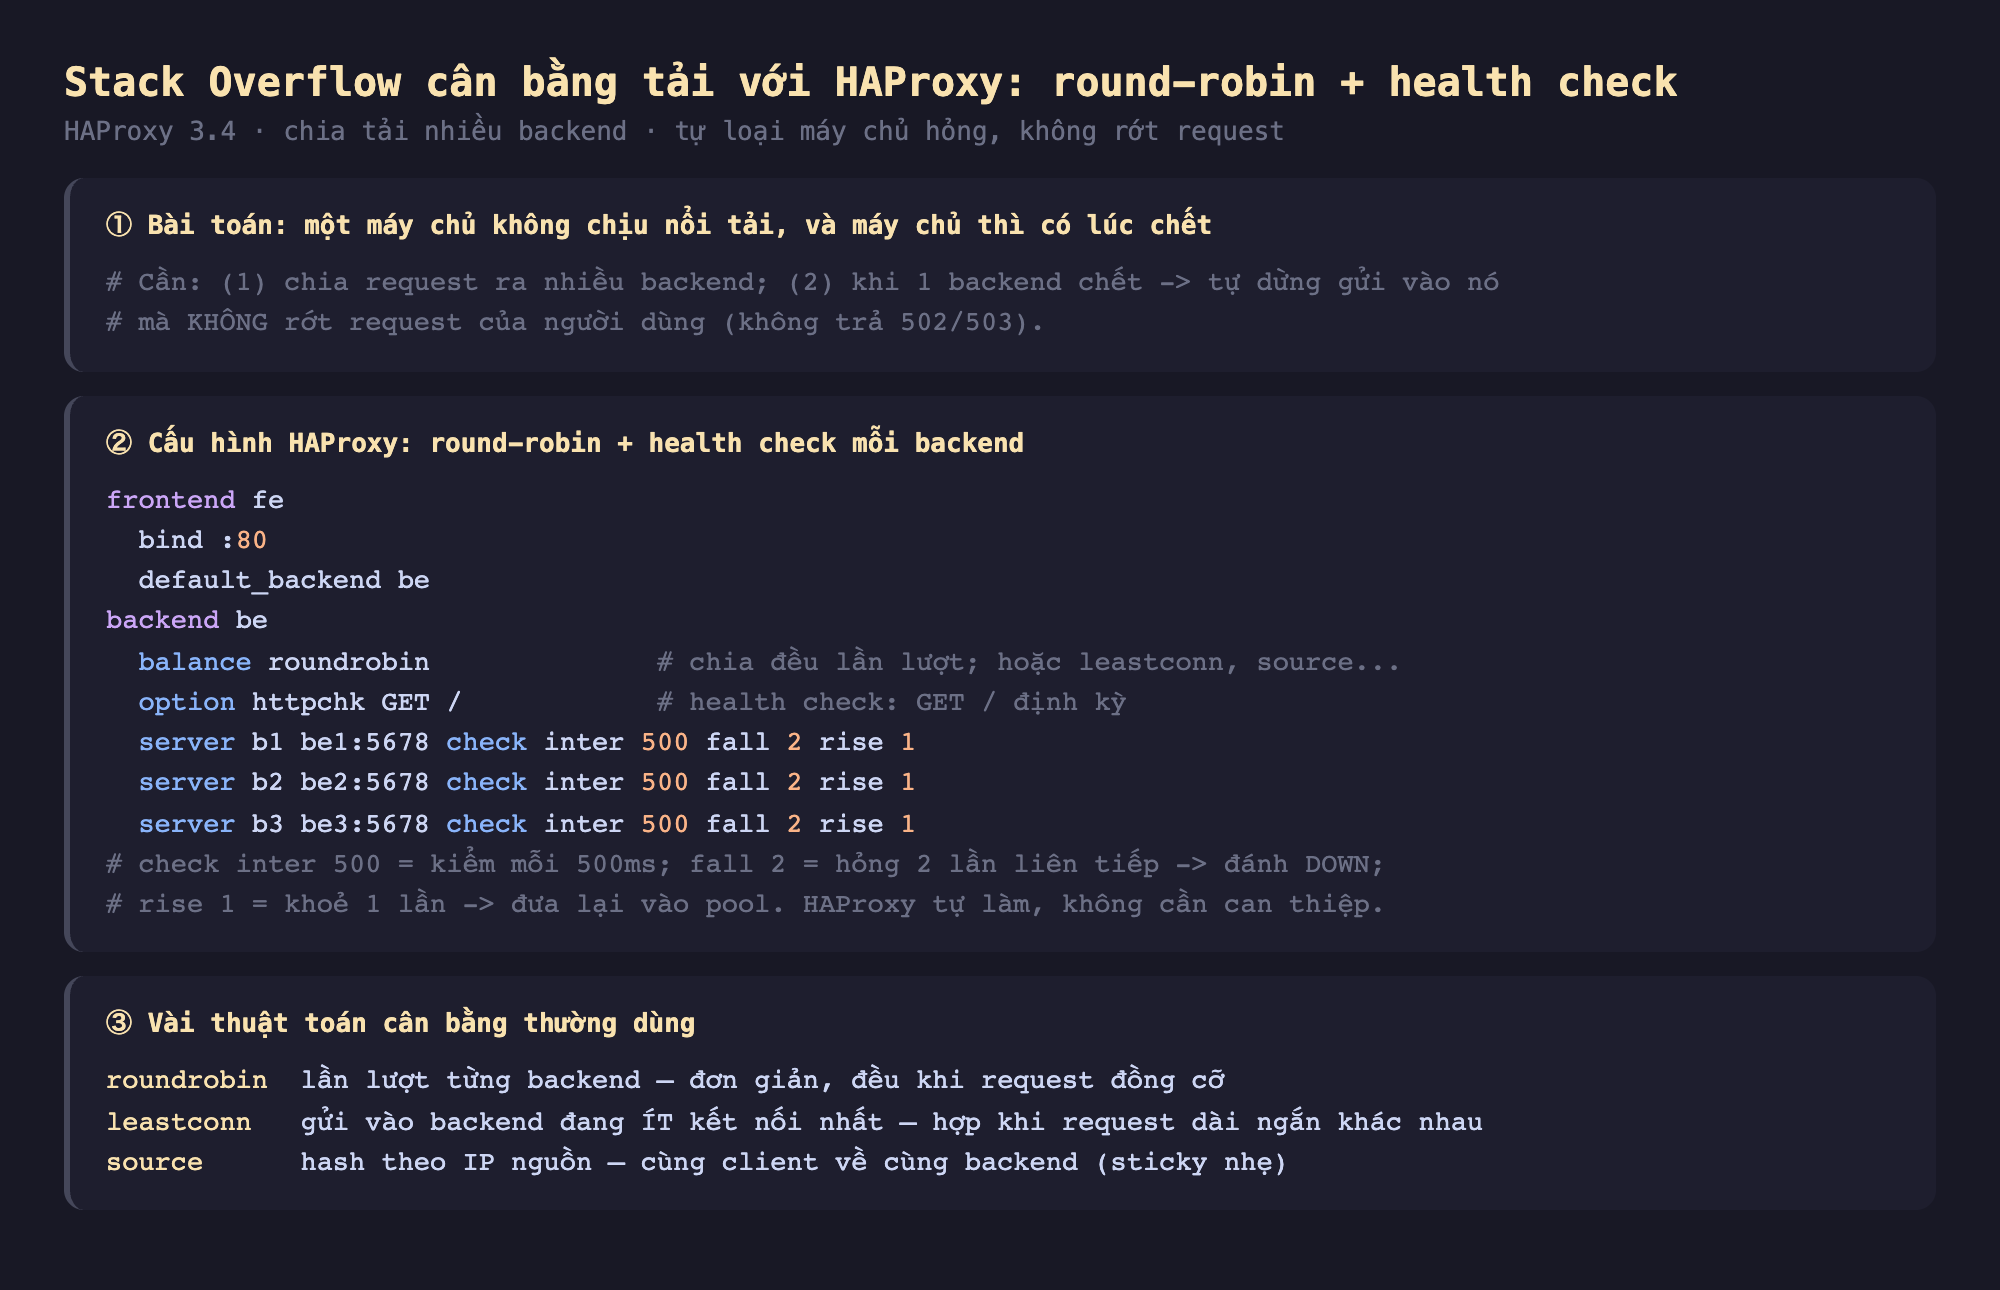
Hình 1: Cấu hình HAProxy — balance roundrobin chia tải, option httpchk + check inter/fall/rise cho health check tự động; và vài thuật toán cân bằng (roundrobin, leastconn, source).
Đo THẬT: round-robin và failover
Ta dựng thật HAProxy 3.4 trước 3 backend (mỗi backend trả tên mình), rồi bắn request qua HAProxy.
Round-robin — 12 request chia đều:
4  backend-1
4  backend-2
4  backend-3
Chia đều tuyệt đối, mỗi backend nhận 1/3. Giết backend-2 (giả lập máy chủ chết) rồi bắn tiếp:
docker stop htl-be2   # máy chủ chết
12 request sau đó:
   6  backend-1
   6  backend-3
HAProxy tự dồn sang 2 backend còn sống, không trả lỗi 5xx — health check (fall 2, inter 500ms) phát hiện DOWN trong ~1 giây và ngừng gửi vào backend-2. Bật lại backend-2:
docker start htl-be2
12 request:
   4  backend-1
   4  backend-2   (đã quay lại)
   4  backend-3
rise 1: khoẻ lại 1 lần là HAProxy đưa backend-2 vào lại pool — hoàn toàn tự động. Đây là bằng chứng trực tiếp về điều làm nên tính sẵn sàng: máy chủ có thể chết và hồi, người dùng không hề hay biết.
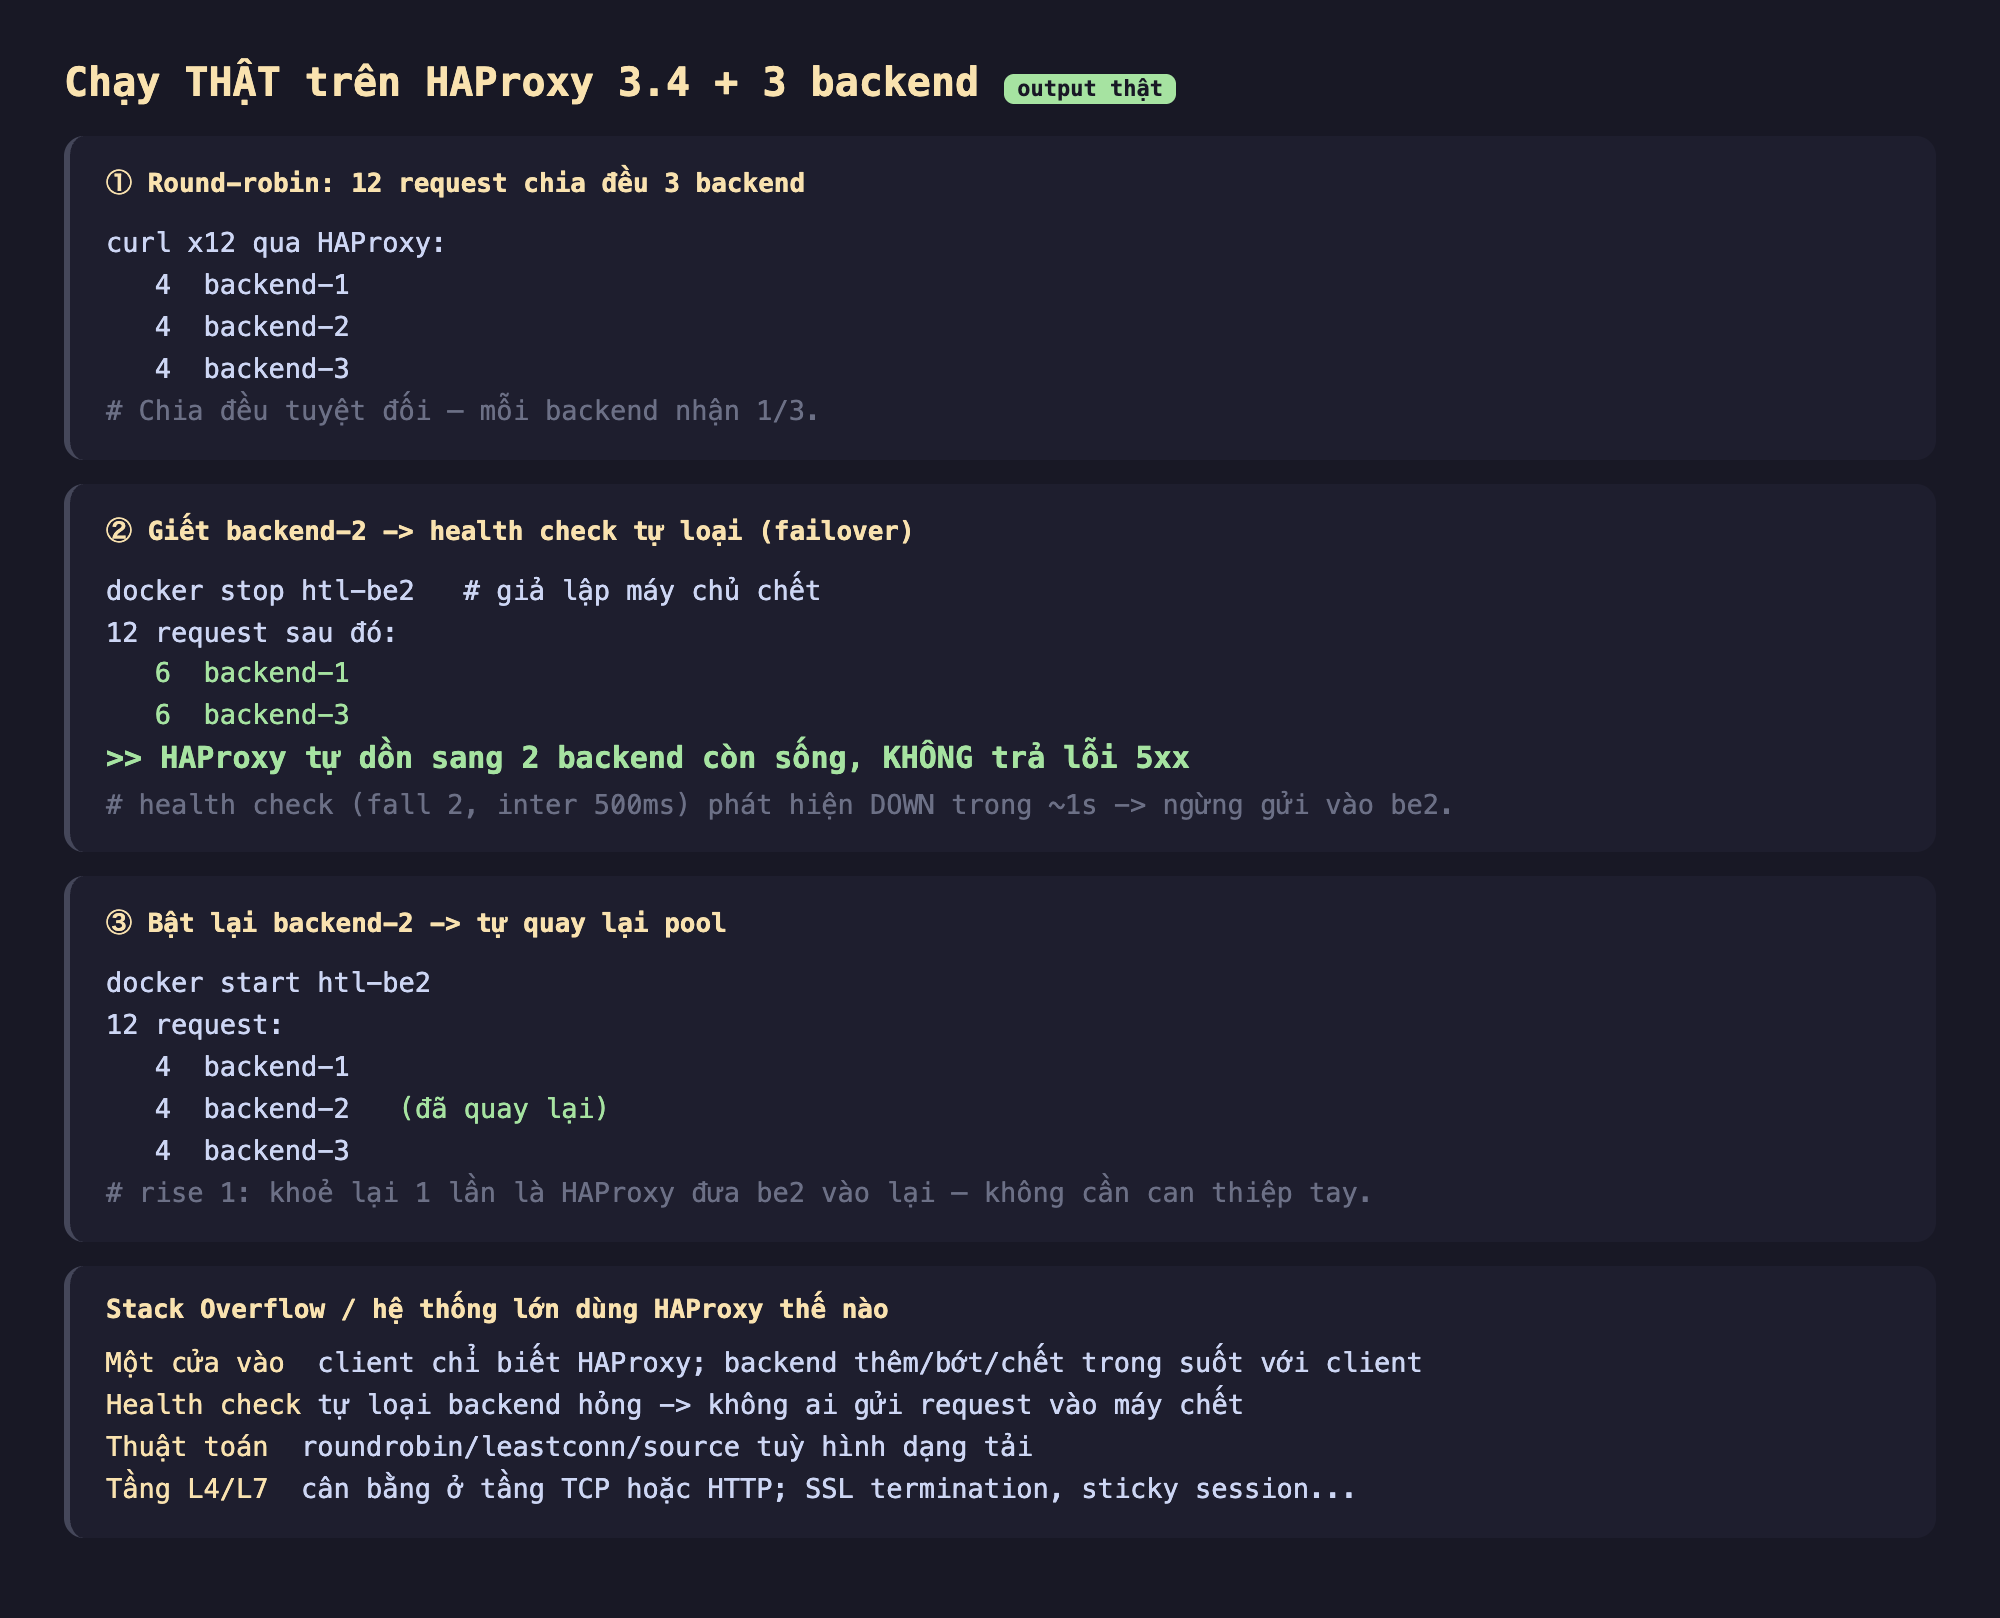
Hình 2: Chạy thật trên HAProxy — round-robin chia 4/4/4; giết backend-2 thì health check tự dồn 6/6 (không 5xx); bật lại thì backend-2 tự quay vào pool 4/4/4. Kèm cách hệ thống lớn dùng HAProxy.
Vì sao đây là mảnh không thể thiếu ở quy mô lớn
- Một cửa vào duy nhất. Client chỉ biết địa chỉ HAProxy; backend được thêm/bớt/chết trong suốt với client. Muốn scale thì thêm backend rồi khai vào HAProxy — không client nào phải đổi gì.
- Health check tách "chết" khỏi "người dùng thấy lỗi". Không có nó, một backend chết nghĩa là 1/N request trả lỗi cho tới khi ai đó can thiệp. Có nó, lỗi được cô lập trong ~1 giây, tự động.
- Nhiều tầng, nhiều thuật toán. Cân bằng ở tầng TCP (L4) hay HTTP (L7);
leastconncho request dài-ngắn khác nhau;sourcecho sticky session; SSL termination; giới hạn tốc độ. HAProxy là một điểm điều phối giàu tính năng.
Đánh đổi cần cân nhắc
Load balancer là một điểm phụ thuộc — phải nhân đôi nó. Nếu chỉ có một HAProxy, nó thành single point of failure. Thực tế chạy ≥2 HAProxy với một IP nổi (keepalived/VRRP) hoặc DNS/anycast phía trước. Cân bằng tải giải tính sẵn sàng của backend, nhưng tự nó cũng cần được làm sẵn sàng.
Health check nông có thể đánh lừa. GET / chỉ biết tiến trình còn sống, không biết nó có phục vụ đúng không (DB phía sau chết, đĩa đầy...). Health check tốt nên kiểm một endpoint phản ánh sức khoẻ thật (như bài REST API capstone của sê-ri Go). Health check sai làm HAProxy giữ backend hỏng hoặc loại backend khoẻ.
Round-robin không phải luôn tối ưu. Nó giả định request đồng cỡ. Nếu request dài ngắn rất khác nhau, leastconn (gửi vào máy ít kết nối nhất) cân tải tốt hơn. Chọn thuật toán theo hình dạng tải thật, đo trước khi chọn.
Ba ý mang về
- Load balancer chia tải nhiều backend sau một cửa vào duy nhất: đo thật HAProxy round-robin chia 12 request thành 4/4/4 — thêm/bớt backend trong suốt với client.
- Health check biến "máy chủ chết" thành chuyện vô hình với người dùng: đo thật giết một backend thì HAProxy tự dồn sang 2 máy còn sống (6/6, không lỗi 5xx) trong ~1s, và tự đưa lại vào pool khi hồi — hoàn toàn tự động.
- Bản thân LB phải được làm sẵn sàng và health check phải sâu: chạy ≥2 HAProxy (tránh single point of failure), kiểm endpoint phản ánh sức khoẻ thật, và chọn thuật toán (roundrobin/leastconn/source) theo hình dạng tải.
Nguồn
- HAProxy Documentation — Health checking / balance: https://docs.haproxy.org/
- Stack Overflow Architecture (dùng HAProxy): https://nickcraver.com/blog/2016/02/17/stack-overflow-the-architecture-2016-edition/
Phần sau ta xét một nút thắt âm thầm: vì sao hàng nghìn kết nối tới PostgreSQL làm sập database, và PgBouncer gộp kết nối cứu thế nào — dựng thật và đo.
