Bài trước ta thấy for range giờ chạy được trên hàm func(yield func(T) bool). Nhưng nếu mỗi thư viện tự đặt tên chữ ký đó theo kiểu riêng, hệ sinh thái sẽ vỡ vụn — hàm của thư viện A không cắm được vào thư viện B. Go 1.23 giải chuyện này bằng package iter với hai định danh chuẩn: iter.Seq và iter.Seq2. Cả slices, maps, và mọi thư viện iterator đều nói chung một "ngôn ngữ" này. Bài này mổ xẻ hai kiểu đó, cách chúng liên thông với thư viện chuẩn, và một hàm ẩn nhiều chi phí nhất: iter.Pull.
Hai kiểu, một hợp đồng chung
Package iter định nghĩa đúng hai kiểu, mỏng đến mức chỉ là bí danh cho chữ ký hàm:
type Seq[V any]     = func(yield func(V) bool)      // một giá trị mỗi bước
type Seq2[K, V any] = func(yield func(K, V) bool)   // cặp K, V mỗi bước
Seq[V] sinh một giá trị mỗi vòng (như slices.Values trả từng phần tử). Seq2[K, V] sinh hai (như duyệt map trả key + value, hay duyệt slice trả chỉ số + phần tử). Đây không phải kiểu magic — chúng chỉ đặt tên cho cái chữ ký ta viết tay ở bài trước, để cả hệ sinh thái tham chiếu cùng một thứ.
func DemNguoc(n int) iter.Seq[int] {
	return func(yield func(int) bool) {
		for i := n - 1; i >= 0; i-- {
			if !yield(i) { return }
		}
	}
}

for v := range DemNguoc(5) { ... }       // 4 3 2 1 0
for i, v := range DanhSo(xs) { ... }     // Seq2: chỉ số + giá trị
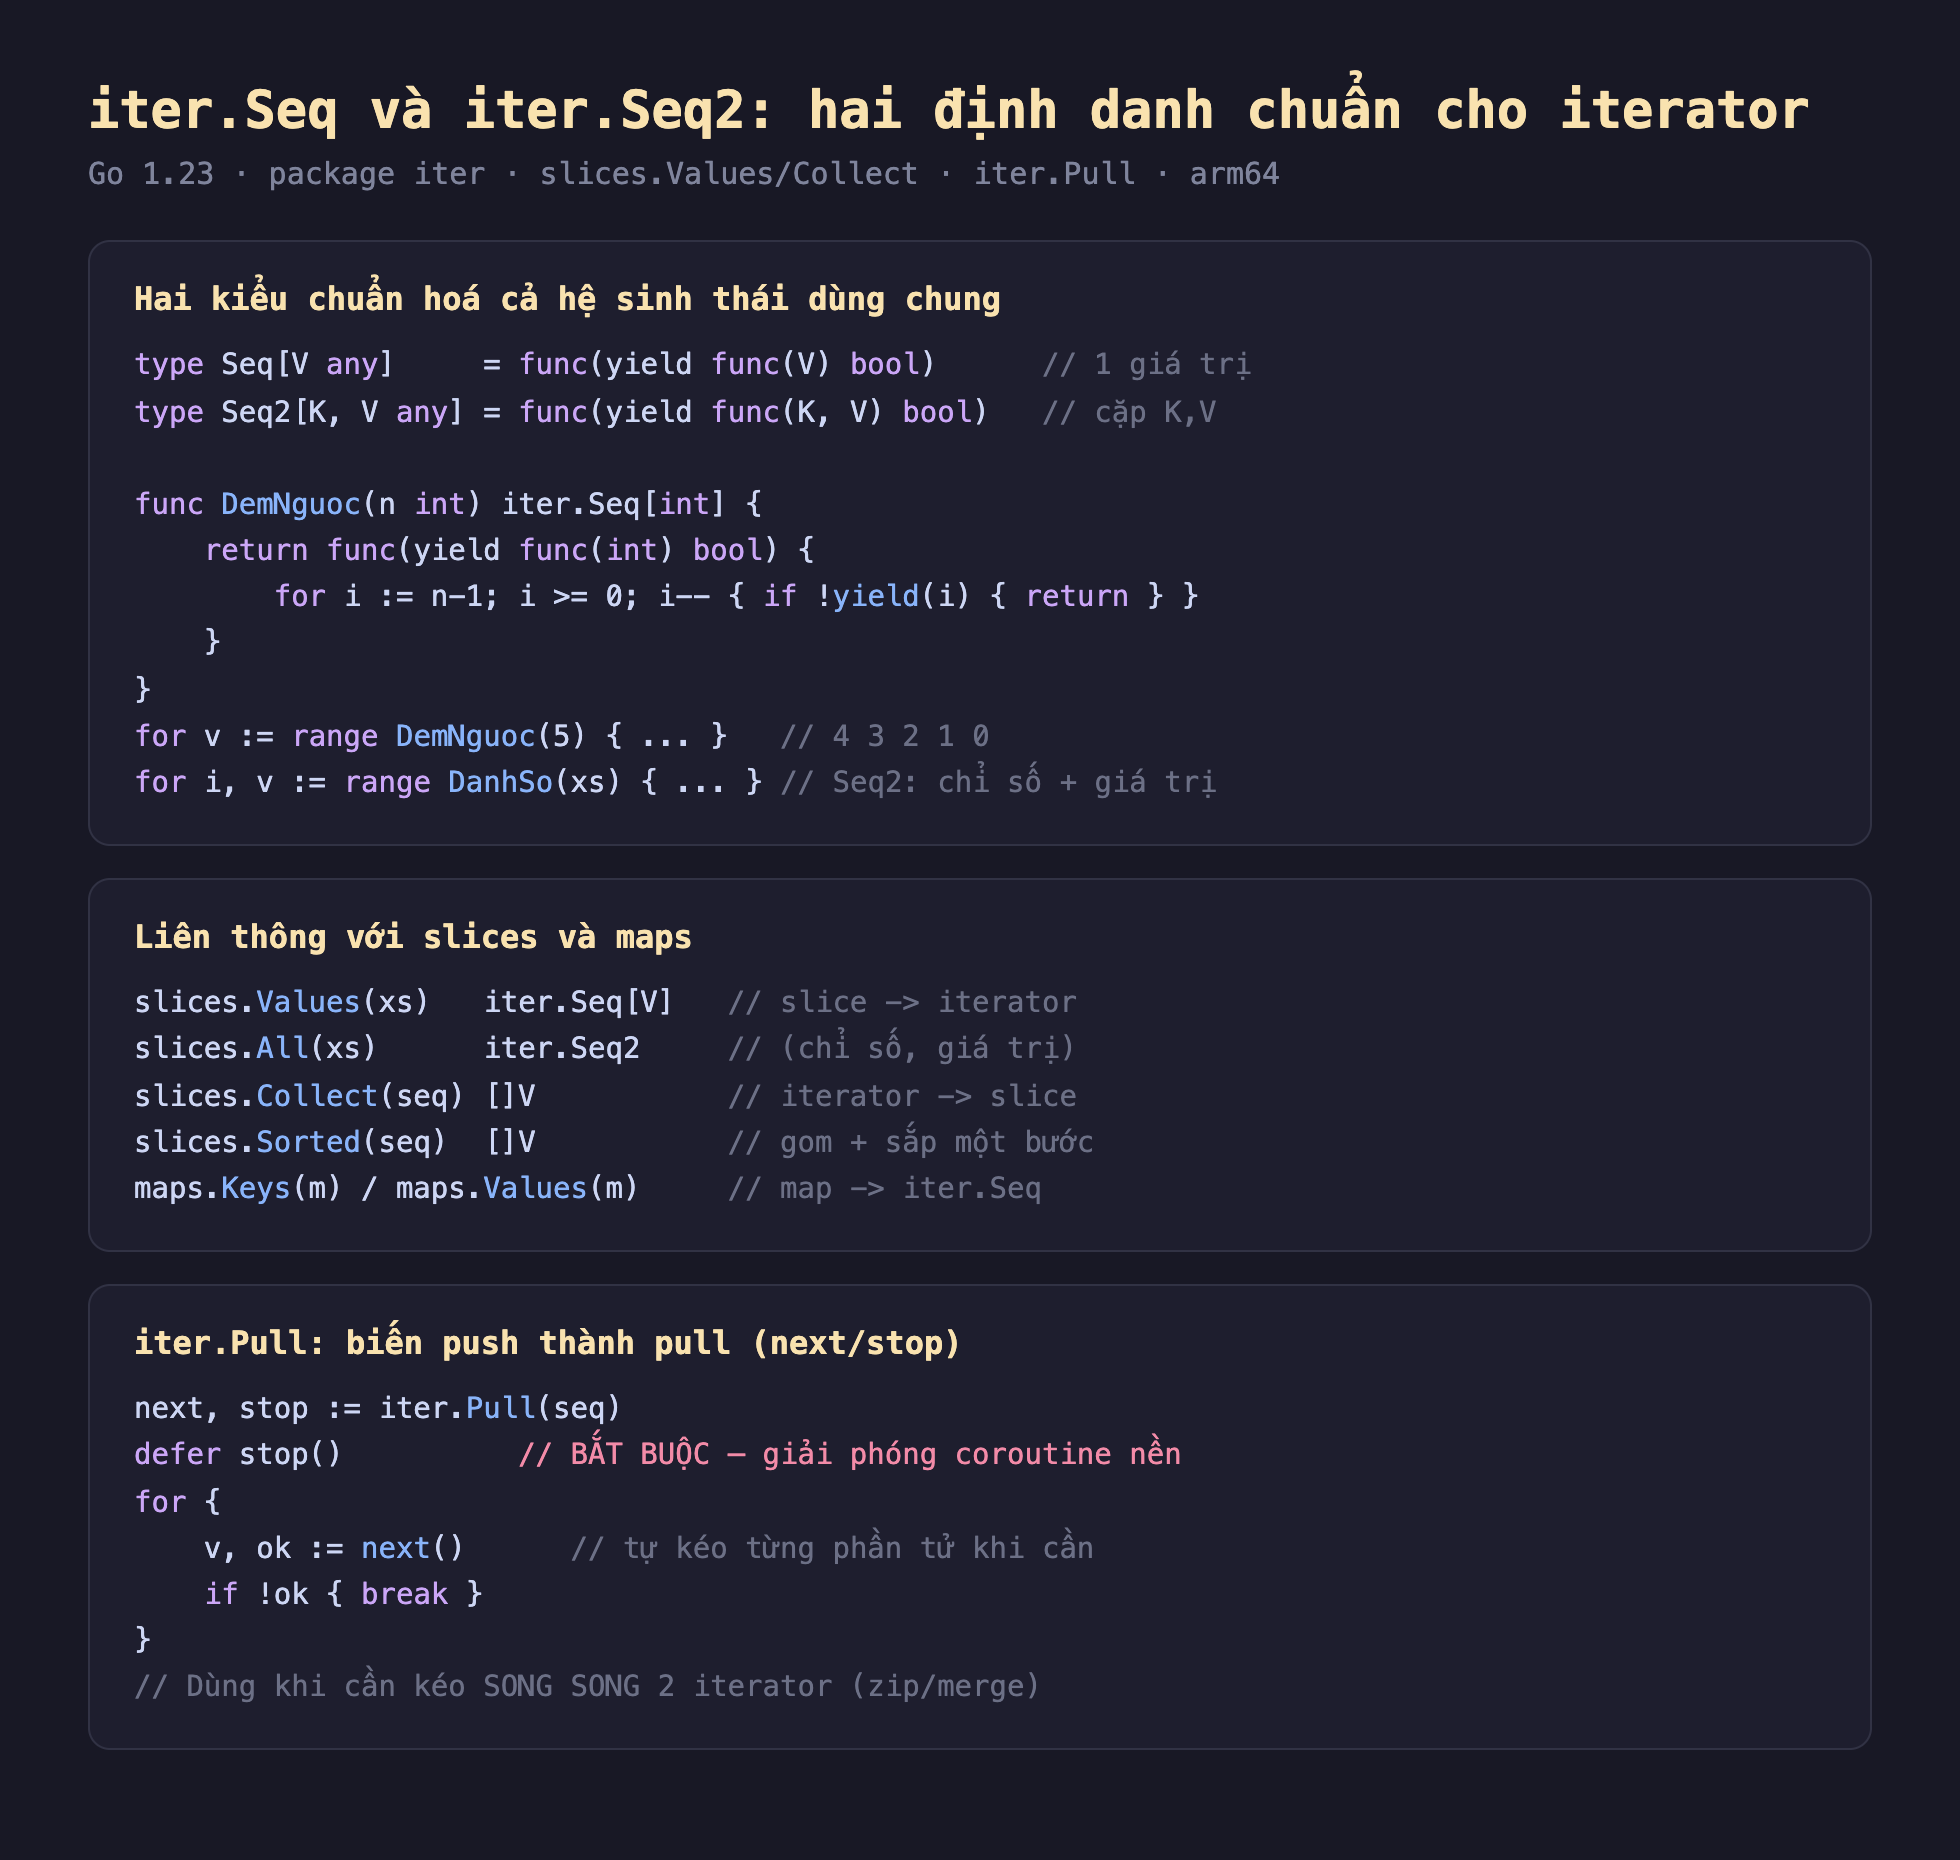
Hình 1: iter.Seq[V] và iter.Seq2[K,V] là hai bí danh chữ ký chuẩn. slices/maps cung cấp hàm chuyển qua lại (Values, All, Collect, Sorted, Keys); iter.Pull đảo iterator push thành cặp next/stop.
Liên thông với slices và maps
Sức mạnh thật của iter.Seq là nó khớp với hàng loạt hàm mới trong slices và maps — biến iterator thành một khớp nối chung giữa dữ liệu và thuật toán:
slices.Values(xs)   -> iter.Seq[V]    // slice thành iterator
slices.All(xs)      -> iter.Seq2      // (chỉ số, giá trị)
slices.Collect(seq) -> []V           // iterator thành slice
slices.Sorted(seq)  -> []V           // gom + sắp trong một bước
maps.Keys(m) / maps.Values(m)        // map thành iter.Seq
Đo thật: slices.Values([]int{10,20,30}) cho 10 20 30; slices.Collect(DemNguoc(4)) gom iterator ngược về slice [3 2 1 0]; slices.Sorted(DemNguoc(5)) vừa gom vừa sắp ra [0 1 2 3 4]. Chiều nào cũng có: slice → iterator → xử lý lười → slice. Đây là lý do iter.Seq không chỉ là "cú pháp đẹp" mà là hạ tầng cho một phong cách xử lý dữ liệu kiểu pipeline trong Go.
iter.Pull: đảo push thành pull, và cái giá của nó
Iterator iter.Seq là mô hình push: iterator chủ động đẩy từng phần tử qua yield, bạn không kiểm soát nhịp. Nhưng đôi khi bạn cần pull: tự quyết định khi nào kéo phần tử kế — kinh điển là khi muốn kéo song song hai iterator (zip, merge). for range đơn lẻ không làm được vì nó chỉ kéo tuần tự một nguồn. iter.Pull bắc cầu:
next, stop := iter.Pull(seq)
defer stop()          // BẮT BUỘC — giải phóng coroutine nền
for {
	v, ok := next()   // tự kéo từng phần tử khi cần
	if !ok { break }
}
Đo thật, iter.Pull cho phép zip hai iterator: (1,10) (2,20) (3,30) — kéo cả hai cùng nhịp, điều push không làm được. Nhưng đây là chỗ phải đo và thành thật về chi phí:
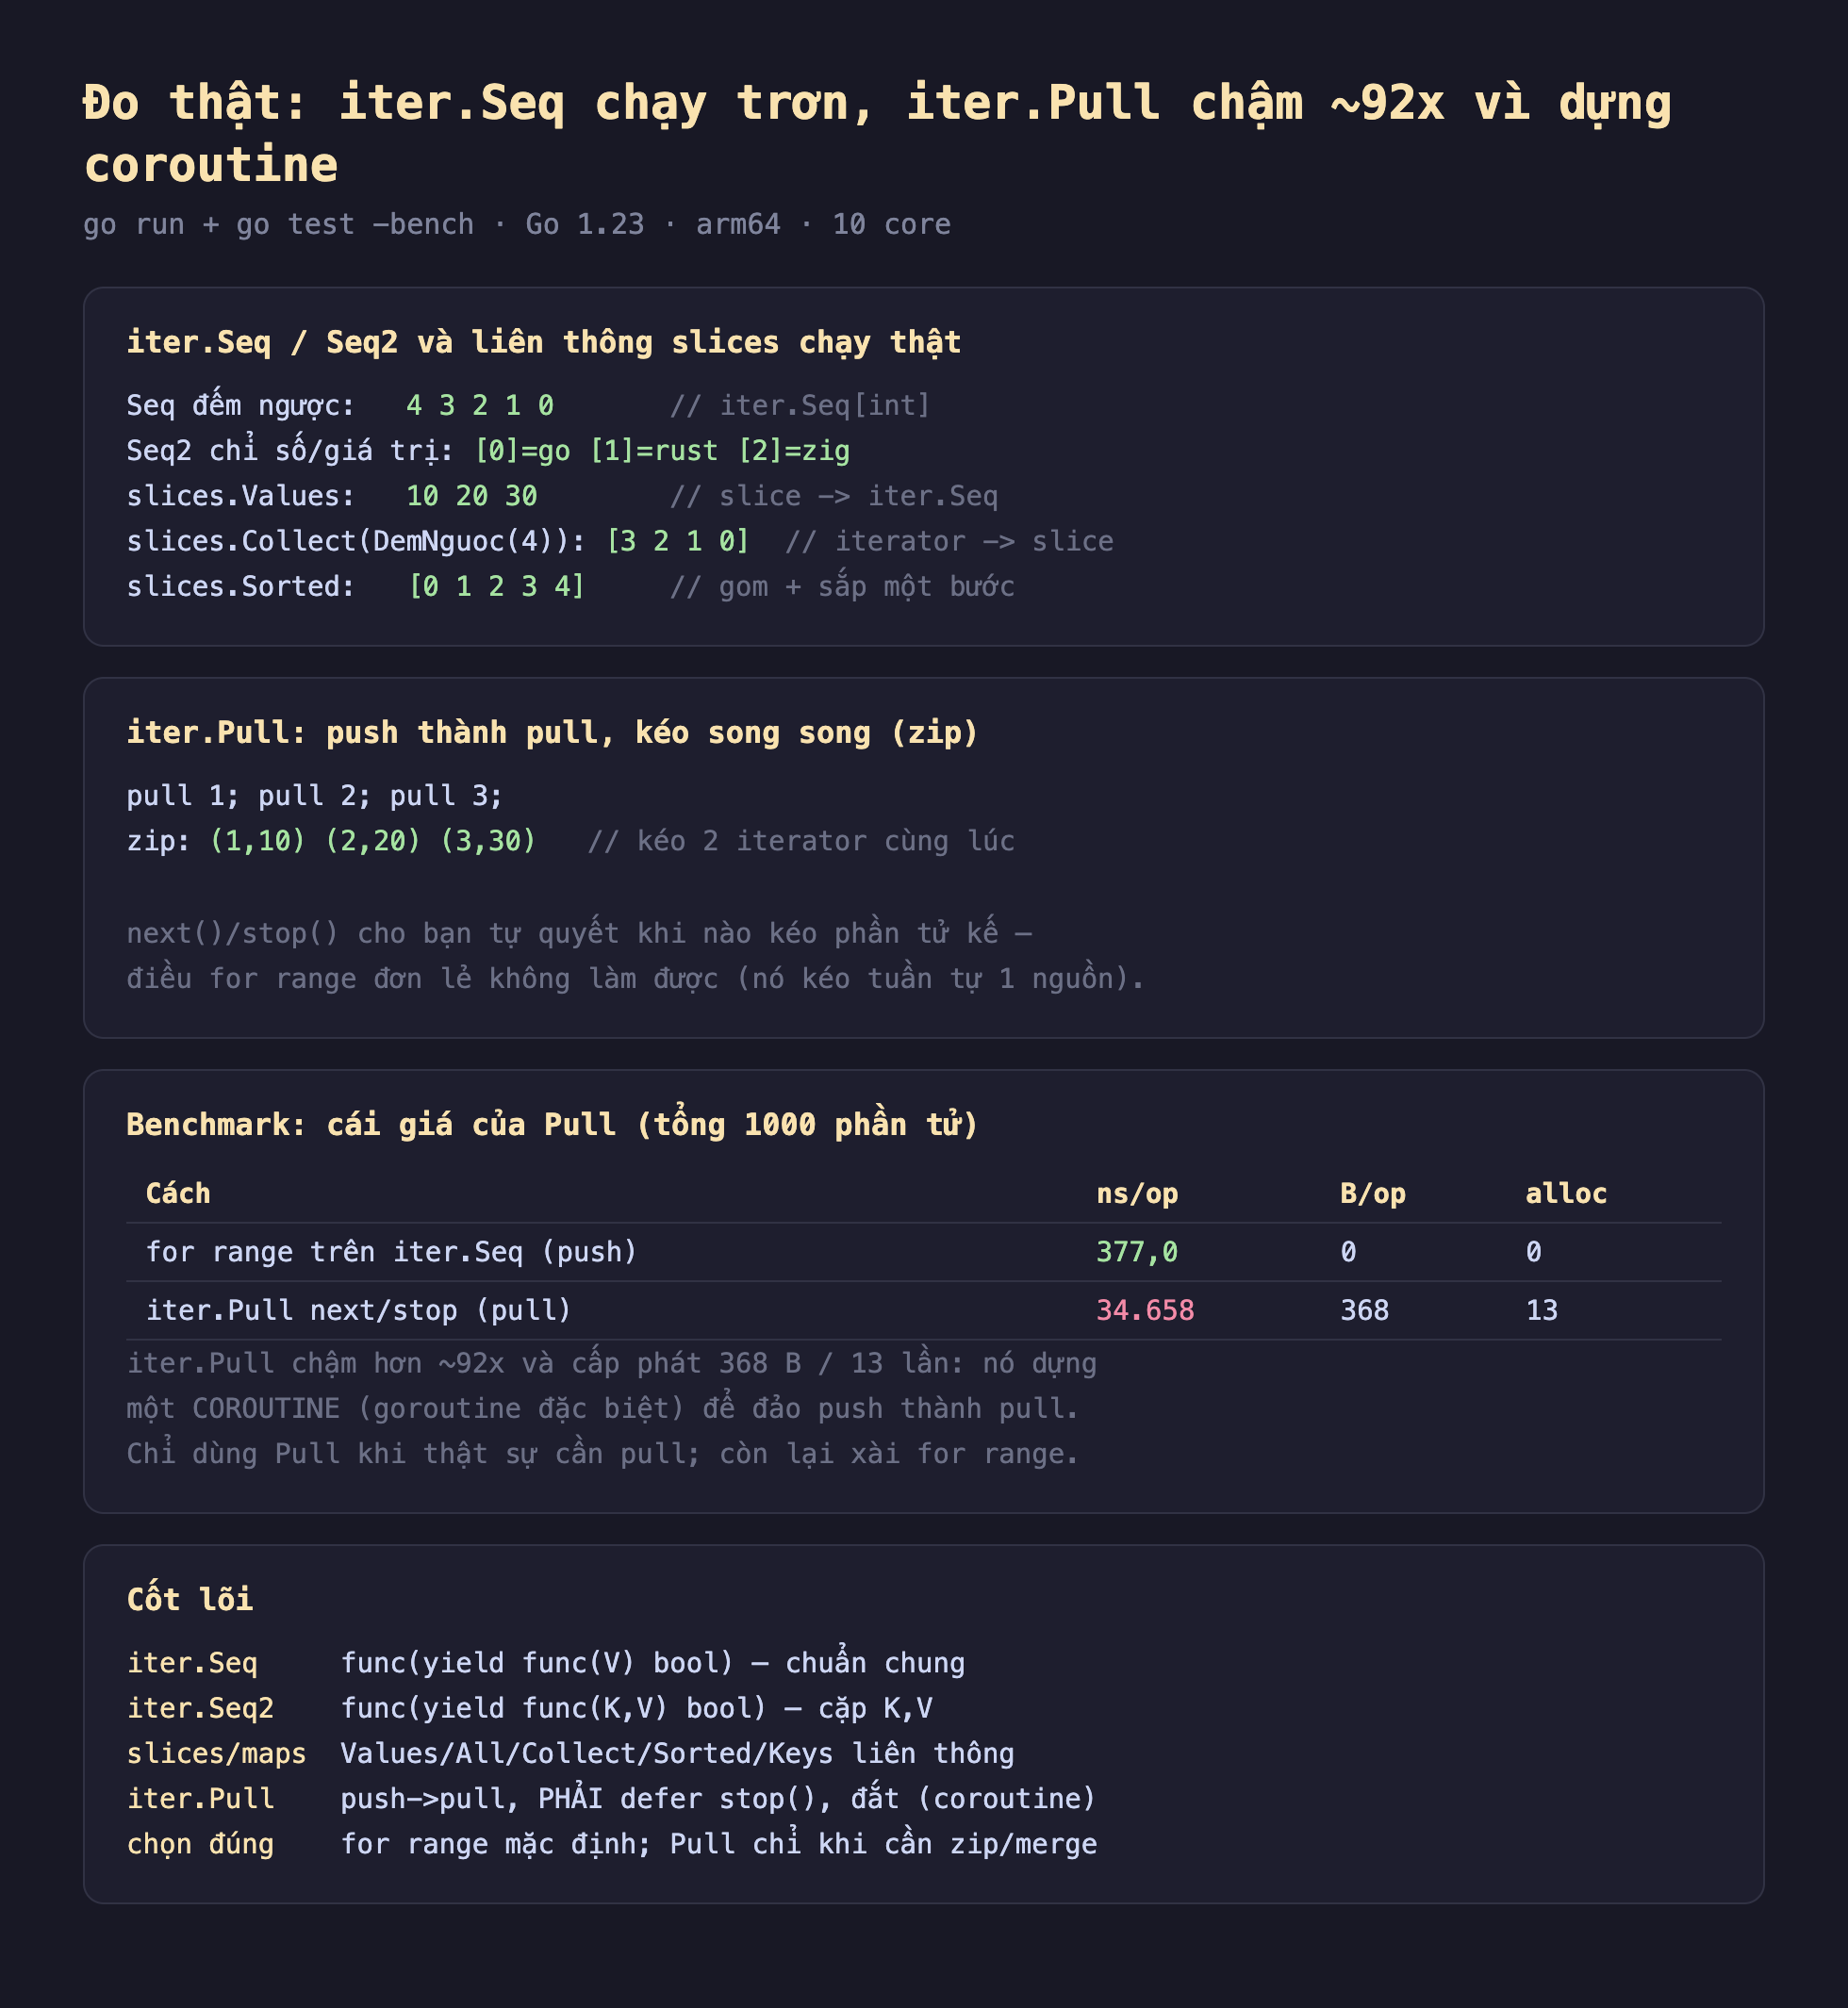
Hình 2: for range trên iter.Seq chạy 377,0 ns, 0 cấp phát. iter.Pull cùng công việc mất 34.658 ns, 368 B, 13 lần cấp phát — chậm hơn ~92 lần vì phải dựng một coroutine để đảo push thành pull.
iter.Pull chậm hơn ~92 lần (34.658 ns so với 377,0 ns) và cấp phát 368 byte / 13 lần. Lý do: để đảo một iterator push thành cặp next/stop, runtime phải dựng một coroutine — một goroutine đặc biệt chạy iterator và tạm dừng nó giữa các phần tử. Chi phí thiết lập coroutine đó là cái giá bạn trả. Đây là lý do defer stop() bắt buộc: nếu không gọi stop, coroutine nền bị treo, rò rỉ goroutine.
Đánh đổi cần cân nhắc
Dùng for range mặc định, iter.Pull chỉ khi thật sự cần pull. Với 99% trường hợp — duyệt, lọc, biến đổi một nguồn — for range trên iter.Seq là đúng và gần như miễn phí (0 cấp phát). Chỉ với limit ít ỏi các bài toán cần kéo nhiều nguồn đồng bộ (zip, merge sort, so trộn hai luồng), iter.Pull mới đáng cái giá coroutine. Đừng reach cho Pull vì nó "linh hoạt hơn".
Trả về iter.Seq thay vì slice khi dữ liệu lớn hoặc lười. Một hàm trả iter.Seq không phải cụ thể hóa toàn bộ dữ liệu — người gọi có thể break sớm hoặc chỉ lấy vài phần tử đầu. Nhưng nếu người gọi luôn cần cả tập và số phần tử nhỏ, trả []T thẳng có khi đơn giản và nhanh hơn. Chọn iter.Seq khi tính lười hoặc kích thước không giới hạn thật sự có giá trị.
Nhất quán chữ ký để cắm vào hệ sinh thái. Khi viết thư viện, trả đúng iter.Seq[V] / iter.Seq2[K,V] (không phải kiểu tự chế cùng chữ ký) để người dùng cắm thẳng vào slices.Collect, slices.Sorted, maps.Keys. Vì chúng là type alias, một func(yield func(int) bool) tự viết vẫn khớp — nhưng khai rõ iter.Seq[int] làm ý định và tài liệu rõ ràng hơn.
Ba ý mang về
iter.Seq[V]vàiter.Seq2[K,V]là hai định danh chuẩn (bí danh chofunc(yield func(V) bool)vàfunc(yield func(K,V) bool)) để cả hệ sinh thái Go nói chung một ngôn ngữ iterator —slicesvàmapscung cấpValues,All,Collect,Sorted,Keysđể chuyển qua lại giữa slice/map và iterator.for rangetrêniter.Seqgần như miễn phí: đo thật 377,0 ns, 0 cấp phát cho tổng 1.000 phần tử — đây là đường dùng mặc định cho gần như mọi bài toán duyệt.iter.Pullđảo push thành pull nhưng đắt ~92 lần (34.658 ns, 368 B, 13 alloc) vì phải dựng một coroutine —defer stop()là bắt buộc để tránh rò rỉ goroutine; chỉ dùng khi thật sự cần kéo song song nhiều nguồn (zip/merge).
Phần sau ta rời chủ đề iterator để sang một tính năng biên dịch rất thực dụng: Phần sau mổ xẻ //go:embed — cách nhúng tệp tĩnh thẳng vào binary, cơ chế, và đánh đổi kích thước so với đọc từ đĩa.
