Trong 15 năm, for range của Go chỉ chạy trên vài thứ dựng sẵn: slice, map, chuỗi, channel. Muốn duyệt một cây, một danh sách liên kết, hay kết quả phân trang từ API, bạn phải viết callback thủ công hoặc trả về slice tốn bộ nhớ. Go 1.23 mở khoá điều này: for range giờ chạy được trên một hàm. Cơ chế đứng sau — gọi là range-over-func — tinh tế hơn vẻ ngoài, và hiểu nó là hiểu vì sao break, continue, return đều "vừa vặn" bên trong một cấu trúc mà bạn tự viết. Bài này đo thật cơ chế đó và cái giá của nó.
Iterator là một hàm nhận yield
Một iterator trong Go 1.23 là một hàm có chữ ký đặc biệt: func(yield func(T) bool). Nó nhận vào một hàm yield, và mỗi lần muốn "sinh ra" một phần tử, nó gọi yield(phần_tử). Giá trị bool mà yield trả về là tín hiệu điều khiển: true nghĩa là "tiếp tục", false nghĩa là "vòng lặp muốn dừng" (do break hoặc return).
func Dem(n int) func(yield func(int) bool) {
	return func(yield func(int) bool) {
		for i := 0; i < n; i++ {
			if !yield(i) { // yield trả false -> ngừng sinh
				return
			}
		}
	}
}

for v := range Dem(5) { fmt.Print(v) } // 0 1 2 3 4
Điểm mấu chốt: iterator chủ động đẩy từng phần tử qua yield, còn thân vòng lặp for range chính là cái yield đó. Bạn viết logic duyệt một lần trong iterator; người dùng viết for v := range ... quen thuộc. Kiểm tra if !yield(i) { return } là bắt buộc — nó là cách iterator tôn trọng lệnh dừng từ phía người dùng.
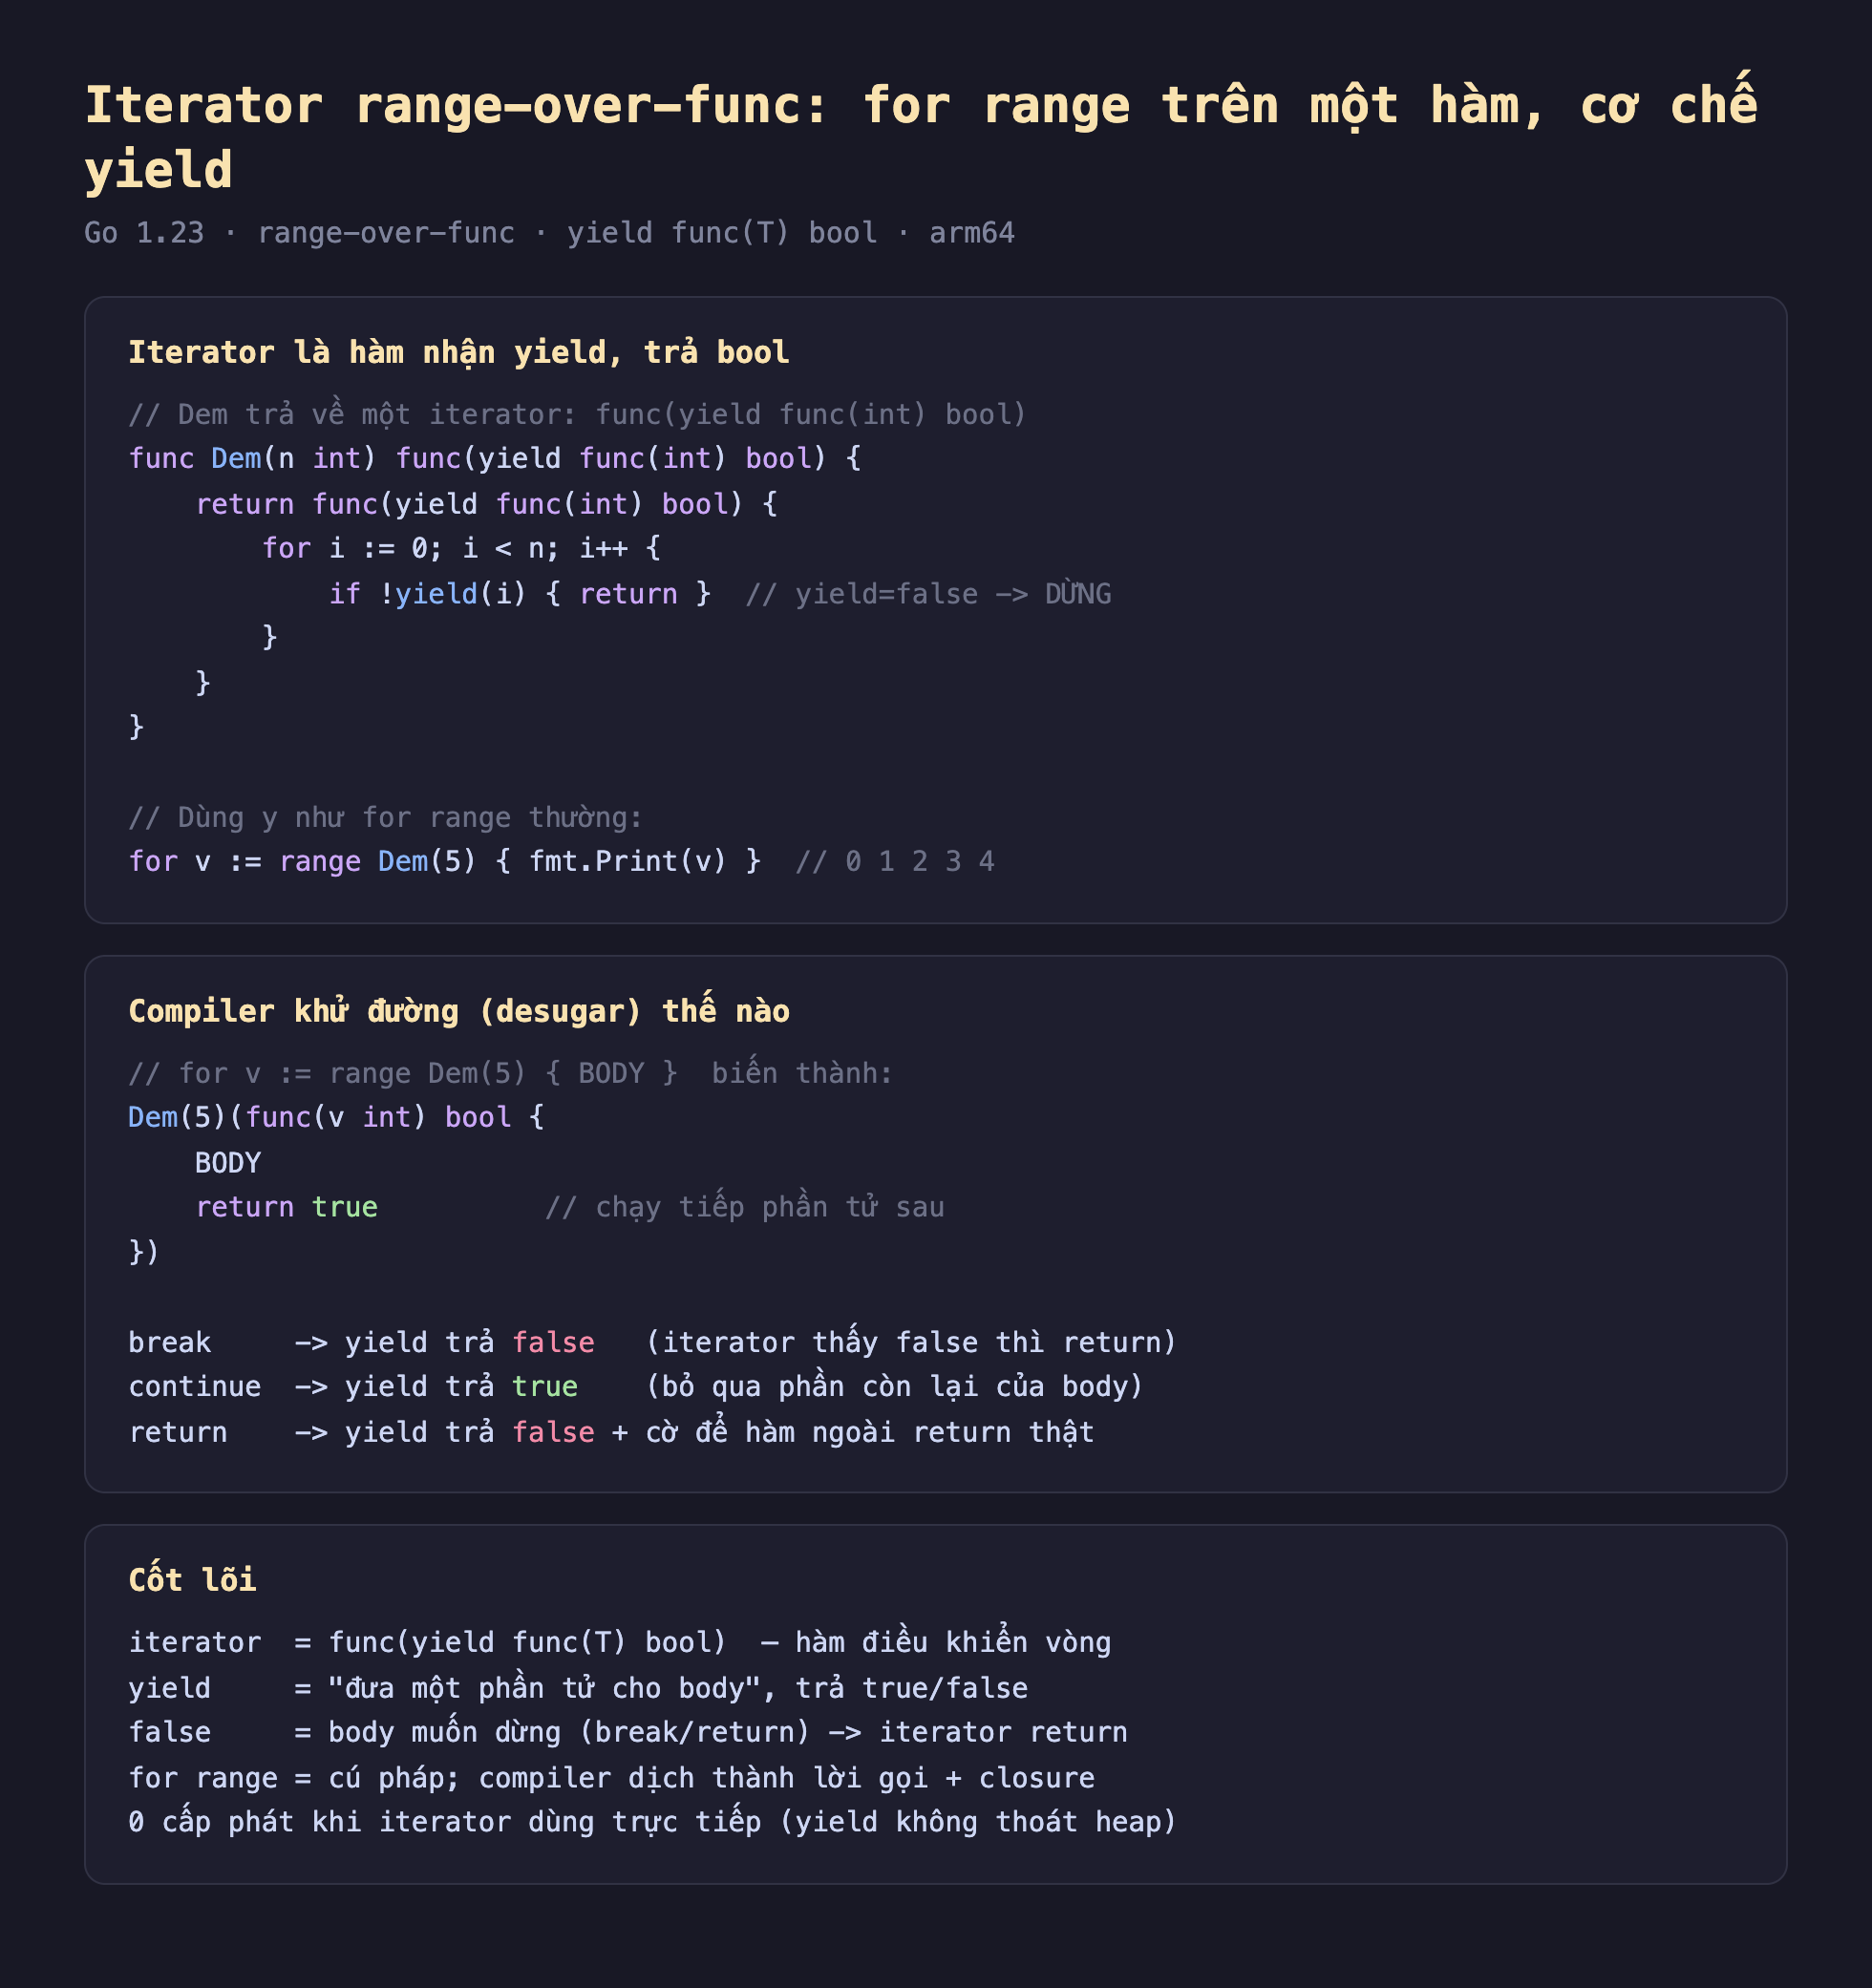
Hình 1: Iterator là hàm func(yield func(T) bool). Compiler khử for v := range Dem(5) { BODY } thành lời gọi Dem(5)(func(v int) bool { BODY; return true }); break/continue/return được dịch thành giá trị trả về của yield cộng cờ điều khiển.
Compiler khử đường thế nào
for range trên hàm không phải phép màu runtime — nó là phép biến đổi lúc biên dịch. Compiler dịch:
for v := range Dem(5) { BODY }
thành đại ý:
Dem(5)(func(v int) bool {
	BODY
	return true      // chạy hết body -> tiếp phần tử sau
})
Thân vòng lặp trở thành thân của closure yield. Ba lệnh điều khiển được dịch khéo léo:
break→yieldtrảfalse. Iterator thấyfalsethìreturn, kết thúc.continue→yieldtrảtruengay tại điểm đó (bỏ qua phần còn lại của body).returntừ hàm ngoài →yieldtrảfalsevà đặt một cờ, để sau khi iterator thoát, hàm bao ngoài thực sựreturn.
Đo thật cả bốn hành vi trong go-lab (Go 1.23):
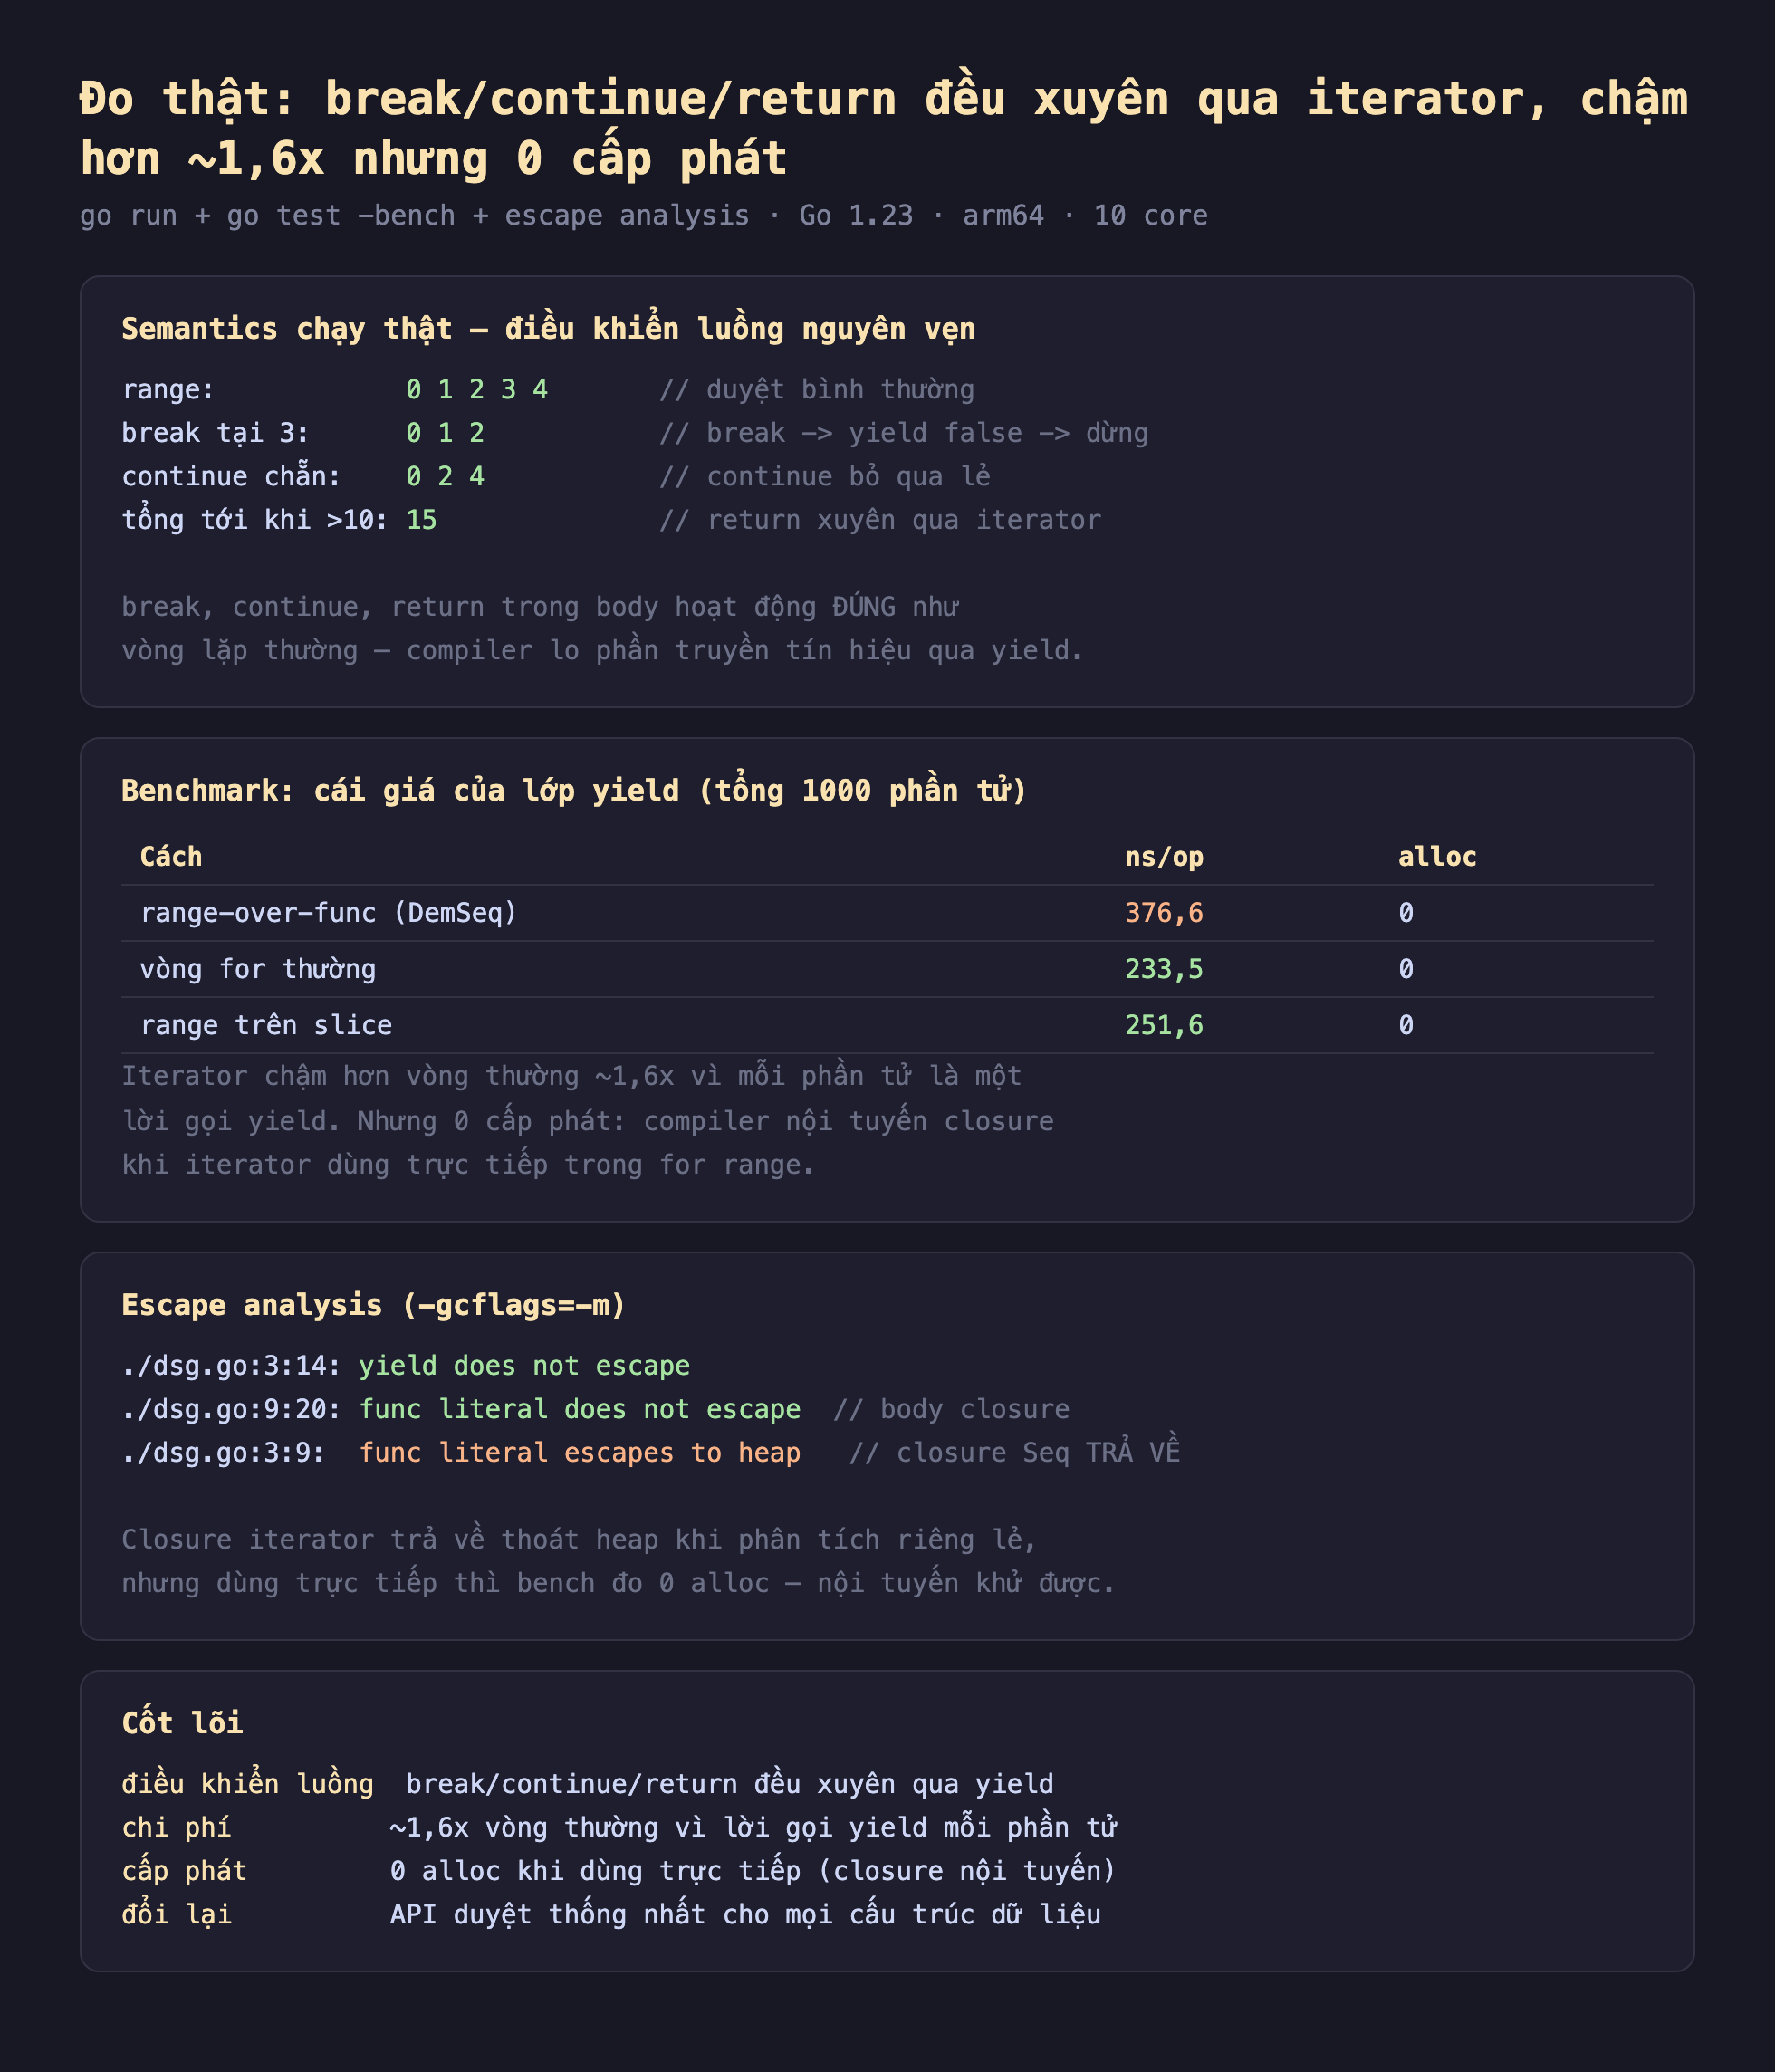
Hình 2: break dừng ở đúng phần tử (0 1 2), continue bỏ qua số lẻ (0 2 4), return xuyên qua iterator trả 15. Benchmark: range-over-func 376,6 ns so với vòng for thường 233,5 ns — chậm ~1,6x nhưng 0 cấp phát.
Kết quả: break tại 3 cho 0 1 2, continue chẵn cho 0 2 4, và return từ trong loop trả về 15 (tổng 0+1+2+3+4+5 vượt ngưỡng 10). Điều khiển luồng hoạt động y hệt vòng lặp thường — đây là điểm thiết kế quan trọng nhất: người dùng iterator không phải học luật mới.
Cái giá: chậm hơn nhưng không cấp phát
Không gì miễn phí. Mỗi phần tử sinh ra là một lời gọi hàm yield, thay vì chỉ một phép gán như vòng lặp thẳng. Benchmark phép tổng 1.000 phần tử:
- range-over-func: 376,6 ns/op, 0 cấp phát.
- vòng for thường: 233,5 ns/op, 0 cấp phát.
- range trên slice: 251,6 ns/op, 0 cấp phát.
Iterator chậm hơn vòng thường khoảng 1,6 lần — đó là chi phí của lớp gọi yield cho mỗi phần tử. Nhưng con số quan trọng không kém là 0 cấp phát. Khi iterator được dùng trực tiếp trong for range, compiler nội tuyến (inline) closure yield và closure iterator, nên không có gì thoát ra heap trong vòng nóng.
Điểm cần thành thật: escape analysis (-gcflags=-m) có báo func literal escapes to heap cho closure mà iterator trả về khi phân tích riêng lẻ — vì một hàm trả về closure thì closure đó thường phải lên heap. Nhưng khi nơi gọi dùng nó ngay trong for range cùng hàm, việc nội tuyến khử được cả cấp phát đó, và benchmark đo 0 allocs/op là bằng chứng runtime cuối cùng. Kết luận: dùng iterator trực tiếp thì rẻ; nếu bạn lưu iterator vào biến rồi truyền lòng vòng qua nhiều hàm, khả năng cấp phát tăng lên — hãy đo chính đường dùng của bạn.
Đánh đổi cần cân nhắc
Dùng iterator khi API duyệt quan trọng hơn 1,6x tốc độ. Với hầu hết code (duyệt cây, phân trang, lọc/biến đổi lười), 143 ns chênh trên 1.000 phần tử là không đáng kể so với lợi ích: một API for range thống nhất cho mọi cấu trúc dữ liệu, không phải trả về slice tốn bộ nhớ hay viết callback thủ công. Trong vòng lặp cực nóng đếm từng nano giây, vòng thẳng vẫn thắng.
Iterator lười (lazy) tiết kiệm bộ nhớ thật sự. Lợi ích lớn nhất không phải tốc độ mà là không phải cụ thể hóa toàn bộ dữ liệu. Một iterator đọc file theo dòng, hay gọi API phân trang, chỉ giữ một phần tử tại một thời điểm — thay vì []string chứa cả triệu dòng. Đây là nơi range-over-func thắng đậm so với "trả về slice".
Iterator có trạng thái phải cẩn thận khi dùng lại. Một iterator gọi hai lần phải cho kết quả nhất quán (hoặc tài liệu rõ là dùng-một-lần). Iterator bọc quanh channel hay con trỏ file là hữu hạn — duyệt lần hai được gì tuỳ nguồn. Đây là hợp đồng bạn phải tự giữ; compiler không kiểm hộ.
Ba ý mang về
- Range-over-func cho
for rangechạy trên hàmfunc(yield func(T) bool): iterator chủ động đẩy phần tử quayield, còn thân vòng lặp chính là closureyieldđó — kiểmif !yield(x) { return }là cách tôn trọng lệnh dừng. - Compiler khử đường lúc biên dịch, không phải runtime:
break→yieldtrảfalse,continue→ trảtrue,return→ trảfalsecộng cờ — nên đo thật cho thấy điều khiển luồng hoạt động y hệt vòng lặp thường (break dừng đúng chỗ, return xuyên qua iterator). - Cái giá là ~1,6x tốc độ nhưng 0 cấp phát khi dùng trực tiếp (376,6 ns so với 233,5 ns, đo thật, compiler nội tuyến closure): đổi lại được API duyệt thống nhất và iterator lười tiết kiệm bộ nhớ — chọn nó khi tính tổng quát quan trọng hơn từng nano giây.
Bài tập làm thử
Bài 1 (đọc hiểu). Cho iterator:
func Dem(n int) func(yield func(int) bool) {
	return func(yield func(int) bool) {
		for i := 0; i < n; i++ {
			if !yield(i) {
				return
			}
		}
	}
}
Đoạn code sau in ra gì?
for v := range Dem(6) {
	if v == 3 {
		break
	}
	fmt.Print(v, " ")
}
Đáp án
In ra 0 1 2 . Khi v == 3, lệnh break được compiler dịch thành yield trả về false tại điểm đó; iterator Dem thấy yield(3) trả false (do phần thân trước khi break không kịp Print giá trị 3 — thực chất break chạy trước dòng Print) nên return ngay, dừng vòng lặp. Kết quả: các giá trị 0, 1, 2 được in trước khi gặp 3 và dừng.
Bài 2 (sửa lỗi/hoàn thiện). Viết một iterator ChanLe(n int) func(yield func(int) bool) sinh ra các số từ 0 đến n-1 nhưng chỉ những số chẵn, tuân theo đúng chữ ký và quy tắc kiểm tra yield đã học.
Đáp án
func ChanLe(n int) func(yield func(int) bool) {
	return func(yield func(int) bool) {
		for i := 0; i < n; i++ {
			if i%2 != 0 {
				continue // số lẻ: bỏ qua, không gọi yield
			}
			if !yield(i) {
				return
			}
		}
	}
}
Điểm quan trọng: chỉ gọi yield cho số chẵn; continue trong thân iterator ở đây là Go thuần (bỏ qua vòng lặp for bên trong iterator), khác với continue mà người dùng viết trong thân for range (cái đó được compiler dịch thành yield trả true). Luôn kiểm if !yield(i) { return } sau mỗi lần gọi yield để tôn trọng lệnh dừng từ phía người dùng.
Bài 3 (vận dụng thực tế). Bạn đang viết một hàm đọc file rất lớn theo từng dòng và muốn cung cấp API cho người dùng duyệt qua các dòng đó bằng for range. Nêu ưu điểm chính của việc dùng iterator (range-over-func) so với việc trả về []string chứa toàn bộ các dòng.
Đáp án
Ưu điểm chính là tính lười (lazy): iterator không cần cụ thể hóa toàn bộ dữ liệu trong bộ nhớ cùng lúc — nó chỉ giữ một dòng tại một thời điểm và sinh dòng tiếp theo khi được yêu cầu (khi vòng for range tiếp tục). Với file rất lớn (có thể hàng triệu dòng), trả về []string sẽ tốn rất nhiều bộ nhớ để chứa toàn bộ nội dung, trong khi iterator giữ bộ nhớ ở mức tối thiểu và cho phép người dùng break sớm nếu chỉ cần vài dòng đầu mà không phải đọc/giữ toàn bộ file.
Bài 4 (đọc số liệu đo thật). Bài đo tổng 1.000 phần tử: range-over-func 376,6 ns/op (0 cấp phát), vòng for thường 233,5 ns/op (0 cấp phát), range trên slice 251,6 ns/op (0 cấp phát). Giải thích tại sao range-over-func chậm hơn nhưng vẫn đạt 0 cấp phát, và điều gì có thể phá vỡ tính "0 cấp phát" đó.
Đáp án
Range-over-func chậm hơn (~1,6x) vì mỗi phần tử sinh ra tương ứng với một lời gọi hàm yield, tốn hơn một phép gán/tăng chỉ số đơn thuần của vòng for thường. Tuy nhiên nó vẫn đạt 0 cấp phát vì khi iterator được dùng trực tiếp ngay trong for range (cùng phạm vi), compiler có thể nội tuyến (inline) cả closure yield lẫn closure của iterator, nên không có gì phải "thoát" (escape) lên heap. Điều có thể phá vỡ điều này: nếu bạn lưu iterator vào một biến rồi truyền nó lòng vòng qua nhiều hàm khác nhau (không dùng trực tiếp tại chỗ), compiler khó/không thể nội tuyến nữa, và escape analysis có thể buộc closure phải cấp phát lên heap — bài viết khuyến cáo phải tự đo lại trong trường hợp cụ thể đó.
Bài 5 (bẫy/đánh đổi). Một lập trình viên nói: "Iterator luôn tốt hơn vòng for thường vì nó tổng quát hơn, nên tôi sẽ đổi hết mọi vòng lặp trong code sang range-over-func." Nêu điểm cần cân nhắc lại trong quyết định này dựa theo bài học.
Đáp án
Bài học nói rõ: "dùng iterator khi API duyệt quan trọng hơn 1,6x tốc độ" — với hầu hết code (duyệt cây, phân trang, lọc/biến đổi lười) mức chênh ~143 ns trên 1.000 phần tử không đáng kể so với lợi ích về API thống nhất và tiết kiệm bộ nhớ. Nhưng "trong vòng lặp cực nóng đếm từng nano giây, vòng thẳng vẫn thắng" — nghĩa là không nên đổi mọi vòng lặp một cách máy móc; những vòng lặp hiệu năng cực kỳ nhạy cảm (hot path đã được xác định qua profiling) nên giữ nguyên dạng vòng for thường thay vì đổi sang iterator chỉ vì tính tổng quát.
Phần sau ta đi vào hai kiểu chuẩn hoá cơ chế này trong thư viện chuẩn: Phần sau mổ xẻ iter.Seq và iter.Seq2 — hai định danh mà cả hệ sinh thái Go dùng chung để viết và tiêu thụ iterator.
