Người dùng thật không gõ hoàn hảo. Họ gõ "elasticsrch" (thiếu chữ), "kibanna" (thừa chữ), hoặc mới gõ "ela" đã mong thấy gợi ý. Một ô tìm kiếm tốt phải xử lý cả hai: chịu lỗi gõ sai (fuzzy) và gợi ý khi gõ dở (autocomplete). Elasticsearch có công cụ cho cả hai, nhưng chúng hoạt động ở hai thời điểm khác nhau — và hiểu điều đó quyết định bạn chọn đúng công cụ.
Bài này (phần 11 loạt Elasticsearch) đo thật fuzzy query và edge_ngram autocomplete trên es-lab, cùng cái giá phải trả cho mỗi cách.
Hai bài toán, hai thời điểm
Fuzzy (chịu lỗi gõ sai) tính lúc truy vấn. Nó dùng khoảng cách Levenshtein — số phép sửa tối thiểu (thêm/xóa/đổi/hoán vị một ký tự) để biến chuỗi này thành chuỗi kia. Tham số fuzziness là số phép sửa cho phép. Vì tính lúc truy vấn, nó không cần index đặc biệt, nhưng tốn hơn khi tìm.
Autocomplete (gợi ý khi gõ dở) chuẩn bị lúc index bằng edge_ngram: tạo sẵn tất cả tiền tố của mỗi từ ("elastic" → el, ela, elas, elast...). Khi người dùng gõ "ela", nó khớp token "ela" đã lưu sẵn → ra ngay. Tính trước lúc index nên tìm cực nhanh, nhưng index to hơn.
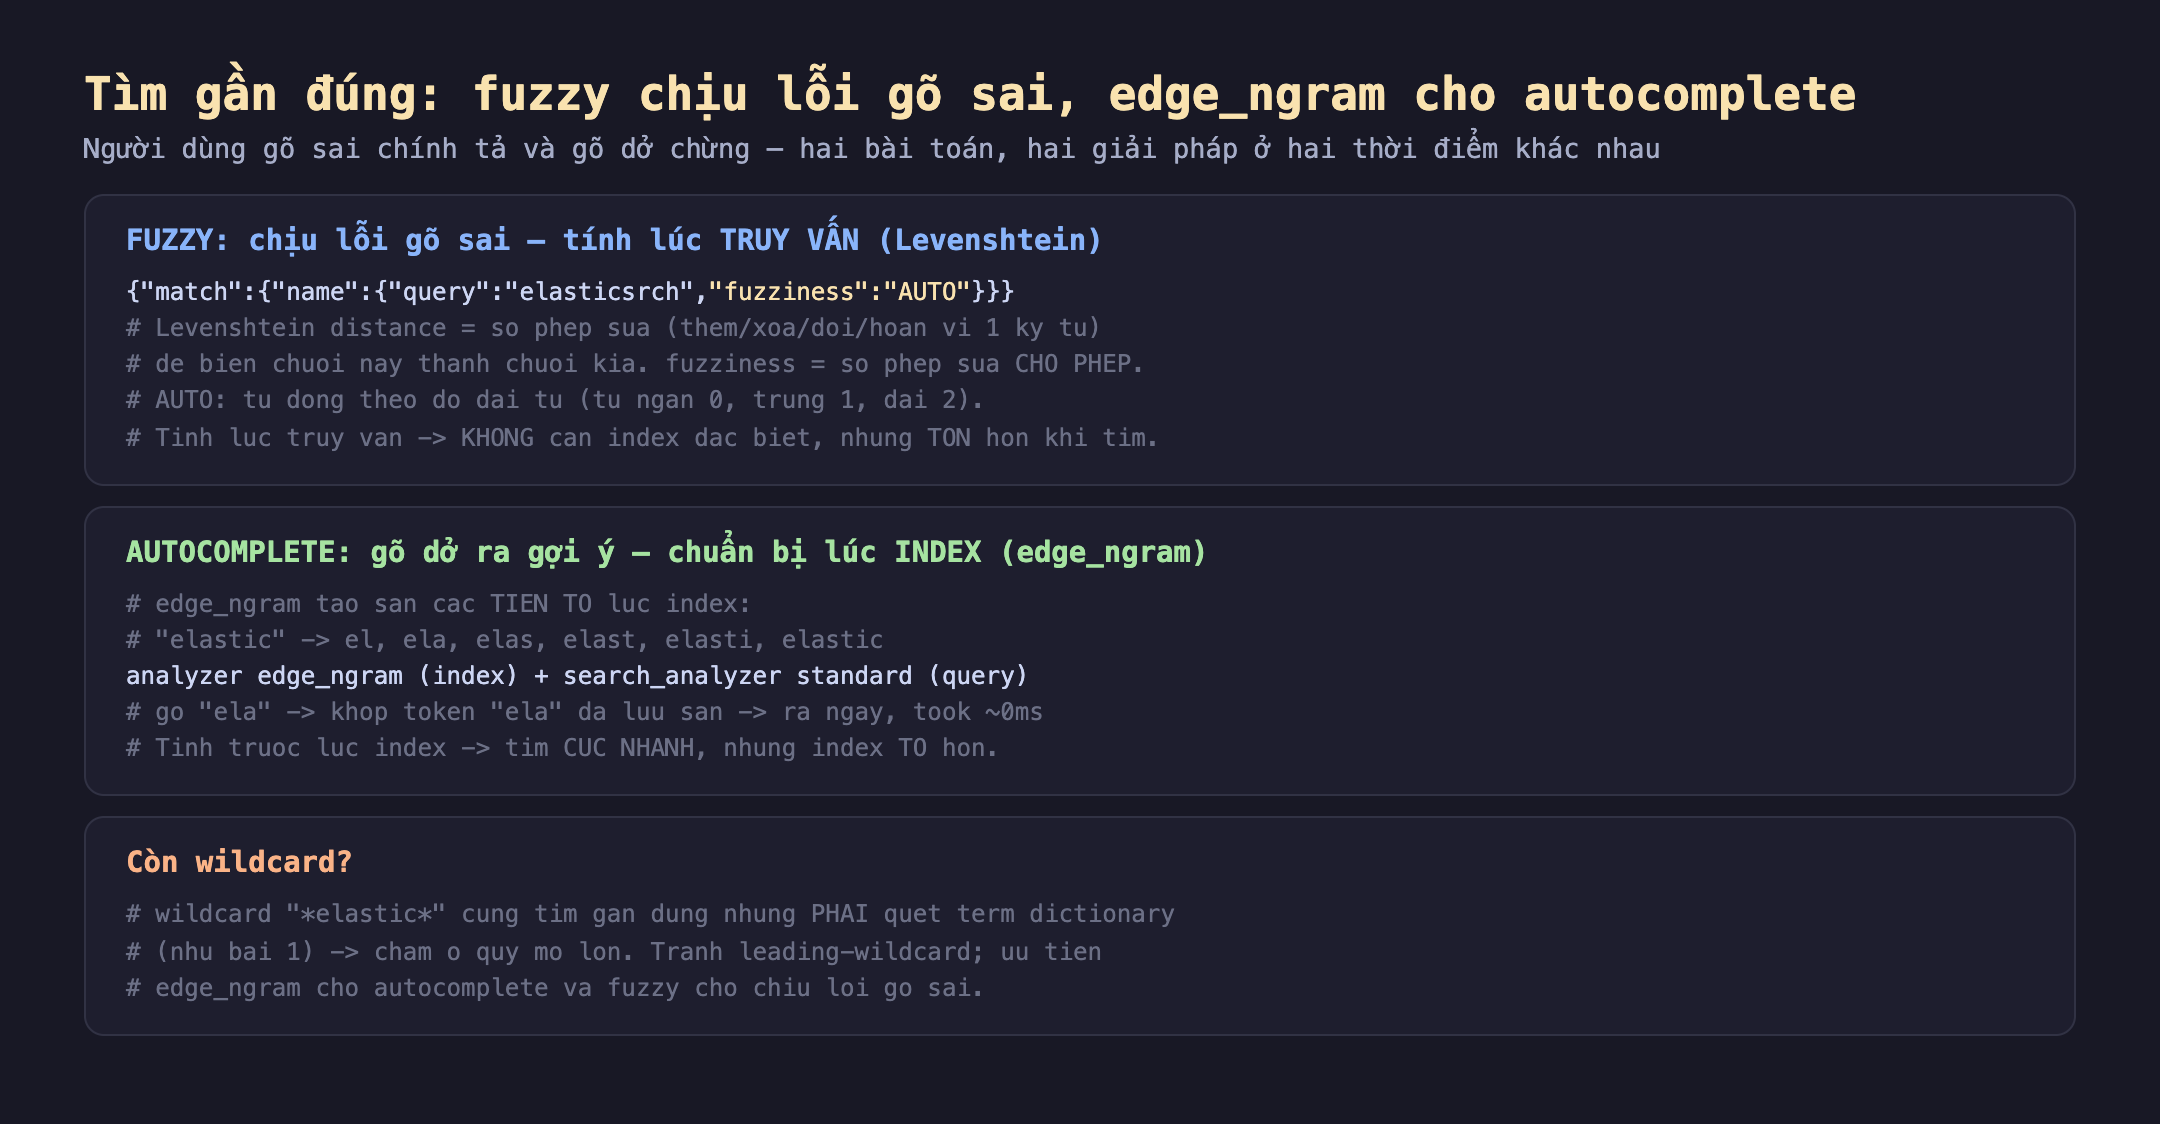
Hình 1: fuzzy tính Levenshtein distance lúc truy vấn (không cần index đặc biệt, tốn khi tìm). edge_ngram tạo sẵn tiền tố lúc index (tìm cực nhanh, index to hơn). Hai thời điểm, hai đánh đổi.
# Fuzzy: chiu loi go sai
{"query":{"match":{"name":{"query":"elasticsrch","fuzziness":"AUTO"}}}}

# Autocomplete: index voi edge_ngram, search voi standard
PUT /terms {"settings":{"analysis":{
  "analyzer":{"ac":{"tokenizer":"ac_tok","filter":["lowercase"]}},
  "tokenizer":{"ac_tok":{"type":"edge_ngram","min_gram":2,"max_gram":15,"token_chars":["letter"]}}
}}, "mappings":{"properties":{
  "name":{"type":"text","analyzer":"ac","search_analyzer":"standard"}}}}
Chú ý: autocomplete dùng analyzer: ac (edge_ngram) lúc index nhưng search_analyzer: standard lúc tìm — nếu không, chuỗi tìm cũng bị cắt thành n-gram và cho kết quả sai. Đây là cạm bẫy đã nhắc ở bài analyzer.
Đo thật: fuzzy chịu lỗi gõ sai
Mình index 5 từ (elasticsearch, elastic stack, logstash, kibana, kubernetes) rồi gõ sai chính tả với fuzziness: AUTO. Kết quả thật từ es-lab:
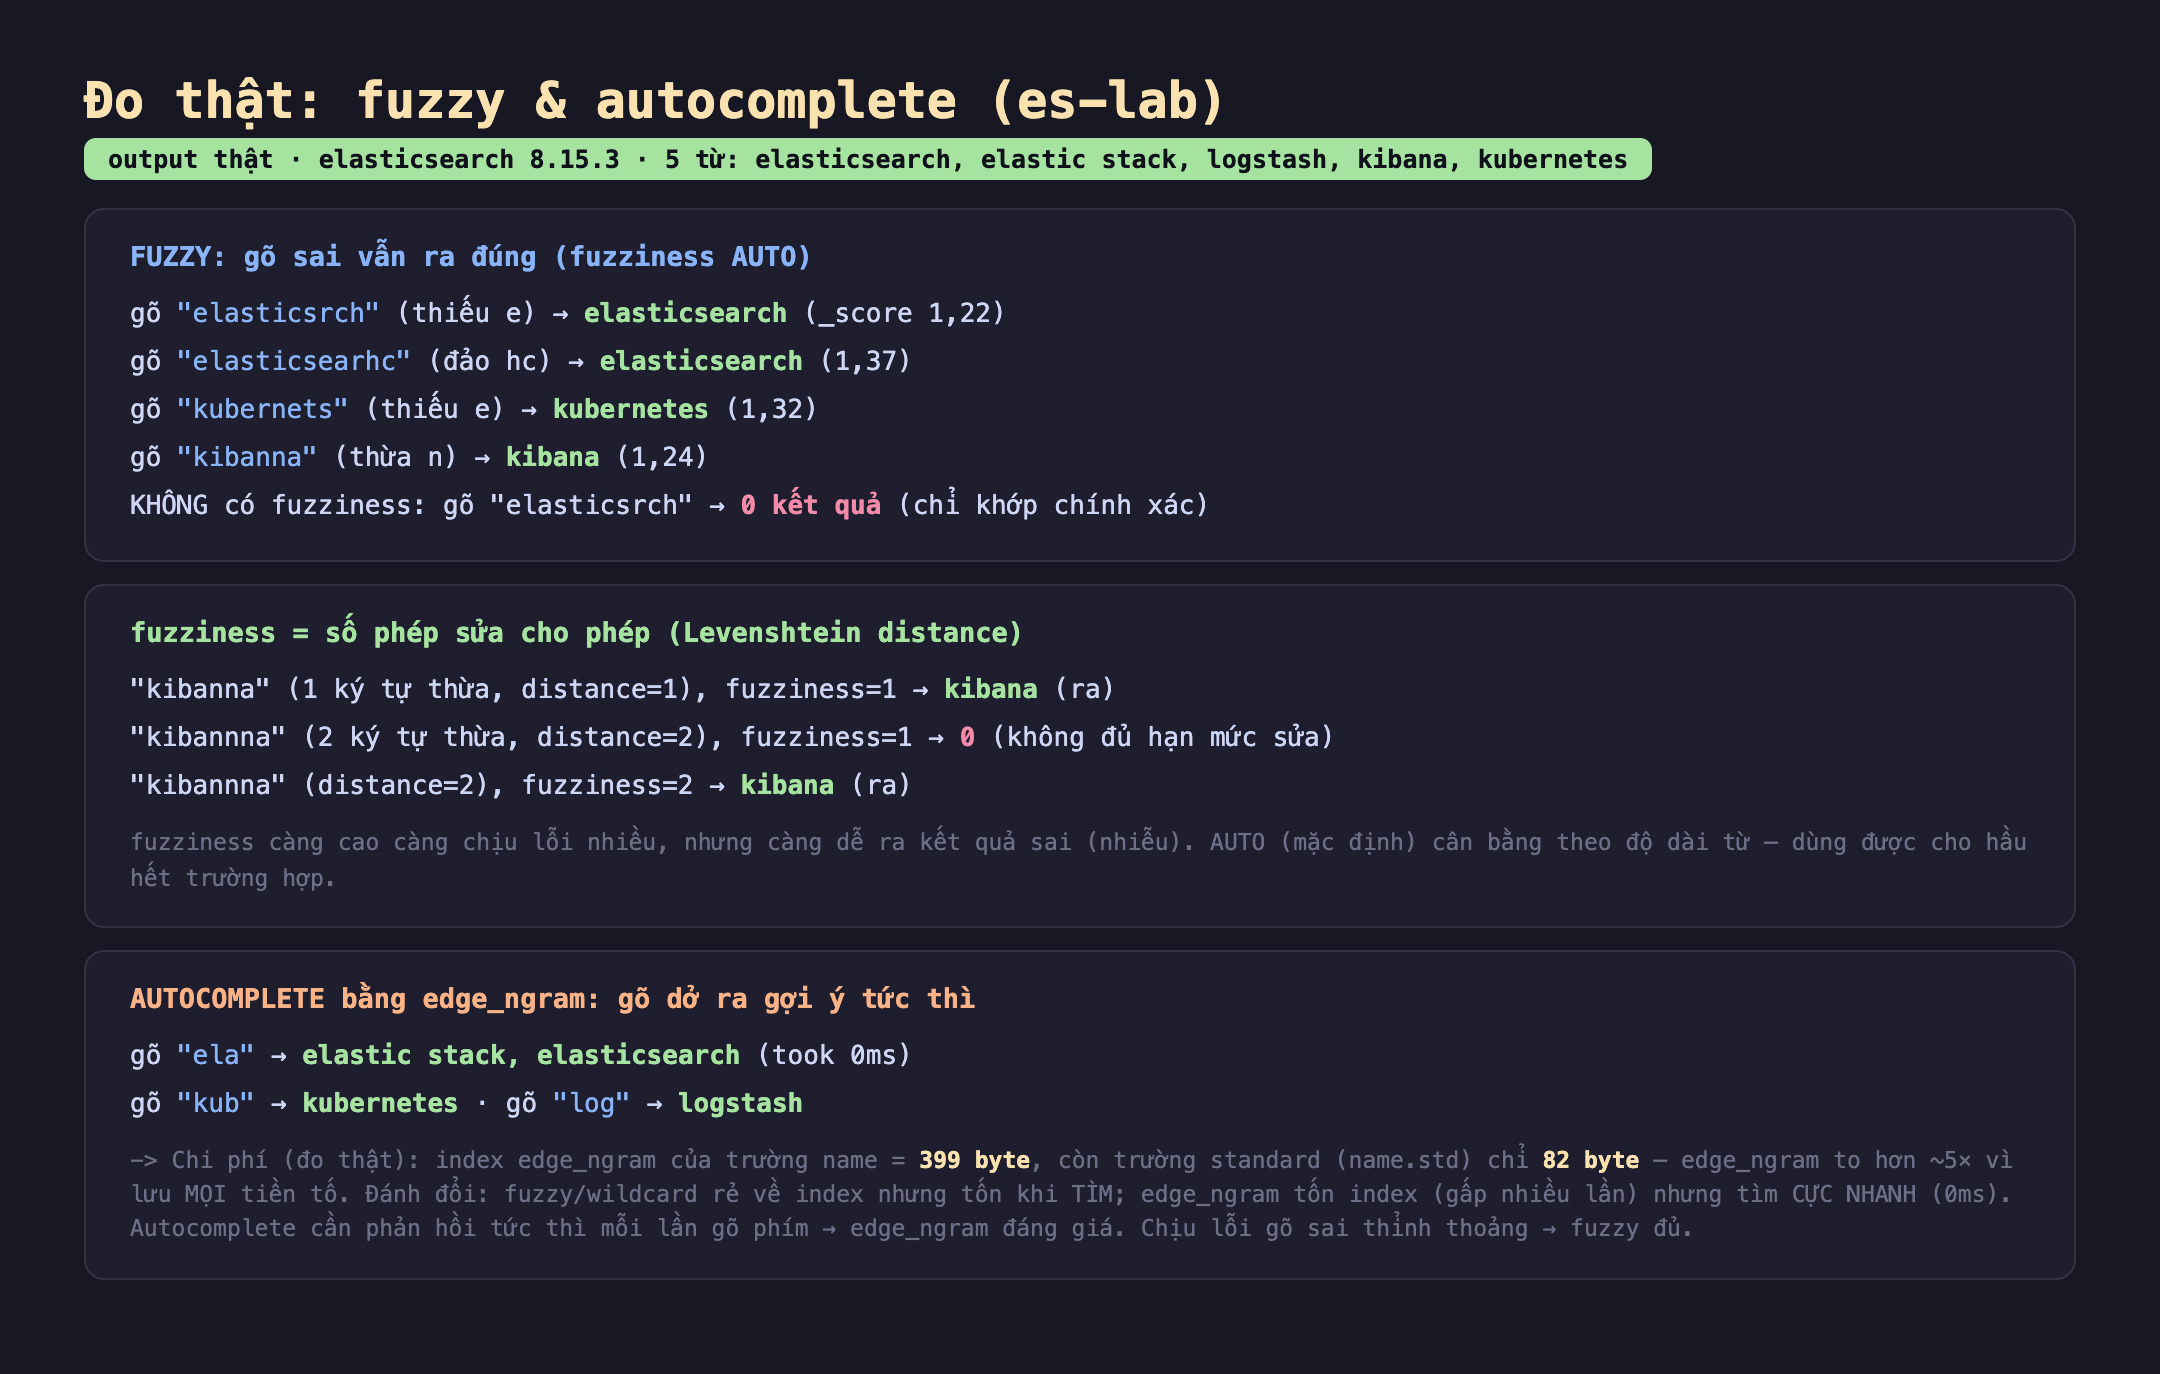
Hình 2: Kết quả thật. fuzzy sửa được typo (elasticsrch→elasticsearch); fuzziness theo Levenshtein distance (1 lỗi cần fuzziness≥1, 2 lỗi cần ≥2); edge_ngram autocomplete ra gợi ý trong 0ms; index edge_ngram 399b vs standard 82b.
- Gõ sai vẫn ra đúng: "elasticsrch" (thiếu e), "elasticsearhc" (đảo hc), "kubernets" (thiếu e), "kibanna" (thừa n) — tất cả đều tìm ra từ đúng với điểm hợp lý. Đây là trải nghiệm "ý bạn là...?" của các ô tìm kiếm tốt.
- Không có fuzziness thì gõ sai = 0 kết quả: "elasticsrch" tìm chính xác → 0 hits. Fuzzy là thứ bật thêm, không mặc định.
Đo thật: fuzziness là khoảng cách Levenshtein
Để thấy fuzziness chính xác là gì, mình thử các mức lỗi khác nhau:
- "kibanna" (1 ký tự thừa, distance=1) với
fuzziness:1→ ra kibana. - "kibannna" (2 ký tự thừa, distance=2) với
fuzziness:1→ 0 kết quả (không đủ hạn mức sửa). - "kibannna" (distance=2) với
fuzziness:2→ ra kibana.
Rõ ràng: fuzziness là trần số phép sửa. Lỗi vượt trần thì không khớp. AUTO (mặc định) tự chọn trần theo độ dài từ (từ ngắn 0, trung bình 1, dài 2) — cân bằng tốt cho hầu hết trường hợp.
Đo thật: autocomplete bằng edge_ngram
Gõ vài ký tự đầu, edge_ngram trả gợi ý ngay:
- "ela" → elastic stack, elasticsearch (took 0ms)
- "kub" → kubernetes · "log" → logstash
Phản hồi gần như tức thì (0ms) vì token tiền tố đã có sẵn trong index — không tính toán gì lúc tìm. Đây là điều fuzzy không làm tốt cho autocomplete: fuzzy tính Levenshtein mỗi lần gõ phím sẽ tốn hơn nhiều.
Đánh đổi cần cân nhắc
edge_ngram index lớn hơn nhiều — đo được ~5 lần. Index edge_ngram của trường name chiếm 399 byte, còn trường standard (name.std) chỉ 82 byte — gấp gần 5 lần, vì edge_ngram lưu mọi tiền tố của mọi từ. Với từ điển lớn, đây là cái giá đáng kể về đĩa và RAM. Đổi lại là tốc độ tìm 0ms. Đánh đổi cổ điển: trả trước lúc index để nhanh lúc tìm. Autocomplete cần phản hồi tức thì mỗi lần gõ phím, nên edge_ngram đáng giá; nếu chỉ thỉnh thoảng chịu lỗi gõ sai, fuzzy (không tốn index) là đủ.
Fuzzy tốn khi tìm và có thể trả kết quả nhiễu. Mỗi fuzzy query phải mở rộng từ gõ vào thành nhiều biến thể (trong khoảng Levenshtein) rồi tra từng cái — tốn hơn match thường, và trên trường cardinality cao có thể chậm. Fuzziness cao hơn mở rộng nhiều hơn nữa, vừa chậm vừa dễ trả về từ không liên quan (hai từ khác nghĩa chỉ cách nhau 2 ký tự). Dùng AUTO và giới hạn max_expansions để kiểm soát; đừng đặt fuzziness cao "cho chắc".
Wildcard không phải công cụ cho hai bài này. *elastic* cũng tìm gần đúng, nhưng như bài 1 đã đo, leading-wildcard phải quét toàn bộ term dictionary — chậm ở quy mô lớn. Đừng dùng wildcard cho autocomplete (dùng edge_ngram) hay cho chịu lỗi gõ sai (dùng fuzzy). Wildcard chỉ hợp cho các mẫu khớp đặc thù mà hai công cụ kia không phủ, và luôn tránh dấu sao ở đầu.
Ba ý mang về
- Fuzzy chịu lỗi gõ sai bằng khoảng cách Levenshtein, tính lúc truy vấn. Đo thật: "elasticsrch", "kubernets", "kibanna" đều ra từ đúng với fuzziness AUTO; không có fuzziness thì gõ sai cho 0 kết quả. fuzziness là trần số phép sửa: 2 lỗi cần fuzziness≥2.
- Autocomplete dùng edge_ngram, chuẩn bị tiền tố lúc index, tìm 0ms. Đo thật: gõ "ela" ra gợi ý ngay trong 0ms vì token tiền tố đã lưu sẵn. Nhớ đặt search_analyzer=standard để chuỗi tìm không bị cắt n-gram.
- Đánh đổi index vs tốc độ tìm. Đo thật: edge_ngram index 399b vs standard 82b (~5 lần lớn hơn) nhưng tìm tức thì; fuzzy rẻ về index nhưng tốn khi tìm và dễ nhiễu nếu fuzziness cao. Chọn edge_ngram cho autocomplete gõ-phím, fuzzy cho chịu lỗi thỉnh thoảng; tránh wildcard cho cả hai.
Nguồn
- Elasticsearch docs — Fuzzy query, fuzziness: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-dsl-fuzzy-query.html
- Elasticsearch docs — Edge n-gram tokenizer (autocomplete): https://www.elastic.co/guide/en/elasticsearch/reference/current/analysis-edgengram-tokenizer.html
- Elasticsearch docs — Search as you type: https://www.elastic.co/guide/en/elasticsearch/reference/current/search-as-you-type.html
Phần sau là bài tổng kết cả loạt: khi nào nên dùng Elasticsearch, khi nào không, và một checklist thực chiến nối tất cả số liệu đã đo thành khung quyết định cho kỹ sư backend.
