Khi tạo một index Elasticsearch, có một tham số bạn đặt một lần rồi không đổi được: number_of_shards. Đặt sai nó, và bạn hoặc lãng phí tài nguyên (quá nhiều shard nhỏ), hoặc không scale được (quá ít shard khổng lồ) — và sửa thì phải reindex toàn bộ. Đây là quyết định kiến trúc cốt lõi của ES, nhưng nhiều người đặt đại một con số mà không hiểu nó ảnh hưởng gì.
Bài này (phần 10 loạt Elasticsearch) mổ xẻ shard và replica — hai khái niệm nền tảng của tính phân tán — đo thật tác động của số shard lên tốc độ nạp, và trung thực về việc replica không hoạt động trên lab một node.
Shard và replica là gì
Shard là một mảnh của index. Mỗi index được chia thành N shard, và mỗi shard là một index Lucene đầy đủ, tự tìm kiếm được. Document được băm theo _id rồi rải đều vào các shard. Khi tìm kiếm, ES chạy song song trên mọi shard rồi gộp kết quả — và khi nạp, các shard cũng ghi song song (dùng nhiều core).
Replica là bản sao của một shard, đặt trên node khác. Nó phục vụ hai mục đích: (1) chịu lỗi (node chứa primary chết, replica lên thay), và (2) tăng thông lượng đọc (truy vấn chia cho cả primary lẫn replica).
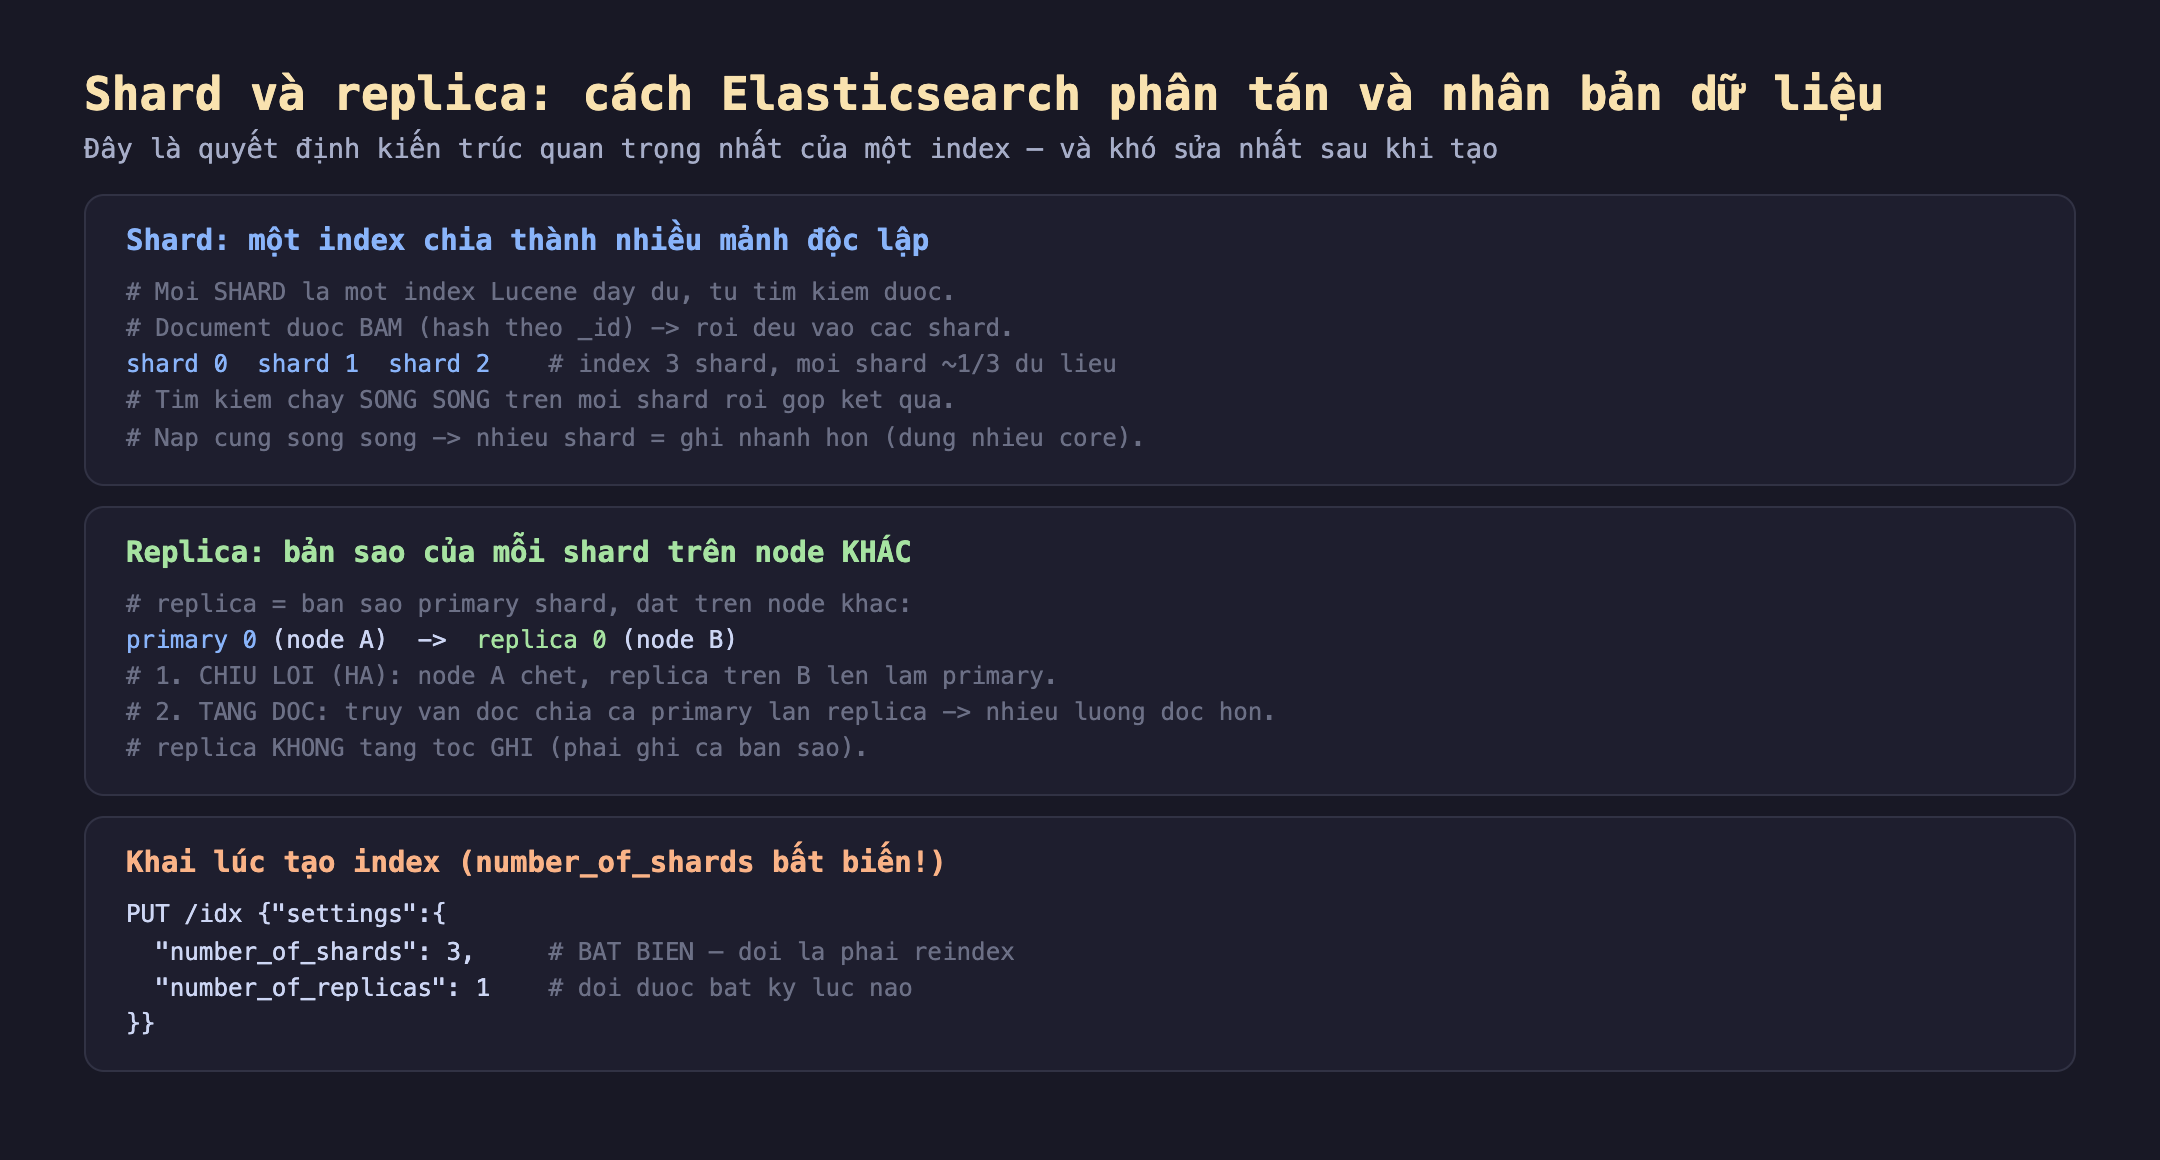
Hình 1: Shard = mảnh index (Lucene index đầy đủ), document băm rải đều vào các shard, tìm kiếm/nạp chạy song song. Replica = bản sao trên node khác, cho chịu lỗi (HA) và tăng đọc. number_of_shards bất biến; number_of_replicas đổi được.
PUT /idx
{
  "settings": {
    "number_of_shards": 3,     # BAT BIEN — doi la phai reindex
    "number_of_replicas": 1    # doi duoc bat ky luc nao
  }
}
Đo thật: số shard ảnh hưởng tốc độ nạp
Mình nạp cùng 200.000 tài liệu vào index với 1, 3, 6 shard (single-node, 0 replica), đo thời gian. Kết quả thật từ es-lab:
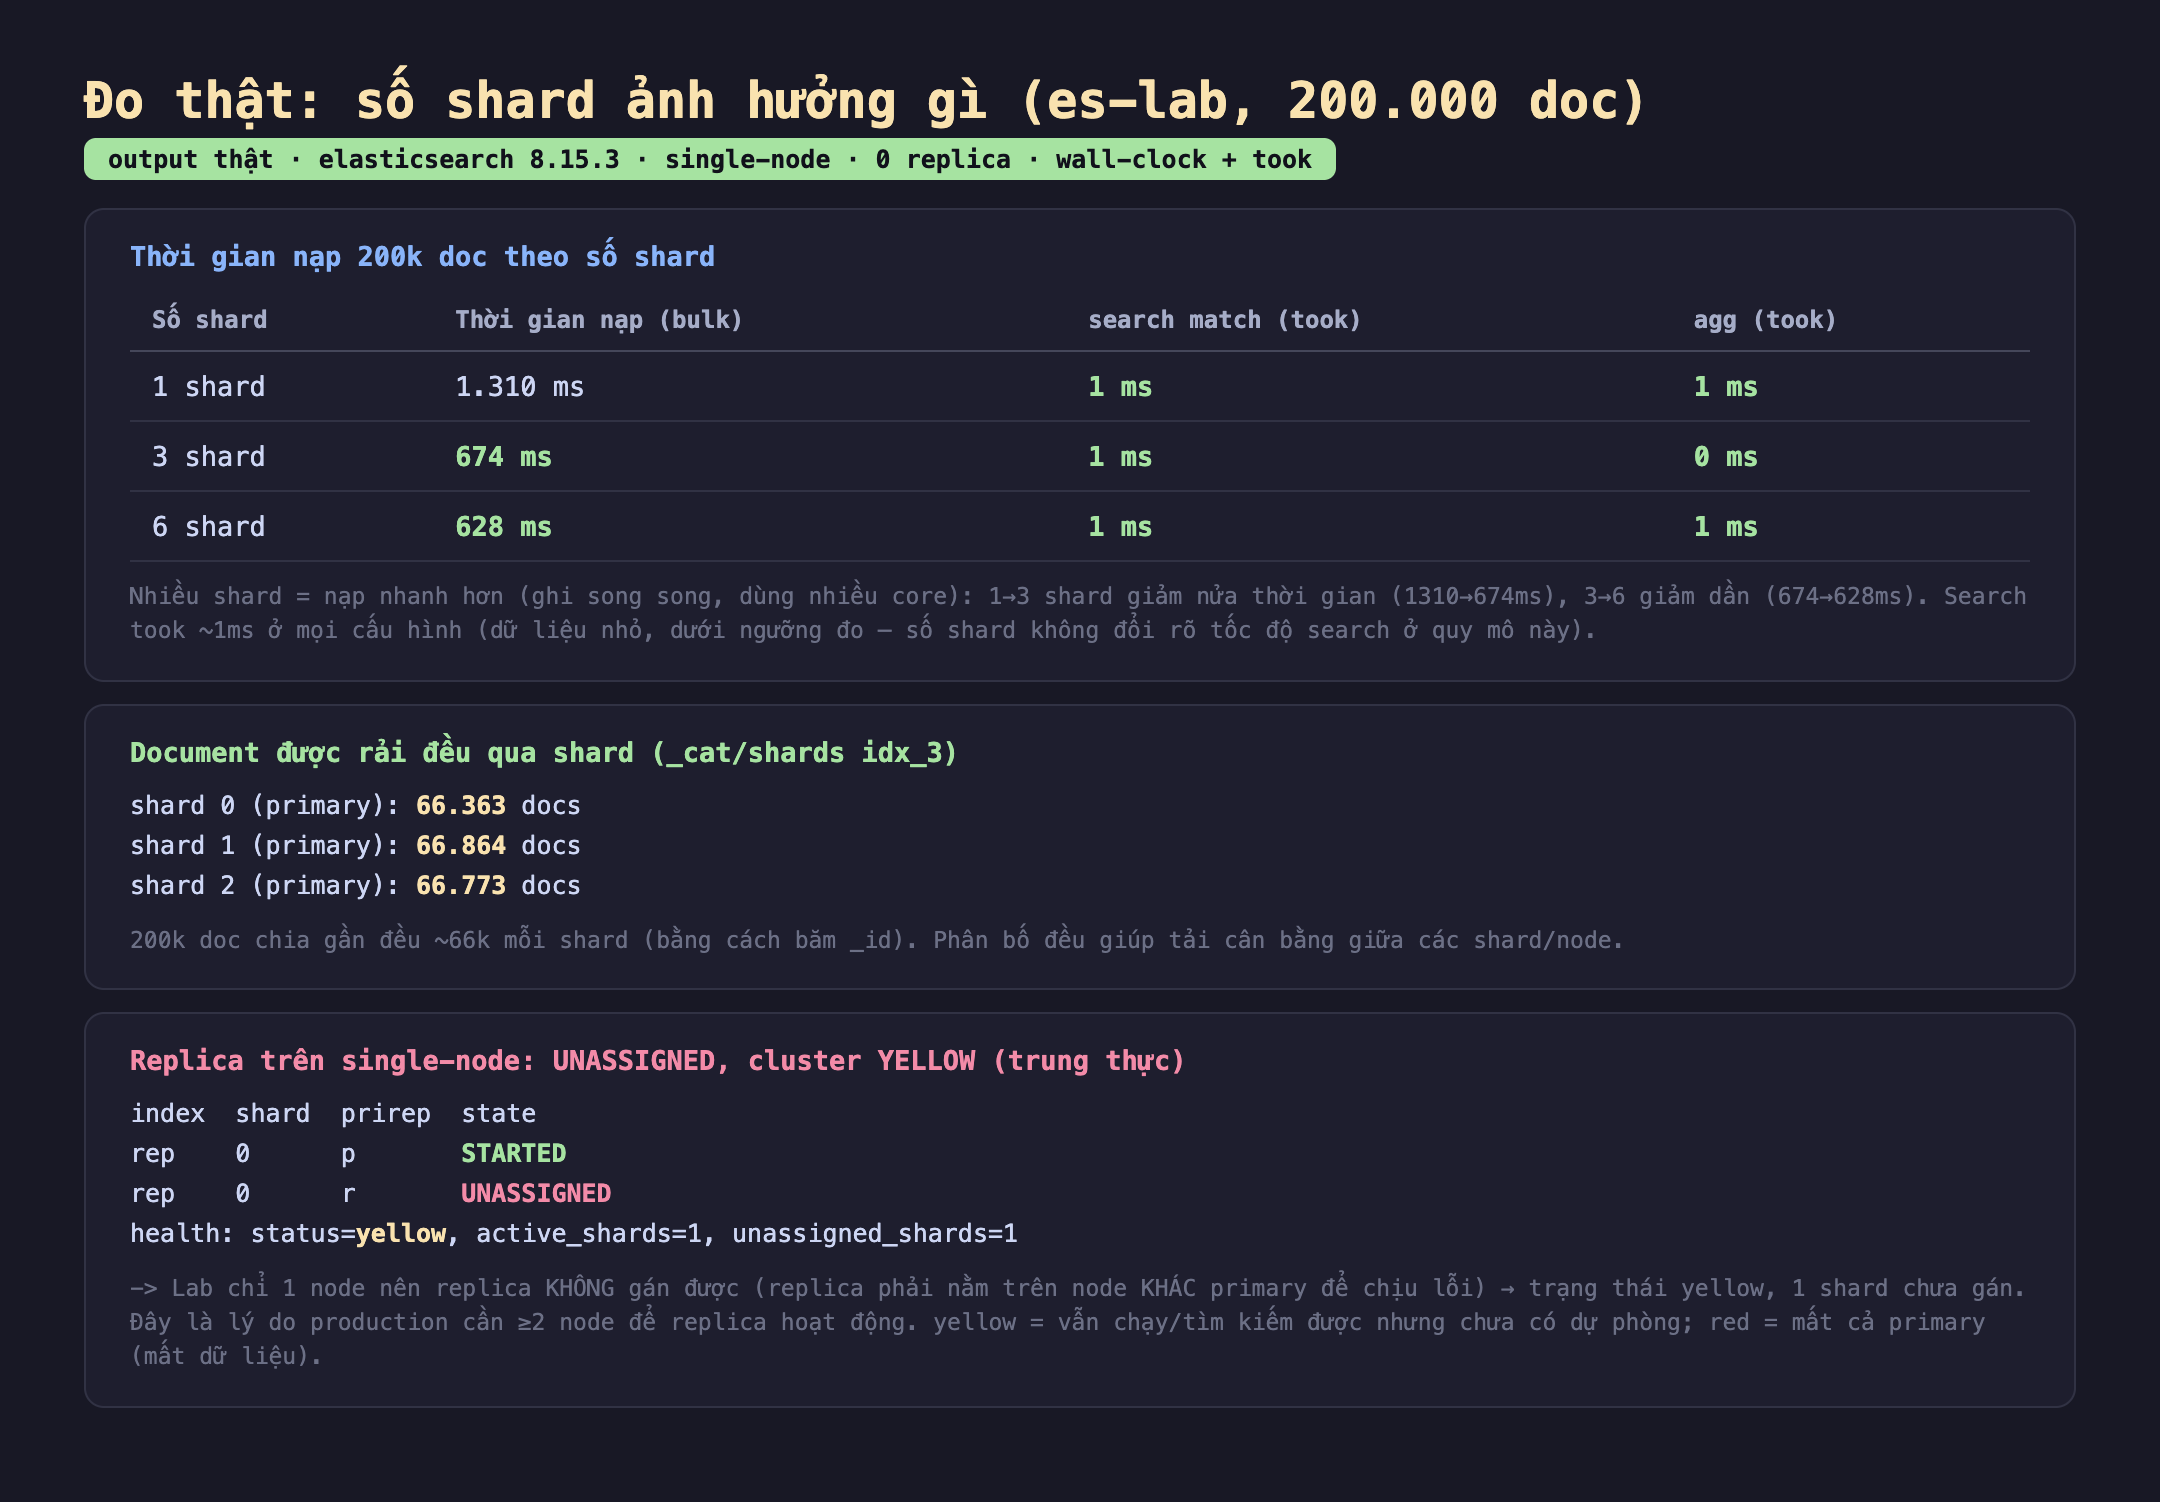
Hình 2: Kết quả thật. Nạp 200k doc: 1 shard 1.310ms, 3 shard 674ms (giảm nửa nhờ ghi song song), 6 shard 628ms (giảm dần). Document rải đều ~66k mỗi shard. Replica trên single-node UNASSIGNED, cluster yellow.
- Nhiều shard = nạp nhanh hơn: 1 shard mất 1.310ms, 3 shard chỉ 674ms (giảm nửa), 6 shard 628ms. Vì các shard ghi song song trên nhiều core — 3 shard dùng 3 luồng ghi. Nhưng lợi ích giảm dần: 1→3 giảm một nửa, 3→6 chỉ thêm chút (674→628) vì máy đã bão hòa core và mỗi shard có chi phí cố định.
- search took ~1ms ở mọi cấu hình: ở quy mô dữ liệu nhỏ này, thời gian search dưới ngưỡng đo được — số shard không thay đổi rõ tốc độ search. (Trên dữ liệu lớn hơn, nhiều shard giúp search song song, nhưng cũng tốn chi phí gộp kết quả — không phải cứ nhiều là nhanh.)
- Document rải đều: idx_3 có 3 primary shard với ~66.363 / 66.864 / 66.773 document — gần như đều tuyệt đối, nhờ băm
_id. Phân bố đều giúp tải cân bằng giữa các shard/node.
Trung thực: replica không hoạt động trên lab một node
Khi mình tạo index với number_of_replicas: 1 trên es-lab (chỉ một node), _cat/shards cho thấy: primary shard STARTED, nhưng replica shard UNASSIGNED, và cluster health là yellow với unassigned_shards: 1.
Lý do rất quan trọng để hiểu: replica phải nằm trên node khác primary — nếu đặt cùng node, node đó chết thì mất cả hai, replica vô nghĩa. Lab chỉ một node nên không có chỗ đặt replica → nó treo ở trạng thái UNASSIGNED. Đây là lý do mọi cluster production cần ít nhất 2 node để replica hoạt động và có tính sẵn sàng cao.
Ba màu trạng thái cluster: green (mọi shard, kể cả replica, đã gán), yellow (primary OK nhưng vài replica chưa gán — vẫn chạy/tìm kiếm bình thường, chỉ thiếu dự phòng), red (có primary shard chưa gán — mất một phần dữ liệu, truy vấn có thể thiếu kết quả). Lab yellow là bình thường cho một node; production yellow kéo dài là dấu hiệu thiếu node/thiếu chỗ cho replica.
Đánh đổi cần cân nhắc
Over-sharding (quá nhiều shard nhỏ) tốn tài nguyên hơn là giúp. Mỗi shard có chi phí cố định: bộ nhớ heap cho metadata, file handle, overhead khi gộp kết quả truy vấn. Một cluster với hàng nghìn shard tí hon (mỗi shard vài MB) lãng phí heap và làm chậm mọi thao tác quản lý. Khuyến nghị của Elastic: mỗi shard nên khoảng 10-50 GB, và số shard mỗi node tỉ lệ với heap (thường <20 shard mỗi GB heap). Đừng tạo 50 shard cho một index 1 GB "cho chắc".
Oversized shards (shard quá lớn) cũng có vấn đề. Ngược lại, shard quá lớn (>50 GB) làm phục hồi chậm (khi di chuyển/khôi phục phải copy cả shard khổng lồ), rebalance cluster lâu, và một shard không thể chia nhỏ để chạy song song hơn. Cân bằng là chọn số shard sao cho mỗi shard rơi vào khoảng 10-50 GB khi index đạt kích thước dự kiến. Vì shard bất biến, phải ước lượng tăng trưởng khi tạo index — hoặc dùng data stream / rollover cho dữ liệu time-series tăng liên tục.
Replica đánh đổi tài nguyên lấy an toàn và đọc. Mỗi replica nhân đôi dung lượng đĩa và làm chậm ghi (phải ghi cả bản sao). Đổi lại được chịu lỗi và tăng thông lượng đọc. Với dữ liệu quan trọng đang phục vụ, ít nhất 1 replica là bắt buộc. Nhưng khi nạp hàng loạt lần đầu (bài 8), tạm đặt number_of_replicas: 0 để nạp nhanh rồi bật lên sau — đó là mẹo tối ưu đã nhắc ở bài bulk.
Ba ý mang về
- Nhiều shard = nạp nhanh hơn nhờ ghi song song, nhưng giảm dần. Đo thật: nạp 200k doc với 1 shard 1.310ms, 3 shard 674ms (giảm nửa), 6 shard 628ms. Document băm rải đều ~66k mỗi shard. Số shard là bất biến — chọn sai phải reindex.
- Replica cần nhiều node; trên single-node nó UNASSIGNED. Đo thật: tạo replica trên lab một node cho trạng thái yellow, replica UNASSIGNED, vì replica phải nằm trên node khác primary để chịu lỗi. Production cần ≥2 node. yellow = chạy được nhưng thiếu dự phòng; red = mất primary (mất dữ liệu).
- Cân bằng số shard: không quá nhỏ, không quá lớn. Mỗi shard nên ~10-50 GB; over-sharding (nghìn shard tí hon) tốn heap, oversized shard làm phục hồi chậm. Replica nhân đôi đĩa và làm chậm ghi, đổi lấy HA + đọc — tắt khi nạp hàng loạt, bật cho production.
Nguồn
- Elasticsearch docs — Size your shards: https://www.elastic.co/guide/en/elasticsearch/reference/current/size-your-shards.html
- Elasticsearch docs — Scalability and resilience (shards, replicas): https://www.elastic.co/guide/en/elasticsearch/reference/current/scalability.html
- Elasticsearch docs — Cluster health: https://www.elastic.co/guide/en/elasticsearch/reference/current/cluster-health.html
Phần sau ta xử lý tìm gần đúng: fuzzy query chịu lỗi gõ sai, wildcard, và edge_ngram cho autocomplete — đo thật khả năng tìm "elasticsrch" vẫn ra "elasticsearch" và chi phí đánh đổi.
