Phân trang nghe đơn giản: "cho tôi 20 kết quả, trang thứ 500". Trong SQL bạn viết LIMIT 20 OFFSET 9980 và xong. Nhiều người mang thẳng tư duy đó sang Elasticsearch bằng from: 9980, size: 20 — và sớm muộn gặp một lỗi khó hiểu: "Result window is too large". Hóa ra phân trang trong hệ phân tán khó hơn nhiều, và cách làm "tự nhiên" (offset) là một cạm bẫy hiệu năng được thiết kế để chặn bạn lại trước khi nó làm sập cluster.
Bài này (phần 9 loạt Elasticsearch) đo thật ba cách phân trang — from/size, search_after, scroll — trên 500.000 bản ghi ở es-lab, và chỉ ra khi nào dùng cái nào.
Vì sao from/size đắt khi lật sâu
Elasticsearch phân tán dữ liệu qua nhiều shard. Để trả về trang ở from=9980, size=20 đã sắp xếp, nó không thể chỉ "nhảy tới vị trí 9980" — vì mỗi shard giữ một phần dữ liệu và không biết trước phần tử thứ 9980 toàn cục nằm ở shard nào. Nên mỗi shard phải trả về from+size = 10000 kết quả đầu đã sắp, gửi hết về node điều phối (coordinator), node này trộn lại rồi bỏ đi 9980 cái đầu để lấy 20. Càng lật sâu, mỗi shard càng phải gom nhiều, và càng nhiều kết quả bị gom rồi bỏ.
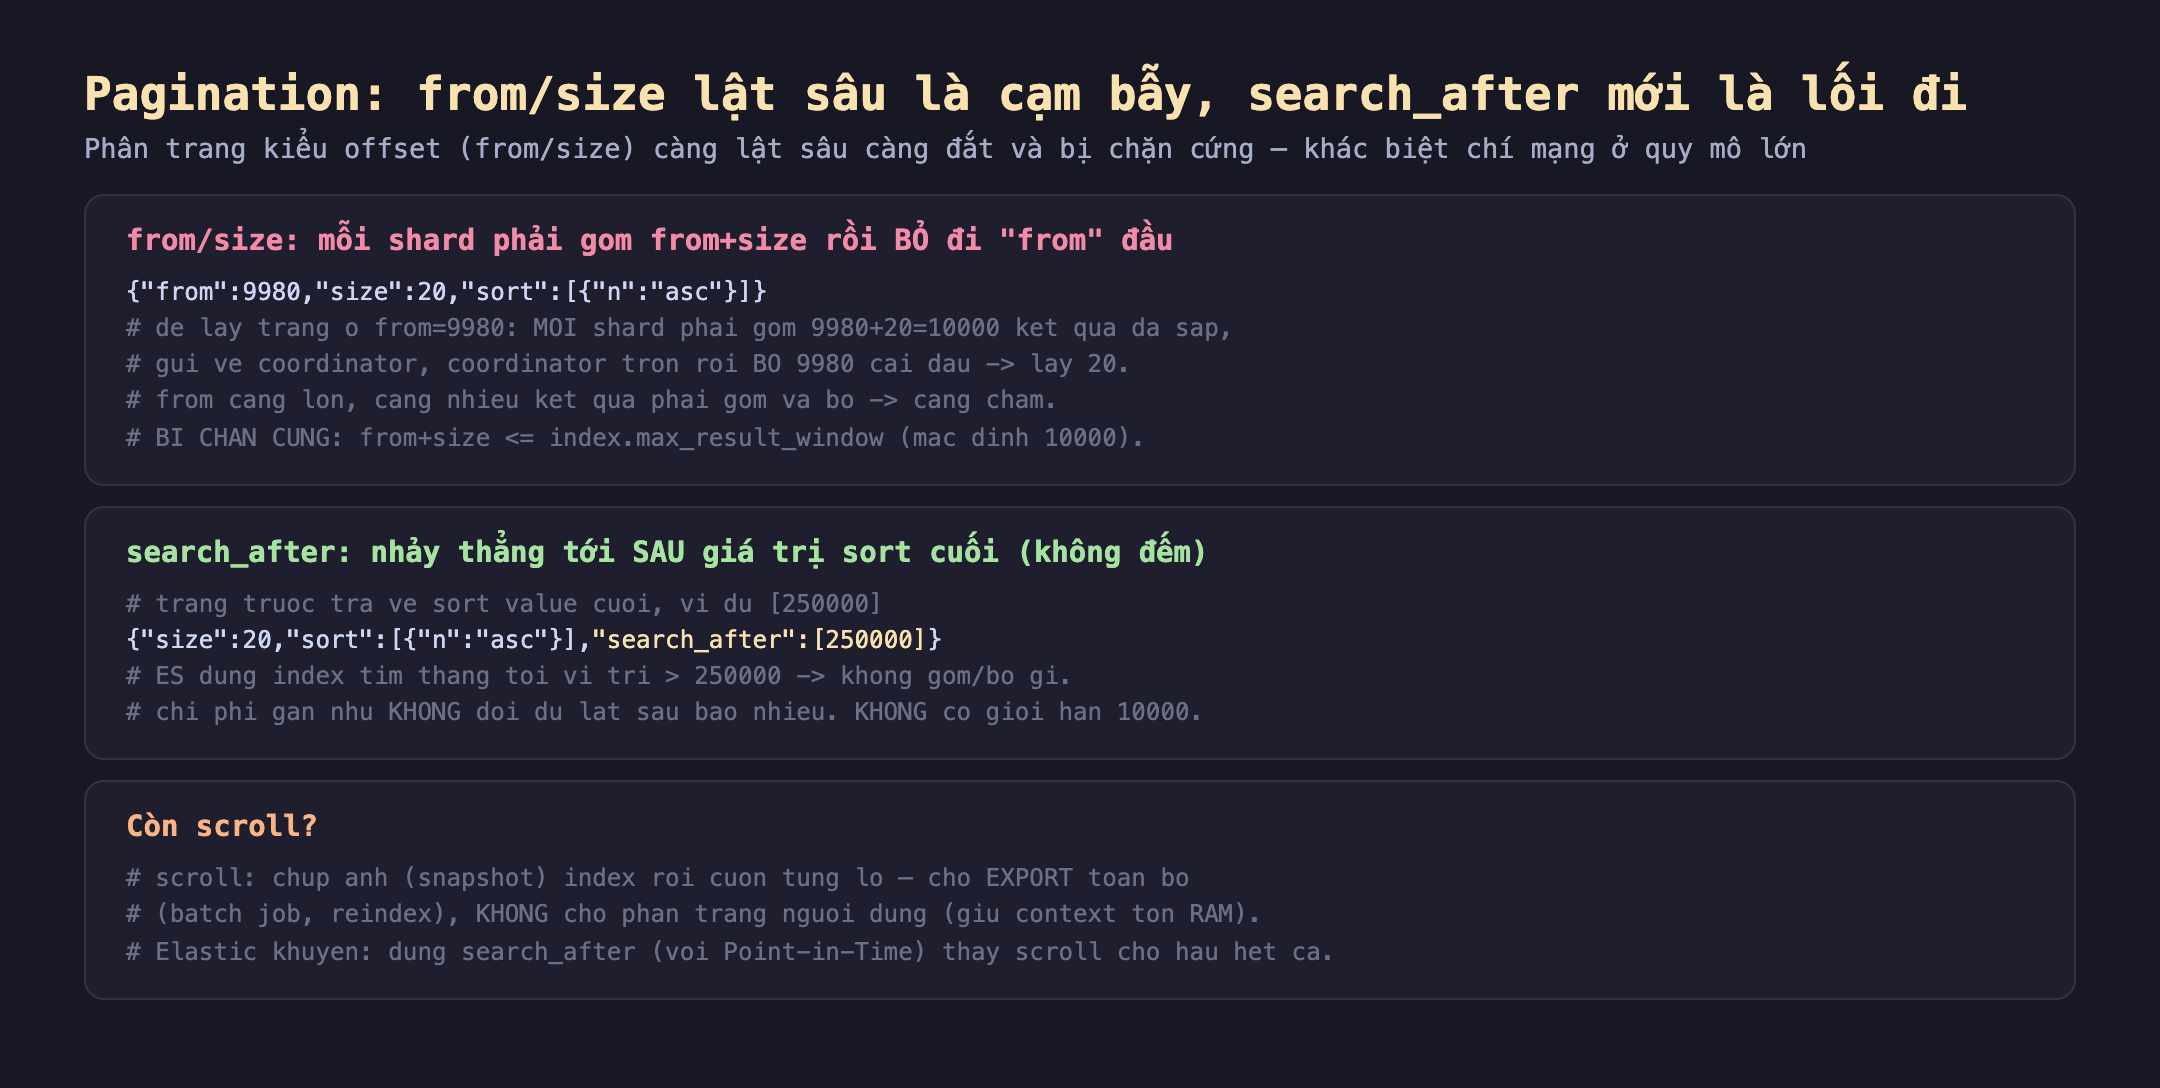
Hình 1: from/size — mỗi shard gom from+size rồi coordinator bỏ đi from đầu (đắt dần, chặn ở 10.000). search_after — seek thẳng tới sau giá trị sort cuối (không đếm, không giới hạn). scroll — snapshot để export toàn bộ.
# from/size: don gian nhung dat khi sau, bi chan o 10000
{"from":9980,"size":20,"sort":[{"n":"asc"}]}

# search_after: trang truoc tra ve sort value cuoi, dua lai de lay trang sau
{"size":20,"sort":[{"n":"asc"}],"search_after":[250000]}
Đo thật: from/size tăng dần rồi báo lỗi
Mình nạp 500.000 bản ghi (3 shard) rồi đo took của from/size ở các độ sâu khác nhau (warm cache). Kết quả thật:
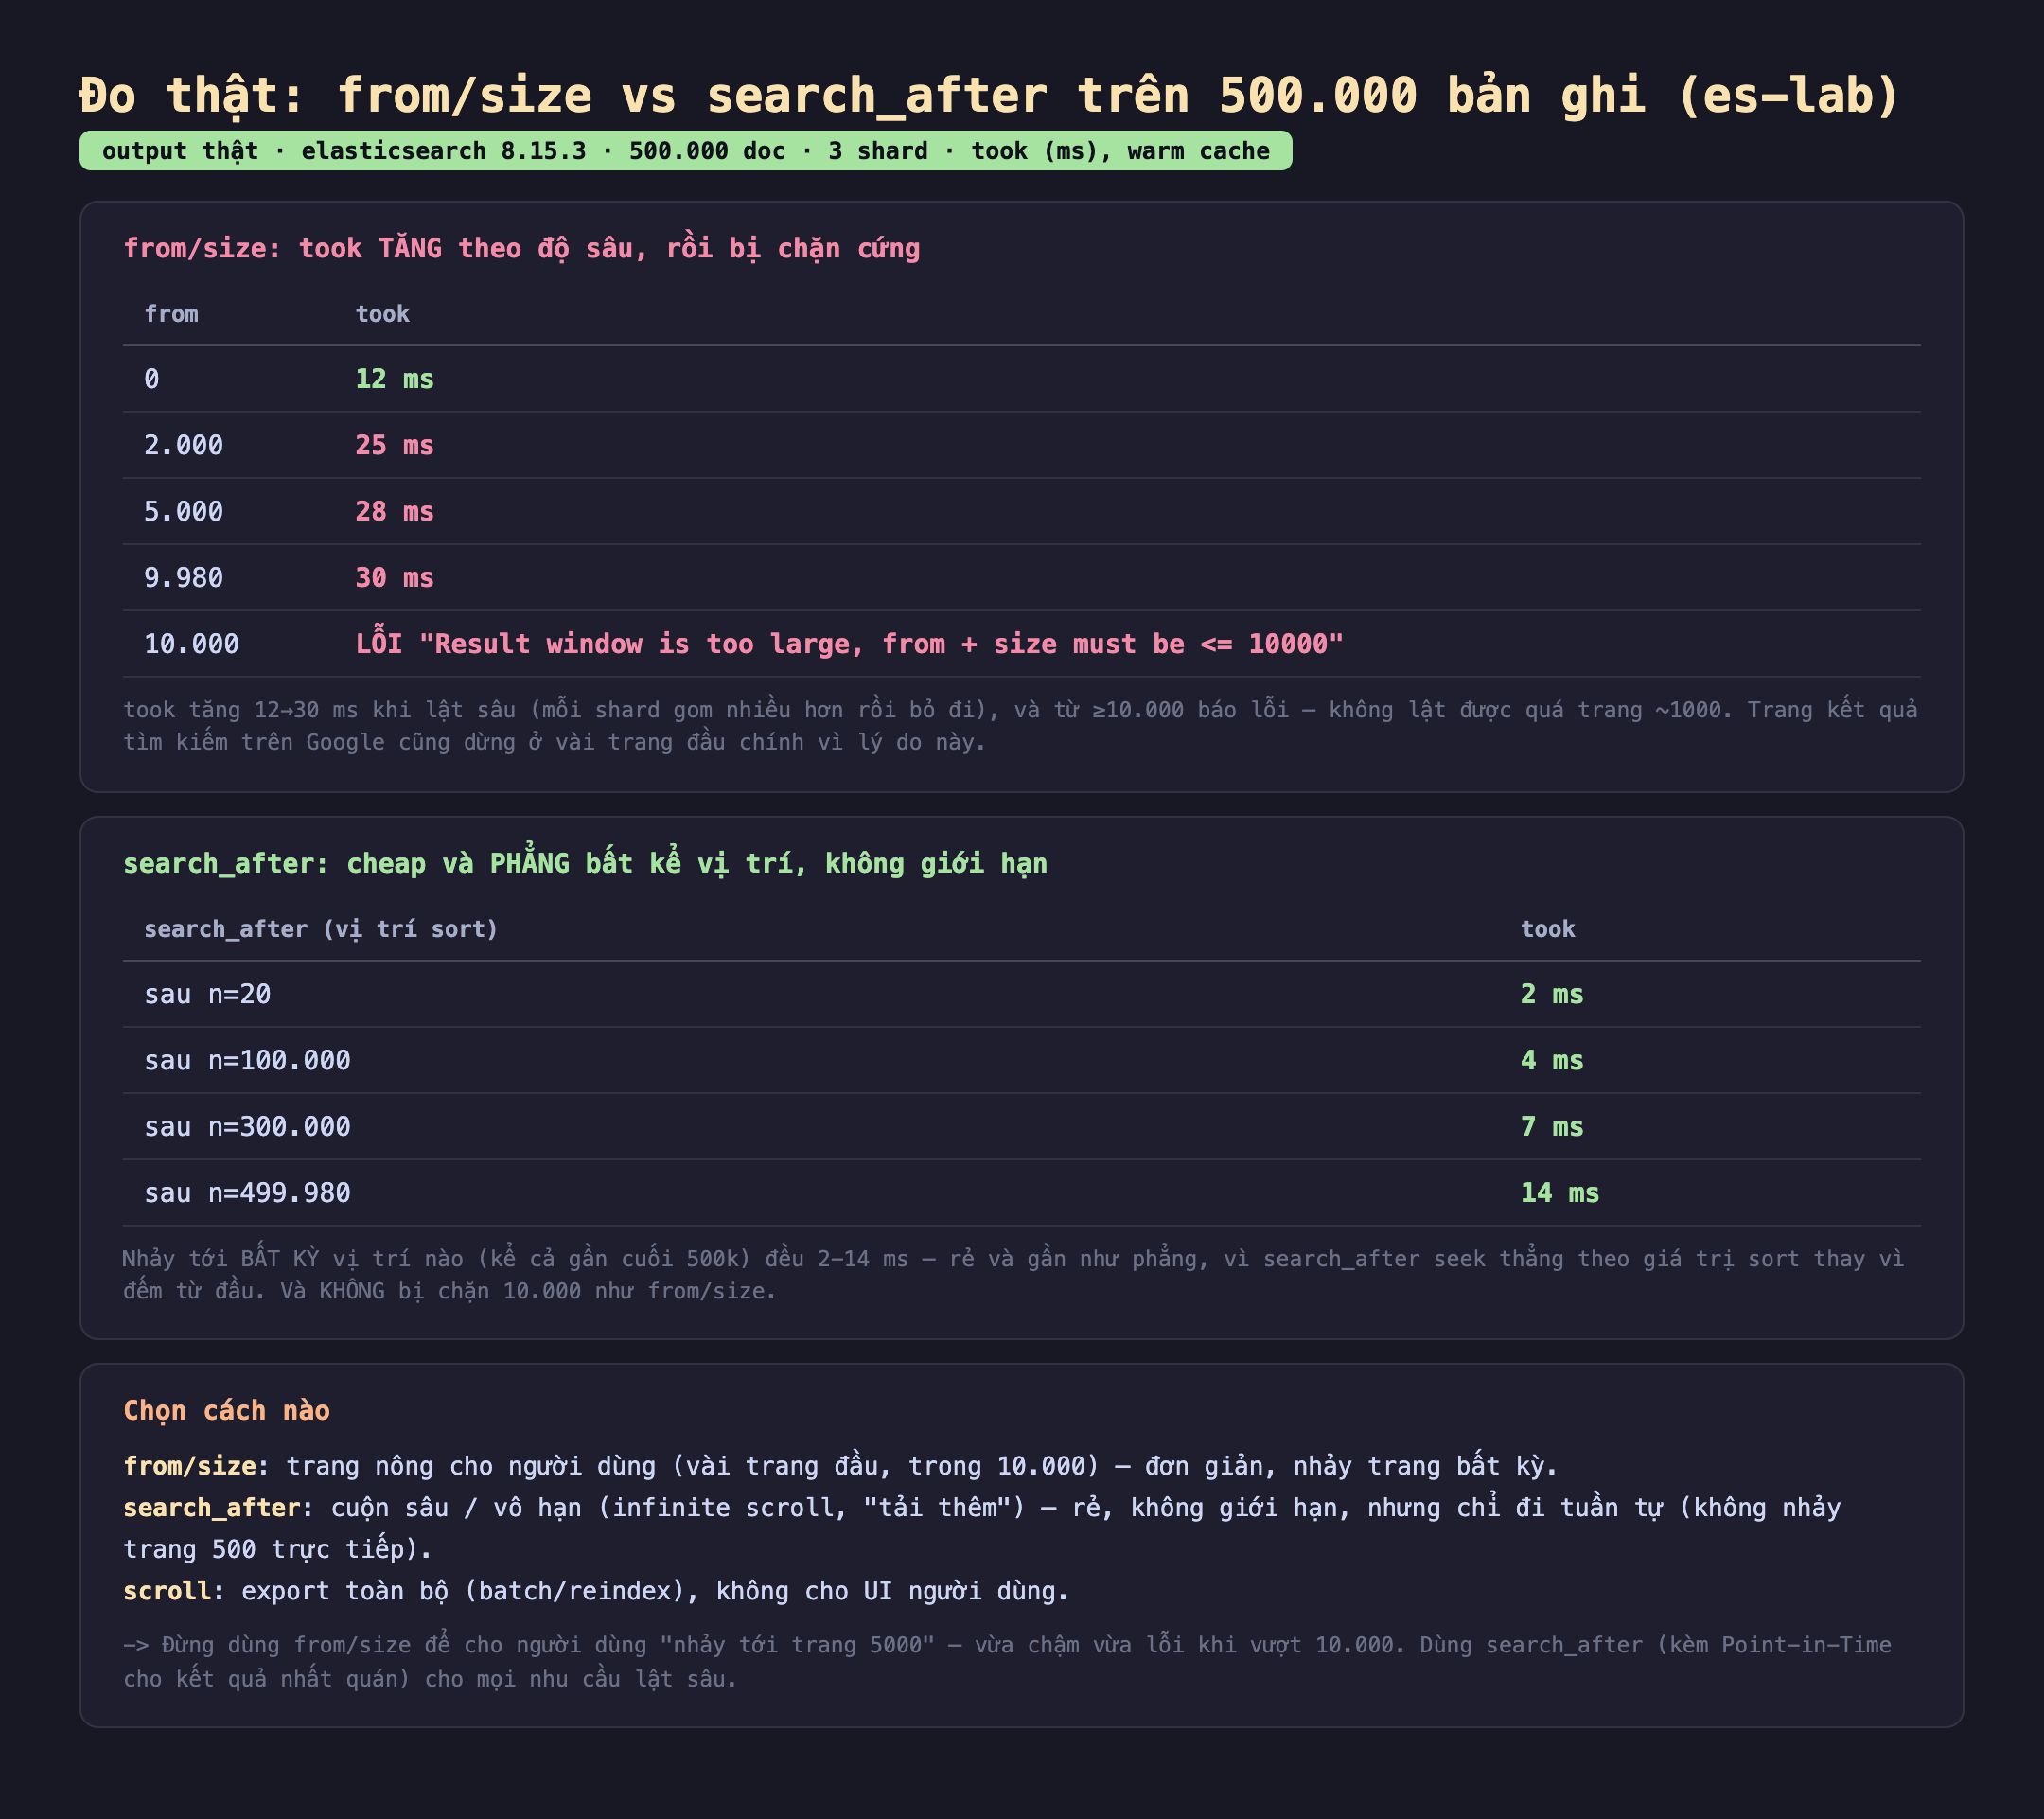
Hình 2: Kết quả thật. from/size tăng 12→30ms khi lật sâu và báo lỗi ở from=10.000. search_after nhảy tới bất kỳ vị trí nào (kể cả gần cuối 500k) chỉ 2-14ms và không giới hạn.
- from/size tăng theo độ sâu: 12ms (from=0) → 25ms → 28ms → 30ms (from=9.980). Chi phí tăng ~2,5 lần vì mỗi shard phải gom ngày càng nhiều rồi bỏ đi.
- from=10.000 → LỖI:
"Result window is too large, from + size must be <= 10000". Đây là giới hạnindex.max_result_window(mặc định 10.000). ES cố tình chặn để một truy vấn deep-paging không ngốn hết heap của cả cluster. Nghĩa là với from/size, bạn không lật được quá ~trang 1000.
Đây là lý do kết quả tìm kiếm Google cũng dừng ở vài trang đầu, và hầu hết UI tốt chỉ cho lật vài chục trang — deep paging bằng offset vừa đắt vừa bị chặn.
Đo thật: search_after phẳng và không giới hạn
search_after giải bài toán khác hẳn: thay vì đếm từ đầu, nó dùng giá trị sort của phần tử cuối trang trước để seek thẳng. Mình nhảy tới nhiều vị trí khác nhau trên cùng 500k bản ghi:
- sau n=20: 2ms · sau n=100.000: 4ms · sau n=300.000: 7ms · sau n=499.980: 14ms
Nhảy tới bất kỳ vị trí nào — kể cả gần cuối tập 500.000 — đều chỉ 2-14ms, rẻ và gần như phẳng. Vì search_after dùng index để tìm thẳng tới vị trí > giá trị sort, nó không gom và bỏ gì cả. Và quan trọng: nó không bị chặn 10.000 — bạn cuộn được qua toàn bộ dữ liệu.
Đánh đổi cần cân nhắc
search_after chỉ đi tuần tự, không nhảy trang bất kỳ. Đổi lại sự rẻ và không giới hạn, search_after đòi bạn phải có giá trị sort của trang trước để lấy trang sau — tức chỉ đi tiếp được, không "nhảy thẳng tới trang 500". Điều này hợp hoàn hảo với infinite scroll / nút "tải thêm" (mô hình UI phổ biến nhất hiện nay), nhưng không hợp với UI phân trang kiểu "nhảy tới trang N bất kỳ". Thực tế, hầu hết sản phẩm hiện đại đã bỏ phân trang nhảy-trang cho tìm kiếm sâu, chính vì giới hạn kỹ thuật này.
Dùng Point-in-Time (PIT) với search_after cho kết quả nhất quán. Nếu dữ liệu thay đổi (thêm/xóa document) trong lúc người dùng cuộn, search_after thuần có thể bỏ sót hoặc trùng kết quả. Giải pháp là mở một Point-in-Time (ảnh chụp index tại một thời điểm) rồi search_after trên đó — mọi trang thấy cùng một trạng thái dữ liệu. Đây là cách Elastic khuyến nghị cho phân trang sâu nhất quán, thay cho scroll (API cũ).
scroll chỉ cho export, không cho UI người dùng. scroll giữ một context (snapshot + con trỏ) trên server để cuộn qua toàn bộ kết quả — mạnh cho tác vụ export toàn bộ (batch job, reindex, xuất báo cáo). Nhưng mỗi scroll context tốn RAM và tồn tại cho tới khi hết hạn, nên không dùng cho phân trang người dùng (hàng nghìn người cuộn cùng lúc = hàng nghìn context = sập). Với tác vụ export mới, Elastic cũng khuyến nghị search_after + PIT thay scroll trong hầu hết trường hợp.
Ba ý mang về
- from/size đắt khi lật sâu và bị chặn cứng ở 10.000. Đo thật: từ 12ms (from=0) tăng lên 30ms (from=9.980), rồi from=10.000 báo lỗi "Result window is too large". Mỗi shard phải gom from+size rồi coordinator bỏ đi from đầu — không lật được quá ~trang 1000. Chỉ dùng from/size cho trang nông.
- search_after rẻ, phẳng và không giới hạn. Đo thật: nhảy tới bất kỳ vị trí nào trong 500k bản ghi (kể cả gần cuối) chỉ 2-14ms, vì nó seek thẳng theo giá trị sort thay vì đếm từ đầu. Đây là lối đi đúng cho cuộn sâu / infinite scroll.
- Chọn đúng công cụ: from/size nông, search_after sâu, scroll export. search_after chỉ đi tuần tự (không nhảy trang bất kỳ) nên hợp "tải thêm"; dùng kèm Point-in-Time cho kết quả nhất quán khi dữ liệu đổi; scroll chỉ cho export toàn bộ (batch/reindex), không cho UI người dùng.
Nguồn
- Elasticsearch docs — Paginate search results (from/size, search_after): https://www.elastic.co/guide/en/elasticsearch/reference/current/paginate-search-results.html
- Elasticsearch docs — Point in time API: https://www.elastic.co/guide/en/elasticsearch/reference/current/point-in-time-api.html
- Elasticsearch docs — index.max_result_window: https://www.elastic.co/guide/en/elasticsearch/reference/current/index-modules.html
Phần sau ta mổ xẻ shard và replica: dữ liệu phân tán thế nào, số shard ảnh hưởng tốc độ index và search ra sao, và đo thật tác động của việc chọn số shard — yếu tố kiến trúc quan trọng nhất của một cluster Elasticsearch.
