Bạn có một triệu bản ghi cần đưa vào Elasticsearch. Cách tự nhiên nhất — vòng lặp, mỗi bản ghi một lời gọi POST /_doc — là cách sai và sai nghiêm trọng. Đây là một trong những cái bẫy hiệu năng phổ biến nhất khi làm việc với ES: nạp dữ liệu từng document một chậm đến mức biến một công việc 30 giây thành nhiều giờ.
Giải pháp là _bulk API — gộp nhiều thao tác vào một request. Bài này (phần 8 loạt Elasticsearch) đo thật khoảng cách giữa hai cách, và đo luôn một câu hỏi thực tế: lô bao nhiêu document một request thì tối ưu? Mọi con số dưới đây đo bằng đồng hồ thật trên es-lab.
Vì sao từng-cái chậm, bulk nhanh
Khi bạn index từng document, mỗi lần là một chu trình đầy đủ: mở kết nối HTTP, gửi request qua mạng, ES phân tích và định tuyến, ghi, trả response. Chi phí cố định đó (round-trip mạng, phân tích) nhỏ với một document, nhưng nhân lên nghìn lần khi nạp nghìn document.
_bulk gộp nhiều thao tác vào một request bằng định dạng NDJSON (mỗi dòng một JSON): một dòng metadata (action), một dòng document, lặp lại. Cả nghìn document đi trong một round-trip, ES xử lý cả lô cùng nhau.
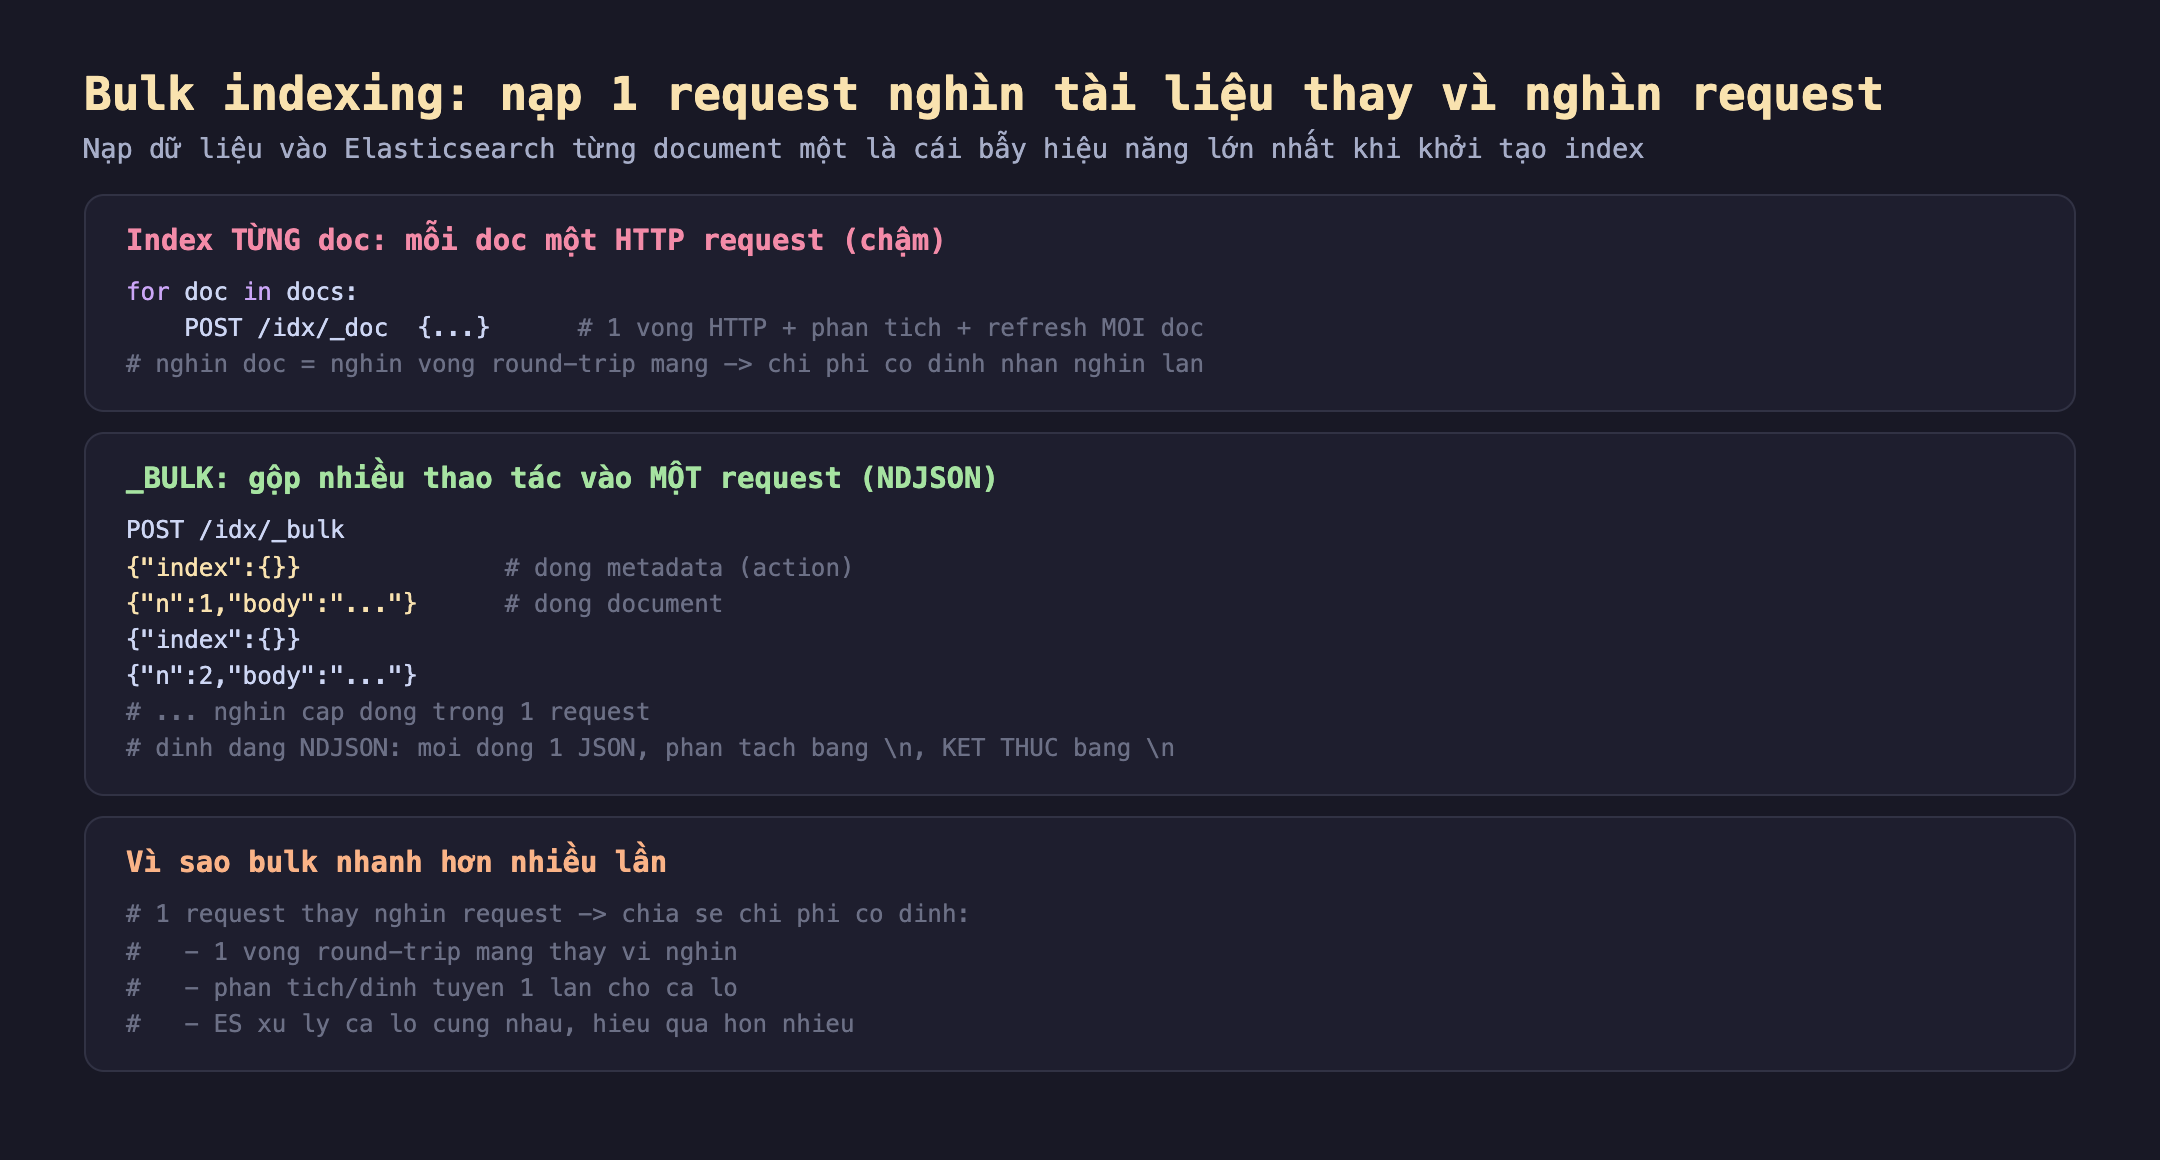
Hình 1: Index từng doc = mỗi doc một round-trip HTTP (chi phí cố định nhân nghìn lần). _bulk = gộp nghìn doc vào một request NDJSON, chia sẻ chi phí cố định — một round-trip thay vì nghìn.
# _bulk: dinh dang NDJSON — moi dong 1 JSON, KET THUC bang \n
curl -XPOST localhost:9200/idx/_bulk -H 'Content-Type: application/x-ndjson' --data-binary '
{"index":{}}
{"n":1,"body":"..."}
{"index":{}}
{"n":2,"body":"..."}
'
Đo thật: từng cái vs bulk
Mình nạp cùng 2000 tài liệu bằng hai cách, đo bằng đồng hồ thật trên es-lab. Kết quả:
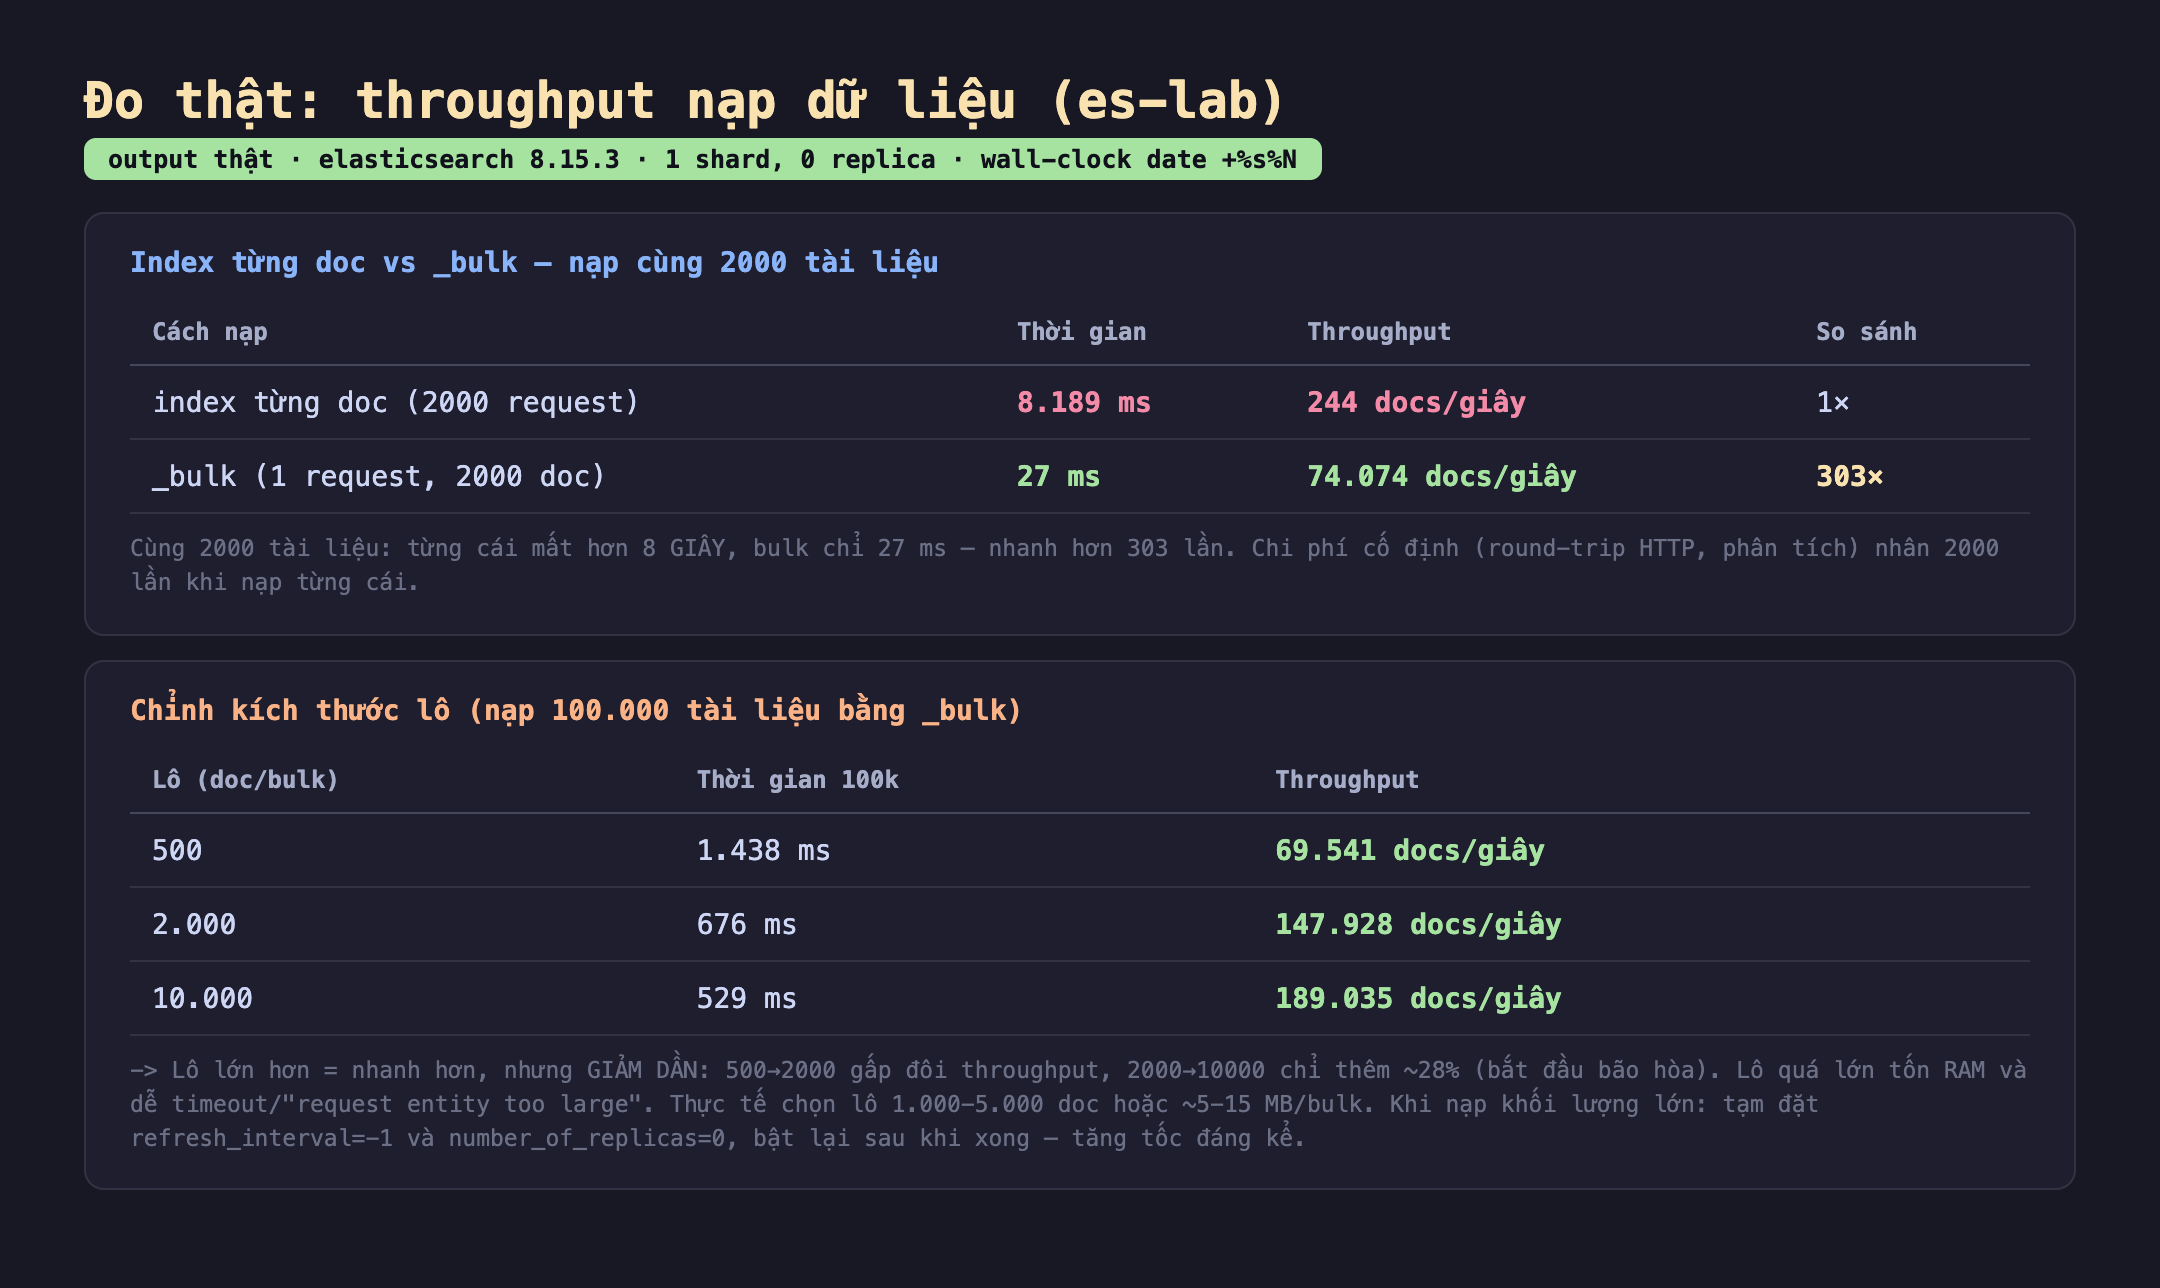
Hình 2: Kết quả thật. Nạp 2000 tài liệu từng cái mất 8,2 giây (244 docs/giây); _bulk một request chỉ 27ms (74.074 docs/giây) — nhanh hơn 303 lần. Lô lớn hơn nhanh hơn nhưng giảm dần: 69k → 148k → 189k docs/giây.
- Index từng doc: 244 docs/giây. 2000 request mất 8.189 ms — hơn 8 giây cho 2000 tài liệu bé xíu. Phần lớn thời gian là chờ round-trip, không phải ghi.
- _bulk một request: 74.074 docs/giây. Cùng 2000 tài liệu, chỉ 27 ms — nhanh hơn 303 lần. Khác biệt hoàn toàn đến từ việc bỏ 1999 round-trip thừa.
Hãy ngoại suy: với 1 triệu tài liệu, nạp từng cái ở tốc độ này mất ~68 phút; bulk ở 74k docs/giây mất ~13 giây. Đó là ranh giới giữa "chạy được" và "không bao giờ xong".
Đo thật: chọn kích thước lô
Bulk nhanh, nhưng lô bao nhiêu? Mình nạp 100.000 tài liệu với các kích thước lô khác nhau:
- 500 doc/bulk: 69.541 docs/giây
- 2.000 doc/bulk: 147.928 docs/giây (gấp đôi so với lô 500)
- 10.000 doc/bulk: 189.035 docs/giây (chỉ hơn ~28% so với lô 2.000)
Rõ ràng: lô lớn hơn nhanh hơn, nhưng lợi ích giảm dần (diminishing returns). Từ 500 lên 2.000 throughput gấp đôi; từ 2.000 lên 10.000 chỉ thêm ~28% — bắt đầu bão hòa. Lý do: khi lô đủ lớn, chi phí round-trip đã được chia nhỏ đến mức không còn là nút thắt; nút thắt chuyển sang việc ES thực sự ghi và index. Tăng lô thêm nữa không giúp nhiều, mà còn gây rủi ro.
Đánh đổi cần cân nhắc
Lô quá lớn gây vấn đề — chọn 1.000-5.000 doc hoặc ~5-15 MB. Lô càng lớn càng ngốn RAM (cả client lẫn ES phải giữ cả lô trong bộ nhớ), và có thể vượt giới hạn kích thước request (http.max_content_length mặc định 100 MB → lỗi "request entity too large"), hoặc gây timeout. Khuyến nghị thực tế không phải "càng lớn càng tốt" mà là kích thước byte ~5-15 MB mỗi bulk (thường tương đương vài nghìn document), vì document to/nhỏ khác nhau. Đo trên dữ liệu thật của bạn để tìm điểm ngọt.
Khi nạp khối lượng lớn, tắt refresh và replica tạm thời. Mặc định ES refresh mỗi giây (làm document mới tìm được) và ghi ra replica — cả hai tốn công trong lúc nạp ồ ạt. Hai tinh chỉnh tăng tốc đáng kể khi nạp hàng loạt: đặt refresh_interval: -1 (tắt refresh, bật lại sau) và number_of_replicas: 0 (nạp vào primary thôi, tạo replica sau khi xong). Lab này đã dùng 0 replica. Sau khi nạp xong, bật lại cả hai. Đổi lại: trong lúc nạp, dữ liệu chưa tìm được ngay và chưa có bản sao dự phòng — chấp nhận được cho tác vụ nạp ban đầu, không cho dữ liệu production đang phục vụ.
Xử lý lỗi từng dòng trong bulk — một request thành công không nghĩa mọi doc thành công. _bulk trả về HTTP 200 ngay cả khi một số document trong lô lỗi (sai kiểu, mapping conflict). Response có trường errors: true và chi tiết từng item. Code nạp dữ liệu phải kiểm tra trường này, không chỉ mã HTTP — nếu không, bạn tưởng nạp thành công trong khi một phần dữ liệu âm thầm rớt. Đây là lỗi hay gặp trong pipeline nạp dữ liệu tự động.
Ba ý mang về
- Đừng bao giờ nạp từng document một — dùng _bulk. Đo thật: 2000 tài liệu nạp từng cái mất 8,2 giây (244 docs/giây), _bulk một request chỉ 27ms (74.074 docs/giây) — nhanh hơn 303 lần. Khác biệt đến từ việc bỏ nghìn round-trip HTTP thừa, không phải tốc độ ghi.
- Lô lớn hơn nhanh hơn nhưng giảm dần. Đo thật nạp 100k: lô 500 cho 69k docs/giây, lô 2.000 cho 148k (gấp đôi), lô 10.000 cho 189k (chỉ thêm 28% — bão hòa). Thực tế chọn 1.000-5.000 doc hoặc ~5-15 MB mỗi bulk; lô quá lớn tốn RAM và dễ "request entity too large".
- Tối ưu nạp hàng loạt: tắt refresh + replica, kiểm lỗi từng dòng.
refresh_interval: -1vànumber_of_replicas: 0khi nạp ồ ạt (bật lại sau) tăng tốc đáng kể. Và luôn kiểmerrorstrong response bulk — HTTP 200 không bảo đảm mọi document trong lô thành công.
Nguồn
- Elasticsearch docs — Bulk API: https://www.elastic.co/guide/en/elasticsearch/reference/current/docs-bulk.html
- Elasticsearch docs — Tune for indexing speed: https://www.elastic.co/guide/en/elasticsearch/reference/current/tune-for-indexing-speed.html
- Elasticsearch docs — Using bulk to index documents: https://www.elastic.co/guide/en/elasticsearch/reference/current/getting-started-index.html
Phần sau ta đo thật cạm bẫy phân trang: from/size chậm dần khi lật sâu (deep paging), và vì sao search_after rẻ hơn hẳn cho cuộn qua lượng lớn kết quả.
