Mapping là schema của một index Elasticsearch — nó định nghĩa mỗi trường thuộc kiểu gì (text, keyword, số, ngày...). Và không như SQL nơi bạn buộc phải khai schema trước, ES tử tế đến mức nguy hiểm: nó tự đoán kiểu khi gặp dữ liệu mới (dynamic mapping). Sự tiện lợi này là con dao hai lưỡi — nó đoán sai một kiểu, và bạn chỉ phát hiện ra sau này khi sort, agg, hay range cho kết quả sai hoặc báo lỗi, lúc dữ liệu đã nạp đầy.
Bài này (phần 7 loạt Elasticsearch) mổ xẻ quyết định mapping quan trọng nhất — text vs keyword — và chỉ ra ba cạm bẫy đo được thật trên es-lab mà gần như ai dùng ES cũng vấp một lần.
text vs keyword: cùng là chuỗi, hai thế giới
Elasticsearch có hai kiểu cho chuỗi, và nhầm lẫn giữa chúng là nguồn lỗi số một:
- text: đi qua analyzer (tách token, lowercase, stem — như bài 2). Dùng cho tìm toàn văn (
match). KHÔNG dùng được cho sort/agg/term trực tiếp. - keyword: lưu nguyên chuỗi làm một token, không phân tích. Dùng cho khớp chính xác, sort, aggregation, term. Lý tưởng cho mã, enum, tag, trạng thái.
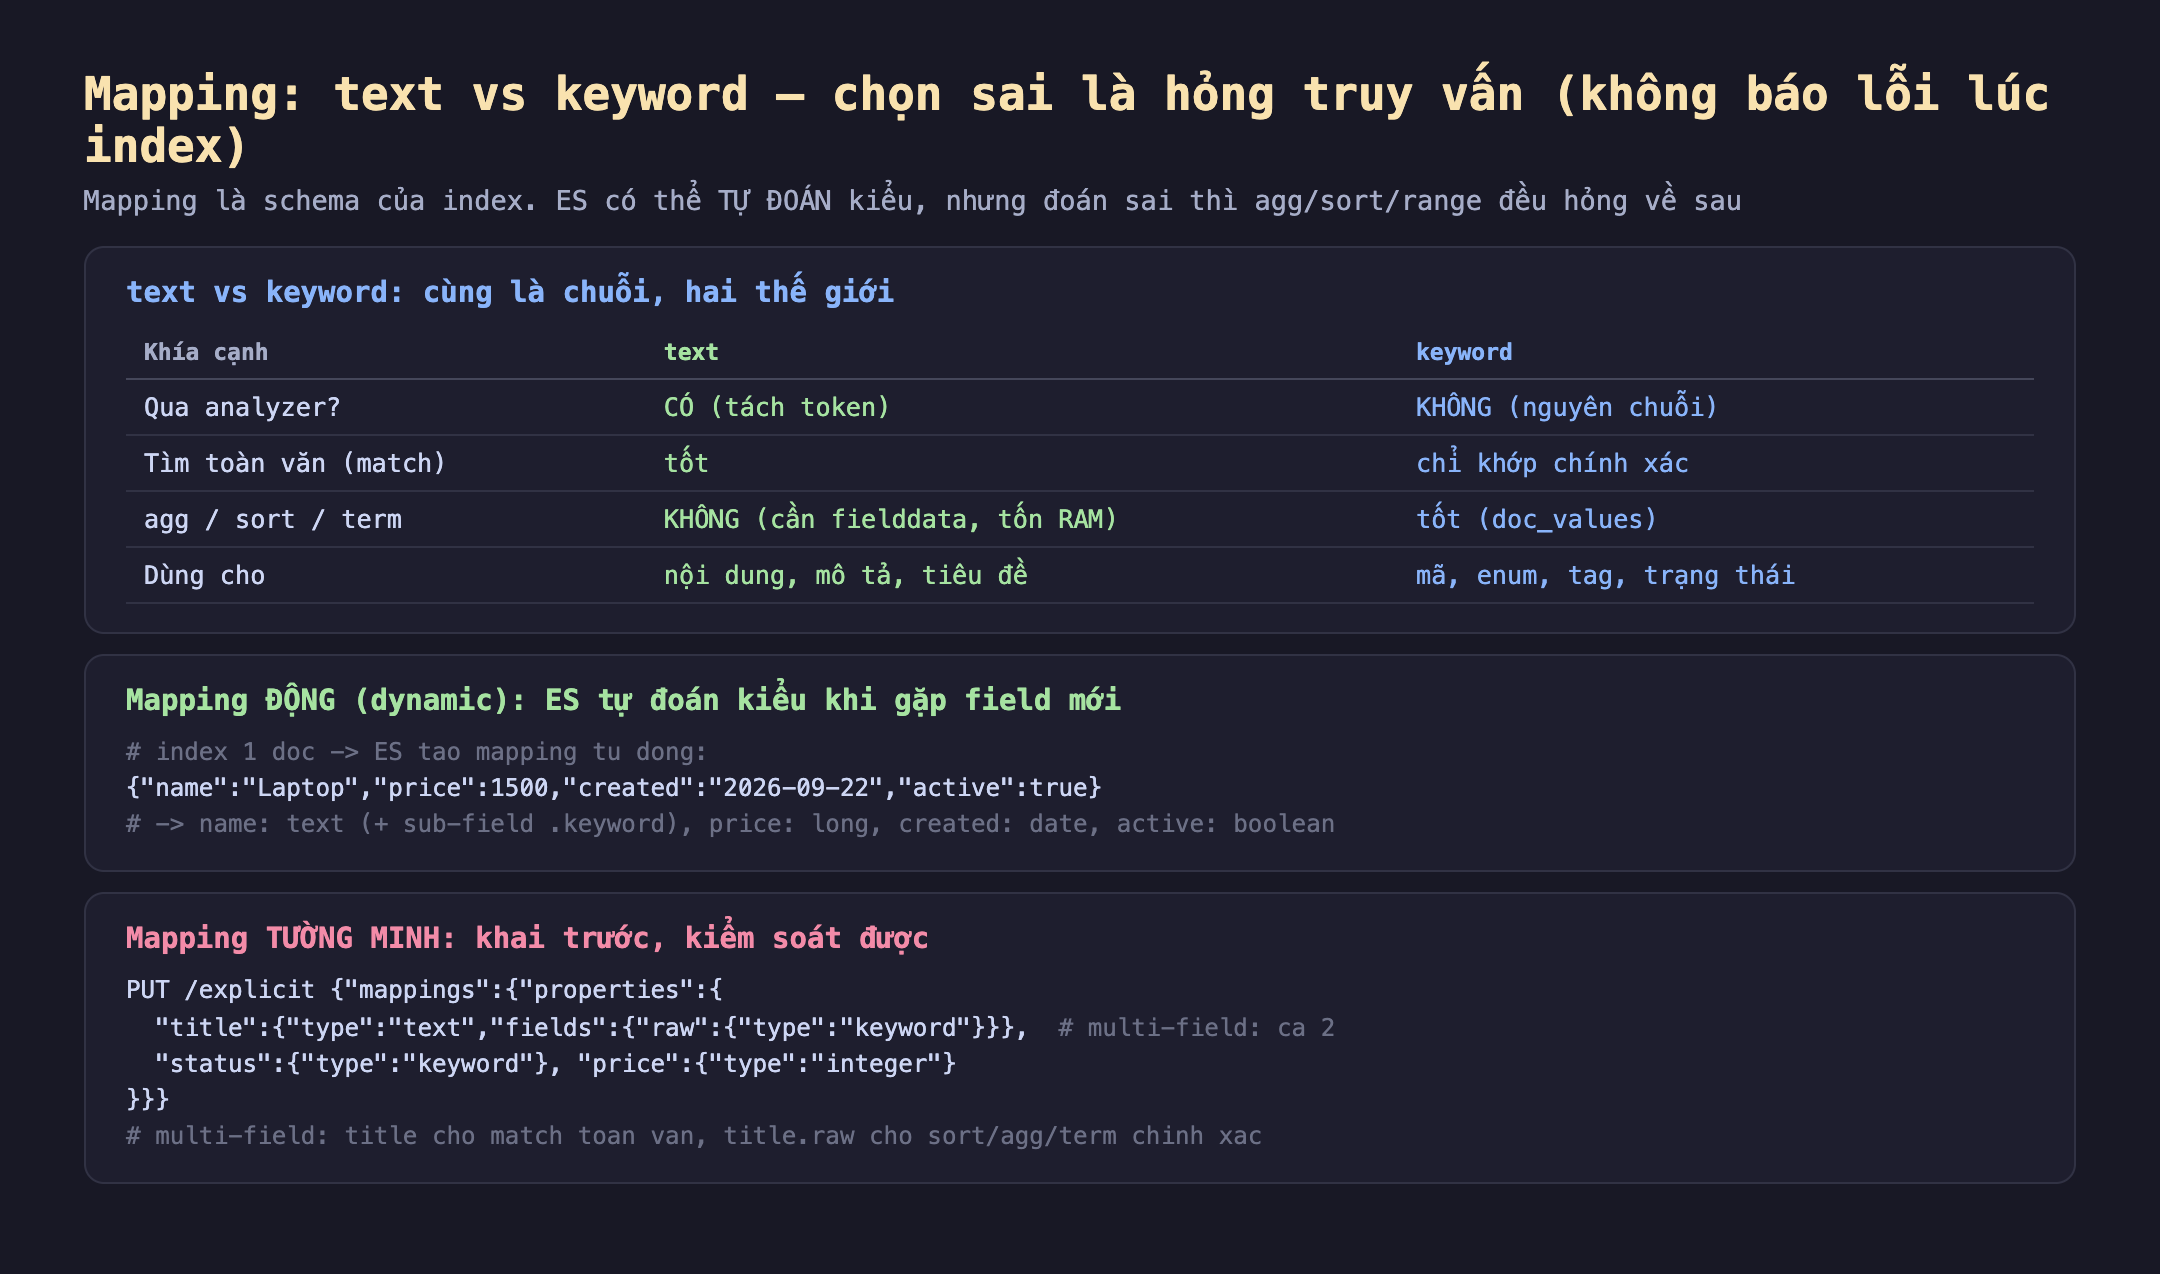
Hình 1: text qua analyzer (cho match), keyword nguyên chuỗi (cho sort/agg/term). Mapping động: ES tự đoán kiểu. Mapping tường minh: khai trước, kiểm soát được — kể cả multi-field (một trường vừa text vừa keyword).
Đo thật: ba cạm bẫy mapping
Mình chạy loạt thử nghiệm trên es-lab để lộ các lỗi mapping điển hình. Kết quả thật:
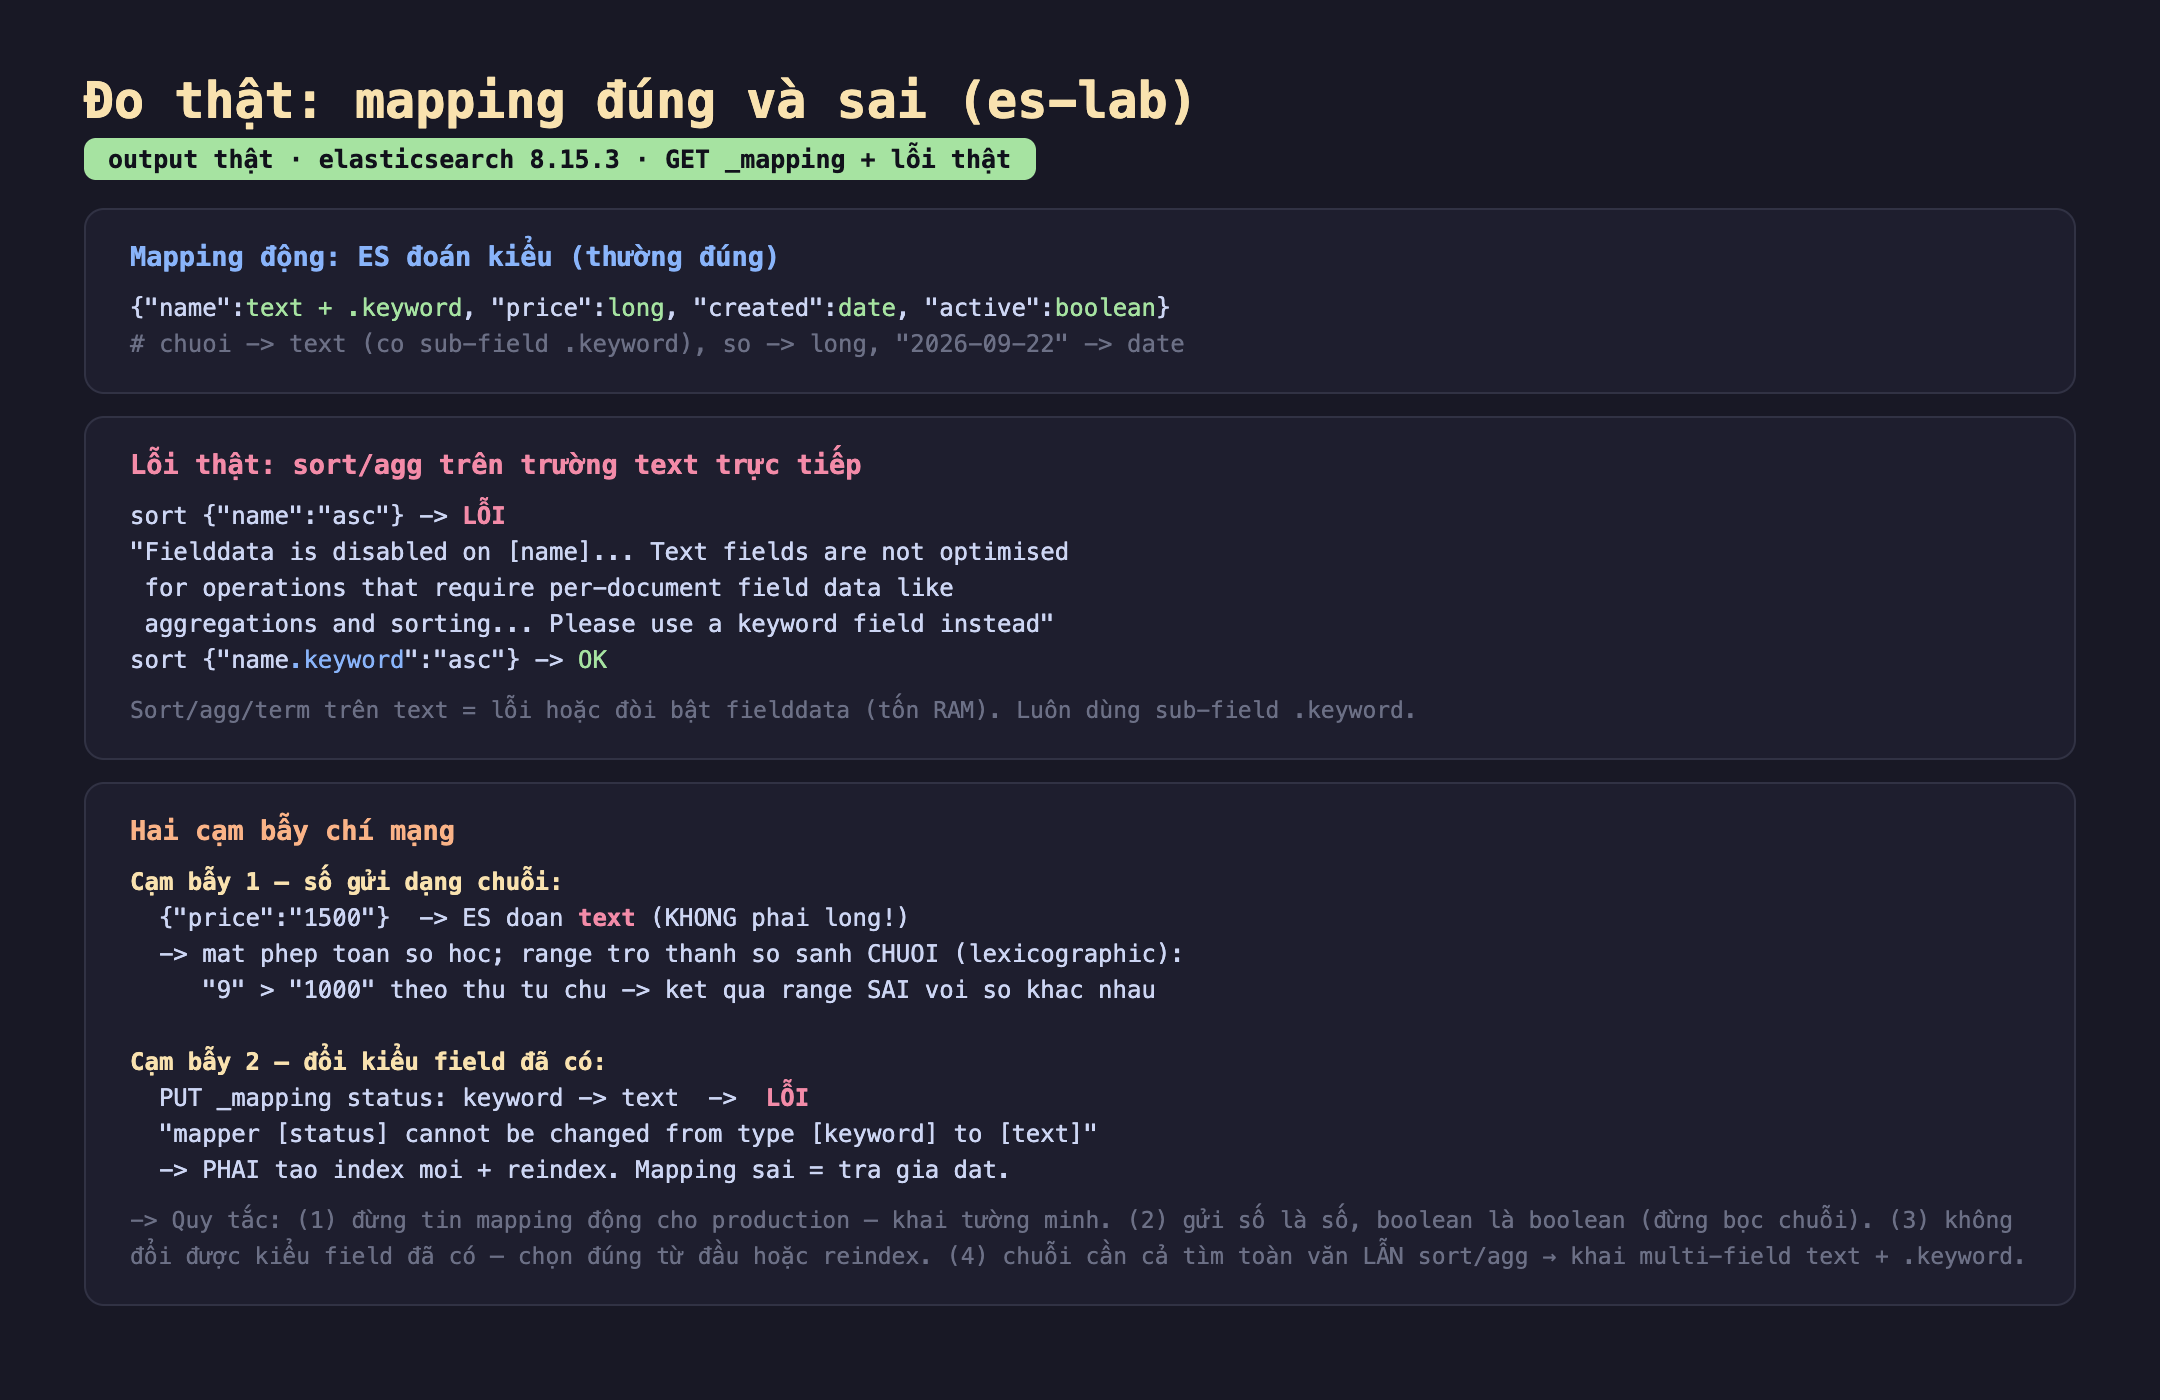
Hình 2: Kết quả thật. Mapping động đoán đúng các kiểu cơ bản; nhưng sort trên text báo lỗi Fielddata; số gửi dạng chuỗi bị đoán thành text (mất phép toán số); và không đổi được kiểu field đã có — phải reindex.
Mapping động đoán kiểu (thường đúng). Index một tài liệu {"name":"Laptop","price":1500,"created":"2026-09-22","active":true}, ES tự tạo: name→text (kèm sub-field .keyword), price→long, created→date, active→boolean. Tiện — nhưng chỉ đúng khi dữ liệu "sạch".
Cạm bẫy 1 — sort/agg trên trường text. Thử sort theo name (text), ES trả lỗi:
"Fielddata is disabled on [name]... Text fields are not optimised for operations that require per-document field data like aggregations and sorting... Please use a keyword field instead"
Đổi sang name.keyword → OK. Đây là lý do mapping động tạo cả sub-field .keyword: để bạn có thể sort/agg. Nhưng nếu không biết, bạn sẽ gặp lỗi này ngay khi làm dashboard.
Cạm bẫy 2 — số gửi dạng chuỗi. Gửi {"price":"1500"} (số bọc trong dấu nháy), ES đoán price→text (không phải long!). Hậu quả: mất phép toán số học, và tệ hơn, range trở thành so sánh chuỗi (lexicographic) — "9" > "1000" theo thứ tự chữ cái, cho kết quả range sai khi các giá trị có độ dài khác nhau. Một bug âm thầm, chỉ lộ khi dữ liệu đa dạng.
Cạm bẫy 3 — không đổi được kiểu field đã có. Thử đổi status từ keyword sang text, ES trả lỗi:
"mapper [status] cannot be changed from type [keyword] to [text]"
Kiểu của một trường là bất biến sau khi tạo. Muốn đổi, bạn phải tạo index mới với mapping đúng rồi reindex toàn bộ dữ liệu — tốn kém và phiền phức ở quy mô lớn. Chọn sai mapping ban đầu là trả giá đắt về sau.
Giải pháp: mapping tường minh + multi-field
Cách làm đúng cho production là khai mapping tường minh trước khi nạp dữ liệu:
PUT /explicit
{
  "mappings": {
    "properties": {
      "title":  { "type": "text", "fields": { "raw": { "type": "keyword" } } },
      "status": { "type": "keyword" },
      "price":  { "type": "integer" }
    }
  }
}
Chú ý title dùng multi-field: vừa là text (cho match toàn văn) vừa có sub-field title.raw kiểu keyword (cho sort/agg/term chính xác). Đây là mẫu chuẩn khi một trường cần cả hai khả năng — và đo thật xác nhận: match trên title tìm toàn văn OK, terms agg trên status (keyword) OK.
Đánh đổi cần cân nhắc
Mapping động tiện cho prototype, nguy hiểm cho production. Với dữ liệu khám phá nhanh (log, dữ liệu lạ), để ES tự đoán giúp bắt đầu nhanh. Nhưng với schema ổn định (sản phẩm, đơn hàng, người dùng), luôn khai tường minh — bạn kiểm soát kiểu, tránh đoán sai, và có thể tắt dynamic ("dynamic": "strict") để ES từ chối field lạ thay vì âm thầm thêm vào. Field lạ tự thêm có thể gây "mapping explosion" (quá nhiều field) làm chậm cả cluster.
Mỗi sub-field tốn chỗ — đừng khai .keyword cho mọi trường text. Multi-field text + keyword lưu dữ liệu hai lần (một cho inverted index, một cho doc_values). Với trường chỉ dùng tìm toàn văn (như nội dung bài viết dài), thêm .keyword là lãng phí đĩa và còn vô dụng (ignore_above:256 mặc định bỏ qua chuỗi dài). Chỉ khai .keyword cho trường thật sự cần sort/agg/khớp chính xác.
Gửi đúng kiểu JSON ngay từ client. Nhiều lỗi mapping bắt nguồn từ phía ứng dụng gửi sai: số thành chuỗi, boolean thành "true"/"false" chuỗi, ngày sai định dạng. Nếu dùng mapping động, những cái này quyết định kiểu vĩnh viễn của field. Chuẩn hóa dữ liệu ở tầng ứng dụng trước khi gửi, hoặc khai mapping tường minh để ES ép kiểu (coerce) đúng.
Ba ý mang về
- text và keyword là hai kiểu khác nhau cho chuỗi — chọn sai hỏng truy vấn. Đo thật: sort trên trường text báo lỗi "Fielddata is disabled... use a keyword field instead"; phải dùng
.keyword. text cho match toàn văn; keyword cho sort/agg/term/khớp chính xác (mã, enum, tag). - Mapping động tiện nhưng đoán sai âm thầm. Đo thật: số gửi dạng chuỗi
"1500"bị đoán thành text (mất phép toán số, range thành so sánh lexicographic). Với production, khai mapping tường minh và cân nhắcdynamic: strict. - Kiểu field là bất biến — chọn đúng từ đầu hoặc trả giá reindex. Đo thật: đổi status từ keyword sang text báo lỗi "cannot be changed". Dùng multi-field (text + .keyword) cho trường cần cả tìm toàn văn lẫn sort/agg, nhưng đừng khai .keyword cho mọi text (tốn đĩa).
Nguồn
- Elasticsearch docs — Mapping: https://www.elastic.co/guide/en/elasticsearch/reference/current/mapping.html
- Elasticsearch docs — text vs keyword, multi-fields: https://www.elastic.co/guide/en/elasticsearch/reference/current/multi-fields.html
- Elasticsearch docs — Dynamic mapping: https://www.elastic.co/guide/en/elasticsearch/reference/current/dynamic-mapping.html
Phần sau ta đo thật tốc độ nạp dữ liệu: _bulk đối đầu index từng document một, vì sao gộp nhiều thao tác vào một request tăng throughput nhiều lần, và cách chỉnh kích thước lô cho tối ưu.
