Nhiều người nghĩ Elasticsearch chỉ để tìm kiếm. Nhưng một trong những lý do mạnh nhất để dùng nó lại là aggregation — khả năng gom nhóm, đếm, tính toán trên hàng triệu bản ghi trong vài chục mili giây. Đây là thứ biến ES từ "ô tìm kiếm" thành nền tảng của mọi dashboard analytics (Kibana chính là giao diện cho aggregation của ES). Nếu bạn từng viết GROUP BY ... COUNT ... AVG trong SQL, aggregation là phiên bản đó cho dữ liệu quy mô lớn.
Bài này (phần 6 loạt Elasticsearch) chạy thật các loại aggregation phổ biến trên 1 triệu bản ghi ở es-lab, đo thời gian thật, và chỉ ra một cạm bẫy mà nhiều kỹ sư báo cáo sai số liệu vì không biết.
Hai loại aggregation
Aggregation chia làm hai nhóm, và chúng lồng vào nhau được:
- bucket aggregation (gom nhóm): chia tài liệu thành các nhóm —
terms(gom theo giá trị, như GROUP BY),histogram(gom theo khoảng số),date_histogram(gom theo khoảng thời gian). - metric aggregation (tính số): tính một con số trên mỗi nhóm —
stats(min/max/avg/sum/count),avg,sum,cardinality(đếm giá trị duy nhất)...
Sức mạnh thật đến từ lồng: gom theo region bằng terms, rồi trong mỗi region tính avg doanh số — một truy vấn cho ra cả bảng phân tích.
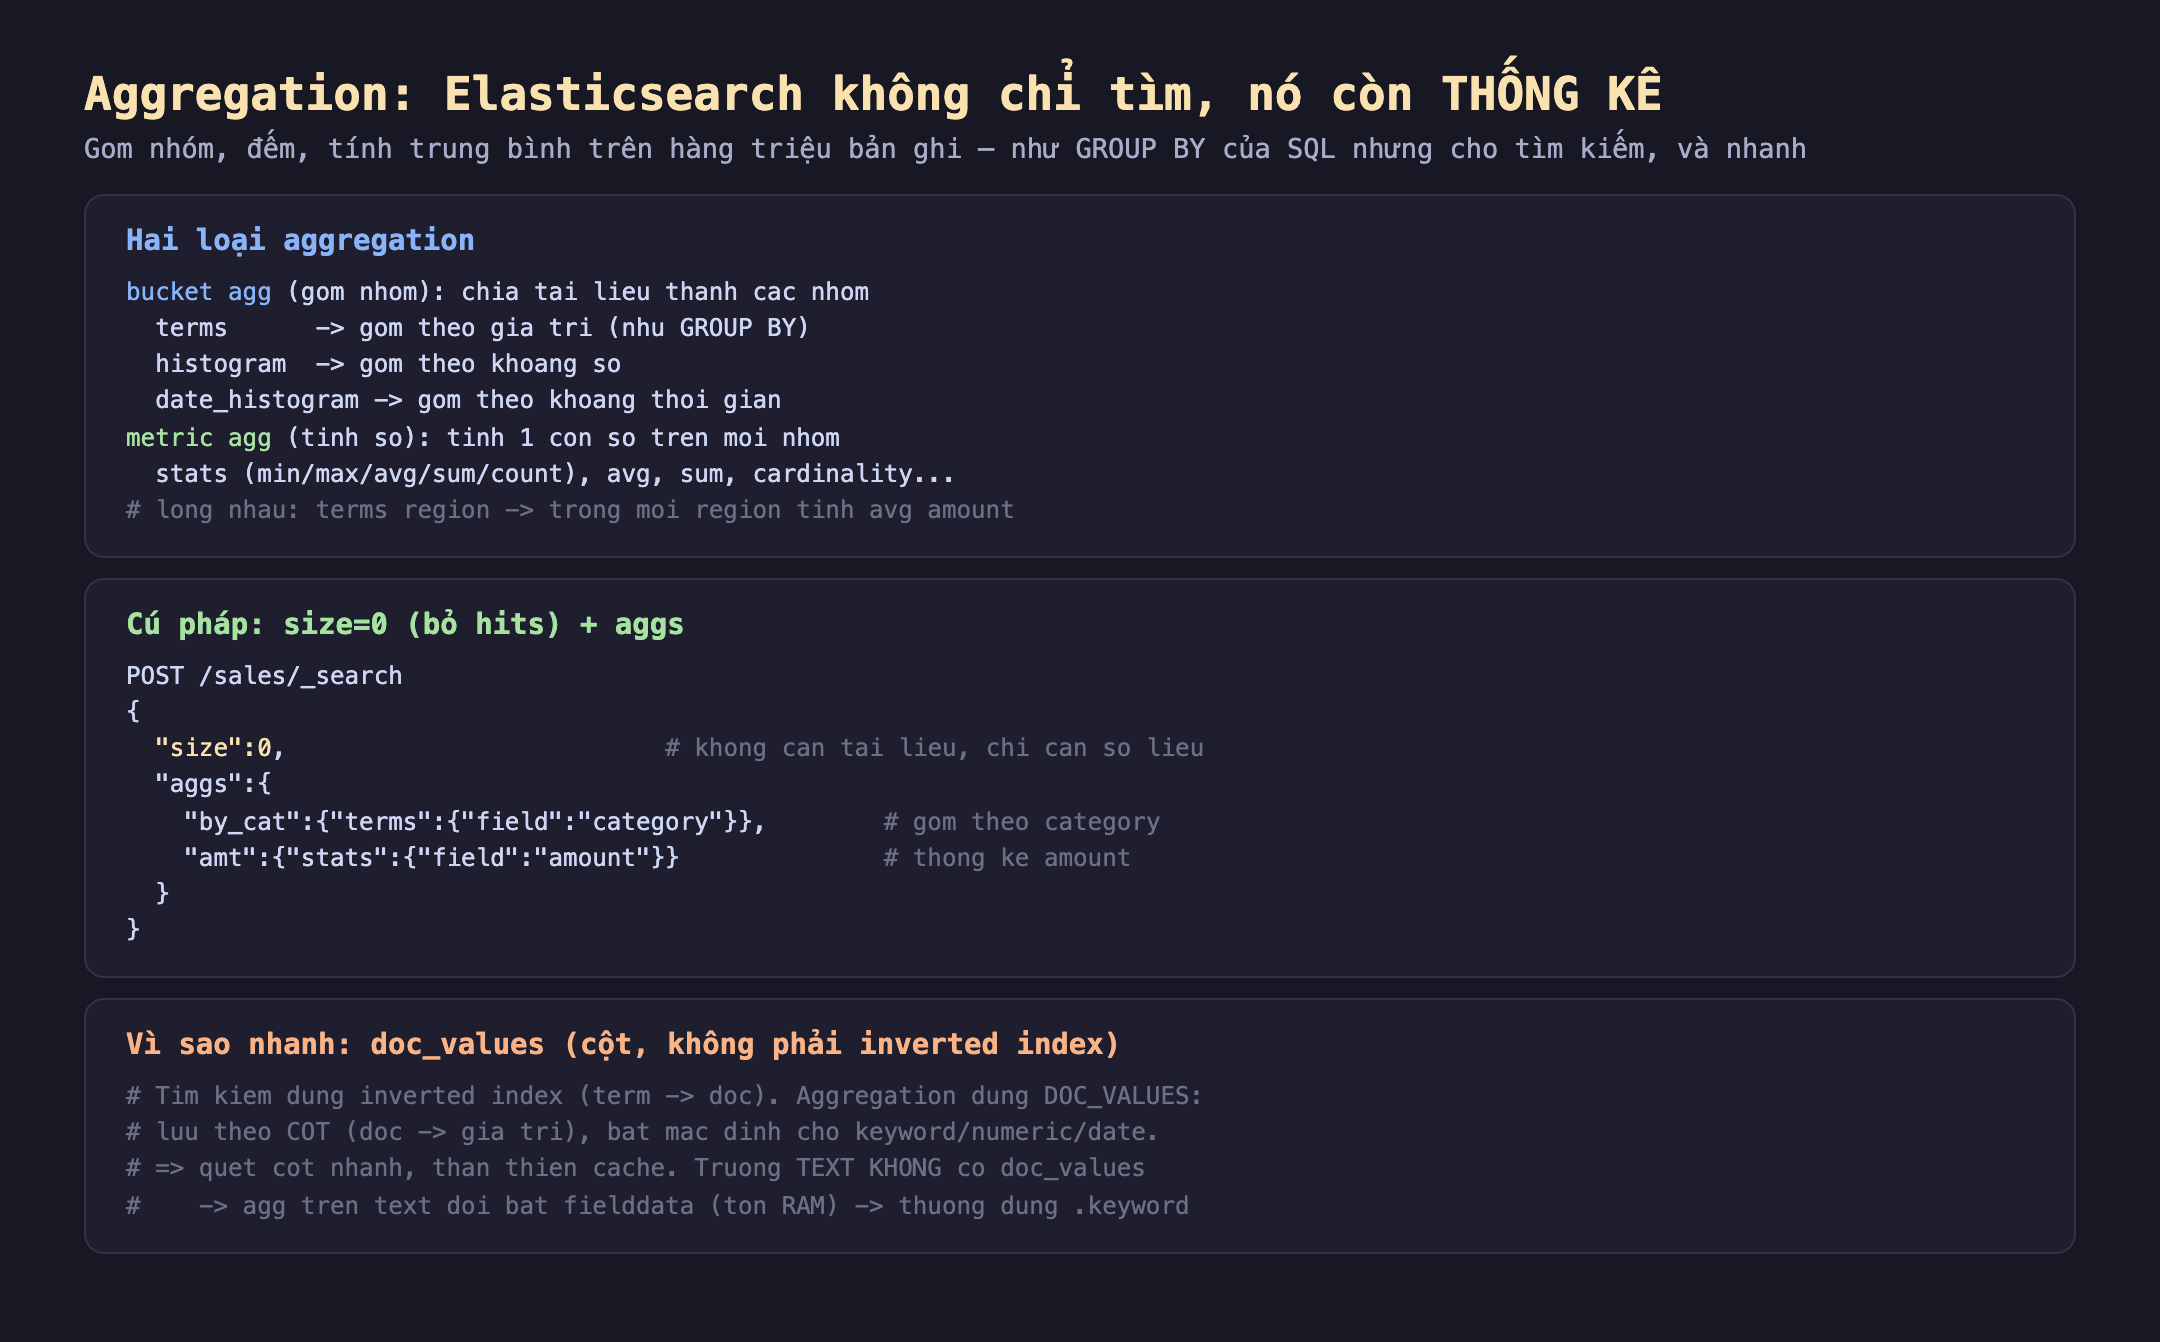
Hình 1: bucket agg gom nhóm (terms, histogram), metric agg tính số (stats, avg, cardinality), lồng được vào nhau. Cú pháp: size=0 + aggs. Nhanh nhờ doc_values (lưu theo cột), bật mặc định cho keyword/numeric/date.
POST /sales/_search
{
  "size": 0,                                    # khong can tai lieu, chi can so lieu
  "aggs": {
    "by_region": {
      "terms": { "field": "region" },           # gom theo region
      "aggs": { "avg_amt": { "avg": { "field": "amount" } } }  # trong moi region, avg
    }
  }
}
Đo thật: aggregation trên 1 triệu bản ghi
Mình nạp 1 triệu bản ghi bán hàng (category, region, amount, customer_id) vào es-lab bằng _bulk, rồi chạy năm loại aggregation, đọc took (thời gian ES tự báo). Kết quả thật:
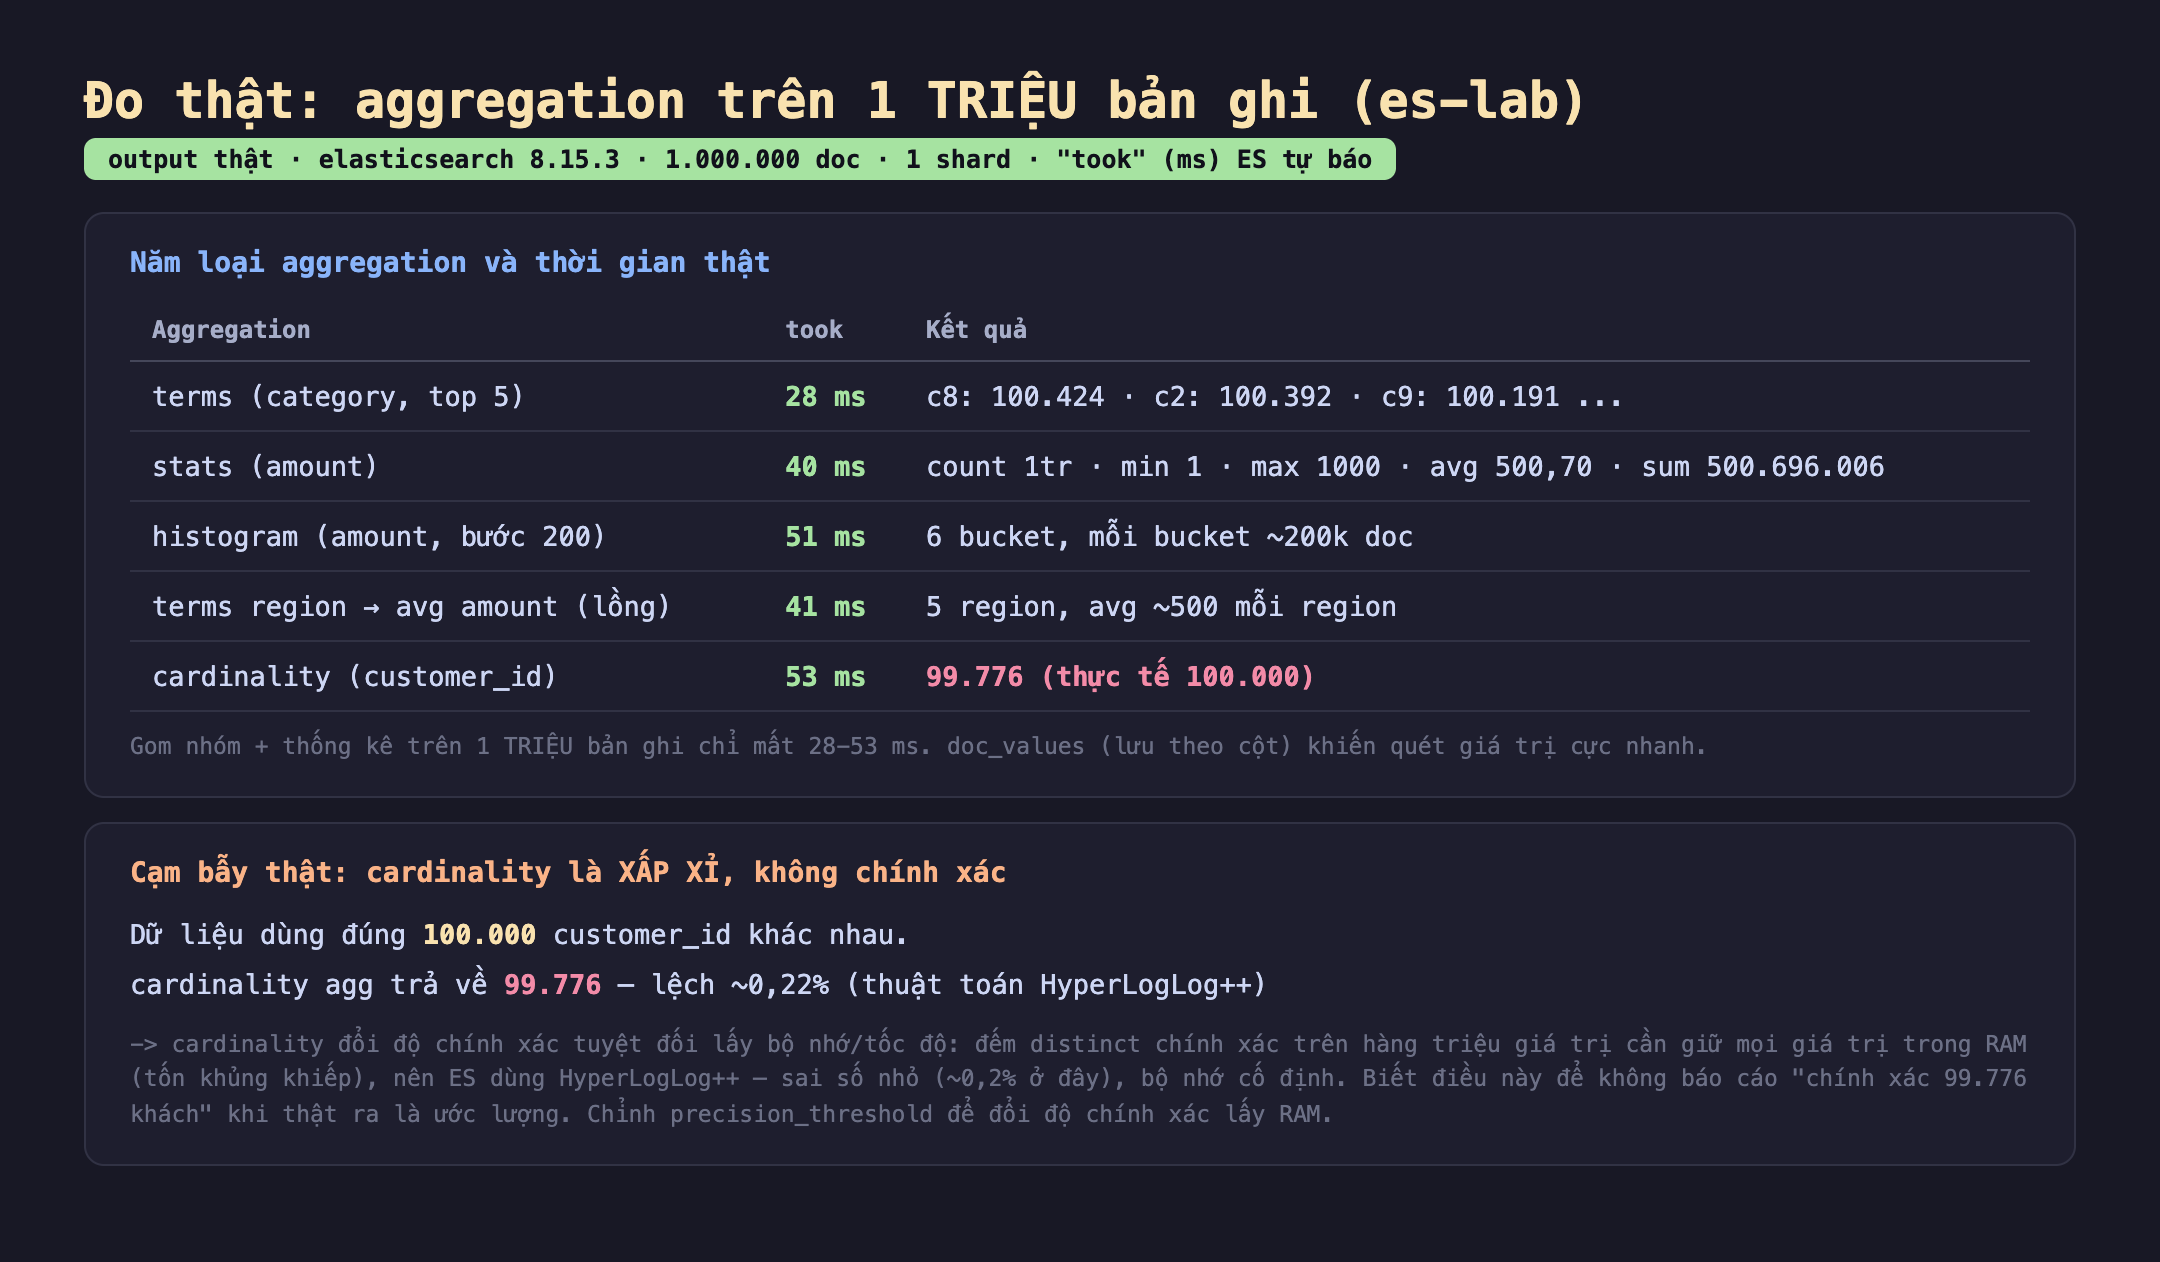
Hình 2: Kết quả thật trên 1 triệu bản ghi. terms 28ms, stats 40ms, histogram 51ms, terms lồng avg 41ms, cardinality 53ms. cardinality trả về 99.776 trong khi thực tế là 100.000 — ước lượng, không chính xác.
- terms (gom theo category) — 28 ms: trả về mỗi danh mục với số lượng (c8: 100.424, c2: 100.392...). Đây là GROUP BY + COUNT trên 1 triệu dòng, xong trong 28 ms.
- stats (amount) — 40 ms: count=1.000.000, min=1, max=1000, avg=500,70, sum=500.696.006. Năm con số thống kê trên toàn bộ 1 triệu bản ghi.
- histogram (amount, bước 200) — 51 ms: phân bố thành 6 khoảng, mỗi khoảng ~200k bản ghi — dữ liệu để vẽ biểu đồ phân bố.
- terms lồng avg (region → avg amount) — 41 ms: mỗi region kèm doanh số trung bình (~500 mỗi region). Một truy vấn, cả bảng phân tích hai chiều.
- cardinality (customer_id) — 53 ms: đếm số khách hàng duy nhất → 99.776.
Toàn bộ các phép thống kê này chạy trong 28–53 ms trên một triệu bản ghi. Bí quyết tốc độ là doc_values: ES lưu các trường keyword/numeric/date theo cột (doc → giá trị), nên quét toàn bộ giá trị một cột cực nhanh và thân thiện cache — ngược với inverted index (dùng cho tìm kiếm, term → doc).
Cạm bẫy: cardinality là ước lượng, không chính xác
Đây là điều nhiều kỹ sư không biết và báo cáo sai số liệu. Mình tạo dữ liệu với đúng 100.000 customer_id khác nhau. Nhưng cardinality agg trả về 99.776 — lệch ~0,22%.
Vì sao không chính xác? Vì đếm distinct chính xác trên hàng triệu giá trị đòi giữ mọi giá trị đã thấy trong bộ nhớ (một Set khổng lồ) — tốn RAM kinh khủng và không scale. ES thay bằng thuật toán HyperLogLog++: dùng bộ nhớ cố định (bất kể bao nhiêu giá trị) và chấp nhận sai số nhỏ (~0,2% ở đây). Đây là đánh đổi cổ điển: độ chính xác đổi lấy bộ nhớ và tốc độ.
Hệ quả thực tế: đừng bao giờ báo cáo "chúng ta có chính xác 99.776 khách hàng" từ cardinality — đó là ước lượng. Nếu cần con số chính xác tuyệt đối (ví dụ báo cáo tài chính), cardinality không phải công cụ đúng. Bạn chỉnh được độ chính xác bằng precision_threshold (cao hơn = chính xác hơn nhưng tốn RAM hơn), nhưng trên quy mô rất lớn thì luôn có sai số.
Đánh đổi cần cân nhắc
Aggregation trên trường text cần fielddata (tốn RAM) — dùng .keyword thay thế. doc_values bật mặc định cho keyword/numeric/date, nhưng không cho trường text (vì text đã bị tách token, gom nhóm theo token thường vô nghĩa). Nếu cố gom theo một trường text, ES đòi bật fielddata — nạp toàn bộ giá trị vào heap, rất tốn RAM và dễ gây OOM trên dữ liệu lớn. Giải pháp đúng: gom theo trường .keyword (phiên bản không phân tích của trường đó). Đây là lý do mapping thường khai cả text + keyword cho một trường.
terms agg trên trường cardinality cao có thể sai và tốn. terms mặc định chỉ trả top N bucket (mặc định 10), và trên nhiều shard, số đếm của các bucket "biên" có thể không chính xác (doc_count_error) vì mỗi shard chỉ gửi top cục bộ về. Với trường có hàng triệu giá trị duy nhất (như user_id), terms vừa tốn (phải theo dõi rất nhiều bucket) vừa dễ sai. Lab 1 shard không gặp; production nhiều shard cần tăng shard_size hoặc dùng cách khác cho trường cardinality cao.
Aggregation sâu/rộng có thể ngốn bộ nhớ và làm chậm cluster. Lồng nhiều tầng aggregation, hoặc terms với size rất lớn, tạo ra số bucket bùng nổ (tích Descartes) — có thể ngốn heap và làm chậm cả cluster, không chỉ truy vấn đó. ES có search.max_buckets (mặc định 65.536) để chặn. Khi làm dashboard phức tạp, đo chi phí thật và cân nhắc tính trước (pre-aggregate) các số liệu hay dùng thay vì aggregation thời gian thực mỗi lần.
Ba ý mang về
- Aggregation biến ES thành cỗ máy phân tích, cực nhanh nhờ doc_values. Đo thật trên 1 triệu bản ghi: terms gom nhóm 28ms, stats tính min/max/avg/sum 40ms, histogram 51ms, terms lồng avg 41ms. bucket agg gom nhóm, metric agg tính số, lồng được vào nhau — như GROUP BY của SQL nhưng cho quy mô lớn.
- cardinality là ước lượng, không chính xác. Đo thật: dữ liệu có đúng 100.000 giá trị duy nhất, cardinality trả về 99.776 (lệch ~0,22%) vì dùng HyperLogLog++ đổi độ chính xác lấy bộ nhớ cố định. Đừng báo cáo con số cardinality như thể chính xác tuyệt đối.
- Biết giới hạn: text cần fielddata (tốn RAM), terms cardinality cao dễ sai, agg sâu ngốn bộ nhớ. Gom nhóm dùng .keyword không dùng text; tăng shard_size cho trường cardinality cao trên nhiều shard; cân nhắc pre-aggregate cho dashboard phức tạp thay vì tính thời gian thực mỗi lần.
Nguồn
- Elasticsearch docs — Aggregations: https://www.elastic.co/guide/en/elasticsearch/reference/current/search-aggregations.html
- Elasticsearch docs — Cardinality aggregation (HyperLogLog++): https://www.elastic.co/guide/en/elasticsearch/reference/current/search-aggregations-metrics-cardinality-aggregation.html
- Elasticsearch docs — doc_values & fielddata: https://www.elastic.co/guide/en/elasticsearch/reference/current/doc-values.html
Phần sau ta mổ xẻ mapping: khác biệt text vs keyword, vì sao chọn sai kiểu dữ liệu làm hỏng cả truy vấn lẫn aggregation, và đo thật mapping động (tự đoán kiểu) so với mapping tường minh.
