Trong thực tế, không ai tìm kiếm chỉ với một điều kiện. Người dùng muốn "laptop gaming, hãng Dell hoặc Asus, giá dưới 20 triệu, còn hàng, không phải hàng trưng bày". Đó là năm điều kiện với các vai trò khác nhau: cái cần tính độ liên quan, cái chỉ cần lọc, cái loại trừ. Công cụ để ghép tất cả lại trong Elasticsearch là bool query — và hiểu đúng bốn mệnh đề của nó là kỹ năng tạo nên 90% truy vấn production.
Bài này (phần 5 loạt Elasticsearch) mổ xẻ must, should, filter, must_not — đặc biệt là khác biệt quan trọng nhất mà người mới hay bỏ qua: filter không tính điểm và được cache. Mọi con số dưới đây đo thật trên es-lab.
Bốn mệnh đề, hai nhóm
bool query gom các điều kiện vào bốn mệnh đề, chia làm hai nhóm theo việc có tính điểm hay không:
| Mệnh đề | Nghĩa | Tính _score? | Cache? |
|---|---|---|---|
| must | bắt buộc khớp (AND) | CÓ (cộng điểm) | không |
| should | nên khớp (OR mềm) | CÓ (khớp nhiều = điểm cao) | không |
| filter | bắt buộc khớp (AND) | KHÔNG | CÓ |
| must_not | bắt buộc không khớp | KHÔNG | CÓ |
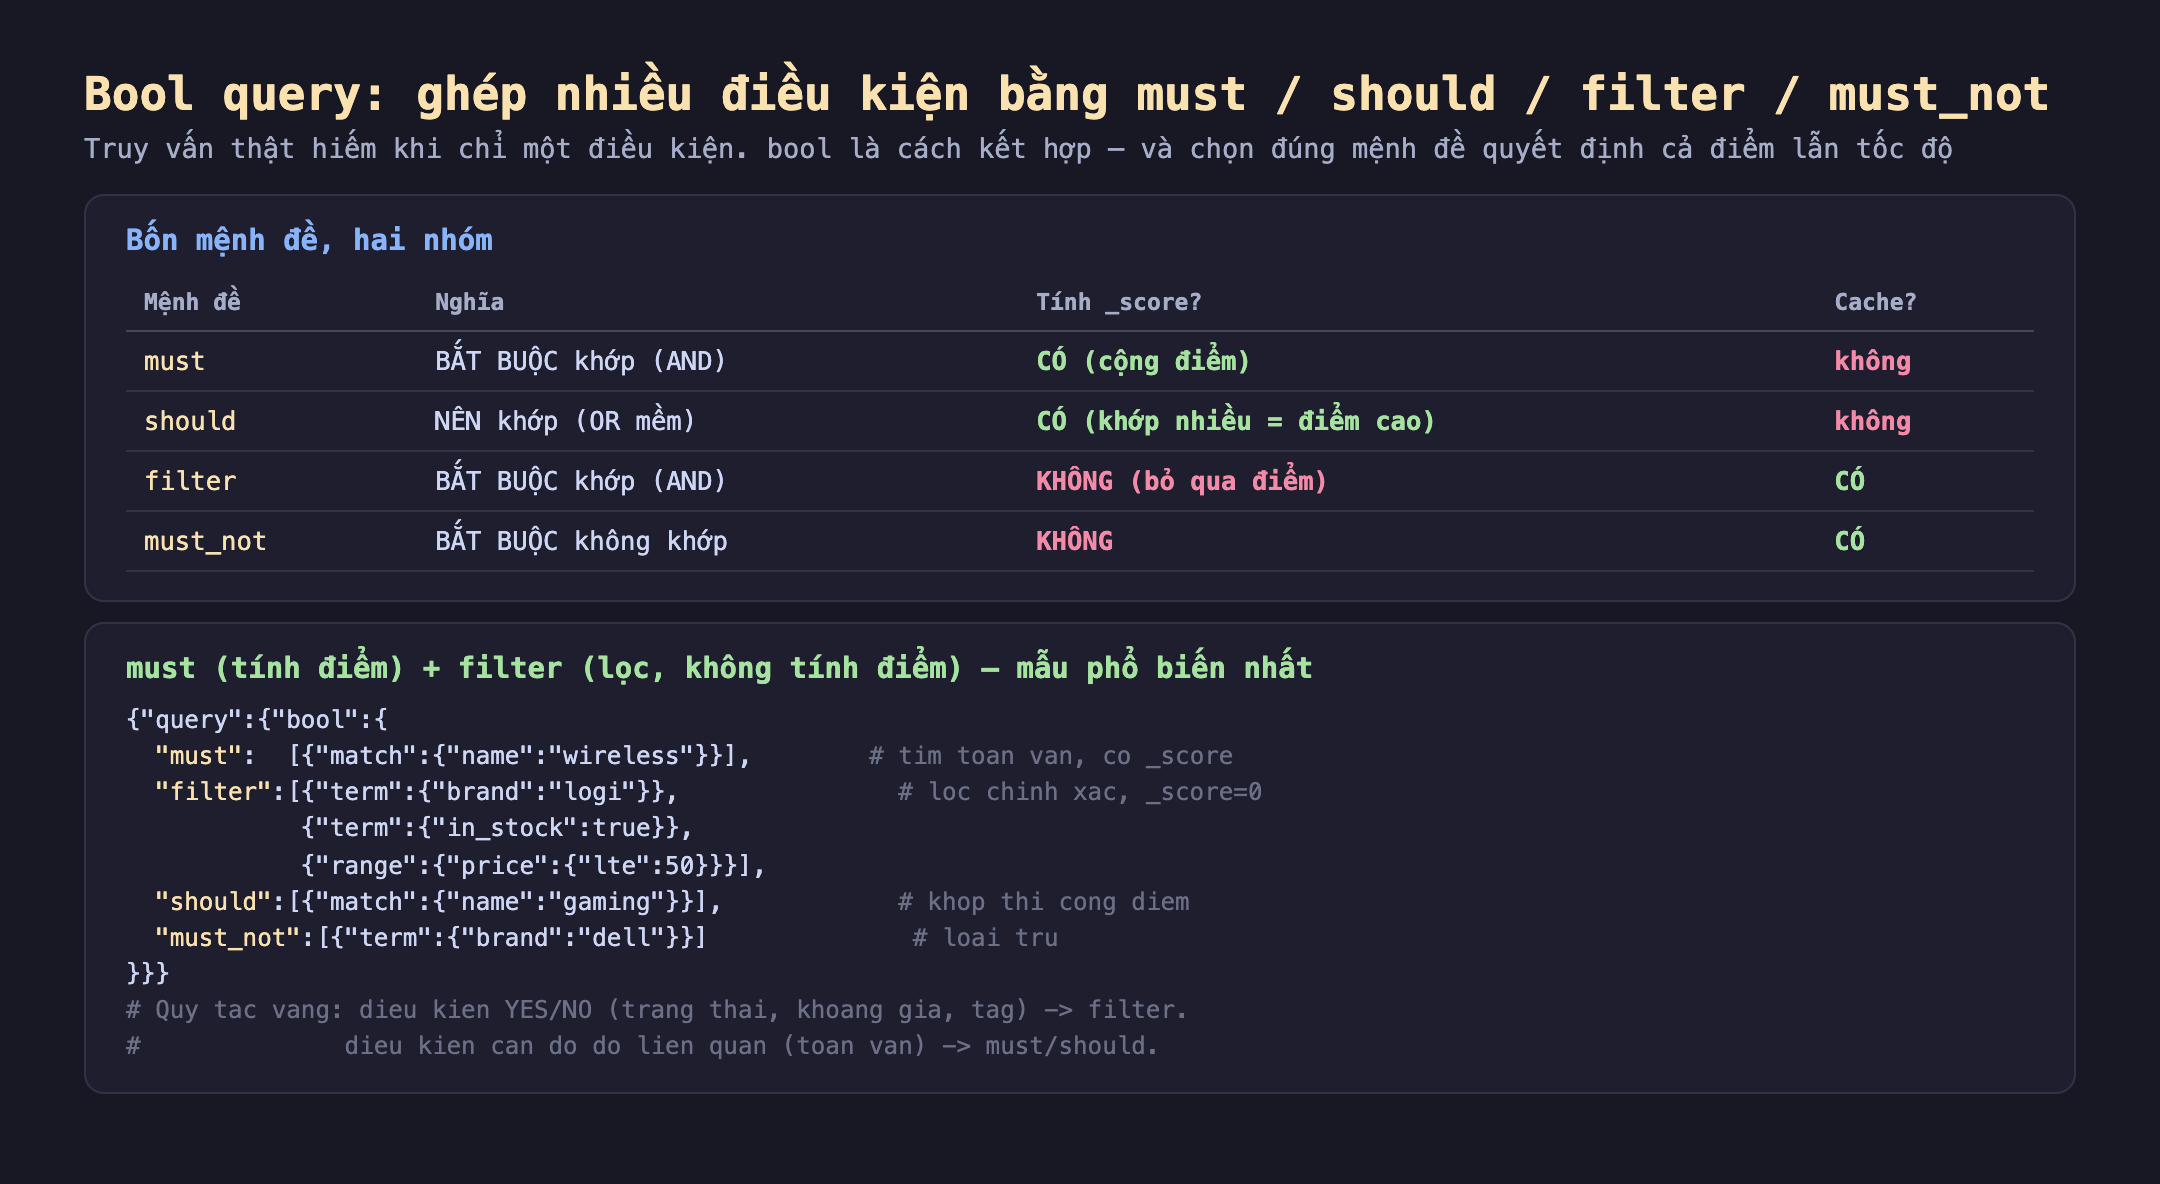
Hình 1: must/should tính điểm BM25 (cho độ liên quan); filter/must_not không tính điểm và được cache (cho lọc yes/no). Mẫu phổ biến: must cho tìm toàn văn, filter cho điều kiện trạng thái/khoảng/tag.
{"query":{"bool":{
  "must":   [{"match":{"name":"wireless"}}],
  "filter": [{"term":{"brand":"logi"}},
             {"term":{"in_stock":true}},
             {"range":{"price":{"lte":50}}}],
  "should": [{"match":{"name":"gaming"}}],
  "must_not":[{"term":{"brand":"dell"}}]
}}}
Đo thật: bốn mệnh đề trên một shop nhỏ
Mình index 5 sản phẩm (name=text, brand=keyword, price=int, in_stock=bool) rồi chạy từng tổ hợp. Kết quả thật từ es-lab:
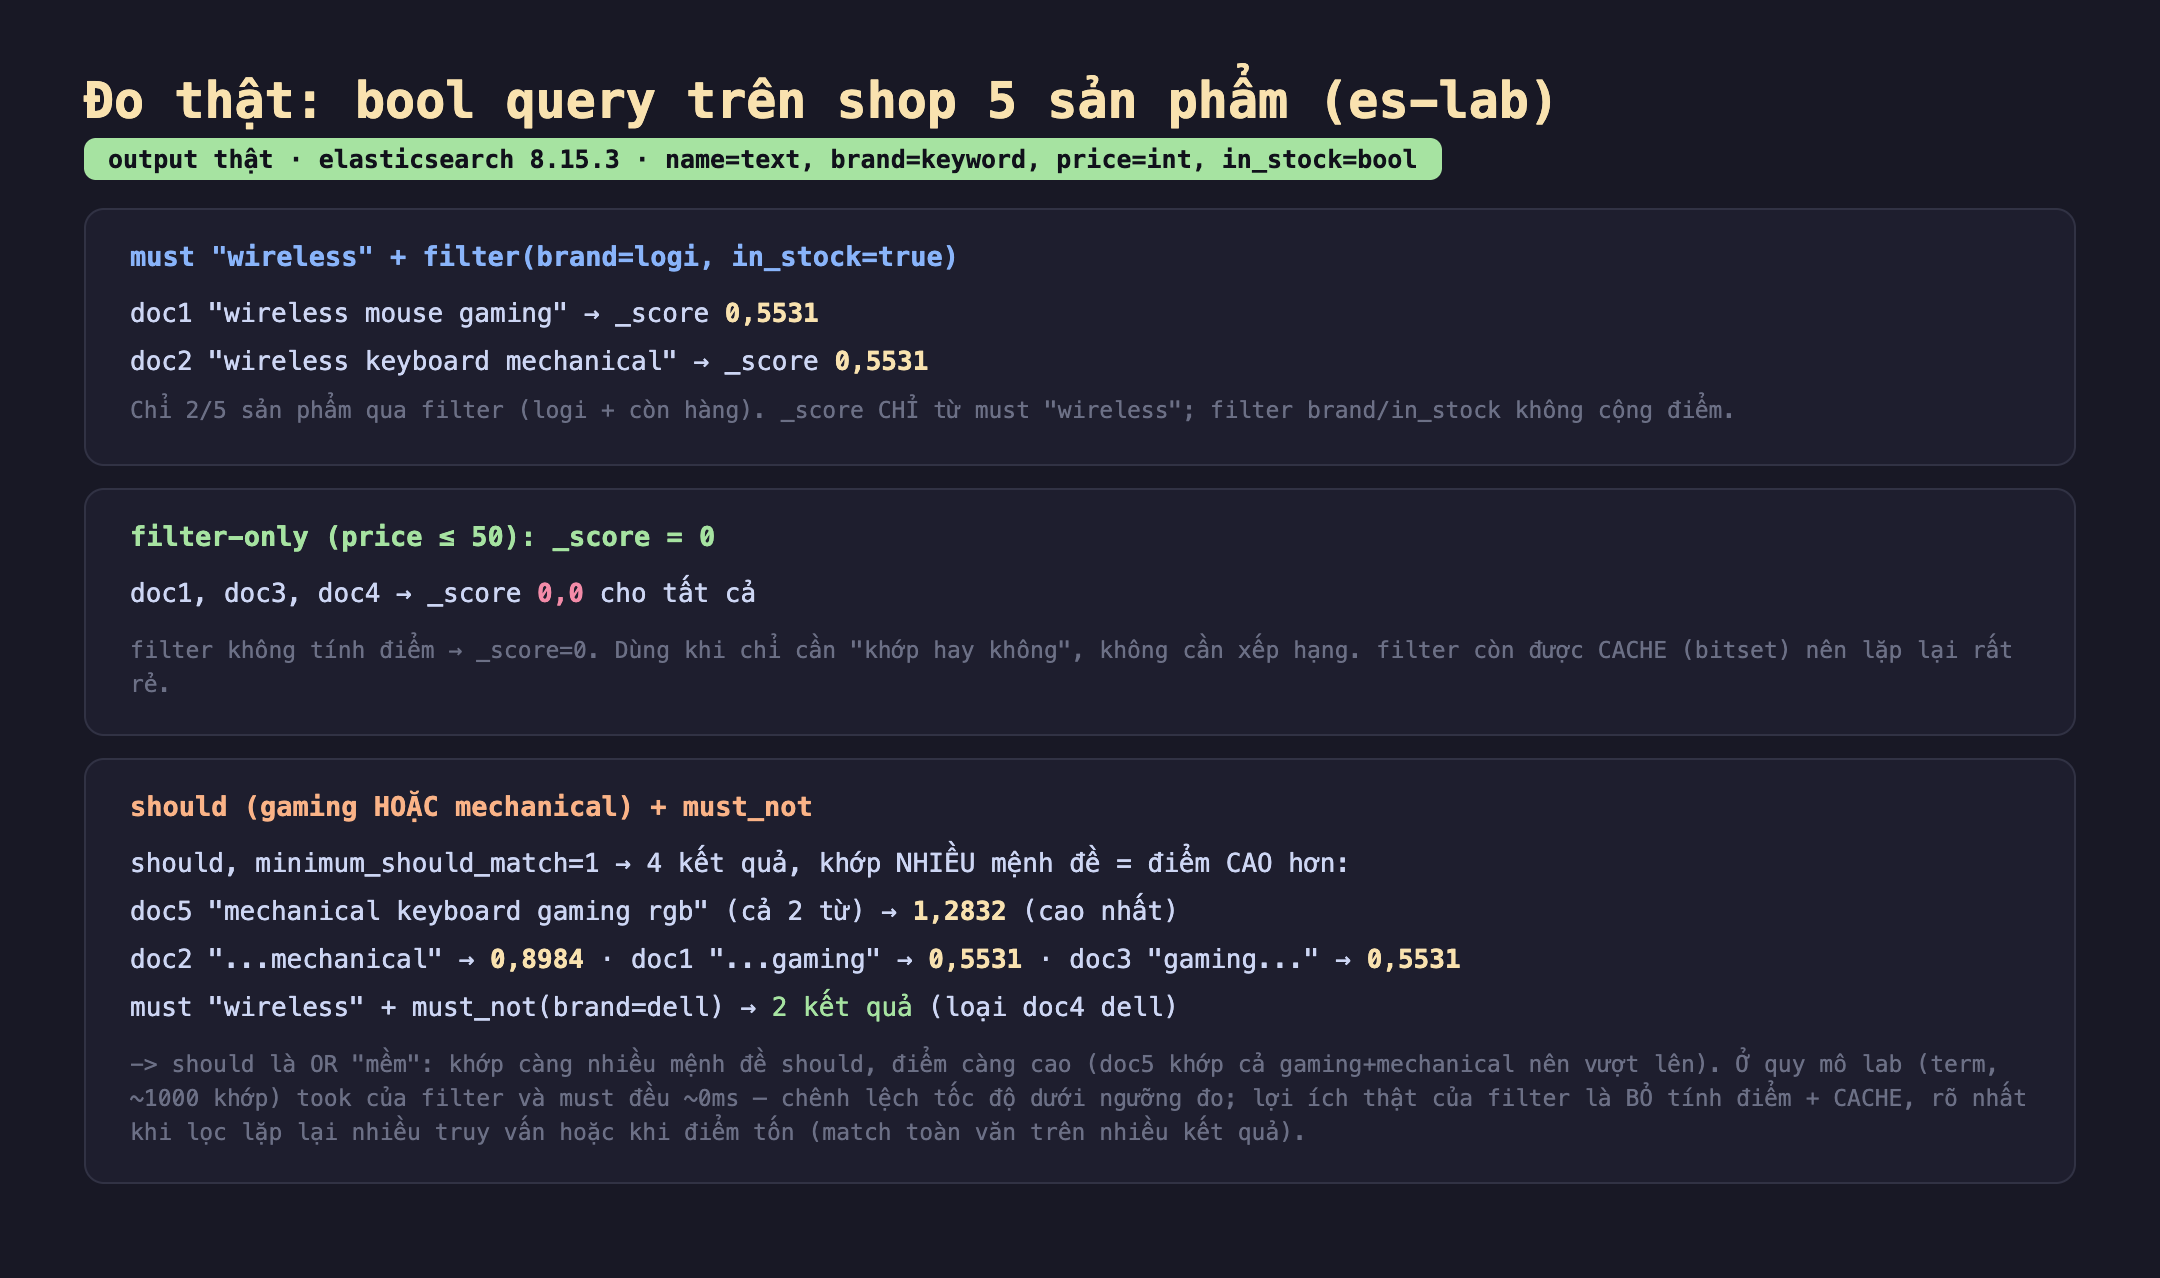
Hình 2: Kết quả thật. must+filter: 2 kết quả, _score chỉ từ must. filter-only: _score=0. should+minimum_should_match: doc5 khớp cả hai từ nên điểm cao nhất (1,2832). must_not loại doc4 dell.
- must + filter: tìm "wireless" (must) chỉ trong hàng logi còn hàng (filter) → 2 kết quả, cả hai
_score = 0,5531. Điểm chỉ đến từ must "wireless"; filter brand/in_stock không cộng điểm dù là điều kiện bắt buộc. - filter-only: lọc giá ≤ 50 → 3 kết quả,
_score = 0,0cho tất cả. filter không tính điểm nên mọi tài liệu khớp đều điểm 0 — đúng khi bạn chỉ cần "khớp hay không", không cần xếp hạng. - should + minimum_should_match=1: "gaming" hoặc "mechanical" → 4 kết quả, và khớp nhiều mệnh đề should thì điểm cao hơn. doc5 "mechanical keyboard gaming rgb" khớp cả hai từ →
1,2832(cao nhất), vượt doc2 (chỉ mechanical, 0,8984) và doc1/doc3 (chỉ gaming, 0,5531). - must_not: "wireless" nhưng loại brand dell → 2 kết quả (doc4 dell bị loại).
Vì sao filter là chìa khóa hiệu năng
Khác biệt filter vs must không chỉ là ngữ nghĩa — nó là hiệu năng. filter mang hai lợi thế:
- Bỏ qua tính điểm: không chạy BM25, chỉ trả lời "khớp/không". Với điều kiện yes/no (trạng thái, khoảng giá, tag), tính điểm là vô nghĩa và lãng phí.
- Được cache: ES lưu một bitset (dãy bit đánh dấu tài liệu nào khớp) cho mỗi filter, tái dùng cho các truy vấn sau. Filter "in_stock=true" chạy một lần, các lần sau dùng lại bitset — gần như miễn phí.
Thành thật về quy mô lab: khi mình đo took của filter vs must cho một term khớp ~1000 tài liệu, cả hai đều ~0 ms — chênh lệch nằm dưới ngưỡng đo được. Lợi ích của filter không lộ ra ở truy vấn đơn giản quy mô nhỏ; nó rõ nhất khi (a) lọc lặp lại qua nhiều truy vấn (cache được tái dùng), và (b) khi tính điểm tốn (match toàn văn trên nhiều kết quả, nhiều mệnh đề). Nhưng quy tắc thiết kế thì luôn đúng: điều kiện không cần độ liên quan → đặt vào filter.
Đánh đổi cần cân nhắc
Quy tắc vàng: yes/no → filter, liên quan → must/should. Mọi điều kiện kiểu "đúng/sai" — trạng thái (còn hàng), khoảng (giá, ngày), thuộc về tập (brand, tag, danh mục) — nên vào filter. Chỉ đặt vào must/should những gì bạn muốn đo độ liên quan và cộng vào _score (thường là match toàn văn). Nhầm lẫn phổ biến: đặt điều kiện lọc vào must, khiến ES tính điểm thừa và mất cache — chậm hơn mà kết quả xếp hạng cũng không tốt hơn.
should có hành vi khác nhau tùy có must/filter hay không. Nếu bool chỉ có should (không must/filter), thì mặc định minimum_should_match=1 (phải khớp ít nhất một). Nhưng nếu bool đã có must hoặc filter, thì should trở thành tùy chọn (minimum_should_match=0 mặc định) — chỉ dùng để cộng điểm cho tài liệu đã qua must/filter, không bắt buộc. Đây là nguồn gây bối rối: cùng một khối should cho kết quả khác nhau tùy ngữ cảnh. Khai minimum_should_match tường minh khi muốn chắc chắn.
must_not và filter đều không tính điểm, nhưng dùng cho mục đích khác. must_not loại trừ (NOT), filter chọn (AND). Cả hai cùng được cache và bỏ tính điểm. Dùng must_not cho "loại bỏ spam, hàng ngừng bán, nội dung ẩn"; dùng filter cho "chỉ lấy đúng điều kiện này". Đừng dùng must với một điều kiện phủ định rồi tự đảo logic — must_not rõ ràng và hiệu quả hơn.
Ba ý mang về
- bool ghép điều kiện bằng bốn mệnh đề với vai trò khác nhau. Đo thật: must/should tính điểm BM25 (doc5 khớp cả 2 từ should được 1,2832 cao nhất), filter/must_not không tính điểm (filter-only cho _score=0 toàn bộ). Chọn đúng mệnh đề quyết định cả thứ tự lẫn tốc độ.
- filter là chìa khóa hiệu năng: bỏ tính điểm + được cache. Đo thật: filter brand/in_stock không cộng vào _score (chỉ must "wireless" tạo 0,5531). Ở quy mô lab chênh lệch tốc độ dưới ngưỡng đo, nhưng cache + bỏ scoring thắng lớn khi lọc lặp lại hoặc điểm tốn.
- Quy tắc vàng: yes/no vào filter, liên quan vào must/should. Trạng thái, khoảng, tag → filter (hoặc must_not để loại trừ); match toàn văn cần xếp hạng → must/should. Nhớ should đổi hành vi khi có must/filter — khai minimum_should_match tường minh.
Nguồn
- Elasticsearch docs — Boolean query: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-dsl-bool-query.html
- Elasticsearch docs — Query and filter context: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-filter-context.html
- Elasticsearch docs — minimum_should_match: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-dsl-minimum-should-match.html
Phần sau ta chuyển từ tìm kiếm sang thống kê: aggregation gom nhóm và tính toán trên hàng trăm nghìn bản ghi (terms, histogram, stats), và đo thật thời gian ES tổng hợp số liệu ở quy mô lớn.
