Database quan hệ trả lời câu hỏi "dòng nào khớp?" — có hoặc không. Công cụ tìm kiếm trả lời một câu hỏi khó hơn: "dòng nào khớp nhất?". Khi bạn gõ một từ khóa và Elasticsearch trả về hàng nghìn tài liệu, thứ thực sự quan trọng là thứ tự — cái gì lên đầu. Thứ tự đó do một con số quyết định: _score, tính bằng thuật toán BM25.
Hiểu BM25 là ranh giới giữa một kỹ sư "dùng được ES" và một kỹ sư "điều khiển được kết quả tìm kiếm". Bài này (phần 4 loạt Elasticsearch) dùng explain API để mổ xẻ từng con số trong công thức BM25, trên dữ liệu thật ở es-lab.
BM25: ba yếu tố quyết định điểm
Mỗi khi một tài liệu khớp một từ, BM25 tính điểm cho nó theo công thức (rút gọn): score = boost × IDF × TF, với ba yếu tố:
- Term Frequency (TF): từ xuất hiện nhiều lần trong tài liệu → điểm cao hơn. Nhưng bão hòa — lần thứ 10 không quý bằng lần thứ 2.
- Inverse Document Frequency (IDF): từ hiếm (ít tài liệu chứa) → điểm cao hơn. Từ phổ biến ("the", "is") gần như vô giá trị; từ hiếm mang nhiều thông tin.
- Field length: trường dài → điểm thấp hơn. Một từ xuất hiện trong câu 3 từ đáng giá hơn cùng từ đó trong bài 1000 từ.
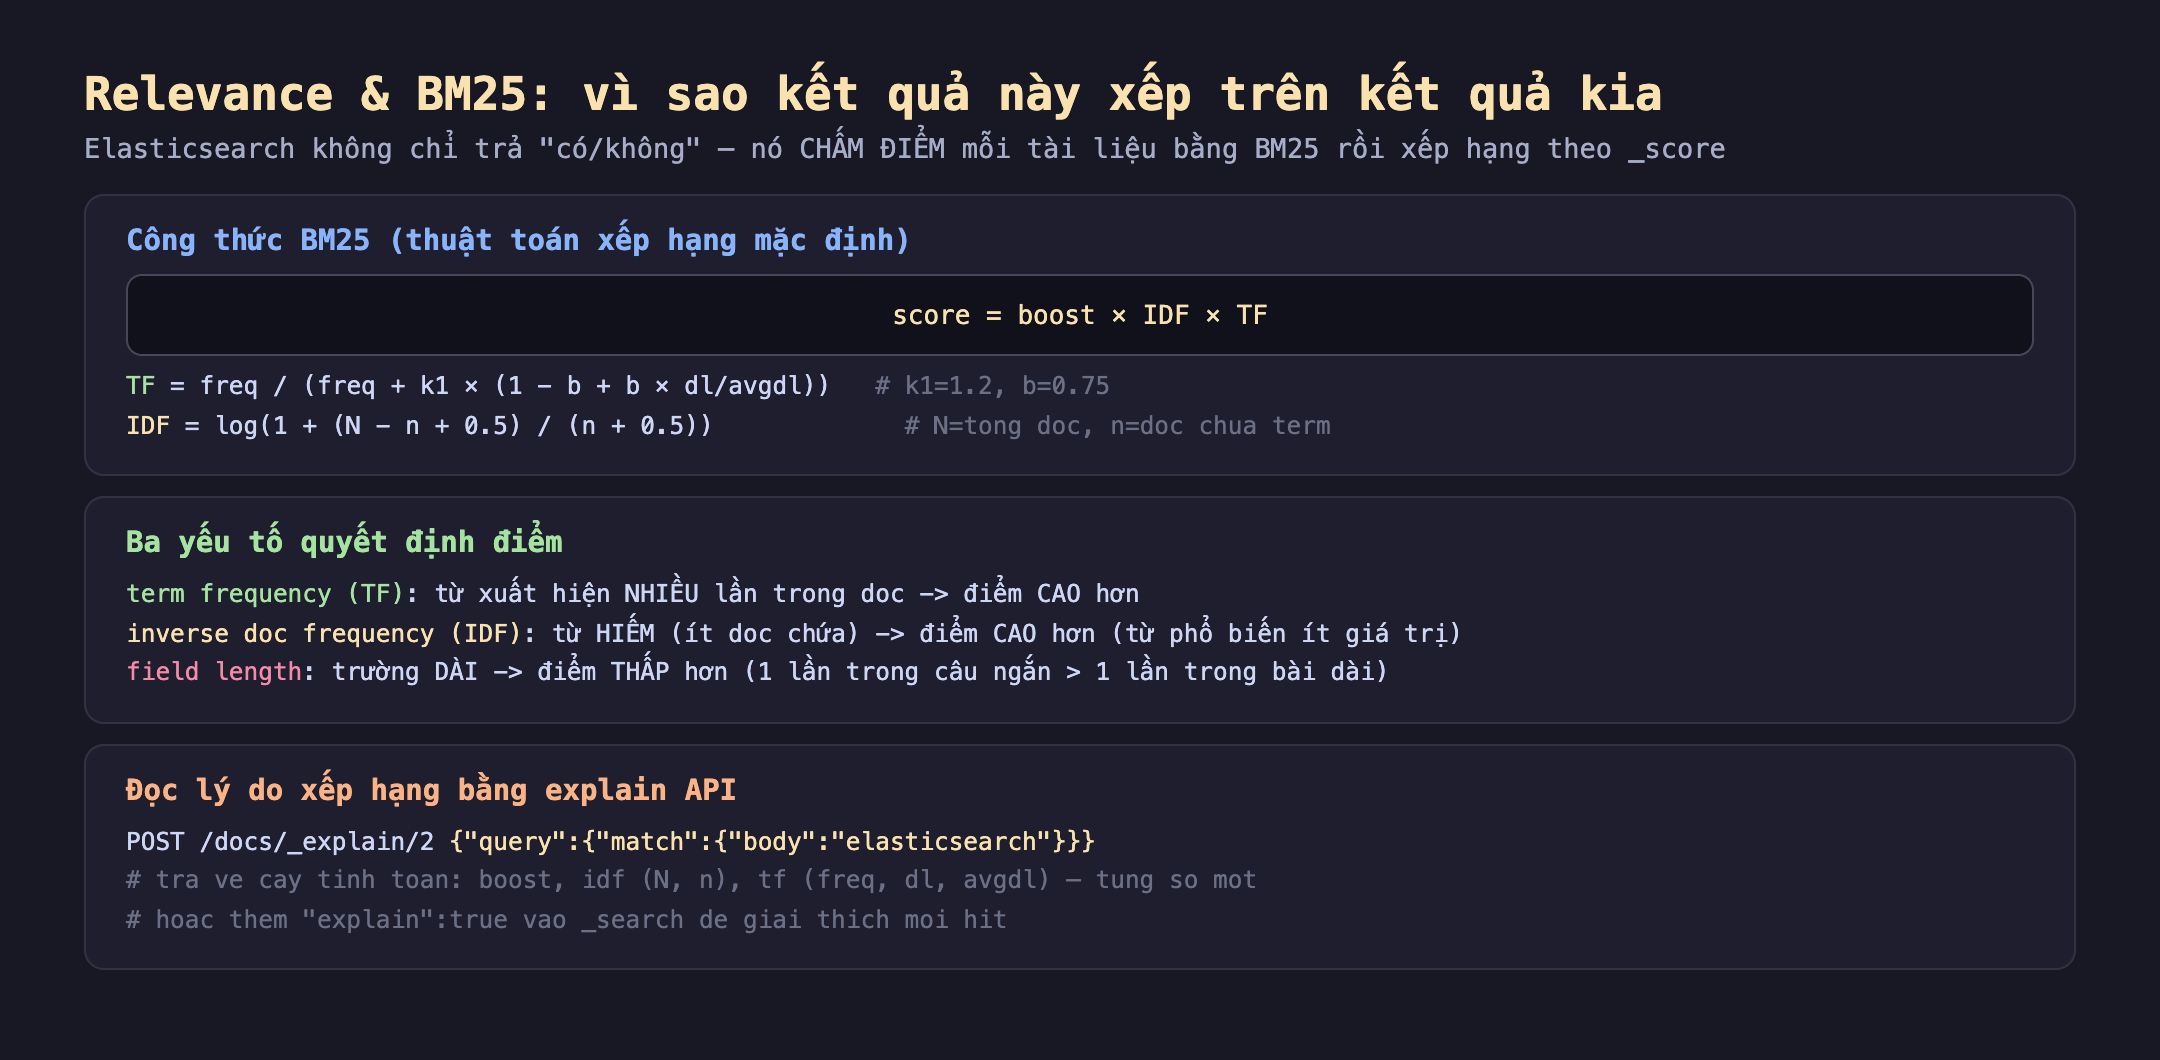
Hình 1: BM25 = boost × IDF × TF. TF cao khi từ xuất hiện nhiều (có bão hòa); IDF cao khi từ hiếm; field length dài làm giảm điểm. explain API cho xem từng con số trong cây tính toán.
# Xem CHINH XAC vi sao mot doc duoc diem nay
curl -XPOST localhost:9200/docs/_explain/2 -H 'Content-Type: application/json' \
  -d '{"query":{"match":{"body":"elasticsearch"}}}'
# -> tra ve cay: boost, idf (N, n), tf (freq, dl, avgdl) tung so mot
# Hoac them "explain":true vao _search de giai thich moi hit
Đo thật: cùng một từ, ba điểm khác nhau
Mình index 4 tài liệu chứa từ "elasticsearch" với tần suất và độ dài khác nhau, rồi tìm "elasticsearch" và dùng _explain để đọc từng con số. Kết quả thật từ es-lab:
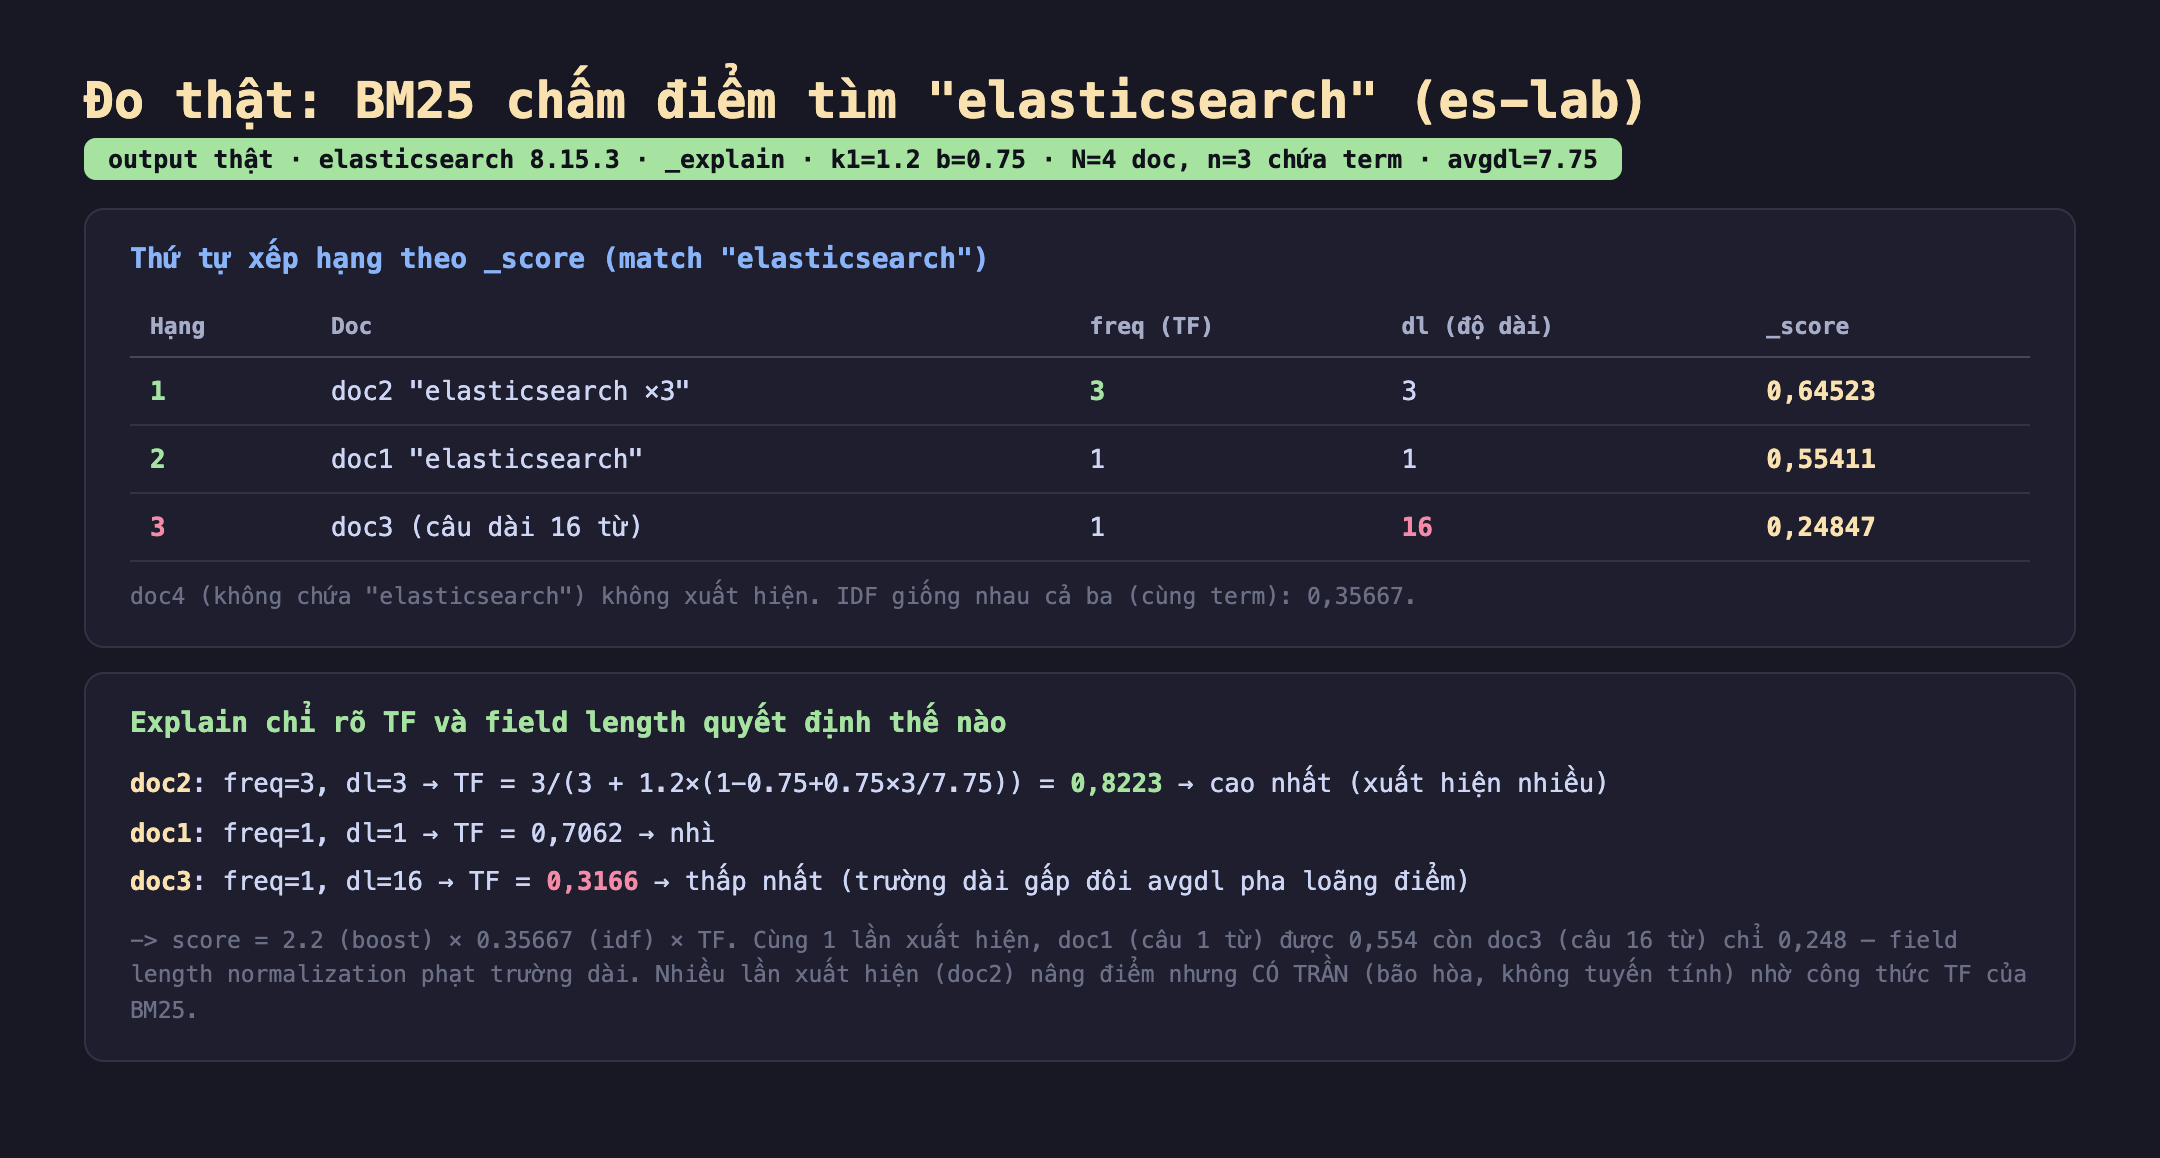
Hình 2: Kết quả thật qua explain. doc2 (từ ×3, câu ngắn) cao nhất 0,645; doc1 (×1, câu 1 từ) 0,554; doc3 (×1, câu 16 từ) thấp nhất 0,248. IDF giống nhau (cùng term); TF và field length tạo ra khác biệt.
Đọc explain, công thức hiện ra rõ ràng với số thật:
- IDF giống nhau cho cả ba:
log(1 + (4−3+0.5)/(3+0.5)) = 0,35667. Vì cùng tìm một từ "elasticsearch" (n=3 tài liệu chứa, N=4 tổng), IDF không phân biệt được chúng. - TF và field length tạo ra toàn bộ khác biệt:
- doc2 (freq=3, dl=3): TF = 3/(3 + 1.2×(1−0.75+0.75×3/7.75)) = 0,8223 → cao nhất. Xuất hiện 3 lần nên điểm cao.
- doc1 (freq=1, dl=1): TF = 0,7062 → nhì. Chỉ 1 lần nhưng câu cực ngắn.
- doc3 (freq=1, dl=16): TF = 0,3166 → thấp nhất. Cùng 1 lần như doc1, nhưng câu dài gấp đôi độ dài trung bình (avgdl=7.75) nên điểm bị pha loãng một nửa.
- score cuối = 2.2 (boost) × 0,35667 (idf) × TF. doc1 và doc3 đều chứa từ đúng 1 lần, nhưng doc1 được 0,554 còn doc3 chỉ 0,248 — chênh hơn 2 lần, chỉ vì độ dài trường. Đó là field length normalization đang làm việc.
Vì sao điều này quan trọng với backend
Khi người dùng than "kết quả tìm kiếm không liên quan", câu trả lời nằm trong _score và explain. Không đoán mò — bạn mở explain ra và thấy chính xác tài liệu nào được điểm bao nhiêu, do TF, IDF hay field length. Từ đó điều chỉnh: tăng boost cho trường quan trọng (tiêu đề > nội dung), đổi tham số k1/b, hay dùng function_score để nhân thêm yếu tố nghiệp vụ (độ mới, lượt bán). BM25 không phải hộp đen — nó là công thức bạn đọc và chỉnh được.
Đánh đổi cần cân nhắc
IDF tính theo từng shard, không toàn cục — kết quả có thể lệch nhẹ khi nhiều shard. N và n trong công thức IDF là của shard đó, không phải toàn index (vì tính toàn cục sẽ tốn một vòng mạng mỗi truy vấn). Với index nhiều shard và dữ liệu phân bố không đều, cùng một tài liệu có thể được điểm hơi khác tùy nằm ở shard nào — đôi khi gây thứ tự "kỳ lạ" ở các kết quả sát điểm nhau. Lab này dùng 1 shard nên không gặp; ở production nhiều shard, nếu cần điểm nhất quán tuyệt đối (thường chỉ khi test), dùng search_type=dfs_query_then_fetch để gom thống kê toàn cục trước — nhưng nó tốn thêm một vòng, hiếm khi đáng.
Tinh chỉnh k1/b là con dao hai lưỡi. k1 điều khiển độ bão hòa của TF (cao = từ lặp lại vẫn tăng điểm mạnh), b điều khiển mức phạt độ dài (b=0 = bỏ qua độ dài, b=1 = phạt tối đa). Mặc định k1=1.2, b=0.75 phù hợp đa số trường hợp và đã được điều chỉnh qua nhiều năm. Chỉnh chúng mà không đo trên tập truy vấn thật (với nhãn "kết quả nào đúng") dễ làm tệ hơn chỗ này trong khi tưởng cải thiện chỗ kia. Chỉnh có cơ sở, không chỉnh theo cảm giác.
_score không phải thứ tự tuyệt đối — kết hợp với tín hiệu nghiệp vụ. BM25 chỉ đo độ liên quan văn bản. Một kết quả BM25 cao nhất chưa chắc là thứ người dùng muốn: bài viết cũ, sản phẩm hết hàng, tài liệu chất lượng thấp vẫn có thể lên đầu. Trong thực tế, bạn thường bọc BM25 trong function_score hoặc kết hợp với các tín hiệu khác (độ mới, độ phổ biến, đánh giá) để ra thứ tự hữu ích, không chỉ liên quan về chữ.
Ba ý mang về
- BM25 chấm điểm bằng ba yếu tố: TF, IDF, field length. Đo thật qua explain: cùng tìm "elasticsearch", doc chứa 3 lần được 0,645, câu 1 từ chứa 1 lần được 0,554, câu 16 từ chứa 1 lần chỉ 0,248. Từ xuất hiện nhiều → điểm cao (có bão hòa); từ hiếm → IDF cao; trường dài → điểm thấp.
- explain API là cách đọc đúng lý do xếp hạng. Đo thật: hai tài liệu cùng chứa từ đúng 1 lần nhưng chênh điểm hơn 2 lần, explain chỉ rõ do field length (dl=1 vs dl=16, avgdl=7.75). Khi kết quả "không liên quan", mở explain ra xem thay vì đoán.
- BM25 chỉnh được nhưng cần cẩn thận. boost theo trường, tham số k1/b, function_score cho tín hiệu nghiệp vụ — tất cả điều chỉnh được. Nhưng IDF tính theo shard (có thể lệch nhẹ khi nhiều shard), và _score chỉ đo liên quan văn bản; kết hợp tín hiệu nghiệp vụ để ra thứ tự hữu ích thật.
Nguồn
- Elasticsearch docs — Theory behind relevance scoring (BM25): https://www.elastic.co/guide/en/elasticsearch/guide/current/scoring-theory.html
- Elasticsearch docs — Explain API: https://www.elastic.co/guide/en/elasticsearch/reference/current/search-explain.html
- Elastic blog — Practical BM25: https://www.elastic.co/blog/practical-bm25-part-2-the-bm25-algorithm-and-its-variables
Phần sau ta học cách kết hợp nhiều điều kiện bằng bool query: must, should, filter, must_not — và đo thật khác biệt giữa filter (có cache, không tính điểm) và must (tính điểm BM25), yếu tố quyết định cả tốc độ lẫn thứ tự.
