Bạn index một tài liệu có tiêu đề "Quick Brown Fox", rồi chạy truy vấn term tìm "Quick" — và nhận về 0 kết quả. Dữ liệu rõ ràng ở đó, truy vấn trông đúng, nhưng Elasticsearch bảo không tìm thấy. Đây là một trong những khoảnh khắc gây hoang mang nhất với người mới dùng ES, và nó bắt nguồn từ việc không hiểu khác biệt giữa ba loại truy vấn phổ biến nhất: match, term, và match_phrase.
Bài này (phần 3 loạt Elasticsearch) nối tiếp bài analyzer để giải mã chính xác câu hỏi "dùng loại truy vấn nào". Mọi con số hits dưới đây là output thật từ es-lab.
Khác biệt cốt lõi: query có đi qua analyzer không
Ba loại truy vấn này chia làm hai nhóm theo một tiêu chí duy nhất: truy vấn có được phân tích (analyze) không.
- match và match_phrase: có phân tích. Chuỗi bạn gõ đi qua cùng analyzer với lúc index (tách từ, lowercase, stemming). "Quick Brown" biến thành token
[quick, brown]trước khi tra. - term: không phân tích. Nó tìm token y nguyên chuỗi bạn đưa vào — "Quick" vẫn là "Quick", không hạ chữ thường.
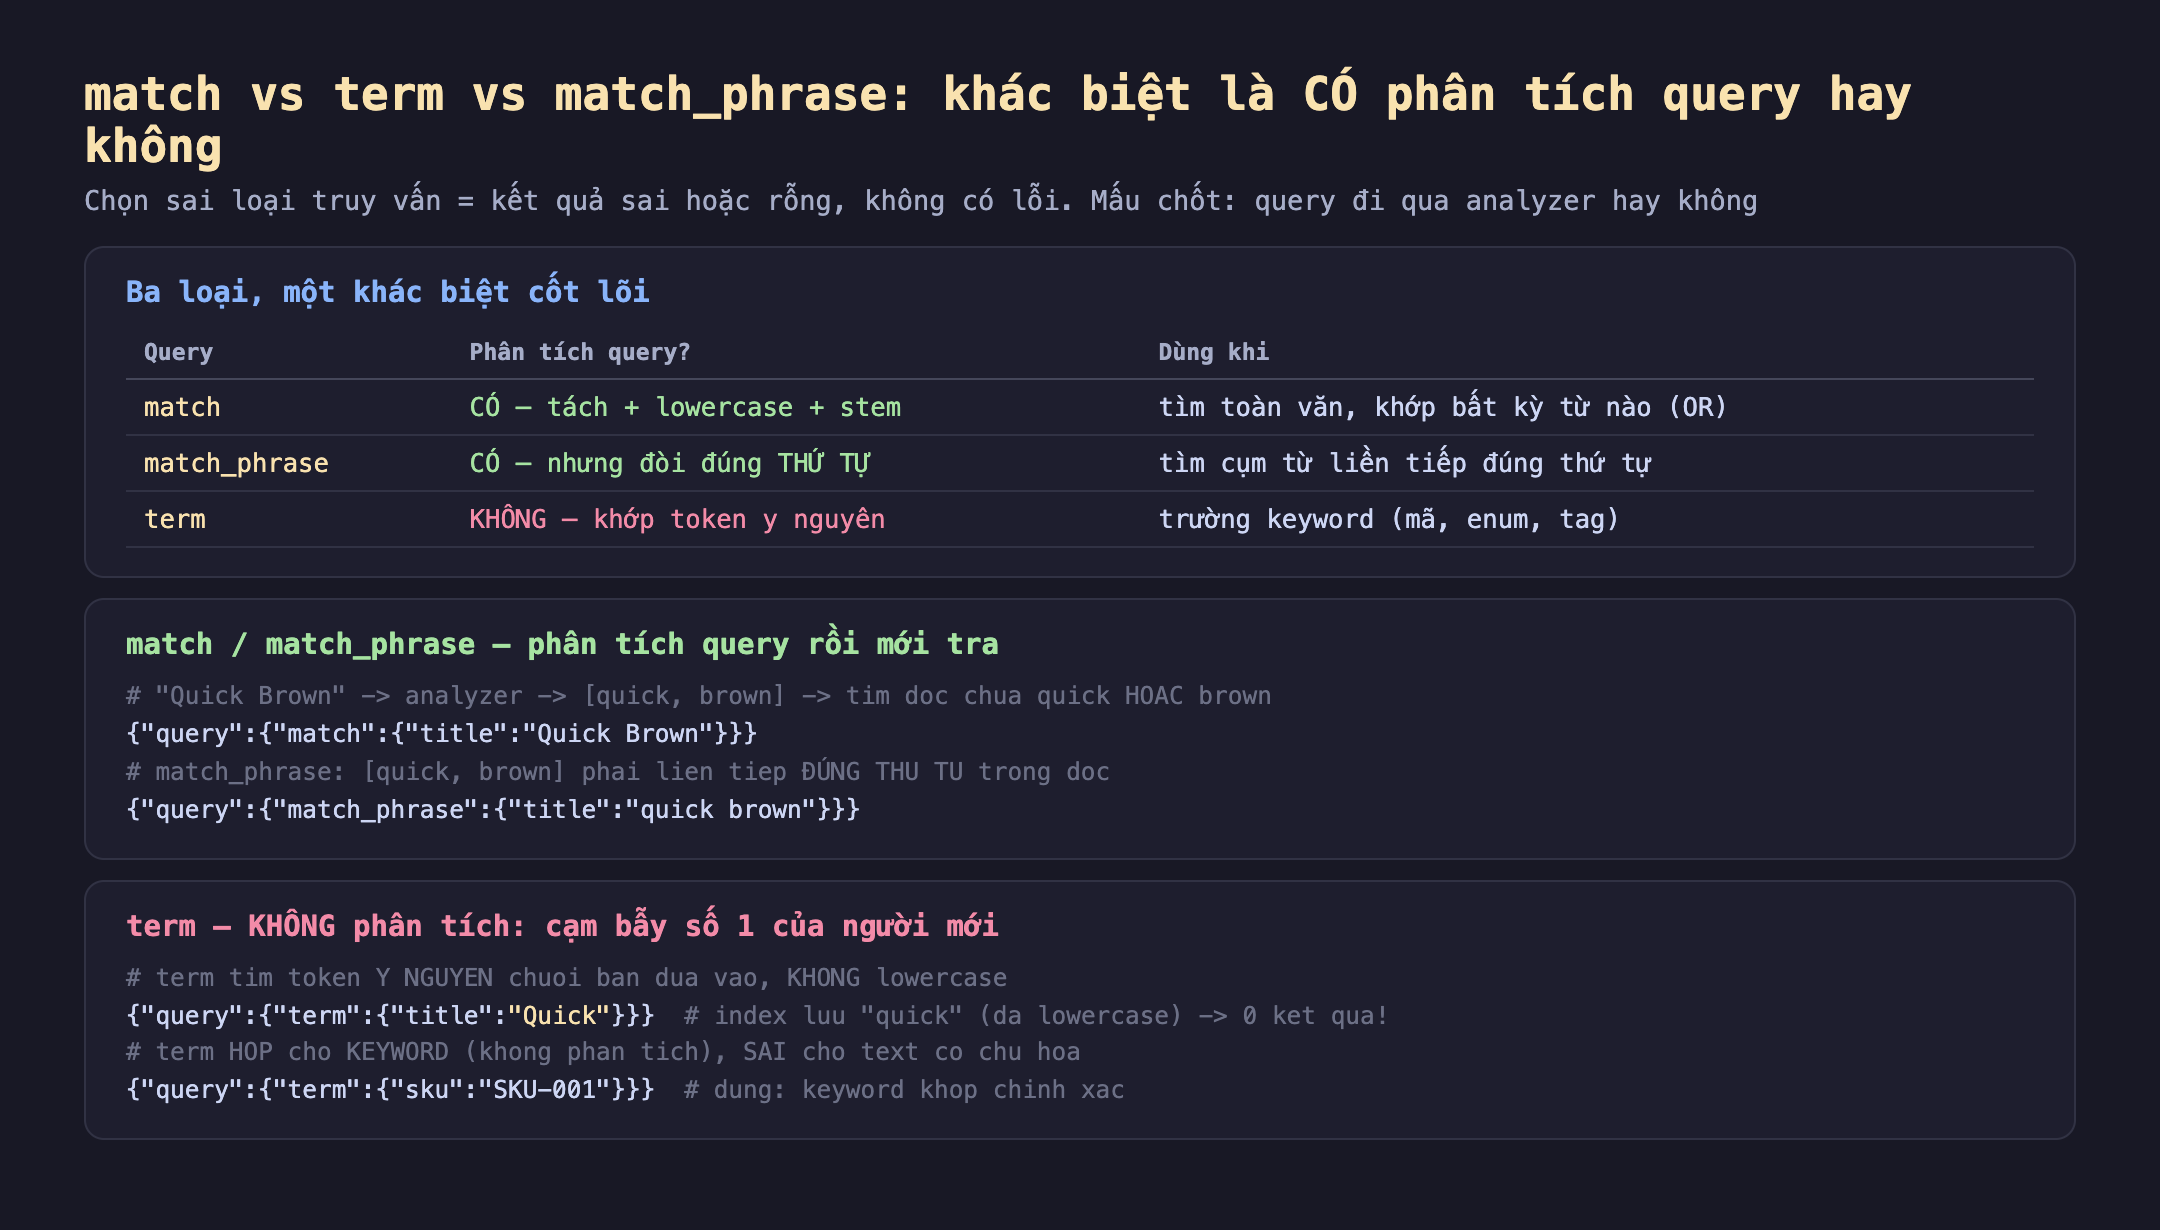
Hình 1: match/match_phrase phân tích query (như lúc index), term thì không. Đó là lý do term "Quick" trên trường text trả về rỗng — index lưu token đã lowercase "quick", còn term tìm literal "Quick".
# match: phan tich "Quick Brown" -> [quick, brown] -> doc chua quick HOAC brown
{"query":{"match":{"title":"Quick Brown"}}}

# match_phrase: [quick, brown] phai LIEN TIEP dung thu tu trong doc
{"query":{"match_phrase":{"title":"quick brown"}}}

# term: tim token Y NGUYEN "Quick" (khong lowercase)
{"query":{"term":{"title":"Quick"}}}
Đo thật: 4 tài liệu, các truy vấn khác nhau
Mình index 4 tài liệu với title kiểu text (qua analyzer) và sku kiểu keyword (không phân tích), rồi chạy từng loại truy vấn. Kết quả thật từ es-lab:
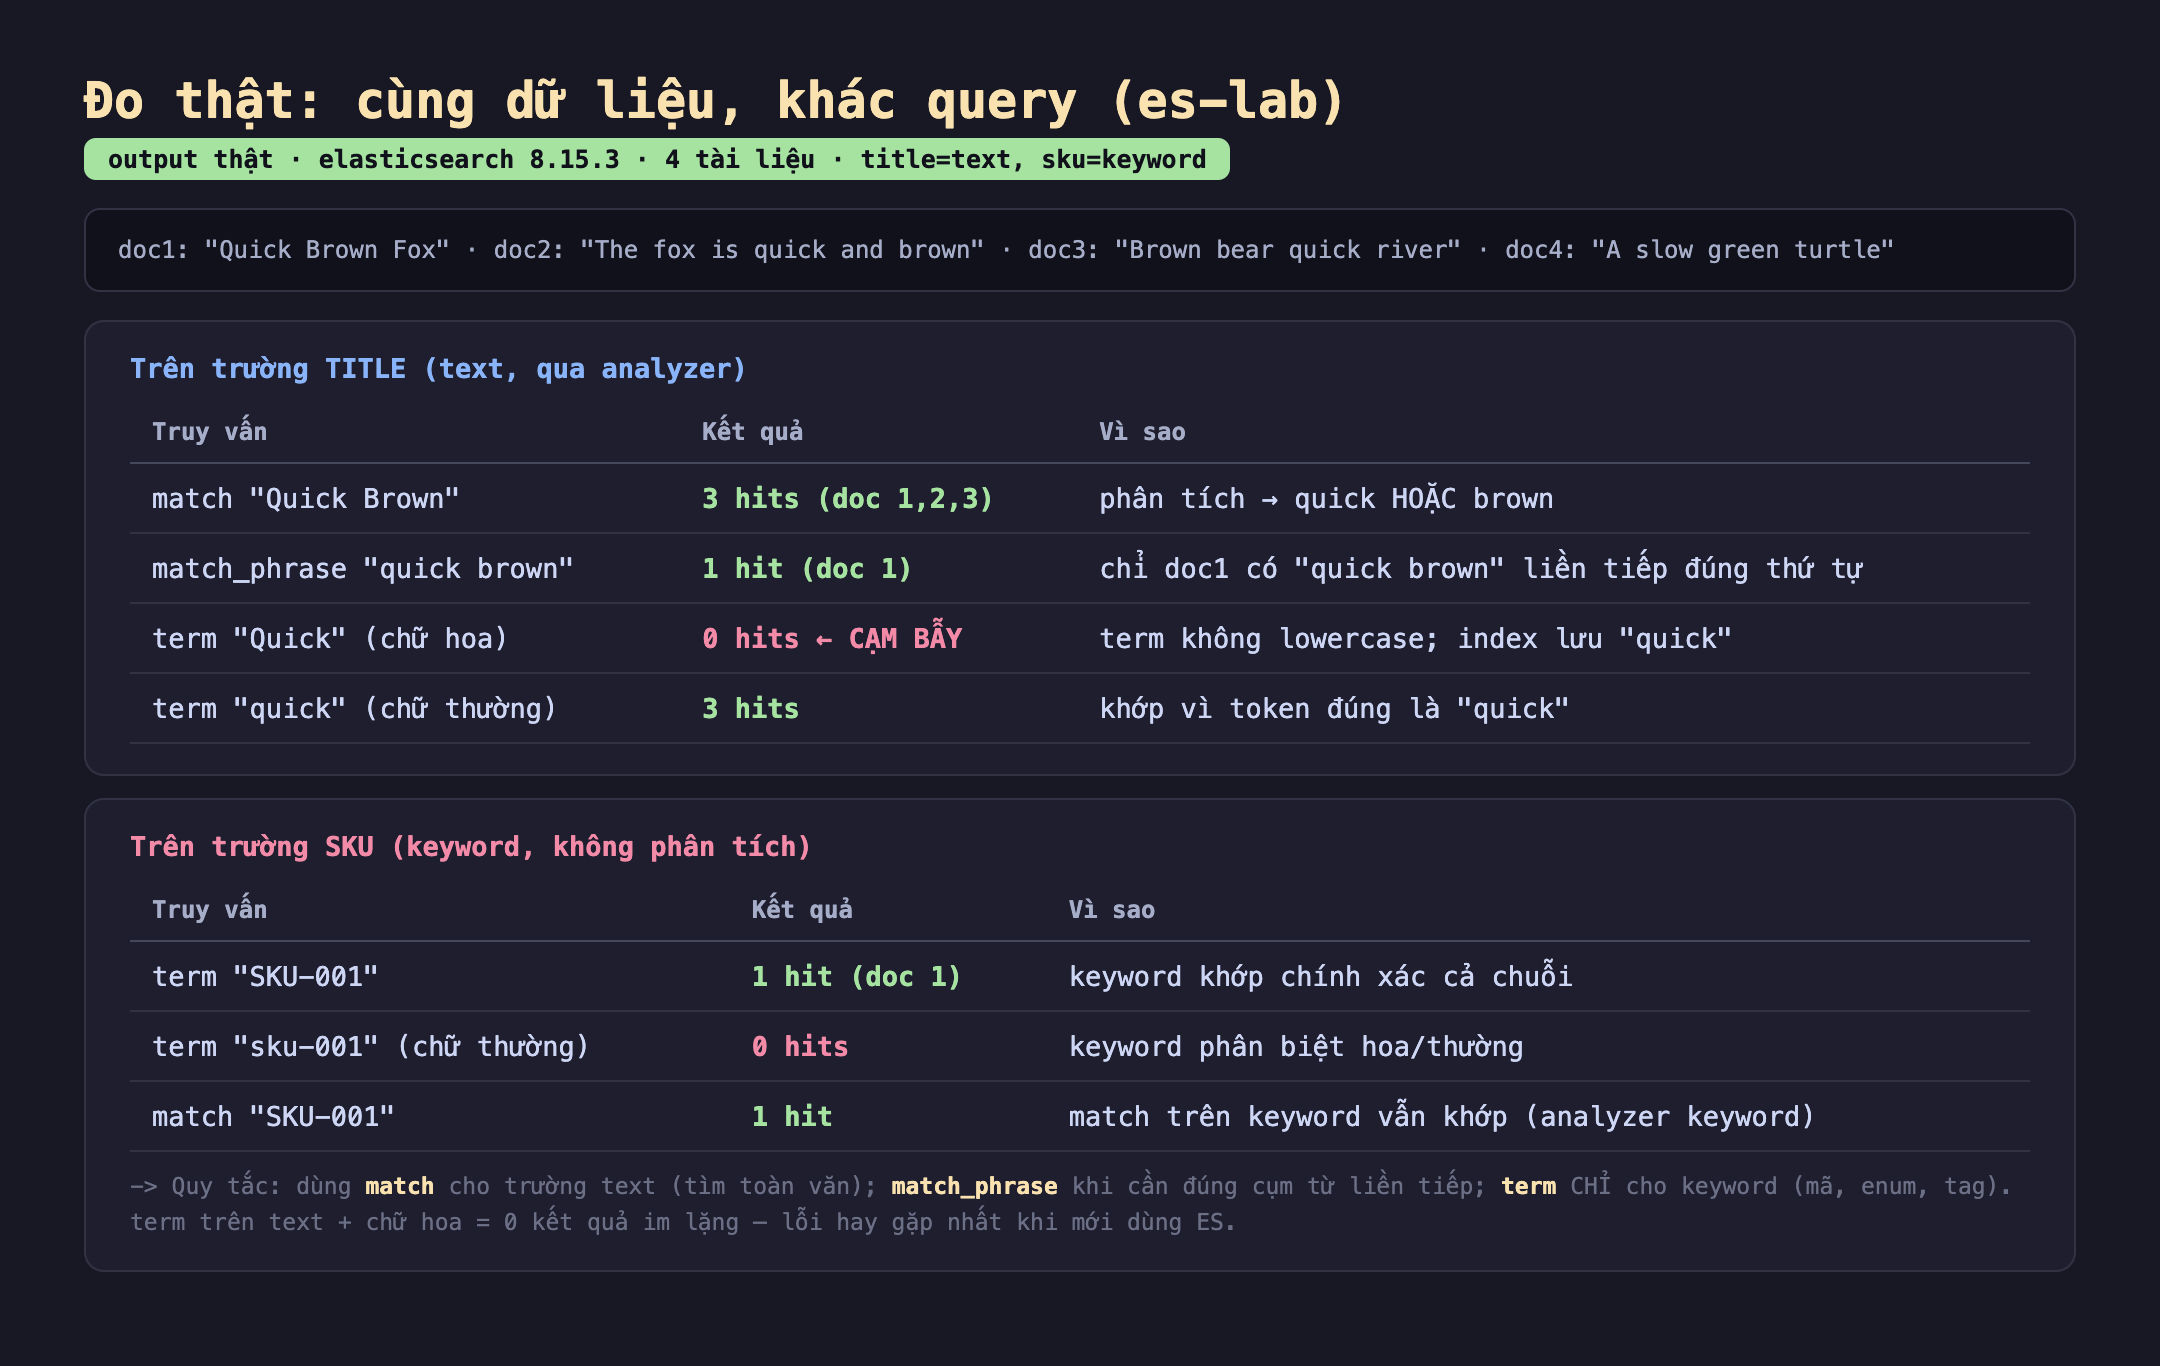
Hình 2: Kết quả thật. match "Quick Brown" → 3 hits (OR của quick/brown); match_phrase → 1 hit (chỉ doc1 có cụm liền tiếp); term "Quick" → 0 hits (cạm bẫy); term "quick" → 3 hits. Trên keyword: term khớp chính xác, phân biệt hoa/thường.
- match "Quick Brown" → 3 hits (doc 1, 2, 3). Query được phân tích thành
[quick, brown], rồi tìm tài liệu chứaquickhoặcbrown. Ba tài liệu đầu đều có ít nhất một trong hai. - match_phrase "quick brown" → 1 hit (doc 1). Cũng phân tích thành
[quick, brown], nhưng đòi hai token liền tiếp đúng thứ tự. Chỉ "Quick Brown Fox" có "quick brown" liền nhau; doc2 "quick and brown" bị chữ "and" chen vào nên trượt. - term "Quick" (chữ hoa) → 0 hits — cạm bẫy. term không phân tích, nên nó tìm token literal "Quick". Nhưng inverted index chỉ lưu "quick" (đã lowercase lúc index). "Quick" ≠ "quick" → không khớp.
- term "quick" (chữ thường) → 3 hits. Giờ literal "quick" khớp đúng token trong index. Chứng tỏ vấn đề nằm ở chữ hoa, không phải dữ liệu.
term đúng chỗ của nó: trường keyword
term không hề vô dụng — nó sinh ra cho trường keyword (không phân tích). Trên trường sku:
- term "SKU-001" → 1 hit. keyword lưu nguyên "SKU-001" làm một token; term khớp chính xác cả chuỗi. Đây là cách bạn lọc theo mã, enum, trạng thái, tag.
- term "sku-001" (chữ thường) → 0 hits. keyword phân biệt hoa/thường và không chuẩn hóa gì; "sku-001" ≠ "SKU-001".
- match "SKU-001" → 1 hit. match trên trường keyword vẫn khớp, vì analyzer của keyword giữ nguyên chuỗi.
Quy tắc rút ra: term cho keyword, match cho text. Dùng term trên text là tự chuốc lấy kết quả rỗng khó hiểu.
Đánh đổi cần cân nhắc
term nhanh hơn match nhưng chỉ đúng khi bạn biết token chính xác. Vì term bỏ qua bước phân tích, nó rẻ hơn một chút và dùng được trong filter context (có cache — bài sau). Nhưng nó đòi bạn biết chính xác token được lưu. Với trường text qua analyzer phức tạp (stemming, lowercase), gần như không thể đoán token, nên dùng match an toàn hơn. Dùng term khi và chỉ khi bạn kiểm soát được giá trị token (keyword).
match_phrase mạnh nhưng chặt — cân nhắc slop. match_phrase đòi các từ liền tiếp đúng thứ tự, nên "quick and brown" không khớp "quick brown". Nếu muốn linh hoạt hơn (cho phép vài từ chen giữa hoặc đảo thứ tự), dùng tham số slop (ví dụ "slop": 2 cho phép dịch chuyển tối đa 2 vị trí). slop cao hơn = khớp nhiều hơn nhưng kém chính xác hơn. Đây là núm chỉnh giữa "đúng cụm từ tuyệt đối" và "gần đúng cụm từ".
match mặc định là OR — biết cách đổi sang AND. match "Quick Brown" trả về tài liệu chứa bất kỳ từ nào (OR), nên doc3 "Brown bear" (chỉ có brown) cũng lọt vào. Nếu muốn đòi tất cả từ, dùng "operator": "and", hoặc minimum_should_match để đòi tối thiểu k từ. Mặc định OR cho recall cao; AND cho precision cao. Chọn theo việc bạn muốn "tìm rộng" hay "tìm chặt".
Ba ý mang về
- Khác biệt cốt lõi: match/match_phrase phân tích query, term thì không. Đo thật: term "Quick" (chữ hoa) trên trường text trả về 0 kết quả vì index lưu token lowercase "quick", trong khi term "quick" cho 3 hits. match tự lowercase nên không vướng lỗi này. Đây là cạm bẫy số 1 của người mới.
- Mỗi loại cho một mục đích. match cho tìm toàn văn (mặc định OR, khớp bất kỳ từ nào); match_phrase cho cụm từ liền tiếp đúng thứ tự (đo thật: chỉ 1/3 tài liệu khớp); term cho trường keyword khớp chính xác (mã, enum, tag). term trên text + chữ hoa = rỗng im lặng.
- term hợp với keyword, phân biệt hoa/thường. Đo thật: term "SKU-001" khớp chính xác, "sku-001" thì không. Dùng term trong filter context để có cache; dùng match_phrase với slop nếu cần cụm từ linh hoạt; dùng operator and/minimum_should_match để siết match từ OR sang AND.
Nguồn
- Elasticsearch docs — Term query: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-dsl-term-query.html
- Elasticsearch docs — Match query & match_phrase: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-dsl-match-query.html
- Elasticsearch docs — Term vs full text queries: https://www.elastic.co/guide/en/elasticsearch/reference/current/term-level-queries.html
Phần sau ta mổ xẻ relevance: vì sao kết quả này xếp trên kết quả kia, thuật toán BM25 tính _score thế nào, và dùng explain API để đọc đúng lý do xếp hạng — đo thật trên es-lab.
