Bài trước cho thấy inverted index tra cứu theo từ (term). Nhưng câu hỏi chưa được trả lời: "từ" là gì? Khi bạn index câu "The Quick-Brown Foxes jumped", Elasticsearch lưu những term nào? "The"? "Quick-Brown" hay "Quick" và "Brown" riêng? "Foxes" hay "fox"? Câu trả lời do analyzer quyết định — và đây là một trong những thứ gây bối rối nhất với người mới, vì nó âm thầm quyết định truy vấn của bạn khớp hay trượt.
Bài này (phần 2 loạt Elasticsearch) mở nắp bước phân tích văn bản: analyzer gồm những gì, các analyzer phổ biến sinh ra token khác nhau thế nào, và vì sao chọn sai analyzer khiến một truy vấn đúng vẫn không ra kết quả. Mọi token dưới đây là output thật từ _analyze trên es-lab.
Cơ chế: analyzer là một pipeline 3 tầng
Một analyzer biến văn bản thô thành chuỗi token qua ba bước, theo thứ tự:
- char_filter: xử lý ở mức ký tự trước khi tách từ. Ví dụ
html_stripgỡ thẻ HTML. - tokenizer: cắt văn bản thành các token. Ví dụ
standardcắt theo khoảng trắng và dấu câu. - token_filter: biến đổi từng token. Ví dụ
lowercase(hạ chữ thường),stemming(đưa về gốc từ), bỏstop words(the, a, over...).
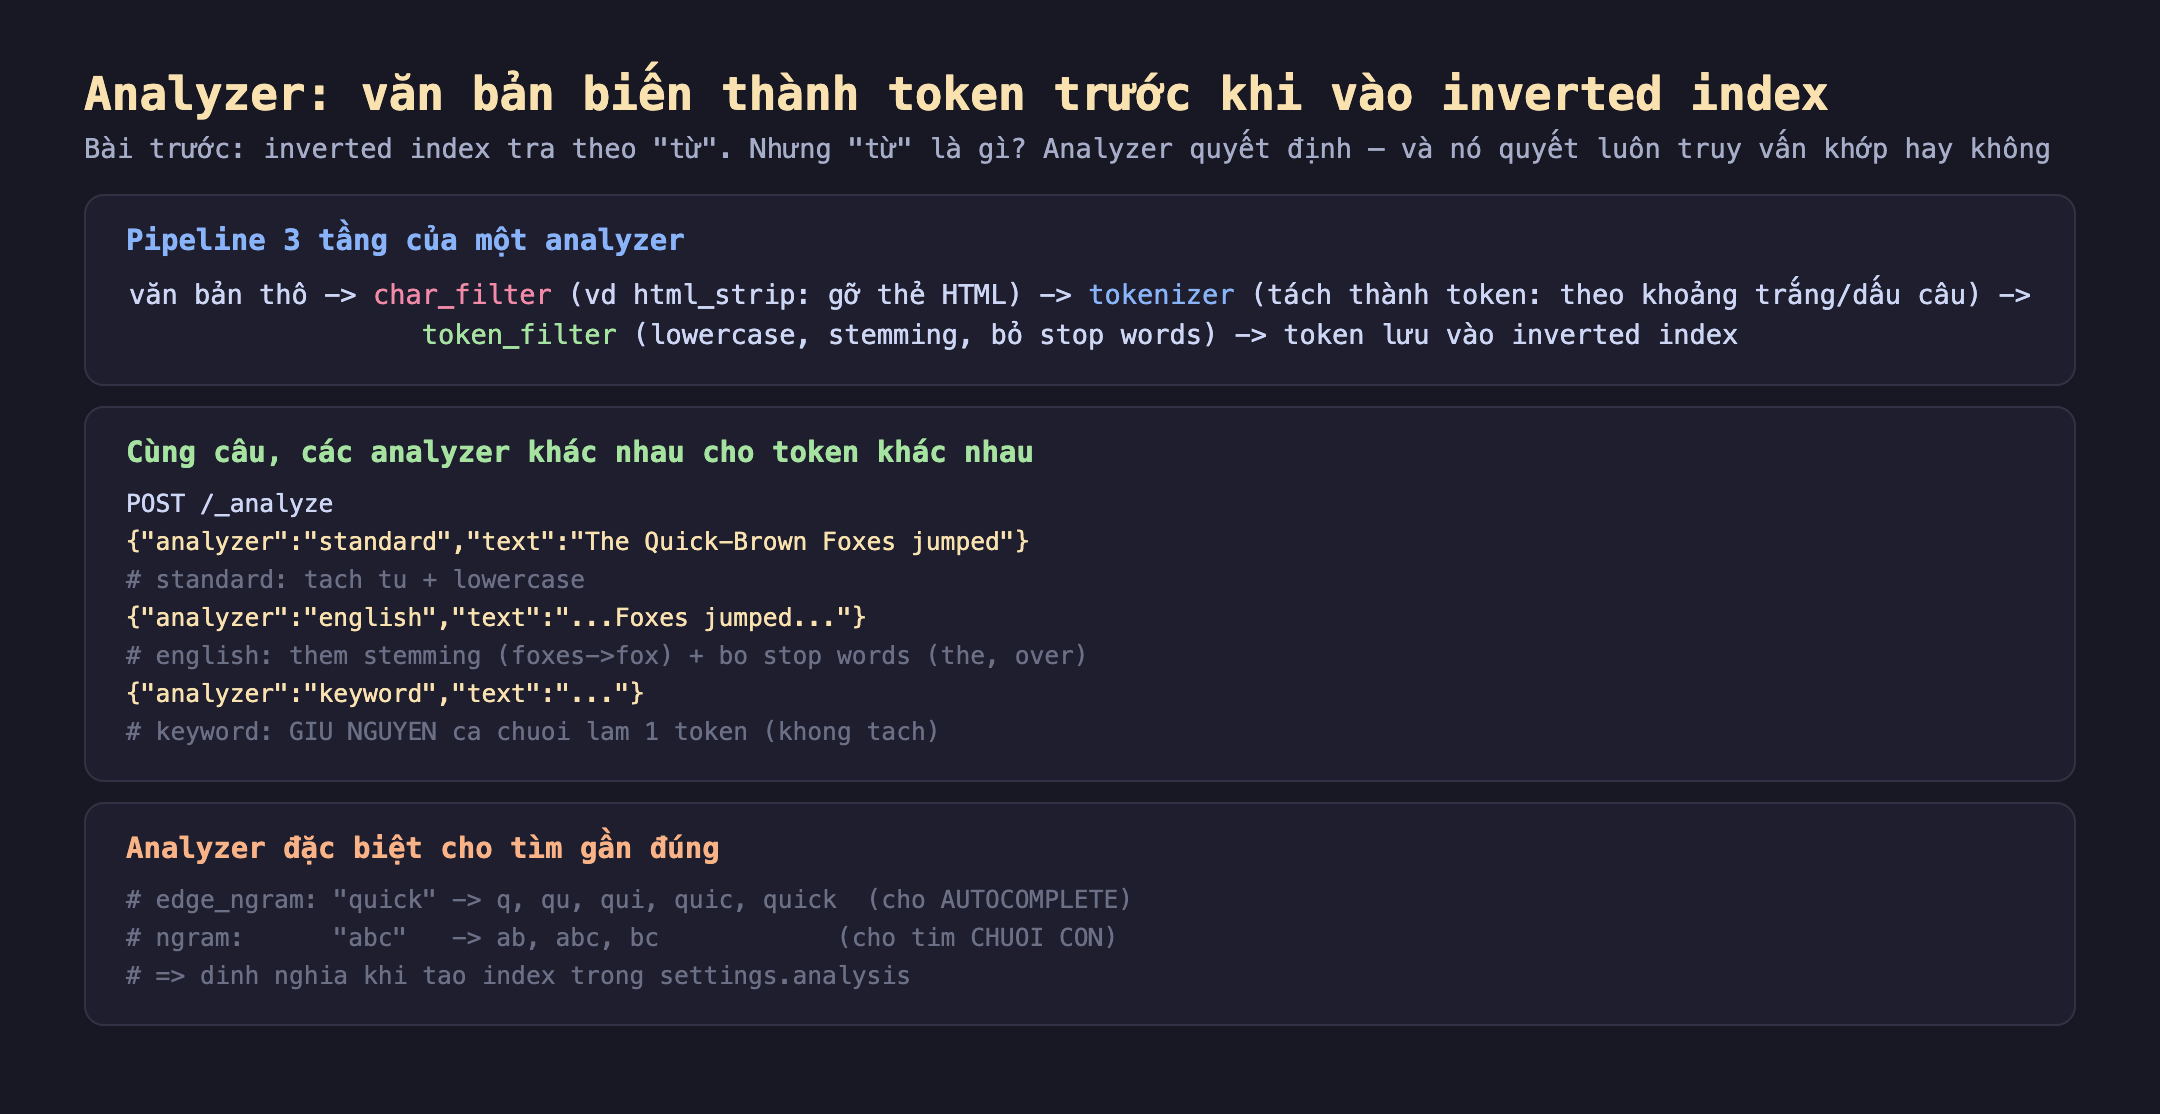
Hình 1: Analyzer = char_filter → tokenizer → token_filter. Cùng một câu, analyzer khác nhau cho token khác nhau: standard (tách + lowercase), english (thêm stemming + bỏ stop words), keyword (giữ nguyên cả chuỗi).
# Xem truc tiep token ma mot analyzer sinh ra — khong can index
curl -XPOST localhost:9200/_analyze -H 'Content-Type: application/json' -d '{
  "analyzer": "english",
  "text": "The Quick-Brown Foxes jumped"
}'
_analyze là công cụ vàng để gỡ lỗi: nó cho bạn thấy chính xác token nào được tạo, mà không cần index gì. Mỗi khi "truy vấn không ra kết quả mà đáng lẽ phải ra", việc đầu tiên nên làm là chạy _analyze trên cả văn bản lẫn truy vấn để xem token có gặp nhau không.
Đo thật: cùng một câu, ba analyzer, ba kết quả
Mình đưa câu "The Quick-Brown Foxes jumped over 2 lazy DOGS, emailing John@example.com!" qua ba analyzer. Token thật từ es-lab:
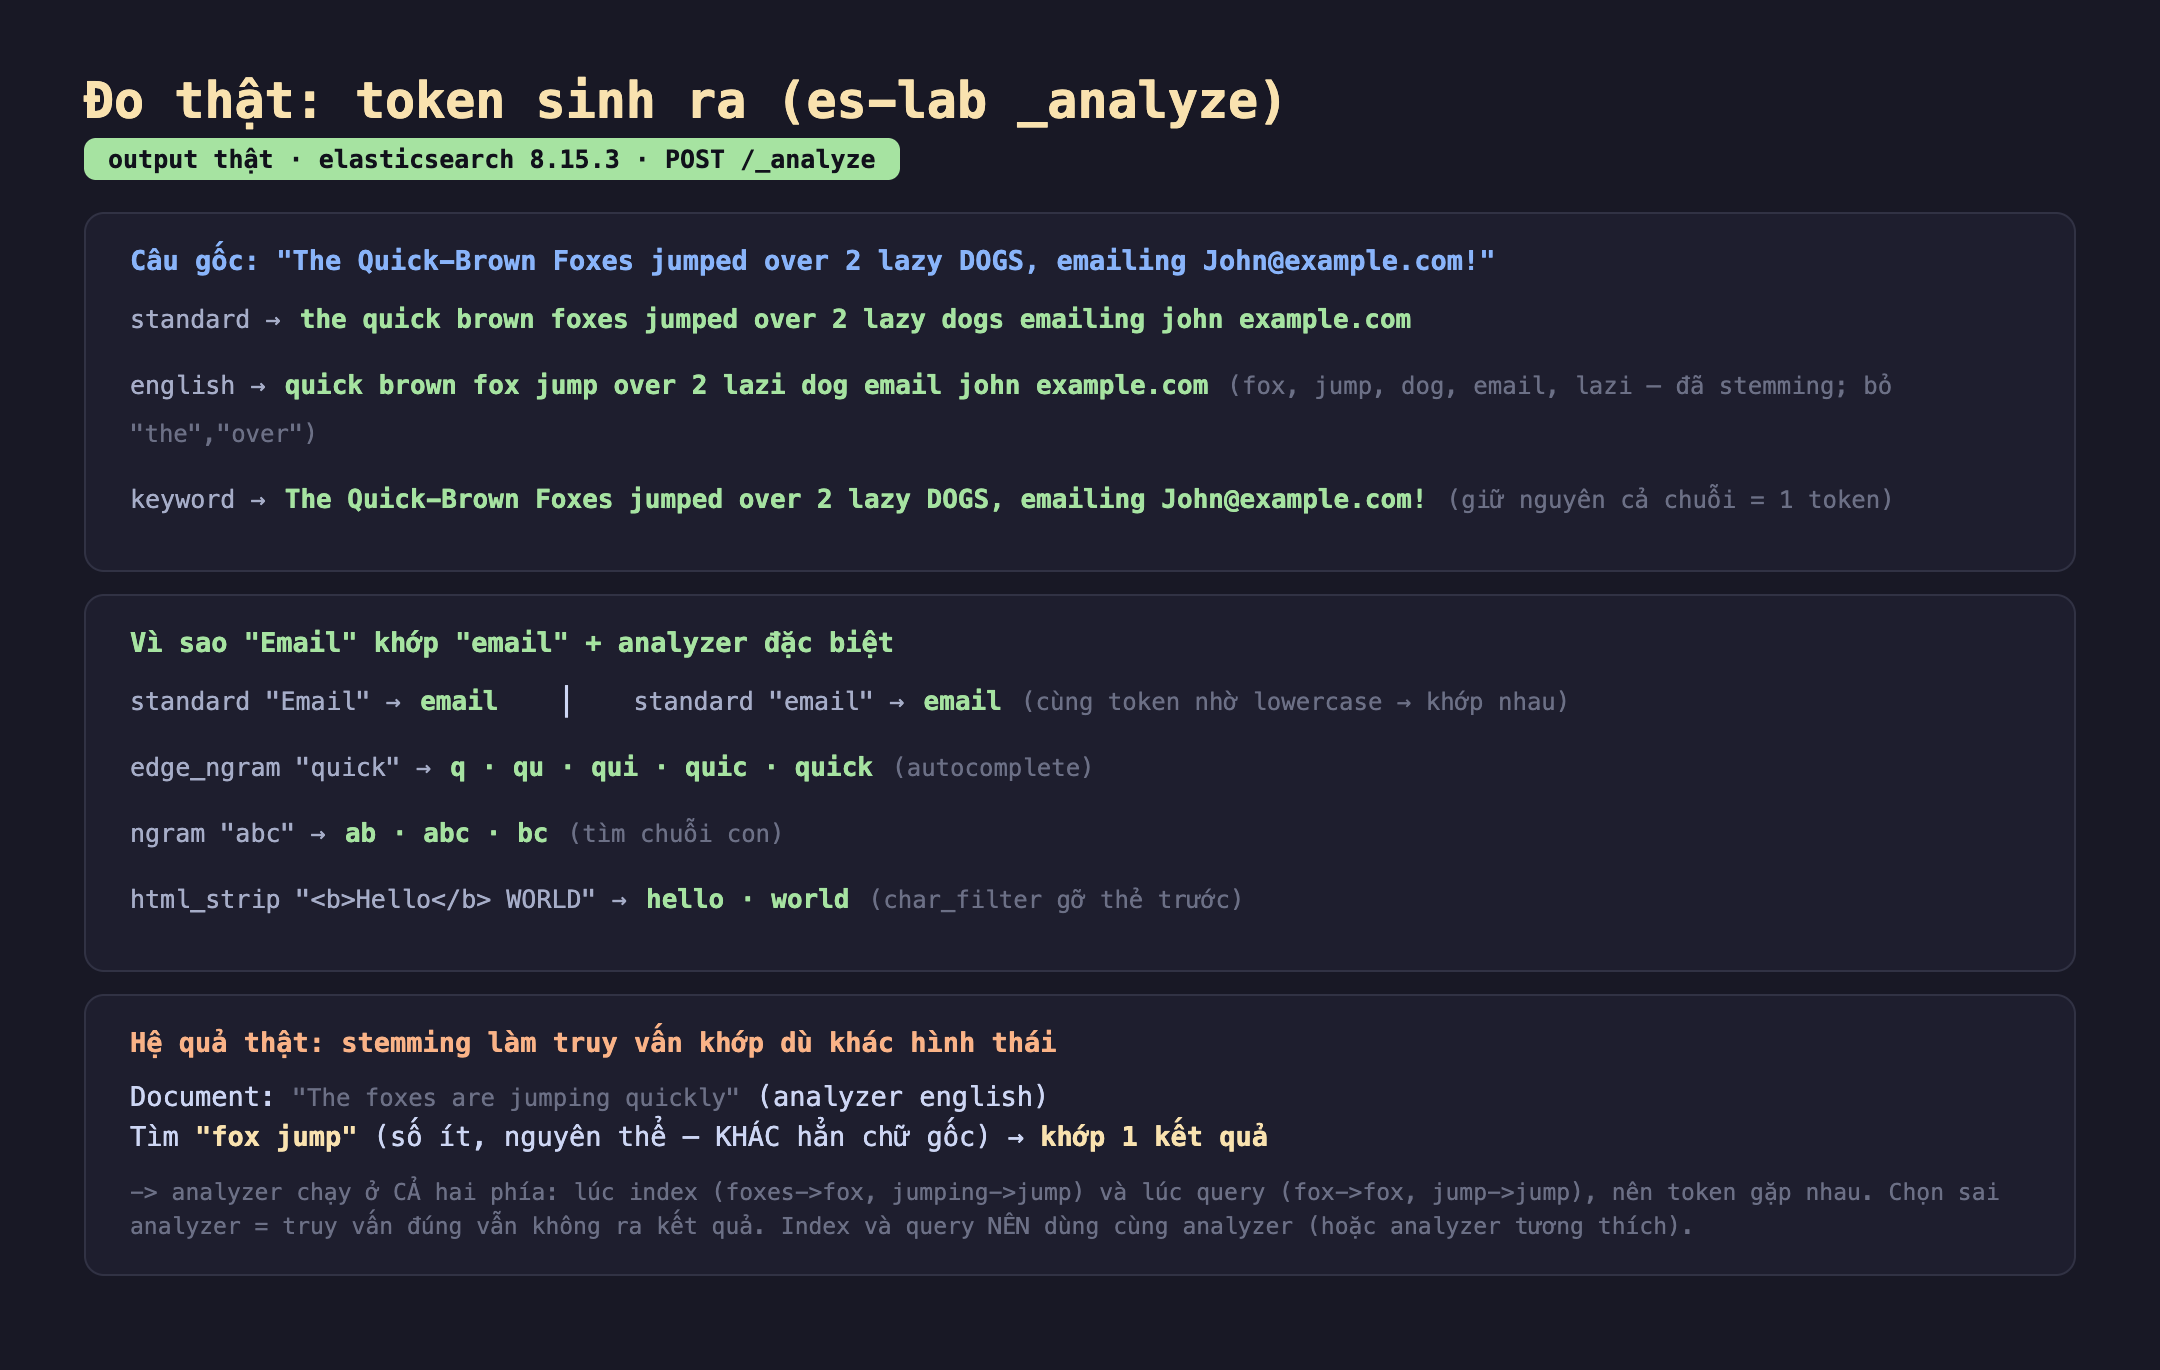
Hình 2: Token thật. standard tách từ + lowercase; english thêm stemming (foxes→fox, jumped→jump, lazy→lazi, dogs→dog) và bỏ stop words (the, over); keyword giữ nguyên cả chuỗi. edge_ngram/ngram cho tìm gần đúng; stemming làm "fox jump" khớp "The foxes are jumping".
- standard (mặc định):
the quick brown foxes jumped over 2 lazy dogs emailing john example.com. Tách theo khoảng trắng/dấu câu, hạ chữ thường. "Quick-Brown" tách thành "quick" + "brown"; email bị cắt thành "john" + "example.com". - english:
quick brown fox jump over 2 lazi dog email john example.com. Ngoài tách + lowercase, nó stemming (đưa về gốc: foxes→fox, jumped→jump, dogs→dog, emailing→email, thậm chí lazy→lazi theo thuật toán stem) và bỏ stop words ("the" biến mất). Token ít hơn, khái quát hơn. - keyword: giữ nguyên văn cả chuỗi làm một token duy nhất. Không tách gì. Dùng cho mã, enum, tag — nơi bạn muốn khớp chính xác toàn bộ.
Vì sao "Email" khớp "email" — và các analyzer đặc biệt
Câu hỏi kinh điển của người mới: vì sao gõ "email" tìm được tài liệu viết "Email"? Vì lowercase filter chạy ở cả hai phía: cả "Email" lẫn "email" đều biến thành token email, nên chúng gặp nhau trong inverted index. Đo thật: _analyze cả "Email" và "email" đều cho đúng một token email.
Ngoài ba analyzer phổ biến, còn các analyzer chuyên dụng cho tìm gần đúng:
- edge_ngram cho autocomplete: "quick" →
q, qu, qui, quic, quick. Index các tiền tố, nên gõ "qui" khớp ngay "quick" — nền tảng của gợi ý khi gõ (bài 11 sẽ đo). - ngram cho tìm chuỗi con: "abc" →
ab, abc, bc. Đây chính là cách giải bài toán*needle*ở bài trước mà không cần quét: chia nhỏ thành n-gram lúc index, để lúc tìm chỉ cần match. - html_strip (char_filter):
<b>Hello</b> WORLD→hello, world— gỡ thẻ HTML trước khi tách.
Hệ quả thật: analyzer quyết định truy vấn khớp hay trượt
Đây là lý do analyzer quan trọng với một kỹ sư backend. Mình index một tài liệu "The foxes are jumping quickly" với analyzer english, rồi tìm "fox jump" — một chuỗi khác hẳn về hình thái (số ít, nguyên thể). Kết quả: khớp 1 tài liệu.
Vì sao? Vì analyzer chạy ở cả hai phía:
- Lúc index: "foxes"→
fox, "jumping"→jumpđược lưu vào inverted index. - Lúc query: "fox"→
fox, "jump"→jump. - Token gặp nhau → khớp.
Đây vừa là sức mạnh vừa là cạm bẫy: nếu bạn index bằng một analyzer và query bằng analyzer khác không tương thích, token sẽ không gặp nhau, và truy vấn đúng vẫn không ra kết quả — không có lỗi, không có cảnh báo, chỉ là 0 hits.
Đánh đổi cần cân nhắc
Stemming tăng recall nhưng giảm precision. Analyzer english gộp "fox" và "foxes", "organize" và "organization" về cùng gốc — tìm được nhiều hơn (recall cao). Nhưng nó cũng có thể gộp những từ không nên gộp (stemming thô bạo: "universe" và "university" có thể cùng gốc "univers"), trả về kết quả không liên quan (precision thấp). Với dữ liệu cần chính xác tuyệt đối (mã sản phẩm, tên riêng), dùng keyword hoặc analyzer nhẹ hơn; với văn bản tự nhiên cần tìm "đại khái", stemming đáng giá.
text vs keyword là quyết định mapping quan trọng nhất (bài 7 sẽ đo). Cùng một chuỗi, lưu kiểu text (qua analyzer, tách token) cho tìm toàn văn, còn keyword (không phân tích, một token) cho lọc/sắp xếp/gom nhóm chính xác. Chọn sai làm hỏng truy vấn: dùng text cho một trường enum thì không lọc chính xác được, dùng keyword cho một đoạn văn thì không tìm toàn văn được. Thường ta khai cả hai (text + .keyword) cho một trường.
Index và query phải dùng analyzer tương thích. Như demo cho thấy, token phải gặp nhau. Mặc định ES dùng cùng analyzer cho index và search, nên thường không phải lo. Nhưng khi bạn tùy biến (ví dụ edge_ngram lúc index để autocomplete), phải cẩn thận đặt search_analyzer riêng — nếu không, gõ "qui" cũng bị cắt thành n-gram và cho kết quả sai. Đây là lỗi tinh vi hay gặp khi làm autocomplete.
Ba ý mang về
- Analyzer quyết định "từ" là gì, qua pipeline 3 tầng. char_filter → tokenizer → token_filter. Đo thật: cùng một câu, standard cho token tách+lowercase, english thêm stemming (foxes→fox) + bỏ stop words, keyword giữ nguyên cả chuỗi làm một token. Dùng
_analyzeđể xem token thật khi gỡ lỗi. - Analyzer chạy ở cả hai phía nên quyết định truy vấn khớp hay trượt. Đo thật: tìm "fox jump" khớp tài liệu "The foxes are jumping quickly" vì stemming đưa cả hai về cùng token. "Email" khớp "email" nhờ lowercase. Chọn sai/không tương thích analyzer = truy vấn đúng vẫn 0 kết quả, không báo lỗi.
- Chọn analyzer là đánh đổi recall vs precision, và text vs keyword. Stemming tìm được nhiều hơn nhưng có thể kém chính xác; dùng keyword cho khớp chính xác (mã, tag), text cho toàn văn; edge_ngram/ngram cho autocomplete/chuỗi con nhưng phải đặt search_analyzer đúng.
Nguồn
- Elasticsearch docs — Text analysis, Analyzers: https://www.elastic.co/guide/en/elasticsearch/reference/current/analysis.html
- Elasticsearch docs — Analyze API: https://www.elastic.co/guide/en/elasticsearch/reference/current/indices-analyze.html
- Elasticsearch docs — Anatomy of an analyzer: https://www.elastic.co/guide/en/elasticsearch/reference/current/analyzer-anatomy.html
Phần sau ta so ba loại truy vấn hay nhầm lẫn nhất: match, term và match_phrase — vì sao term trên trường text thường trả về rỗng, và khi nào dùng loại nào, đo thật trên cùng một tập dữ liệu.
