Mọi lập trình viên backend đều từng viết WHERE name LIKE '%keyword%' để tìm kiếm, và đều từng thấy nó chậm dần khi bảng lớn lên. Lý do rất cơ bản: LIKE '%x%' không dùng được index B-tree — database phải đọc từng dòng, kiểm tra xem chuỗi có chứa x không. Đó là quét toàn bảng (full scan), O(n) theo số dòng.
Elasticsearch giải bài toán này bằng một cấu trúc dữ liệu lật ngược hoàn toàn cách nghĩ: inverted index. Đây là trái tim của mọi công cụ tìm kiếm toàn văn, và là lý do ES tìm trong hàng triệu tài liệu mà vẫn trả kết quả trong mili giây. Bài này (phần 1 loạt Elasticsearch) mở inverted index ra, và đo thật khoảng cách giữa nó và lối quét kiểu LIKE.
Cơ chế: lật ngược từ "tài liệu chứa từ" thành "từ nằm ở tài liệu nào"
Một database thường (forward index) lưu: tài liệu X chứa những từ nào. Để tìm "tài liệu nào chứa từ beta", nó phải mở từng tài liệu ra xem — quét tuyến tính.
Inverted index lật ngược: với mỗi từ, nó lưu sẵn danh sách tài liệu chứa từ đó (gọi là posting list). Giờ tìm "beta" chỉ là: tra từ "beta" trong từ điển term (term dictionary) → nhảy thẳng tới posting list của nó. Không mở tài liệu nào cả.
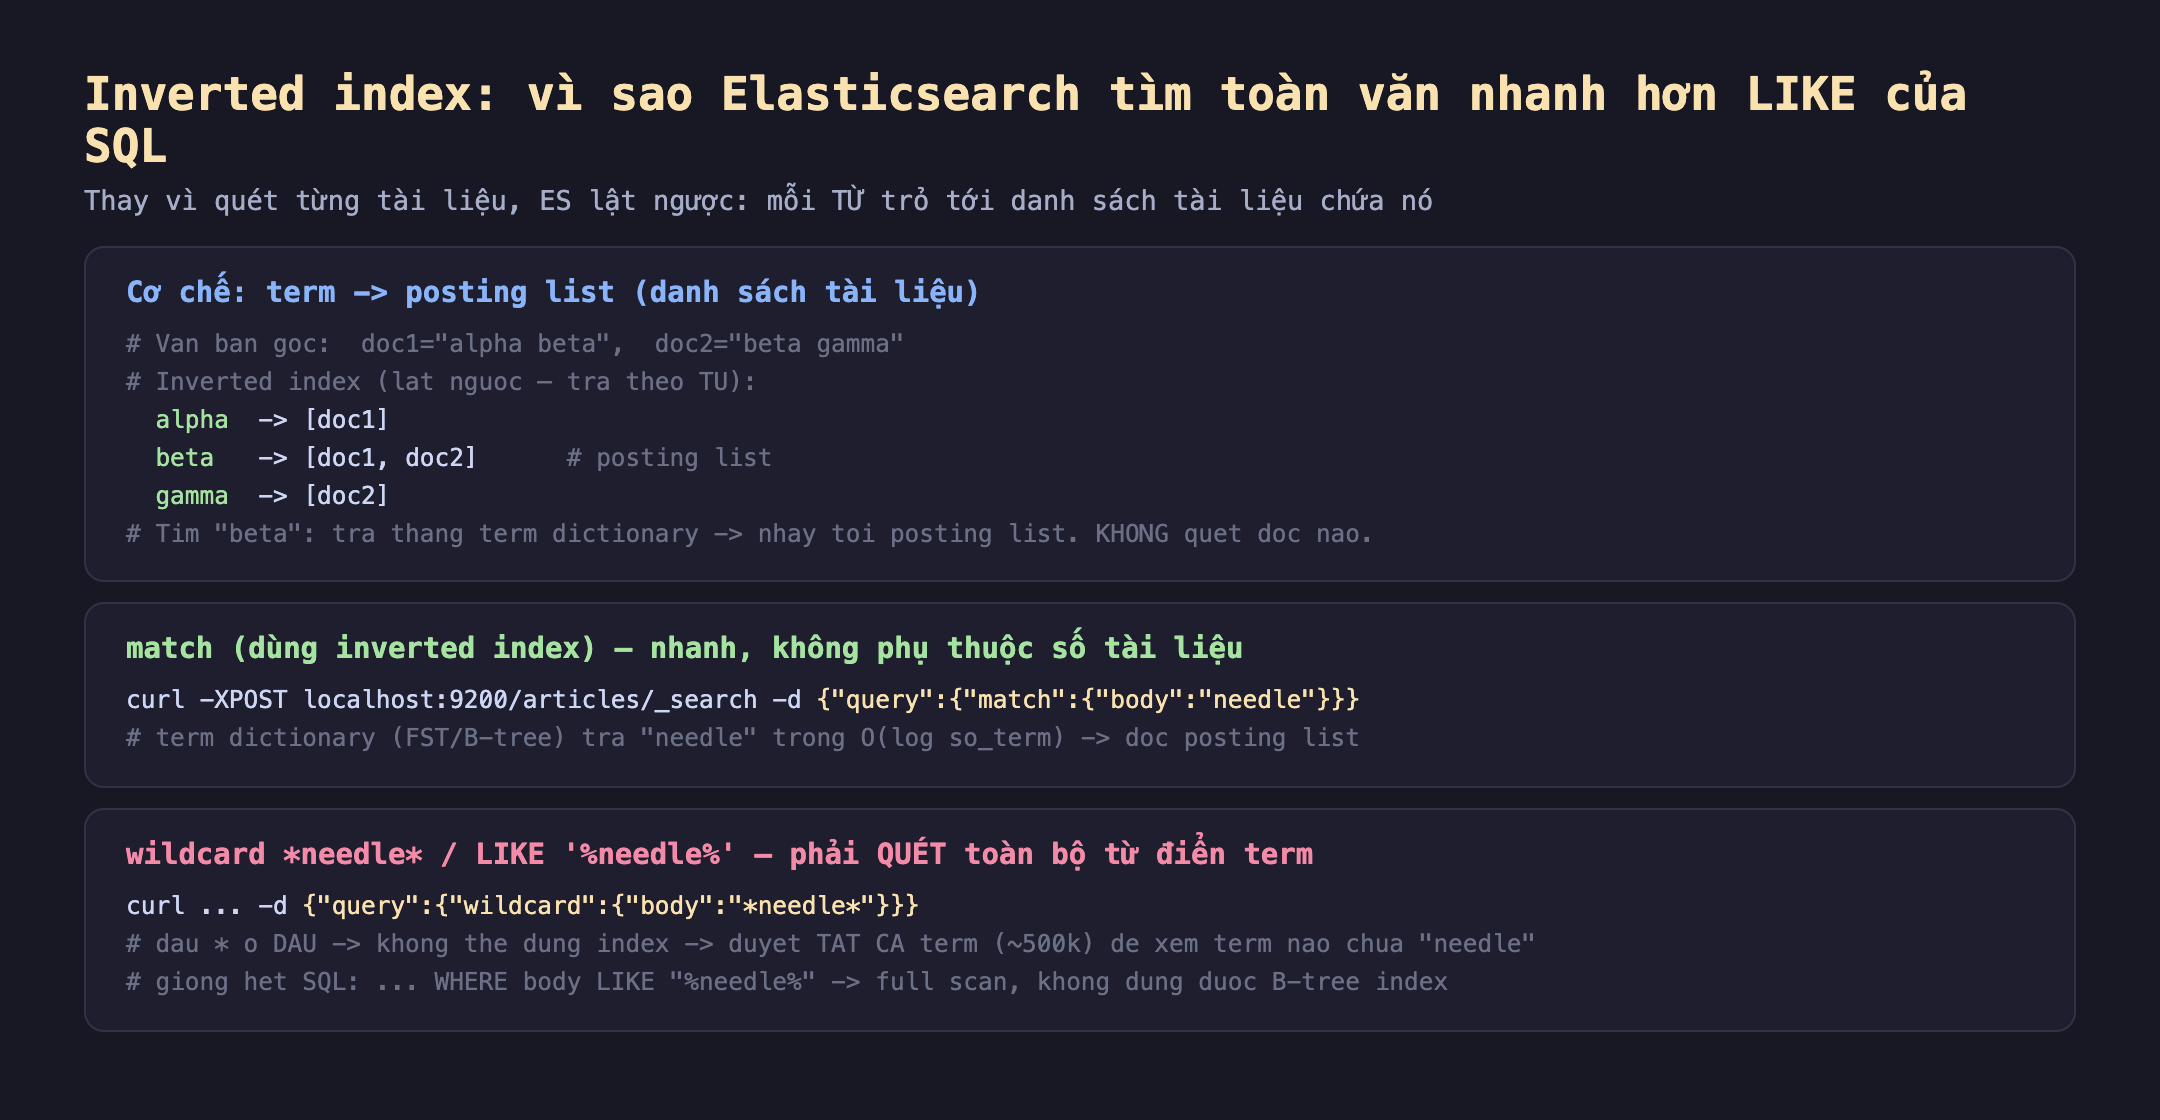
Hình 1: Inverted index lật từ "tài liệu chứa từ gì" thành "từ nằm ở tài liệu nào". match tra thẳng term dictionary rồi tới posting list (không quét tài liệu). wildcard *needle* / LIKE '%needle%' có dấu sao ở đầu nên phải quét toàn bộ term — như full scan của SQL.
# match: dung inverted index — tra thang posting list
curl -XPOST localhost:9200/articles/_search -H 'Content-Type: application/json' \
  -d '{"query":{"match":{"body":"needle"}}}'

# wildcard *needle*: dau * o DAU -> khong dung duoc index -> quet TAT CA term
curl -XPOST localhost:9200/articles/_search -H 'Content-Type: application/json' \
  -d '{"query":{"wildcard":{"body":"*needle*"}}}'
Điểm mấu chốt nằm ở chỗ term dictionary được lưu dưới dạng cấu trúc tra cứu nhanh (trong Lucene là FST — finite state transducer, họ hàng của B-tree/trie). Tra một từ chính xác là O(log số_term). Nhưng tìm một chuỗi con bất kỳ (*needle*) thì không có cách nào ngoài duyệt mọi term — đúng như LIKE '%x%'.
Đo thật: match vs quét từ điển, trên 100.000 tài liệu
Mình nạp 100.000 tài liệu vào es-lab, mỗi tài liệu có 12 từ ngẫu nhiên (tạo ra ~500.000 term duy nhất — term dictionary lớn), và rải từ hiếm "needle" vào ~0,3% tài liệu. Rồi tìm "needle" bằng nhiều cách, xóa cache trước mỗi lần để đo chi phí thật. Số liệu thật từ es-lab:
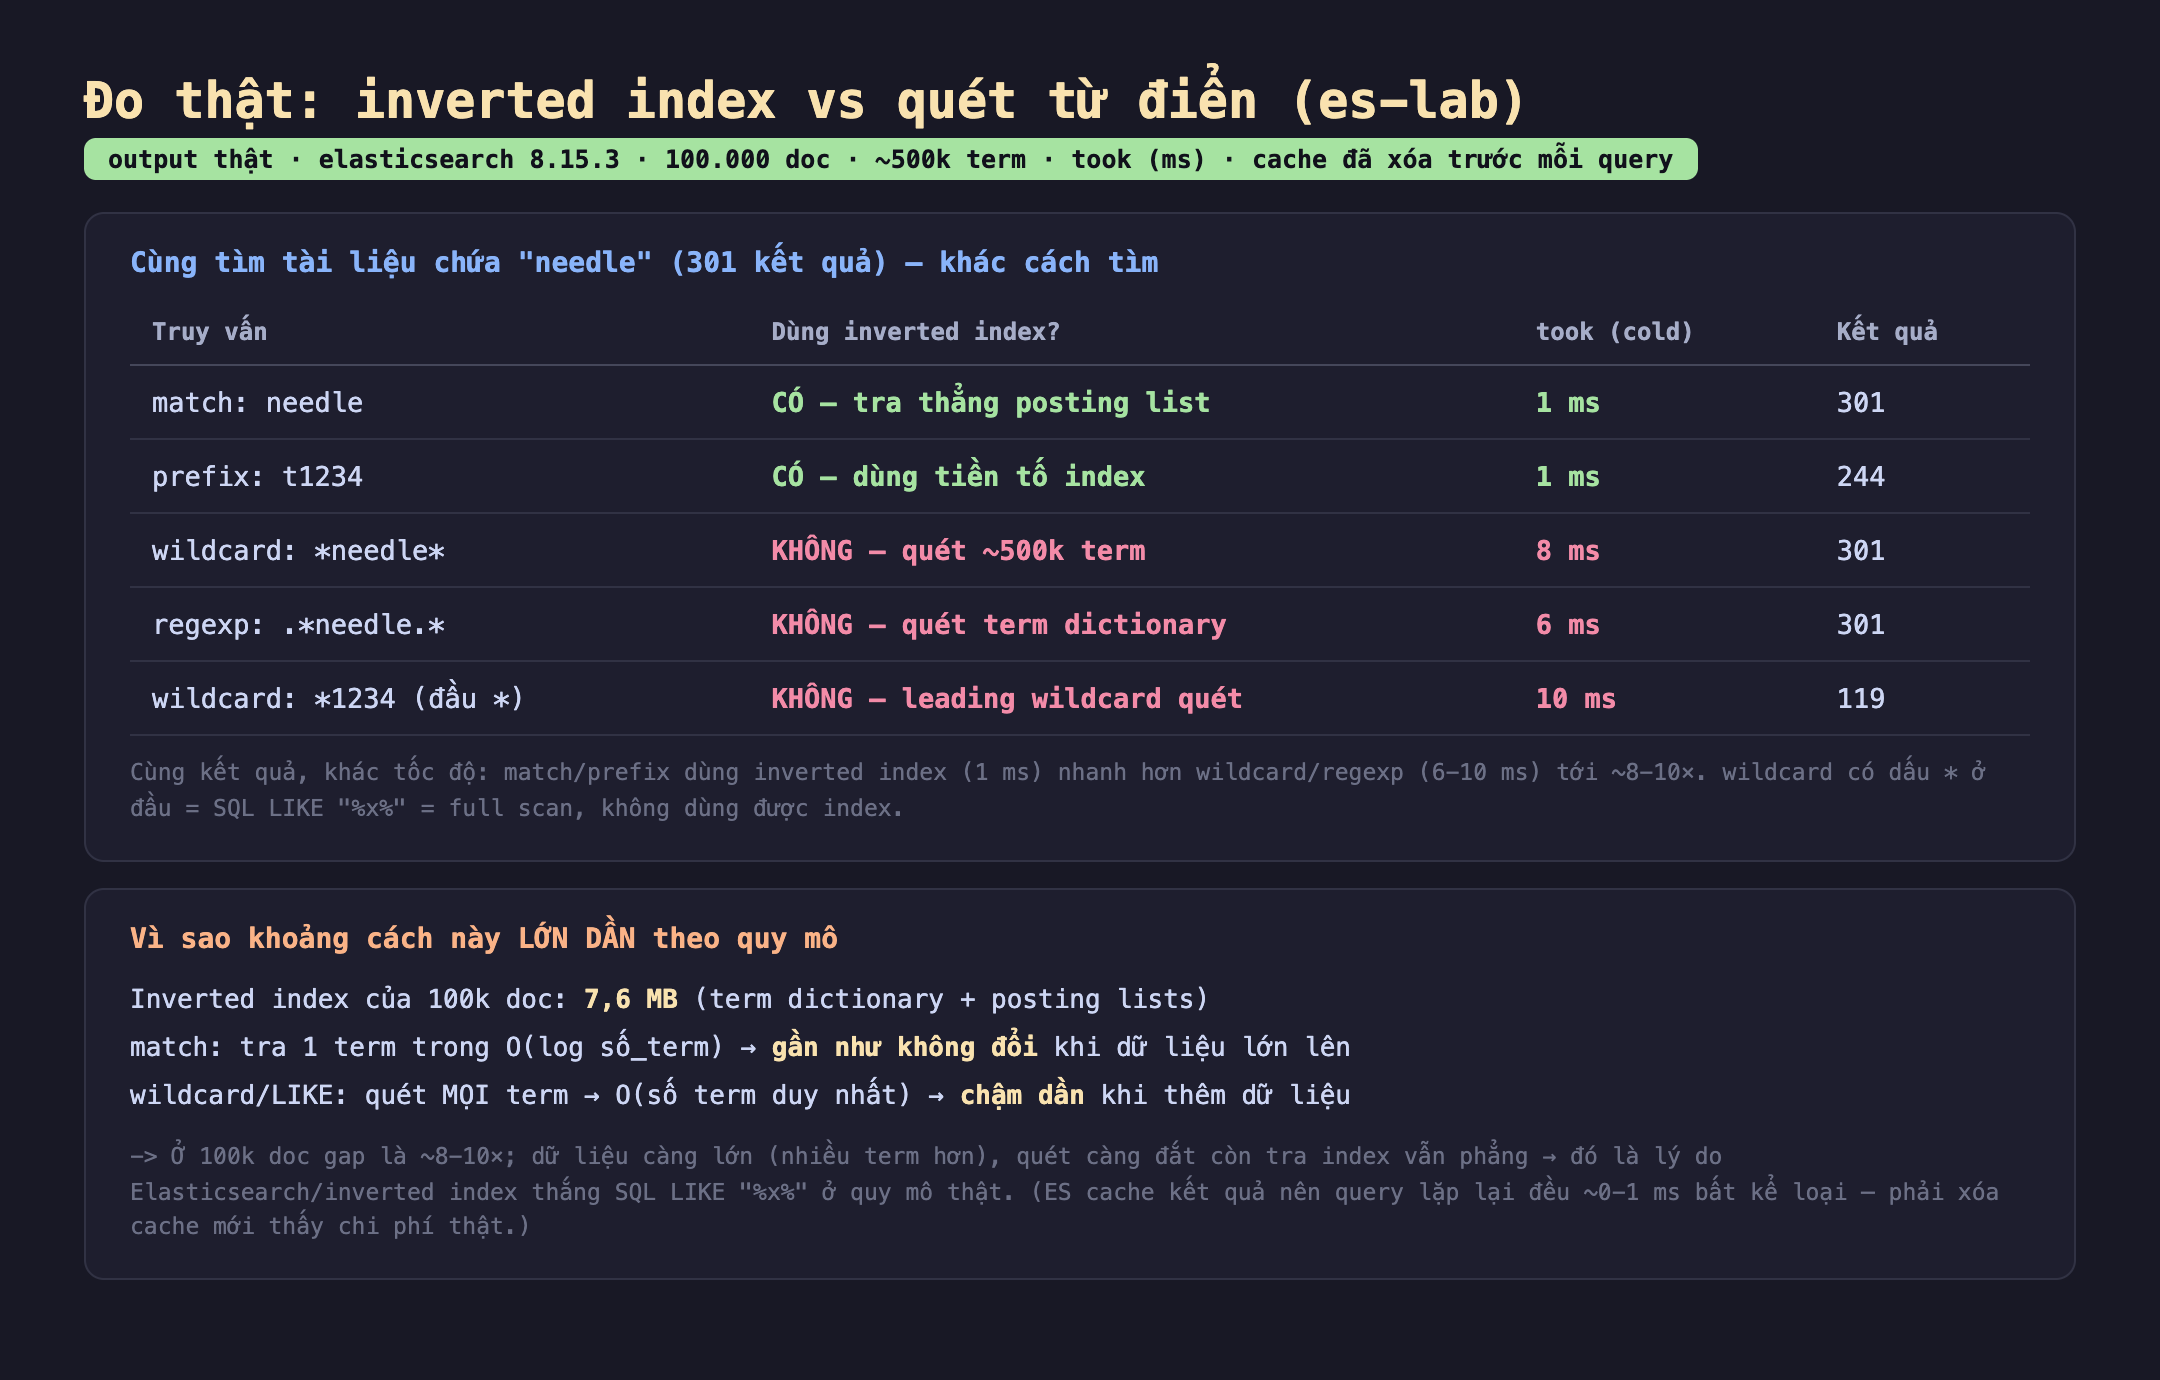
Hình 2: Kết quả thật (cold cache). match/prefix dùng inverted index chạy 1 ms; wildcard/regexp quét term dictionary mất 6-10 ms — cùng 301 kết quả. Inverted index của 100k tài liệu nặng 7,6 MB.
- match "needle" = 1 ms — tra từ "needle" trong term dictionary rồi lấy posting list. Nhanh, và không phụ thuộc số tài liệu trong index.
- prefix "t1234" = 1 ms — tiền tố cũng dùng được index (term dictionary sắp theo thứ tự, nhảy tới khoảng tiền tố).
- *wildcard "needle" = 8 ms, regexp ".needle." = 6 ms, leading-wildcard "1234" = 10 ms — tất cả đều có mẫu không neo được vào đầu term, nên phải duyệt toàn bộ ~500.000 term để xem term nào khớp. Chậm hơn match 8-10 lần, dù cho ra cùng kết quả.
Mấu chốt: wildcard "*needle*" chính là tương đương của LIKE '%needle%' trong SQL — dấu sao (hay %) ở đầu phá vỡ khả năng dùng index, buộc quét tuyến tính.
Vì sao khoảng cách này lớn dần theo quy mô
Ở 100.000 tài liệu, gap chỉ ~8-10× — chưa quá kịch tính. Nhưng điều quan trọng là xu hướng:
- match tra một từ trong O(log số_term) — khi dữ liệu lớn lên, số term tăng chậm (từ vựng có giới hạn), nên thời gian tra gần như phẳng.
- wildcard/LIKE phải quét mọi term duy nhất — O(số term). Dữ liệu càng lớn, càng nhiều term, quét càng đắt.
Inverted index của 100k tài liệu này đã nặng 7,6 MB (term dictionary + posting lists). Ở quy mô hàng chục triệu tài liệu, số term lên hàng triệu, và lúc đó LIKE '%x%' trở nên bất khả thi trong khi match vẫn trả về trong mili giây. Đó là lý do tồn tại của Elasticsearch: nó trả trước cái giá xây inverted index lúc nạp dữ liệu, để gặt tốc độ tra cứu mãi về sau.
Đánh đổi cần cân nhắc
Inverted index tốn chỗ và tốn công lúc ghi. ES phải phân tích mỗi tài liệu (tách từ, chuẩn hóa) và cập nhật posting list lúc index, chứ không phải lúc tìm. Nghĩa là ghi chậm hơn và tốn bộ nhớ/đĩa hơn một bảng SQL thường (ở đây 7,6 MB chỉ cho trường text của 100k doc nhỏ). Đây là đánh đổi cổ điển: trả trước lúc ghi để nhanh lúc đọc. Nếu dữ liệu ghi nhiều đọc ít, hoặc không cần tìm toàn văn, một database quan hệ thường lại hợp hơn.
ES cache kết quả rất mạnh — phải xóa cache mới đo được chi phí thật. Trong lúc thử nghiệm, nếu chạy cùng một truy vấn nhiều lần, ES trả ~0-1 ms cho mọi loại query (kể cả wildcard) nhờ query cache và filesystem cache của OS. Con số 8-10 ms ở trên chỉ hiện ra khi mình xóa cache trước mỗi lần đo. Bài học khi benchmark ES: đo cold cache nếu muốn biết chi phí thật của một truy vấn; còn trong production, cache che phần lớn chi phí cho các truy vấn lặp lại.
Inverted index không giúp cho mọi kiểu tìm. Nó tối ưu cho tìm từ và tiền tố. Tìm chuỗi con giữa từ (*needle*), hậu tố, hay mẫu phức tạp vẫn phải quét — ES không có phép màu ở đây. Nếu bạn thật sự cần tìm chuỗi con (ví dụ tìm trong mã sản phẩm), giải pháp là đánh index khác đi (n-gram — chia từ thành các đoạn nhỏ lúc index, bài sau sẽ đo), chứ không phải dựa vào wildcard lúc tìm.
Ba ý mang về
- Inverted index lật ngược bài toán tìm kiếm. Thay vì quét từng tài liệu (như
LIKE '%x%'của SQL, O(n)), ES lưu sẵn mỗi từ trỏ tới danh sách tài liệu chứa nó, nên tìm một từ là tra thẳng — đo thật match "needle" chỉ 1 ms trên 100.000 tài liệu. - Mẫu neo được vào đầu term thì nhanh, không neo được thì phải quét. Đo thật: match và prefix dùng index (1 ms), còn wildcard "needle", regexp, leading-wildcard phải quét ~500k term (6-10 ms) — cùng kết quả.
*x*chính làLIKE '%x%': dấu sao đầu phá index. - Khoảng cách lớn dần theo quy mô — đó là lý do ES tồn tại. match gần như phẳng O(log số_term), wildcard/LIKE là O(số term) nên chậm dần khi dữ liệu lớn. ES trả giá xây index lúc ghi (7,6 MB cho 100k doc) để gặt tốc độ đọc. Nhớ xóa cache khi benchmark, vì ES cache che chi phí thật.
Nguồn
- Elasticsearch docs — Inverted index: https://www.elastic.co/guide/en/elasticsearch/reference/current/documents-indices.html
- Lucene docs — term dictionary & FST: https://lucene.apache.org/core/9_11_1/
- Elasticsearch docs — wildcard & regexp queries: https://www.elastic.co/guide/en/elasticsearch/reference/current/query-dsl-wildcard-query.html
Phần sau ta mở nắp bước biến văn bản thành token: analyzer và tokenizer làm gì, vì sao "Email" và "email" khớp nhau được, và đo thật các token mà standard/keyword/n-gram sinh ra từ cùng một câu.
