Suốt mười một bài, loạt "Elasticsearch thực chiến cho backend" này theo đuổi một nguyên tắc: không nói lý thuyết, mà đo thật trên container. Mỗi bài chạy Elasticsearch 8.15.3 trong Docker, gọi REST API thật, đọc took và kết quả thật — kể cả khi con số khiêm tốn hay ngược trực giác. Bài cuối này không giới thiệu khái niệm mới. Nó làm một việc: nối tất cả lại thành khung quyết định để bạn biết khi nào dùng Elasticsearch, khi nào không.
Toàn bộ số liệu đã đo
Trước khi rút ra kết luận, hãy nhìn lại bức tranh — mọi con số đều đo thật trên es-lab:
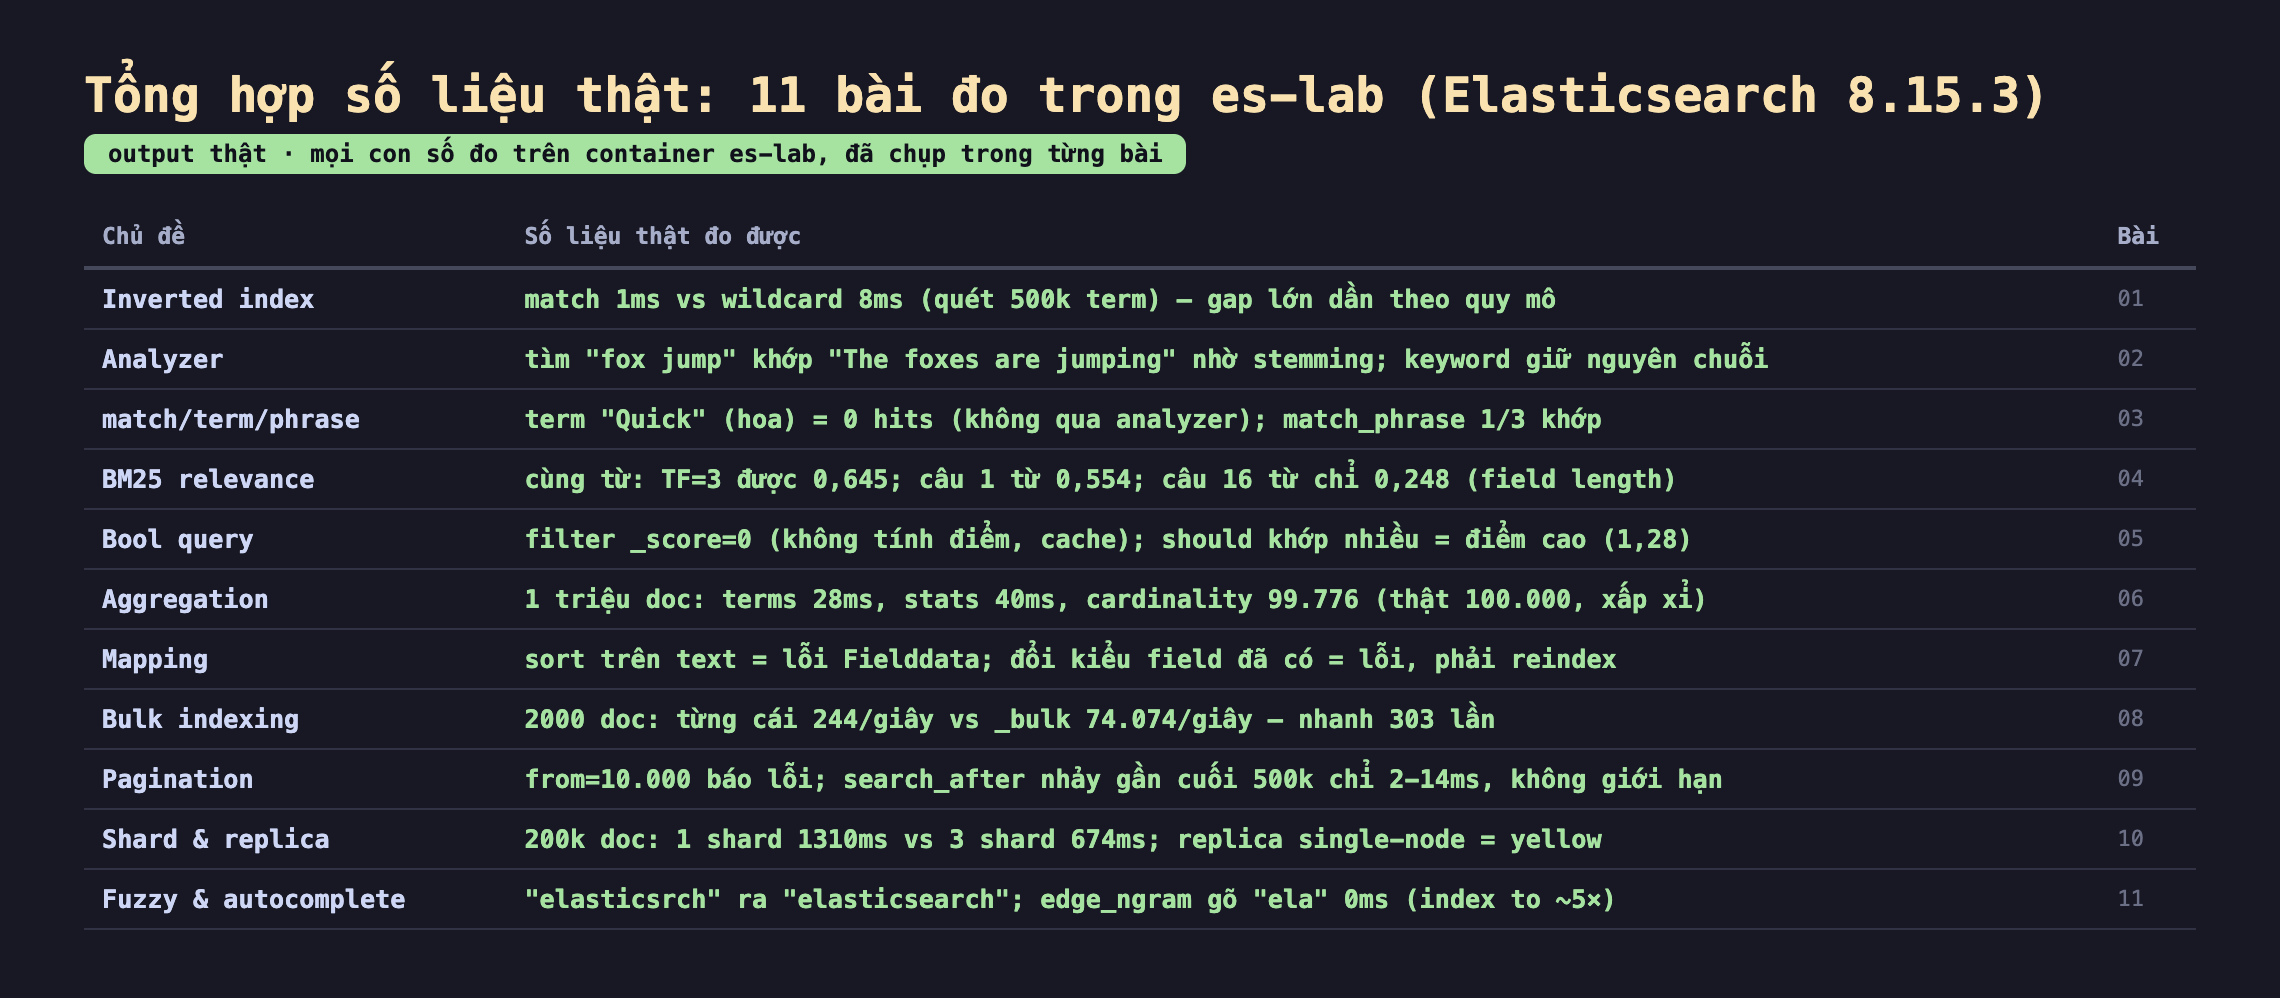
Hình 1: Mười một phép đo thật trong es-lab. Mỗi dòng là một chủ đề và con số đo được — bằng chứng cho mọi kết luận của loạt bài.
Khi nào nên dùng Elasticsearch — và khi nào không
Elasticsearch là công cụ mạnh, nhưng không phải để thay database. Hiểu đúng ranh giới này là điều quan trọng nhất của cả loạt bài:
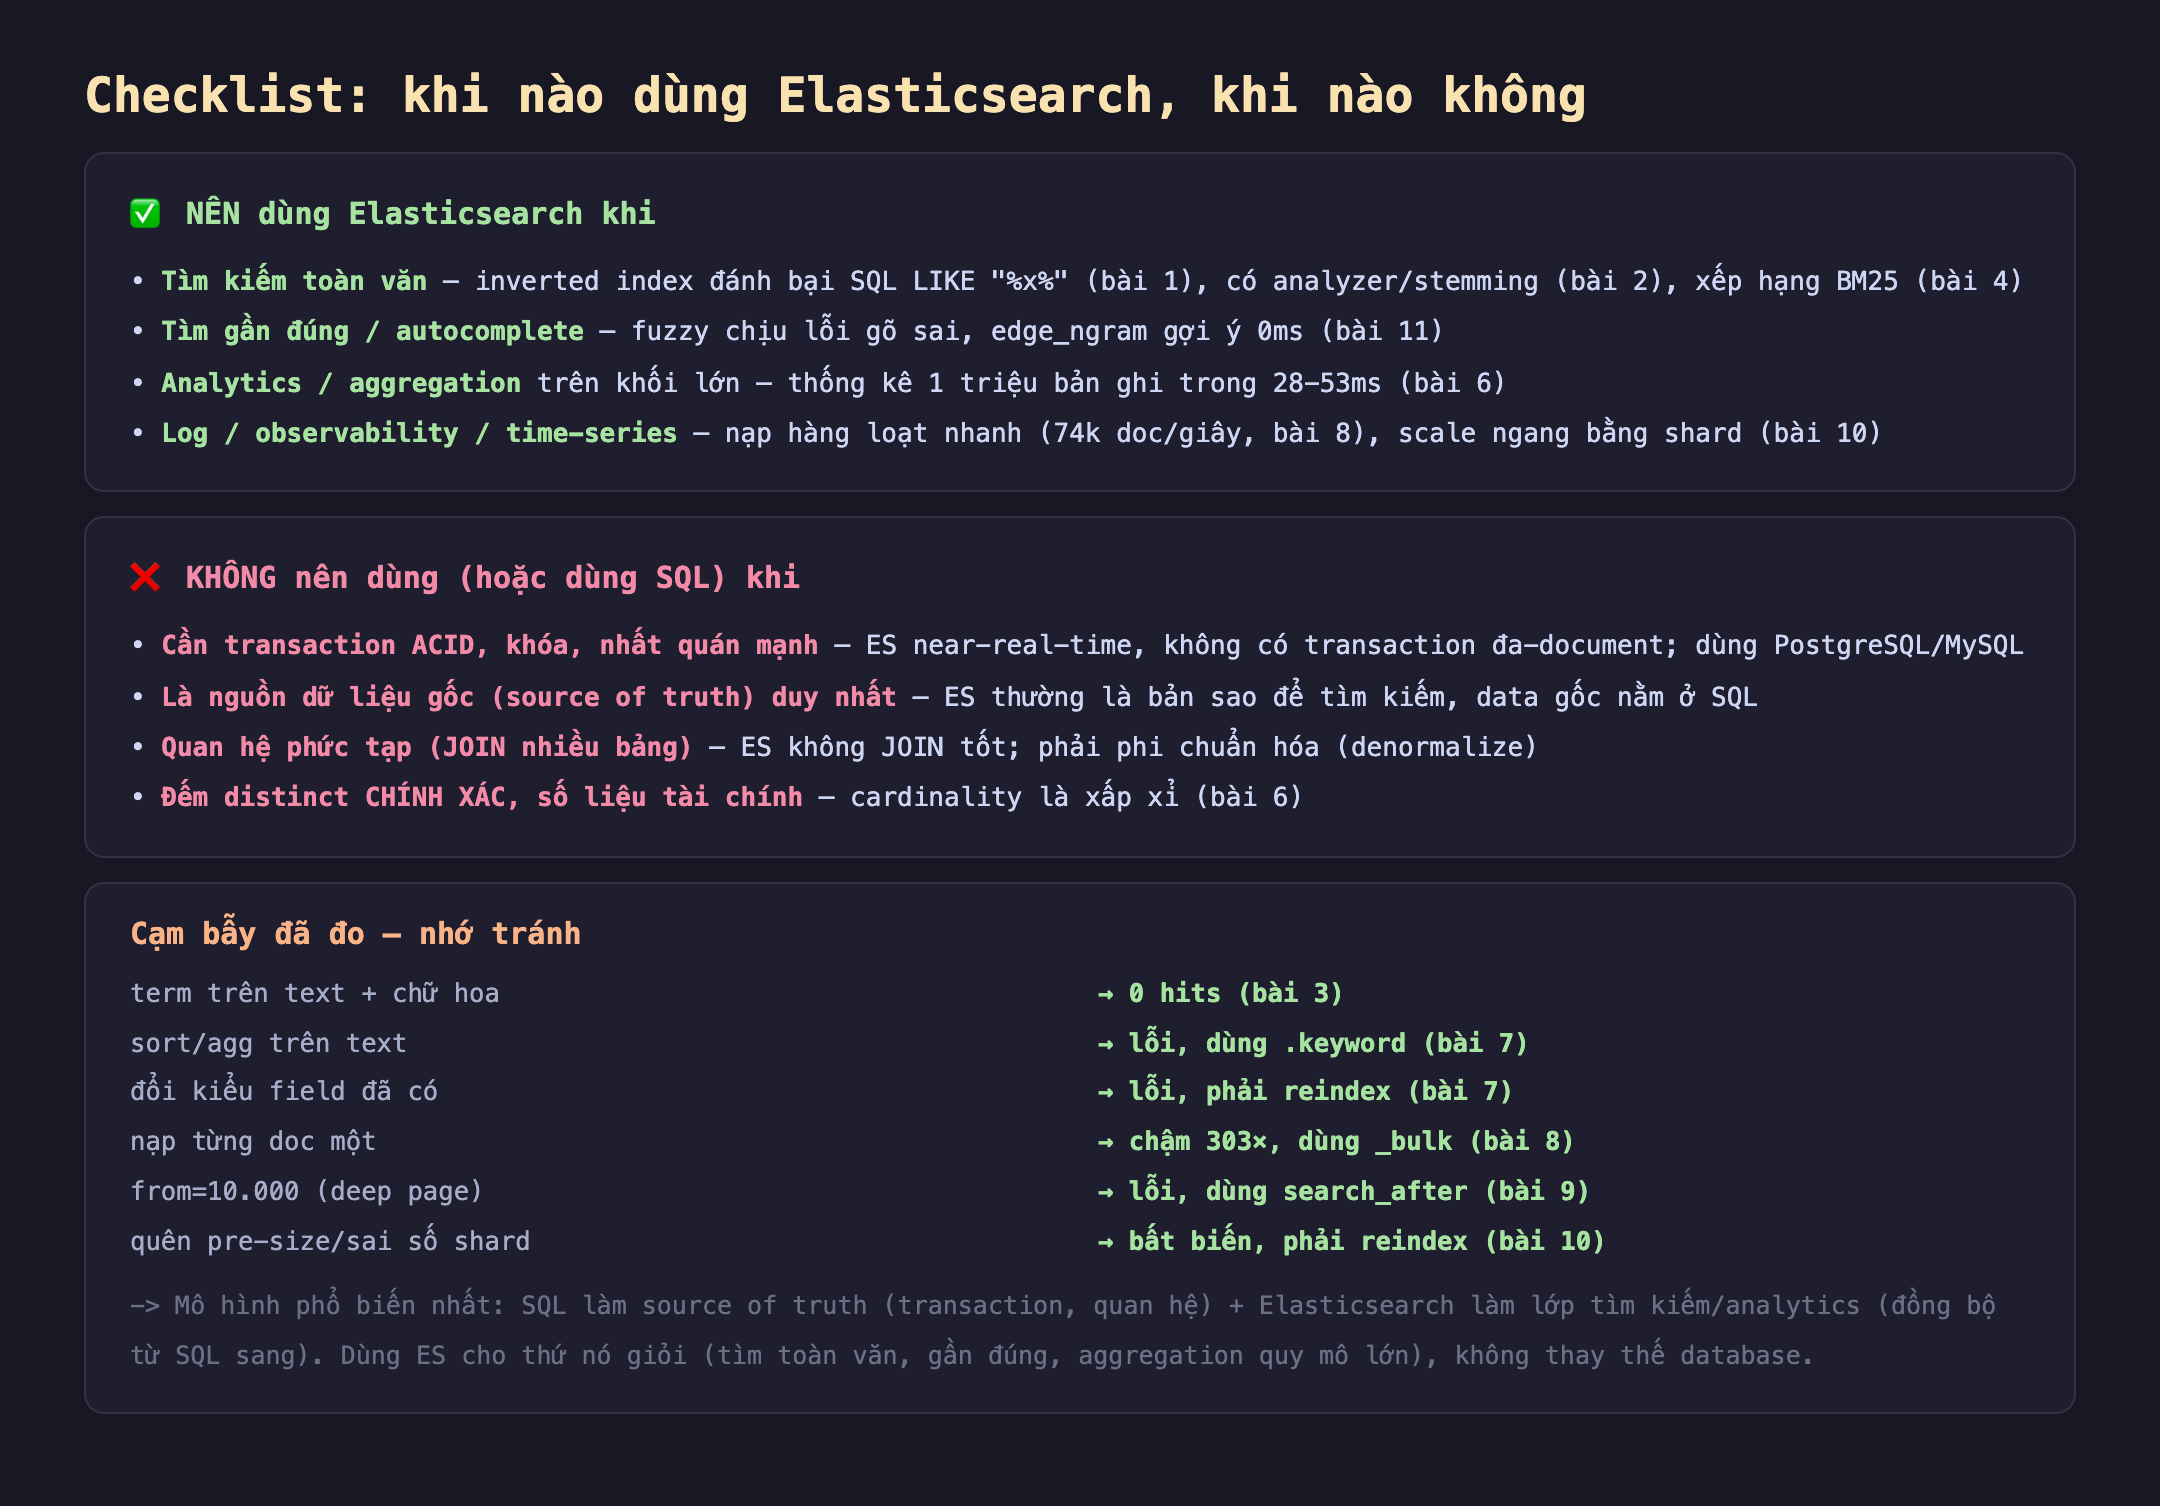
Hình 2: Khung quyết định — nên dùng ES khi (tìm toàn văn, gần đúng, aggregation, log); không nên khi (transaction, source of truth duy nhất, JOIN phức tạp, đếm chính xác); và các cạm bẫy đo được cần tránh.
NÊN dùng Elasticsearch khi:
- Tìm kiếm toàn văn — inverted index đánh bại
LIKE '%x%'của SQL (bài 1: match 1ms vs wildcard 8ms, gap lớn dần theo quy mô), có analyzer/stemming (bài 2), xếp hạng theo độ liên quan BM25 (bài 4). - Tìm gần đúng và autocomplete — fuzzy chịu lỗi gõ sai, edge_ngram gợi ý trong 0ms (bài 11).
- Analytics / aggregation quy mô lớn — thống kê 1 triệu bản ghi trong 28-53ms (bài 6).
- Log / observability / time-series — nạp hàng loạt nhanh (74.074 doc/giây, bài 8), scale ngang bằng shard (bài 10).
KHÔNG nên dùng (hãy dùng SQL) khi:
- Cần transaction ACID, khóa, nhất quán mạnh — ES là near-real-time, không có transaction đa-document. Dùng PostgreSQL/MySQL.
- Là nguồn dữ liệu gốc (source of truth) duy nhất — ES thường là bản sao để tìm kiếm, dữ liệu gốc nằm ở SQL.
- Quan hệ phức tạp (JOIN nhiều bảng) — ES không JOIN tốt, buộc phi chuẩn hóa (denormalize).
- Đếm distinct chính xác, số liệu tài chính — cardinality chỉ là ước lượng (bài 6: 99.776 thay vì 100.000).
Mô hình kiến trúc phổ biến nhất
Từ các ranh giới trên, mô hình thực tế thường thấy là: SQL làm source of truth (giữ transaction, quan hệ, tính đúng tuyệt đối) + Elasticsearch làm lớp tìm kiếm/analytics (đồng bộ dữ liệu từ SQL sang). Khi người dùng tìm kiếm hay xem dashboard, truy vấn đi vào ES; khi ghi/sửa dữ liệu quan trọng, đi vào SQL rồi đồng bộ sang ES. Bạn dùng ES cho thứ nó giỏi, không bắt nó làm việc của database.
Những cạm bẫy đã đo — nhớ tránh
Loạt bài đã chạm phải (và đo) nhiều cạm bẫy thực tế. Gom lại để tra nhanh:
- term "Quick" (chữ hoa) trên text → 0 hits (bài 3): term không qua analyzer, index lưu "quick". Dùng match cho text, term cho keyword.
- sort/agg trên trường text → lỗi Fielddata (bài 7): dùng sub-field
.keyword. - Đổi kiểu field đã có → lỗi, phải reindex (bài 7): chọn mapping đúng từ đầu, khai tường minh.
- Nạp từng document → chậm 303 lần (bài 8): luôn dùng
_bulk. - from=10.000 → lỗi deep paging (bài 9): dùng
search_aftercho cuộn sâu. - Số shard sai → bất biến, phải reindex (bài 10): ước lượng tăng trưởng khi tạo index.
Đánh đổi cần cân nhắc (cho cả loạt)
Elasticsearch trả trước để gặt sau — hiểu cái giá. Gần như mọi sức mạnh của ES đến từ việc trả giá lúc ghi để nhanh lúc đọc: xây inverted index (bài 1), chạy analyzer (bài 2), lưu edge_ngram gấp 5 lần (bài 11), nhân bản replica (bài 10). Nếu workload của bạn ghi nhiều đọc ít, hoặc không cần tìm kiếm phức tạp, cái giá này không đáng — một database quan hệ với index phù hợp lại gọn hơn.
Vận hành ES là một cam kết thật. Một cluster production cần ≥2 node cho replica (bài 10), cần theo dõi heap/shard, cần pipeline đồng bộ dữ liệu từ source of truth, cần tinh chỉnh mapping/analyzer/shard. Đây không phải "cài rồi quên". Nếu nhu cầu tìm kiếm còn nhỏ (vài nghìn bản ghi), full-text search của chính PostgreSQL (tsvector/tsquery) hoặc một thư viện nhẹ có thể đủ, không cần dựng cả ES.
Đo trên dữ liệu và phần cứng thật của bạn. Mọi con số trong loạt này đo trên một node ES với dữ liệu tổng hợp — chúng minh họa cơ chế và xu hướng, không phải cam kết hiệu năng cho hệ thống của bạn. Cluster nhiều node, dữ liệu thật, truy vấn thật sẽ cho con số khác. Dùng các bài này để hiểu vì sao và hướng nào, rồi đo lại trên môi trường của chính mình trước khi quyết định.
Ba ý mang về
- Elasticsearch giỏi tìm kiếm và analytics, không phải database. Đo thật: match nhanh hơn wildcard/LIKE (bài 1), aggregation 1 triệu bản ghi trong 28ms (bài 6), bulk 74k doc/giây (bài 8). Nhưng không có transaction ACID, JOIN kém, cardinality xấp xỉ — dùng SQL cho những việc đó.
- Mô hình đúng: SQL là source of truth, ES là lớp tìm kiếm/analytics. Giữ dữ liệu gốc và tính đúng ở database quan hệ; đồng bộ sang ES cho thứ nó giỏi (tìm toàn văn, gần đúng, aggregation quy mô lớn). Đừng bắt ES thay thế database.
- Tránh các cạm bẫy đã đo. term trên text (0 hits), sort/agg trên text (lỗi Fielddata), nạp từng doc (chậm 303×), from=10.000 (lỗi deep paging), đổi kiểu field/số shard (bất biến, phải reindex). ES trả giá lúc ghi để nhanh lúc đọc — và vận hành nó là cam kết thật, chỉ đáng khi nhu cầu tìm kiếm đủ lớn.
Nguồn
- Elasticsearch docs — Elasticsearch Guide: https://www.elastic.co/guide/en/elasticsearch/reference/current/index.html
- Elastic blog — When to use Elasticsearch: https://www.elastic.co/blog/
- PostgreSQL docs — Full Text Search (lựa chọn thay thế nhẹ): https://www.postgresql.org/docs/current/textsearch.html
