Mười bài trước của loạt này đều xoay quanh Big-O: chọn đúng độ phức tạp để code scale được. Nhưng Big-O có một điểm mù lớn. Nó coi mọi phép truy cập bộ nhớ là như nhau — đọc a[0] hay a[1000000] đều tính là một thao tác. Trên phần cứng thật, điều đó sai hoàn toàn: một lần đọc có thể nhanh gấp trăm lần lần khác, tùy dữ liệu đang nằm ở đâu trong hệ thống phân cấp bộ nhớ (cache L1/L2/L3 hay RAM).
Bài này (phần 11 loạt Giải thuật) chạm vào tầng mà Big-O bỏ qua: cache locality. Ta sẽ đo thật hai đoạn code cùng độ phức tạp, cùng số phép tính nhưng chênh nhau 14 lần — và cũng trung thực về những trường hợp mà hiệu ứng cache không lộ ra như sách giáo khoa hứa hẹn.
Cơ chế: CPU nạp bộ nhớ theo dòng, không theo byte
Chìa khóa: CPU không đọc một byte từ RAM mỗi lần. Nó kéo về cả một dòng cache (cache line) — thường 64 byte — trong một lần. 64 byte đó chứa 16 số int32 liền kề (hoặc 8 số float64). Thêm nữa, CPU có bộ nạp trước (prefetcher): khi thấy bạn đọc tuần tự, nó tự động nạp sẵn dòng kế tiếp.
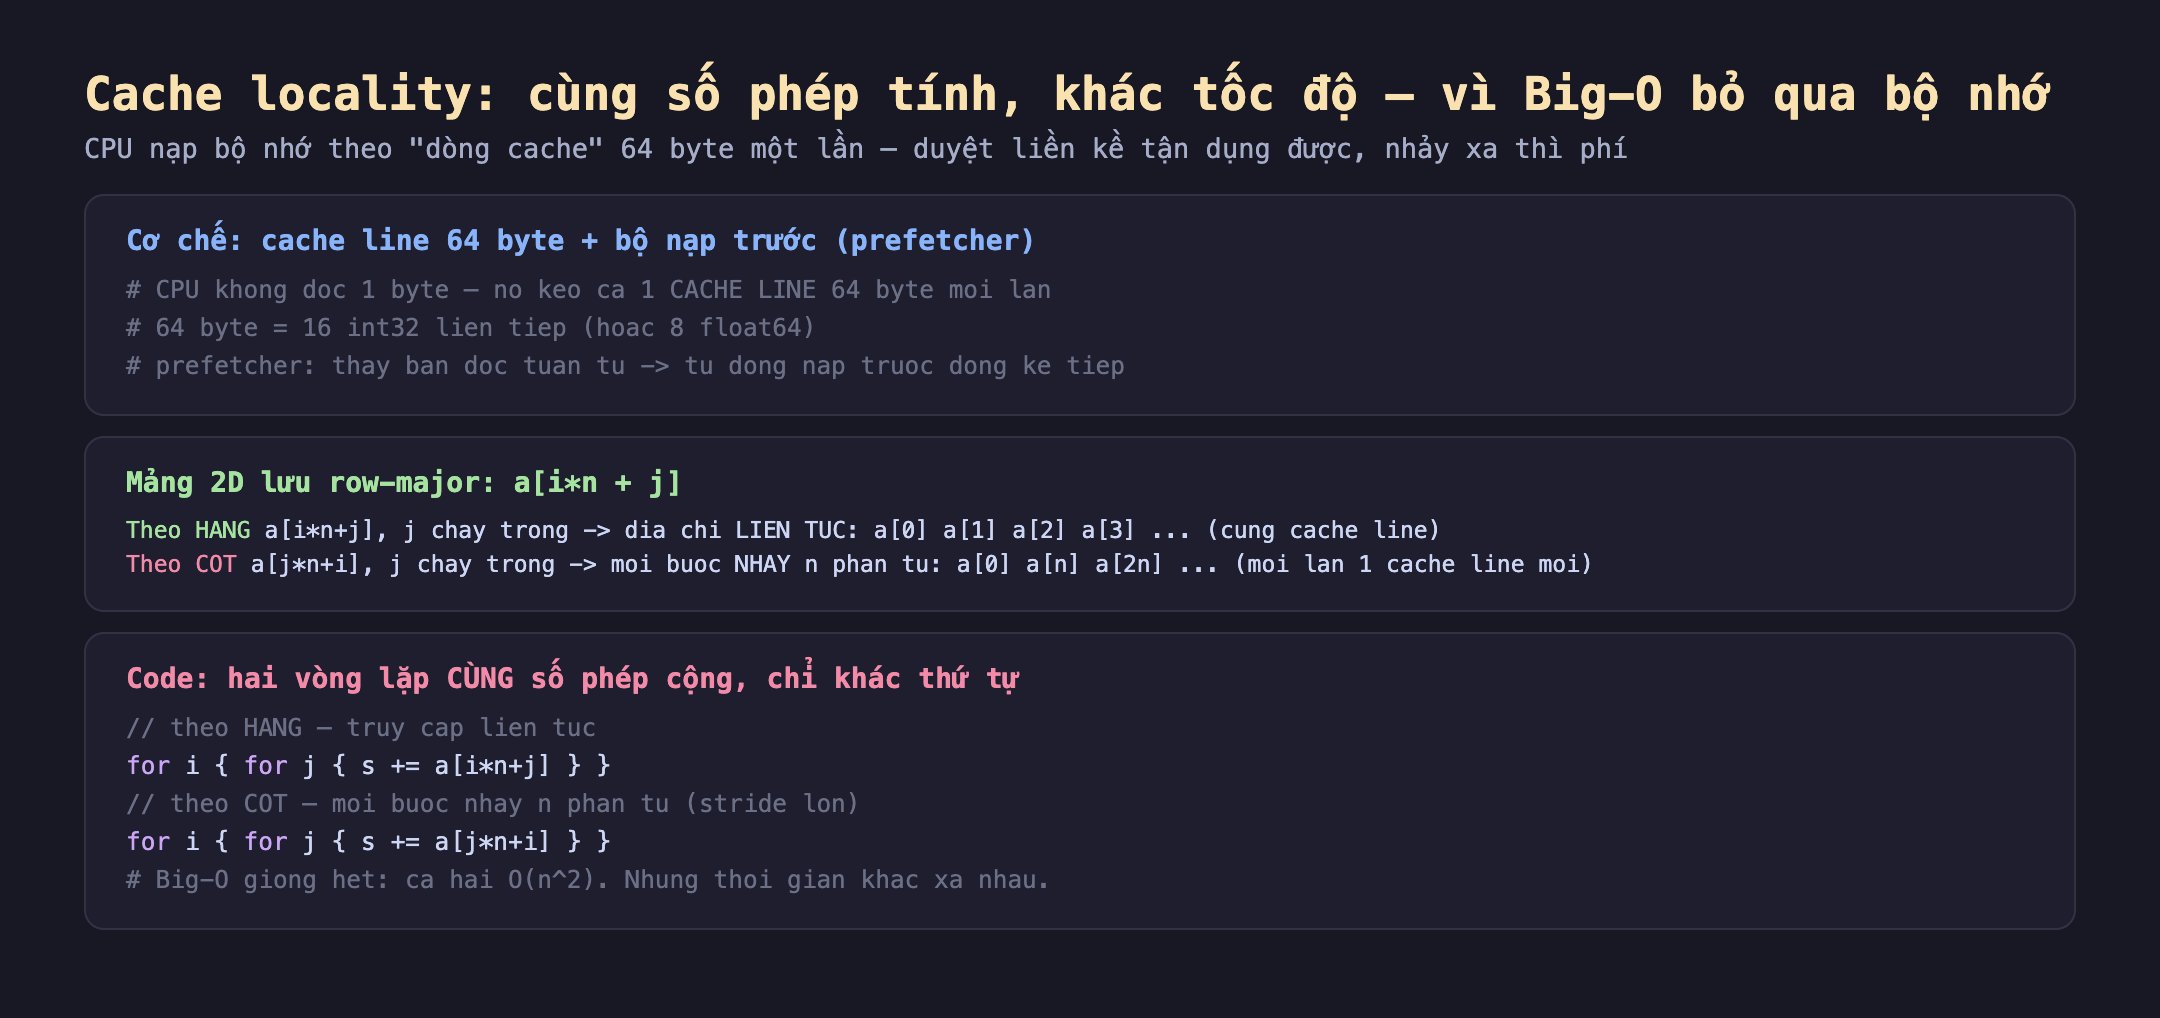
Hình 1: CPU kéo cả dòng cache 64 byte mỗi lần; prefetcher nạp sẵn khi thấy đọc tuần tự. Mảng 2D lưu row-major: duyệt theo hàng truy cập liền kề (tận dụng cache line), duyệt theo cột nhảy n phần tử mỗi bước (mỗi lần một dòng cache mới).
// theo HANG — truy cap lien tuc: a[0] a[1] a[2]... (cung cache line)
for i := 0; i < n; i++ {
	for j := 0; j < n; j++ {
		s += a[i*n+j]
	}
}

// theo COT — moi buoc nhay n phan tu: a[0] a[n] a[2n]... (stride lon)
for i := 0; i < n; i++ {
	for j := 0; j < n; j++ {
		s += a[j*n+i]
	}
}
Hai vòng lặp này giống hệt nhau về Big-O (cùng O(n²)) và số phép cộng (cùng n² phép). Khác biệt duy nhất là thứ tự truy cập — và đó là tất cả.
Đo thật: theo cột chậm hơn 14 lần
Mình duyệt mảng 2D (lưu row-major) theo hàng và theo cột, trên các kích thước tăng dần. Số liệu thật từ go-lab:
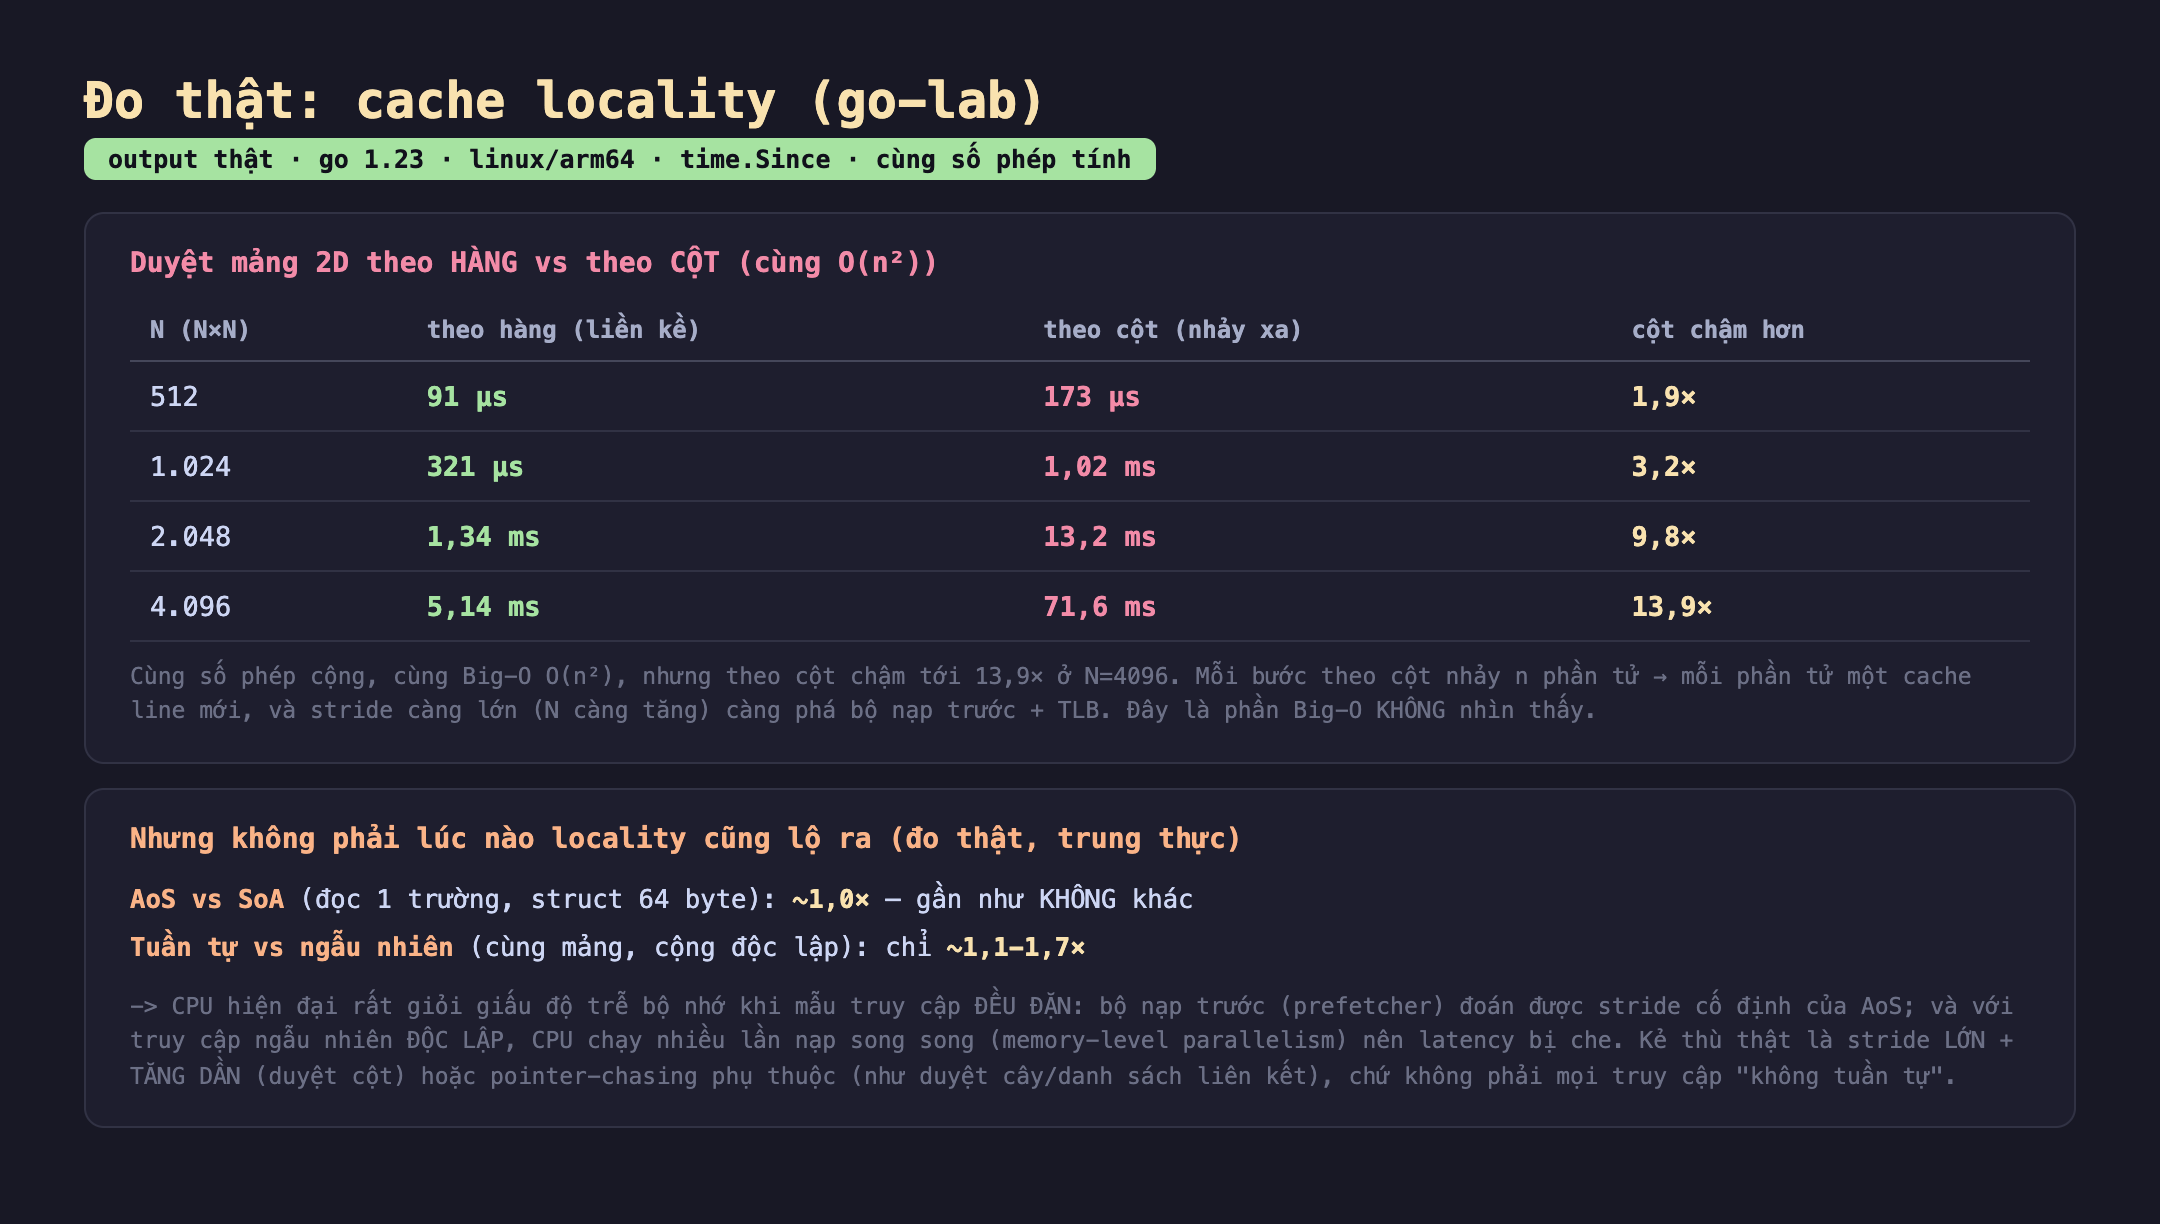
Hình 2: Kết quả thật. Duyệt theo cột chậm hơn theo hàng 1,9× đến 13,9× dù cùng O(n²). Nhưng AoS vs SoA (~1,0×) và tuần tự vs ngẫu nhiên (~1,1-1,7×) lại gần như không khác — CPU giỏi giấu độ trễ cho mẫu đều đặn.
- Theo cột chậm hơn, và càng lớn càng tệ: từ 1,9× (N=512) lên 13,9× (N=4096). Ở N=4096, theo hàng mất 5,14 ms còn theo cột mất 71,6 ms — cùng số phép cộng.
- Vì sao? Khi duyệt theo cột (
a[j*n+i]), mỗi bước nhảynphần tử — tức một dòng cache mới mỗi lần đọc, gần như không tận dụng được 64 byte đã kéo về. Tệ hơn, stride (n) tăng theo N: càng lớn thì càng vượt khả năng của prefetcher và gây thêm cache miss ở nhiều tầng, kể cả TLB (bảng dịch địa chỉ trang). Đó là lý do tỉ lệ chậm tăng dần: 1,9 → 13,9.
Đây là bài học cốt lõi: Big-O đo số phép tính, không đo chi phí mỗi phép. Hai thuật toán O(n²) có thể chênh nhau hơn chục lần chỉ vì cách sắp xếp vòng lặp. Khi tối ưu vòng lặp lồng, duyệt theo thứ tự bộ nhớ (hàng trước, với mảng row-major) là một thắng lợi "miễn phí".
Nhưng trung thực: locality không phải lúc nào cũng lộ ra
Sách giáo khoa thường dạy hai mẹo nữa: dùng struct-of-arrays (SoA) thay vì array-of-structs (AoS), và tránh truy cập ngẫu nhiên. Mình đo cả hai — và kết quả không dramatic như kỳ vọng:
- AoS vs SoA (đọc một trường, struct 64 byte): ~1,0× — gần như không khác.
- Tuần tự vs ngẫu nhiên (cùng mảng, phép cộng độc lập): chỉ ~1,1-1,7×.
Vì sao? Vì CPU hiện đại rất giỏi giấu độ trễ bộ nhớ khi mẫu truy cập đều đặn:
- Với AoS, đọc một trường qua các struct 64 byte tạo ra một stride cố định — prefetcher nhận ra ngay và nạp sẵn, nên gần như không khác SoA liền kề.
- Với truy cập ngẫu nhiên nhưng độc lập (mỗi lần đọc không phụ thuộc kết quả lần trước), CPU phát hành nhiều lần nạp song song (memory-level parallelism) — trong khi chờ một dòng cache, nó đã nạp hàng chục dòng khác, nên độ trễ bị che phần lớn.
Kẻ thù thật của cache không phải "mọi truy cập không tuần tự". Nó là: (1) stride lớn và tăng dần như duyệt cột — phá cả prefetcher lẫn TLB; và (2) pointer-chasing phụ thuộc — khi mỗi bước phải đọc xong con trỏ này mới biết đi đâu tiếp (duyệt cây, danh sách liên kết — như đã thấy ở bài cây BST), CPU không thể nạp song song vì không biết trước địa chỉ. Đó mới là nơi cache miss thật sự giết hiệu năng.
Đánh đổi cần cân nhắc
Đừng tối ưu cache mù quáng — đo trên phần cứng và dữ liệu thật của bạn. Kết quả trên là của một CPU ARM64 cụ thể với prefetcher tốt; trên CPU khác, hay với mẫu truy cập khác, AoS/SoA có thể khác hẳn. Bài học không phải "SoA luôn thắng" hay "ngẫu nhiên luôn chậm" — mà là phải đo. Một "tối ưu cache" dựa trên lý thuyết suông có thể chẳng mang lại gì (như AoS→SoA ở đây) trong khi làm code phức tạp hơn.
Tối ưu cache chỉ đáng khi đó là điểm nóng thật. Thay đổi thứ tự vòng lặp (hàng vs cột) gần như miễn phí và nên làm ngay. Nhưng tái cấu trúc dữ liệu lớn (AoS→SoA toàn hệ thống) tốn công và làm code khó đọc — chỉ đáng khi profiling chỉ ra đó là nút thắt và đo được lợi ích thật. Đừng hy sinh sự rõ ràng cho một tối ưu cache chưa được chứng minh.
Chọn thuật toán vẫn quan trọng hơn tối ưu cache — nhưng cả hai cùng cần. Một thuật toán O(n log n) thân-thiện-cache kém vẫn đánh bại O(n²) thân-thiện-cache tốt khi N lớn — độ phức tạp thắng khi scale. Nhưng trong cùng một lớp độ phức tạp, cache locality quyết định bạn ở đầu nhanh hay đầu chậm của khoảng 14 lần. Chọn đúng Big-O trước; rồi trong đó, tôn trọng bộ nhớ.
Ba ý mang về
- Big-O đo số phép tính, không đo chi phí mỗi phép. Đo thật: hai vòng lặp cùng O(n²), cùng số phép cộng, nhưng duyệt theo cột chậm hơn theo hàng 13,9× ở N=4096 — chỉ vì thứ tự truy cập bộ nhớ. Duyệt theo thứ tự bộ nhớ (hàng trước với mảng row-major) là thắng lợi gần như miễn phí.
- CPU hiện đại giấu độ trễ rất tốt cho mẫu đều đặn. Đo thật, trung thực: AoS vs SoA ~1,0×, tuần tự vs ngẫu nhiên độc lập ~1,1-1,7× — prefetcher đoán được stride cố định, và memory-level parallelism che độ trễ của truy cập độc lập. "Không tuần tự" không tự động nghĩa là chậm.
- Kẻ thù thật là stride lớn/tăng dần và pointer-chasing phụ thuộc. Duyệt cột (stride tăng theo N, phá prefetcher + TLB) và duyệt cây/danh sách liên kết (mỗi bước phụ thuộc bước trước, không nạp song song được) mới là nơi cache miss giết hiệu năng. Tối ưu cache phải đo trên phần cứng thật, không theo lý thuyết suông.
Nguồn
- Ulrich Drepper — What Every Programmer Should Know About Memory: https://people.freebsd.org/~lstewart/articles/cpumemory.pdf
- Wikipedia — Locality of reference, CPU cache: https://en.wikipedia.org/wiki/Locality_of_reference
- Go blog — Go slices and memory layout: https://go.dev/blog/slices-intro
Phần sau là bài tổng kết cả loạt: một checklist chọn thuật toán và cấu trúc dữ liệu — khi nào Big-O là yếu tố quyết định, khi nào hằng số và cache thắng, và cách nối mọi bài đã đo thành một khung tư duy thực dụng.
