Bài BFS (phần 9) tìm đường đi ngắn nhất trên đồ thị không trọng số — đếm số cạnh. Nhưng thế giới thực có trọng số: quãng đường tính bằng ki-lô-mét, mạng tính bằng độ trễ, chuyến bay tính bằng giá vé. Khi cạnh có trọng số khác nhau, "ít cạnh nhất" không còn là "ngắn nhất", và ta cần một thuật toán mạnh hơn: Dijkstra.
Dijkstra là thuật toán kinh điển, nhưng có một chi tiết cài đặt quyết định nó chạy trong mili giây hay giây: cách tìm đỉnh gần nguồn nhất ở mỗi bước. Bài này (phần 10 loạt Giải thuật) đo thật hai cách — quét mảng và dùng heap (hàng đợi ưu tiên ở bài 6) — và cho thấy khác biệt lên tới 210 lần, cùng với một ngoại lệ thú vị.
Dijkstra và chi tiết quyết định tốc độ
Ý tưởng Dijkstra: giữ dist[v] = khoảng cách ngắn nhất đã biết từ nguồn tới v. Lặp lại: lấy đỉnh u chưa chốt có dist nhỏ nhất, chốt nó (khoảng cách đã chắc chắn tối ưu), rồi nới lỏng (relax) các láng giềng — cập nhật dist của chúng nếu đi qua u cho đường ngắn hơn.
Toàn bộ chi phí nằm ở bước "lấy đỉnh chưa chốt có dist nhỏ nhất". Có hai cách:
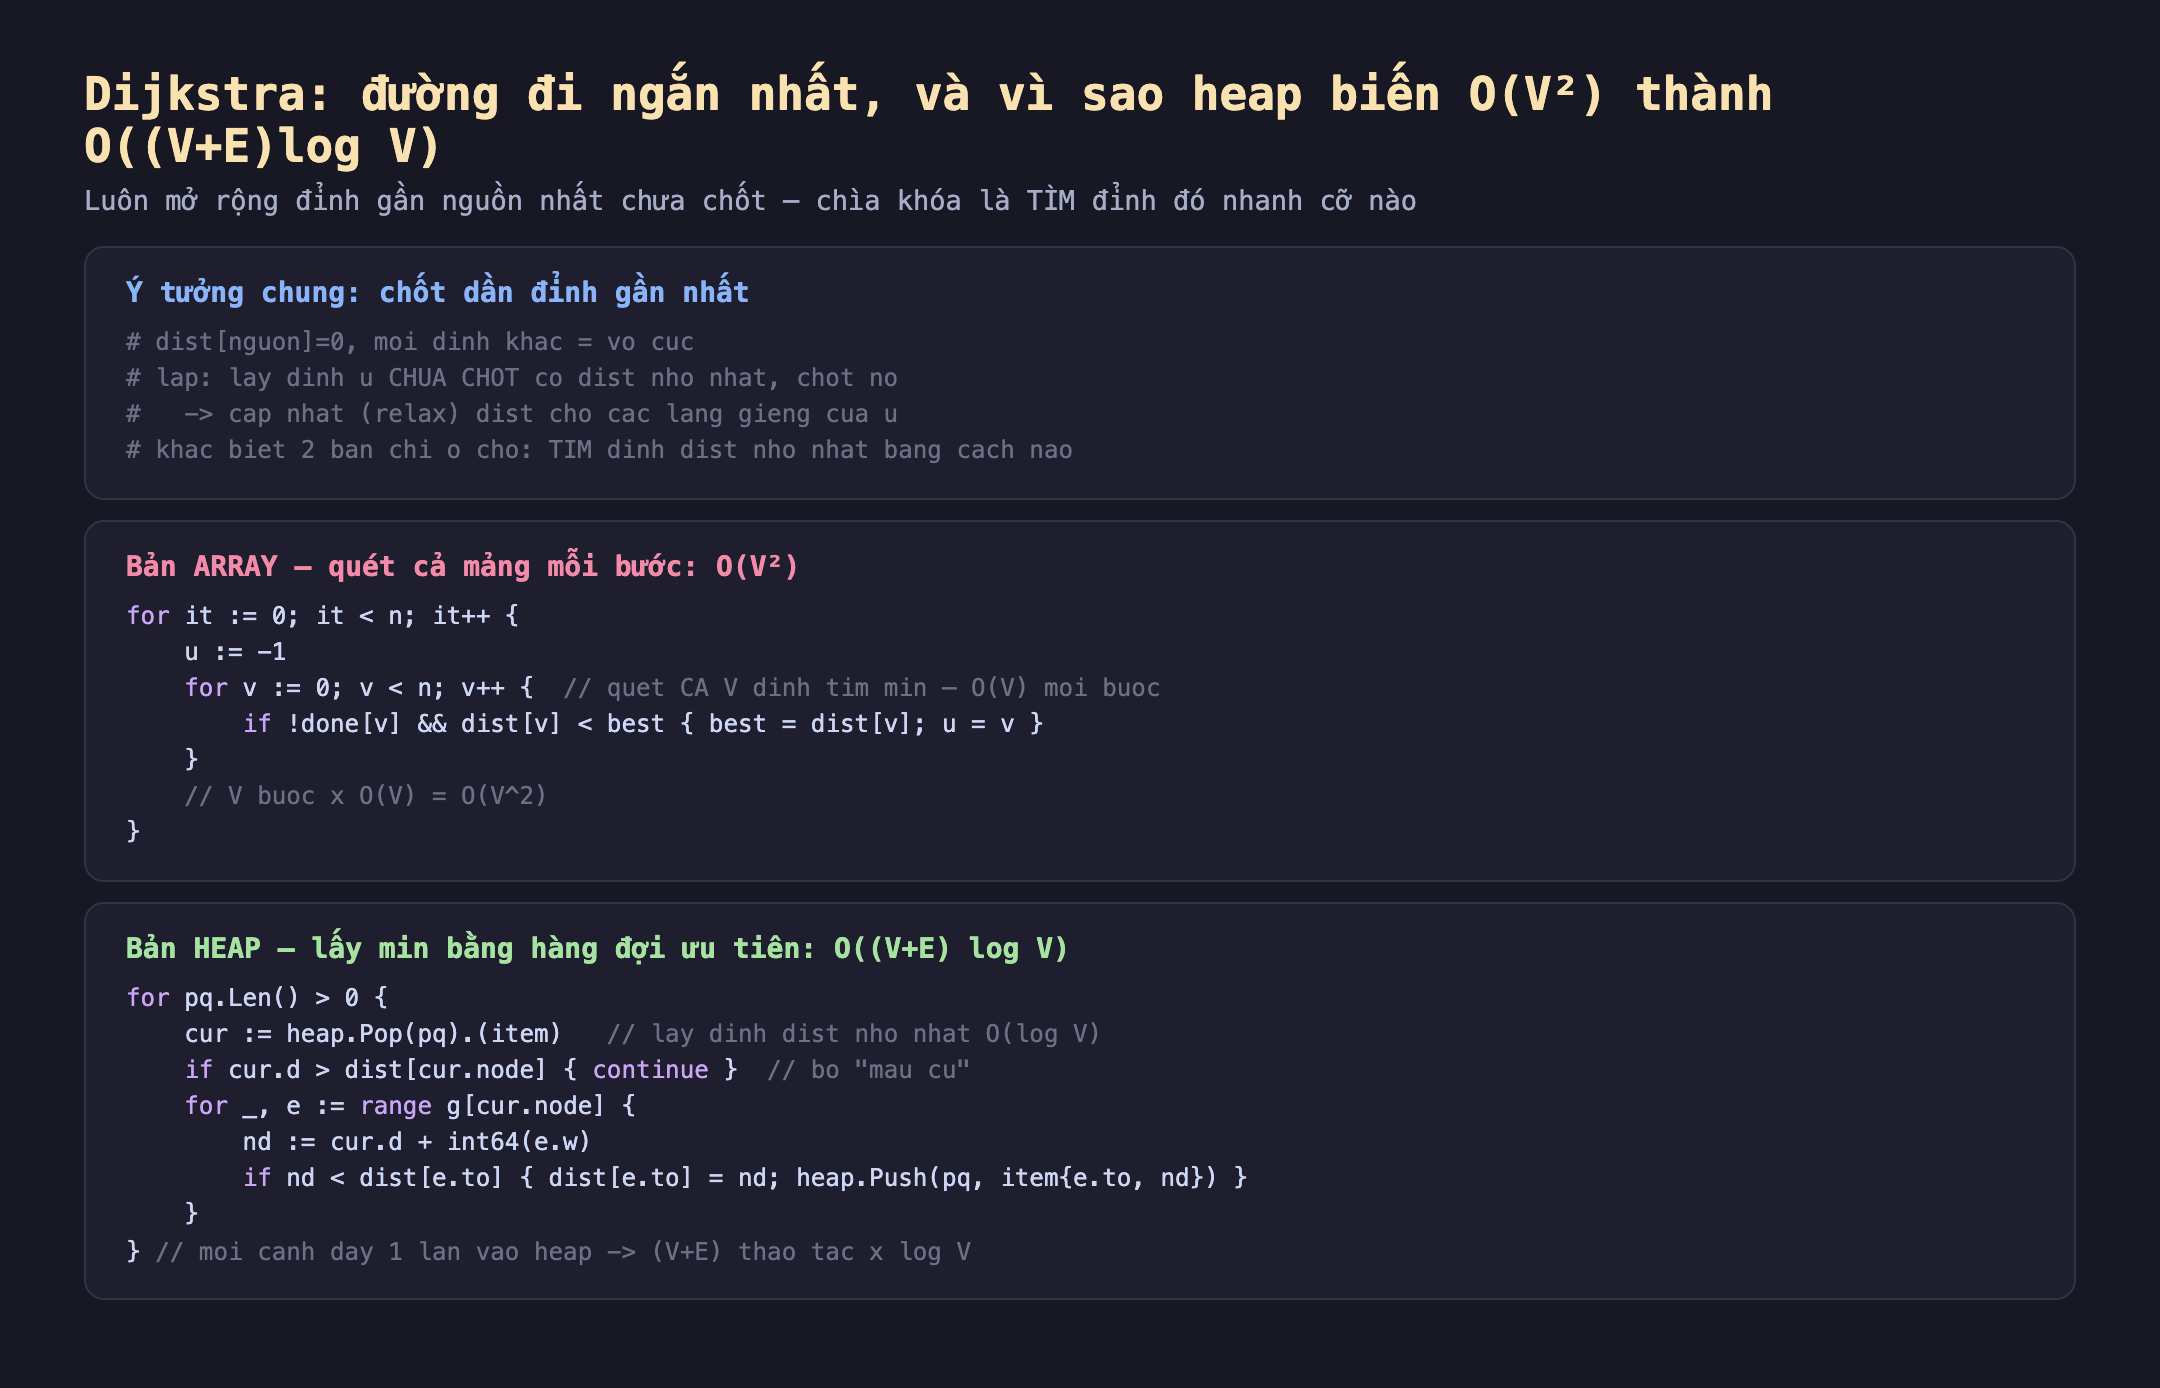
Hình 1: Dijkstra chốt dần đỉnh gần nguồn nhất rồi nới lỏng láng giềng. Bản array quét cả V đỉnh mỗi bước để tìm min → O(V²). Bản heap lấy min bằng hàng đợi ưu tiên O(log V) → O((V+E) log V).
// Ban ARRAY: moi buoc quet CA mang tim dinh dist nho nhat — O(V^2)
func dijkstraArray(g Graph, s int) []int64 {
	dist := make([]int64, len(g)); done := make([]bool, len(g))
	// ... init dist = INF, dist[s] = 0 ...
	for it := 0; it < len(g); it++ {
		u, best := -1, int64(INF)
		for v := range g { // quet CA V dinh — O(V) moi buoc
			if !done[v] && dist[v] < best { best = dist[v]; u = v }
		}
		if u == -1 { break }
		done[u] = true
		for _, e := range g[u] { // noi long lang gieng
			if dist[u]+int64(e.w) < dist[e.to] { dist[e.to] = dist[u] + int64(e.w) }
		}
	}
	return dist
}

// Ban HEAP: lay min bang hang doi uu tien — O((V+E) log V)
func dijkstraHeap(g Graph, s int) []int64 {
	dist := make([]int64, len(g)) // ... init INF, dist[s]=0 ...
	pq := &PQ{{s, 0}}
	for pq.Len() > 0 {
		cur := heap.Pop(pq).(item) // lay dinh dist nho nhat O(log V)
		if cur.d > dist[cur.node] { continue } // bo "mau cu"
		for _, e := range g[cur.node] {
			nd := cur.d + int64(e.w)
			if nd < dist[e.to] { dist[e.to] = nd; heap.Push(pq, item{e.to, nd}) }
		}
	}
	return dist
}
Bản array quét toàn bộ V đỉnh ở mỗi vòng → V vòng × O(V) = O(V²). Bản heap lấy đỉnh nhỏ nhất trong O(log V), và mỗi cạnh chỉ đẩy vào heap một lần → O((V+E) log V). Với đồ thị thưa (E ≈ V), đó là O(V log V) — gần tuyến tính.
Đo thật: đồ thị thưa, heap đè bẹp array
Mình chạy cả hai trên đồ thị thưa có trọng số (mỗi đỉnh ~8 cạnh, trọng số 1-100), kiểm tra hai bản cho cùng kết quả. Số liệu thật từ go-lab:
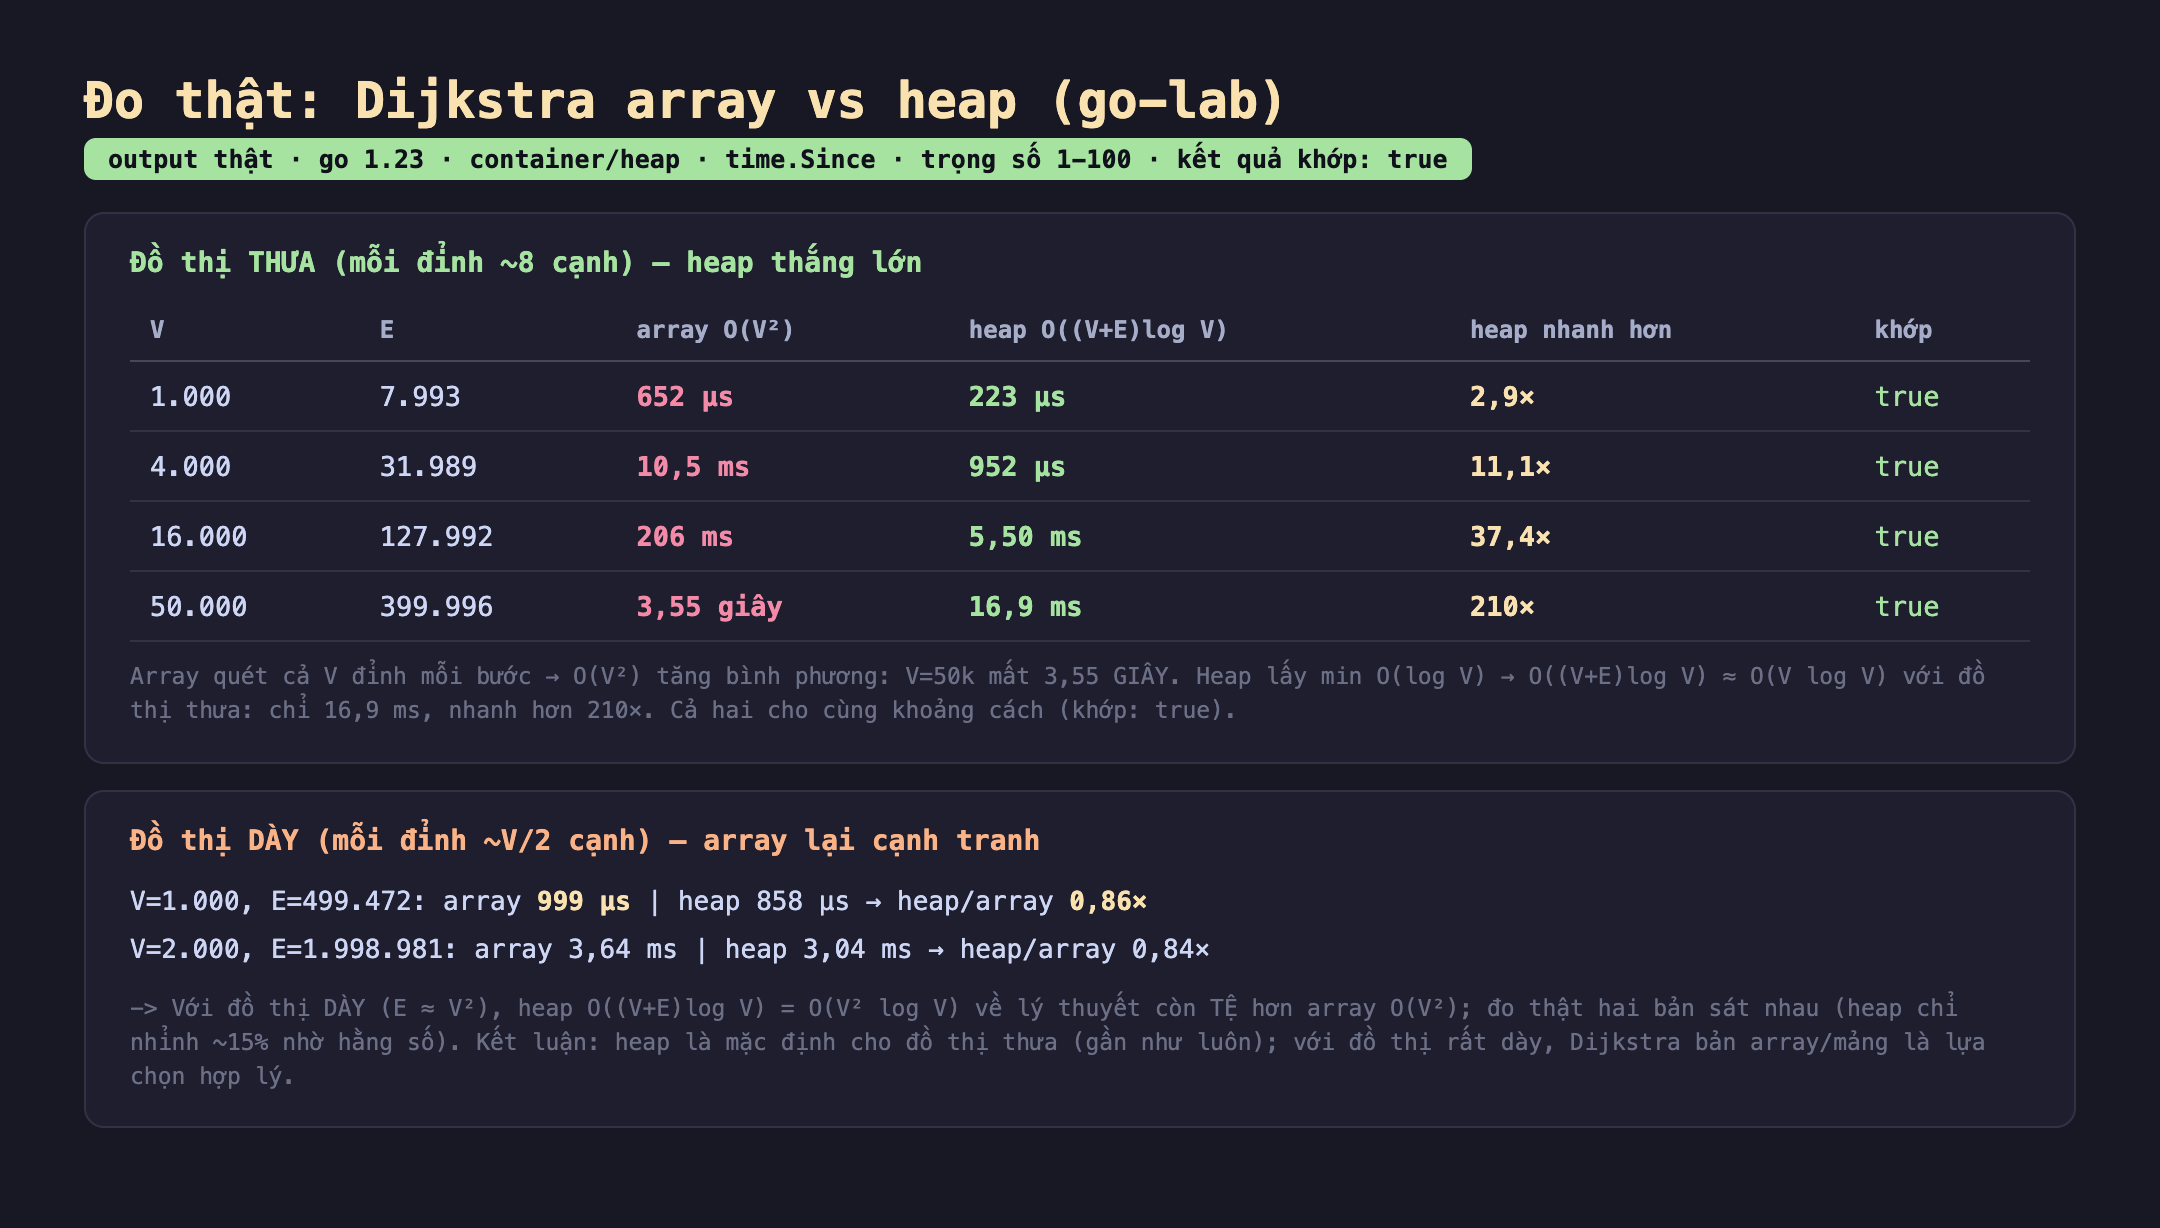
Hình 2: Kết quả thật. Đồ thị thưa: heap nhanh hơn array 2,9× đến 210× (V=50.000: 3,55 giây vs 16,9 ms), cùng kết quả (khớp: true). Đồ thị dày: hai bản sát nhau (heap chỉ 0,84×).
- Array O(V²) tăng bình phương: 652 µs → 10,5 ms → 206 ms → 3,55 giây. Mỗi khi V tăng ~3-4 lần, thời gian nhân khoảng 10-16 lần (đúng V²). Ở V=50.000, nó mất hơn ba giây rưỡi.
- Heap O((V+E) log V) gần tuyến tính: 223 µs → 952 µs → 5,5 ms → 16,9 ms. Ở V=50.000, heap nhanh hơn array 210 lần.
- Cùng kết quả: cột "khớp: true" xác nhận cả hai cho cùng mảng khoảng cách ngắn nhất — heap không hy sinh tính đúng, chỉ tìm đỉnh min thông minh hơn.
Điểm kỹ thuật đáng chú ý trong bản heap: dòng if cur.d > dist[cur.node] { continue }. Vì ta đẩy một đỉnh vào heap nhiều lần (mỗi lần tìm được đường ngắn hơn), heap có thể chứa các "bản ghi cũ" (stale). Khi pop ra một bản ghi có khoảng cách lớn hơn khoảng cách tốt nhất đã biết, ta bỏ qua. Đây là mẹo "lazy deletion" giúp tránh phải cài heap có thao tác giảm khóa (decrease-key) phức tạp.
Ngoại lệ: trên đồ thị dày, array lại cạnh tranh
Đây là chỗ Big-O cho một bài học tinh tế. Mình chạy lại trên đồ thị dày (mỗi đỉnh nối ~V/2 đỉnh khác, E ≈ V²/2): array và heap gần như bằng nhau, heap chỉ nhanh hơn ~15% (heap/array = 0,84-0,86×).
Vì sao? Với đồ thị dày, E ≈ V², nên:
- Array vẫn là O(V²).
- Heap là O((V+E) log V) = O(V² log V) — thêm một thừa số
log V, tệ hơn về lý thuyết.
Thực tế hai bản sát nhau vì hằng số của heap nhỏ và đồ thị chưa đủ lớn để log V lộ rõ. Bài học: bản phức tạp hơn (heap) không phải lúc nào cũng thắng — nó thắng với đồ thị thưa (gần như mọi đồ thị thực tế), nhưng với đồ thị dày, Dijkstra bản array/mảng đơn giản lại là lựa chọn hợp lý, thậm chí nhỉnh hơn.
Đánh đổi cần cân nhắc
Dijkstra không chạy với cạnh trọng số âm. Giả định cốt lõi của Dijkstra: khi một đỉnh được chốt, khoảng cách của nó đã tối ưu và không bao giờ đổi. Giả định này sai nếu có cạnh âm — một đường vòng qua cạnh âm có thể ngắn hơn đường "trực tiếp" đã chốt. Với đồ thị có trọng số âm, phải dùng Bellman-Ford O(VE) (chậm hơn nhưng xử lý được cạnh âm và phát hiện chu trình âm). Đừng dùng Dijkstra khi trọng số có thể âm — nó cho kết quả sai im lặng.
Heap "lazy" tốn thêm bộ nhớ nhưng đơn giản hơn. Bản heap ở trên đẩy mỗi cạnh một lần và để các bản ghi cũ nằm trong heap cho tới khi bị bỏ qua — nên heap có thể chứa tới O(E) phần tử, tốn bộ nhớ hơn. Bản "sạch" dùng decrease-key giữ heap chỉ O(V) phần tử nhưng cài đặt phức tạp (cần chỉ số vị trí trong heap). Với hầu hết trường hợp, bản lazy đơn giản hơn và đủ nhanh; chỉ tối ưu bộ nhớ khi thật sự cần.
Với đồ thị cực lớn, có thuật toán tốt hơn cả Dijkstra cơ bản. Dijkstra tìm đường tới mọi đỉnh. Nếu chỉ cần đường tới một đích cụ thể, A* (A-star) dùng heuristic để hướng tìm kiếm về đích, thường nhanh hơn nhiều. Với đồ thị đường bộ khổng lồ (bản đồ), còn các kỹ thuật tiền xử lý (contraction hierarchies) cho truy vấn gần như tức thì. Dijkstra là nền tảng, nhưng biết khi nào cần công cụ chuyên dụng hơn.
Ba ý mang về
- Cách tìm đỉnh min quyết định tốc độ Dijkstra. Đo thật trên đồ thị thưa 50.000 đỉnh: bản quét mảng O(V²) mất 3,55 giây, bản heap O((V+E) log V) chỉ 16,9 ms — nhanh hơn 210×, cùng kết quả. Heap (hàng đợi ưu tiên) biến bước tìm min từ O(V) thành O(log V).
- Thuật toán phức tạp hơn không phải lúc nào cũng thắng. Đo thật: trên đồ thị dày (E ≈ V²), heap O((V+E) log V) = O(V² log V) còn tệ hơn array O(V²) về lý thuyết, và đo được hai bản sát nhau. Heap thắng với đồ thị thưa (gần như mọi đồ thị thực), array hợp với đồ thị dày.
- Biết giới hạn của Dijkstra. Nó cần trọng số không âm (cạnh âm → dùng Bellman-Ford); mẹo "lazy deletion" (
if cur.d > dist[node] continue) giúp tránh decrease-key phức tạp; và với tìm đường tới một đích, A* thường nhanh hơn.
Nguồn
- Wikipedia — Dijkstra's algorithm: https://en.wikipedia.org/wiki/Dijkstra%27s_algorithm
- Go docs — container/heap: https://pkg.go.dev/container/heap
- CLRS — Single-Source Shortest Paths: https://mitpress.mit.edu/9780262046305/introduction-to-algorithms/
Phần sau ta rời khỏi Big-O thuần để chạm vào phần cứng: vì sao duyệt mảng theo hàng nhanh hơn theo cột dù cùng số phép tính, và cách bố trí dữ liệu thân thiện cache (struct-of-arrays) tăng tốc nhiều lần mà không đổi độ phức tạp.
