Đồ thị là mô hình của gần như mọi thứ có quan hệ: mạng xã hội, bản đồ đường đi, phụ thuộc giữa các task, liên kết web. Và hai thao tác nền tảng nhất trên đồ thị là duyệt nó: BFS (tìm kiếm theo chiều rộng) và DFS (tìm kiếm theo chiều sâu). Cả hai đều O(V+E) — thăm mỗi đỉnh và mỗi cạnh một lần.
Nhưng có một quyết định đến trước cả việc chọn BFS hay DFS, và nó ảnh hưởng tới hiệu năng lớn hơn nhiều: cách biểu diễn đồ thị trong bộ nhớ. Danh sách kề (adjacency list) hay ma trận kề (adjacency matrix)? Bài này (phần 9 loạt Giải thuật) đo thật khoảng cách giữa hai lựa chọn này — và nó lớn đến mức đủ làm sập một service nếu chọn sai.
BFS, DFS và hai cách biểu diễn
BFS dùng hàng đợi, thăm các đỉnh theo lớp (gần trước, xa sau). DFS dùng đệ quy (hoặc ngăn xếp), đi sâu hết một nhánh rồi mới quay lui. Khác biệt là thứ tự, không phải độ phức tạp.
Phần quan trọng hơn là biểu diễn. Danh sách kề lưu với mỗi đỉnh một danh sách các láng giềng thật của nó — tốn O(V+E) bộ nhớ. Ma trận kề lưu một bảng V×V, ô (u,w) = 1 nếu có cạnh — tốn O(V²) bộ nhớ bất kể có bao nhiêu cạnh.
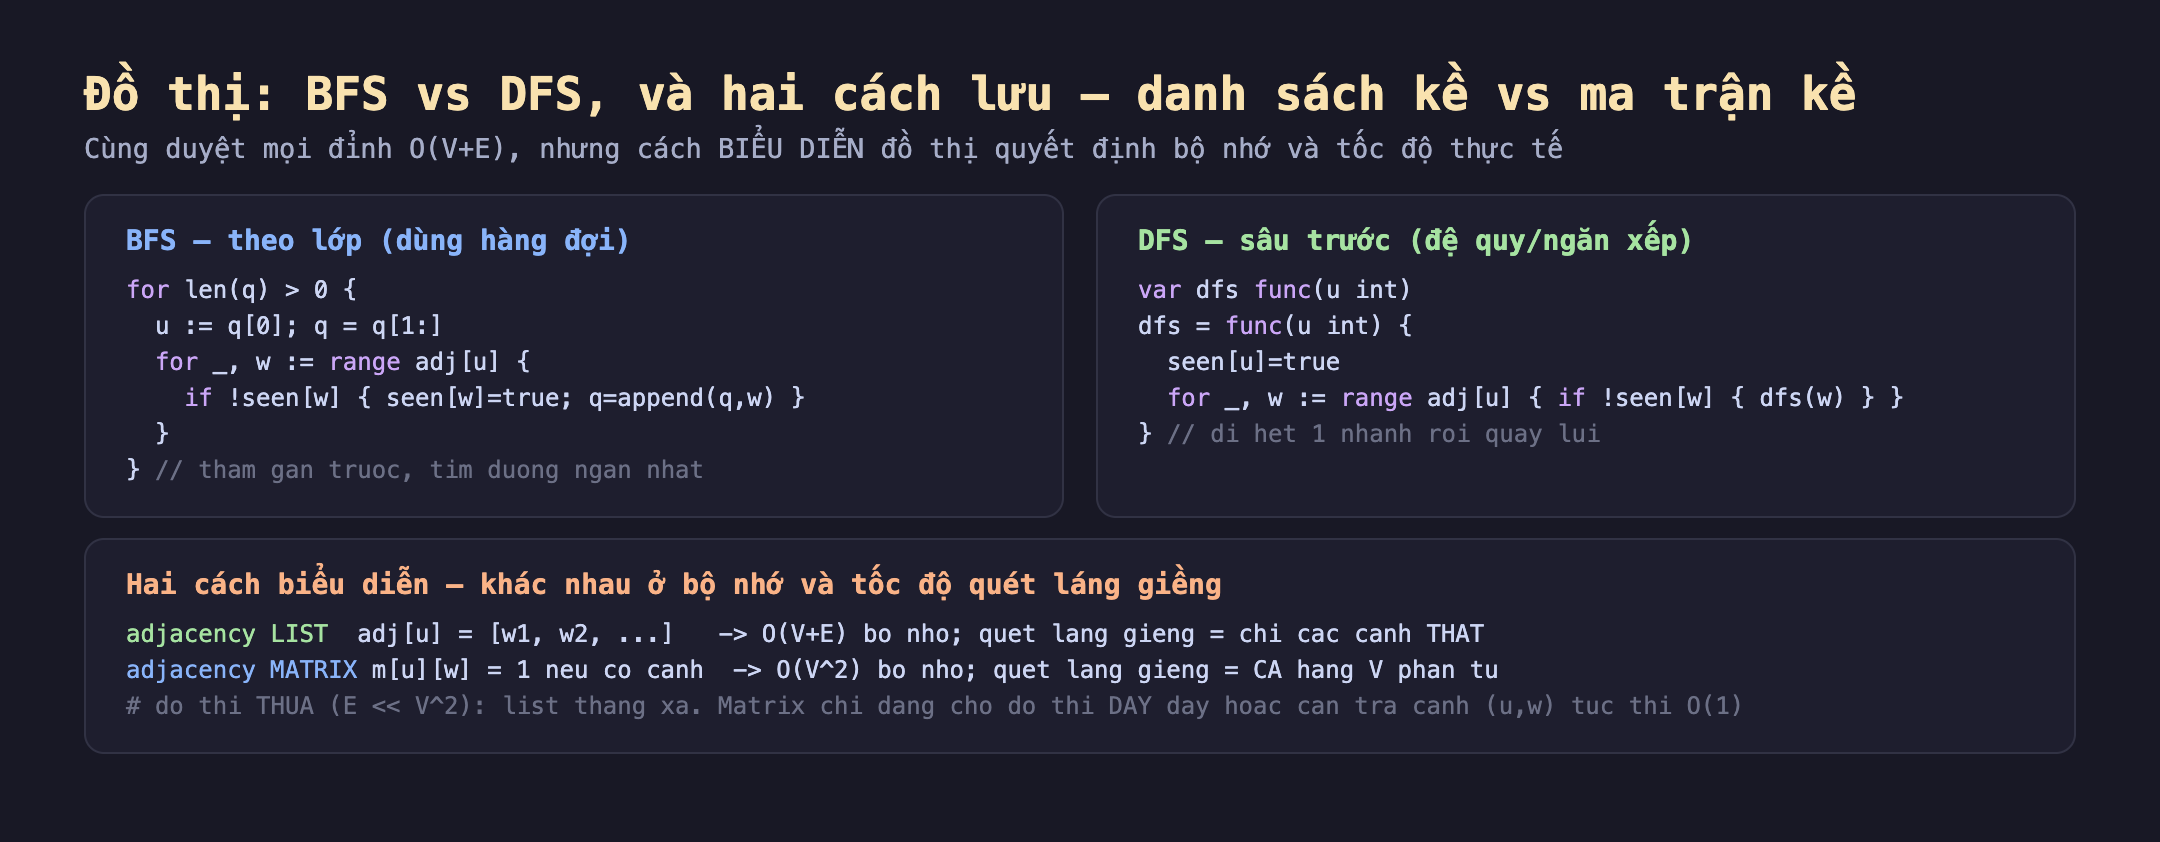
Hình 1: BFS thăm theo lớp (hàng đợi), DFS đi sâu (đệ quy). Danh sách kề lưu các láng giềng thật (O(V+E)); ma trận kề lưu bảng V×V (O(V²)). Trên đồ thị thưa, quét láng giềng bằng list chỉ chạm cạnh thật, bằng matrix phải quét cả hàng V phần tử.
// BFS: theo lop, dung hang doi
func bfsList(g *GraphList, s int) {
	seen := make([]bool, len(g.adj))
	q := []int{s}; seen[s] = true
	for len(q) > 0 {
		u := q[0]; q = q[1:]
		for _, w := range g.adj[u] { // chi cac canh THAT cua u
			if !seen[w] { seen[w] = true; q = append(q, w) }
		}
	}
}

// BFS tren matrix: moi dinh phai quet CA hang V phan tu
func bfsMat(g *GraphMat, s int) {
	seen := make([]bool, g.v)
	q := []int{s}; seen[s] = true
	for len(q) > 0 {
		u := q[0]; q = q[1:]
		for w := 0; w < g.v; w++ { // quet het V o, phan lon la 0
			if g.m[u][w] == 1 && !seen[w] { seen[w] = true; q = append(q, w) }
		}
	}
}
Đo thật: đồ thị thưa, list đè bẹp matrix
Phần lớn đồ thị thực tế là thưa (sparse): số cạnh E nhỏ hơn nhiều so với V² tối đa. Mình tạo đồ thị với mỗi đỉnh ~8 cạnh (E ≈ 8V), rồi đo cả thời gian duyệt lẫn bộ nhớ của hai cách biểu diễn. Kết quả thật từ go-lab:
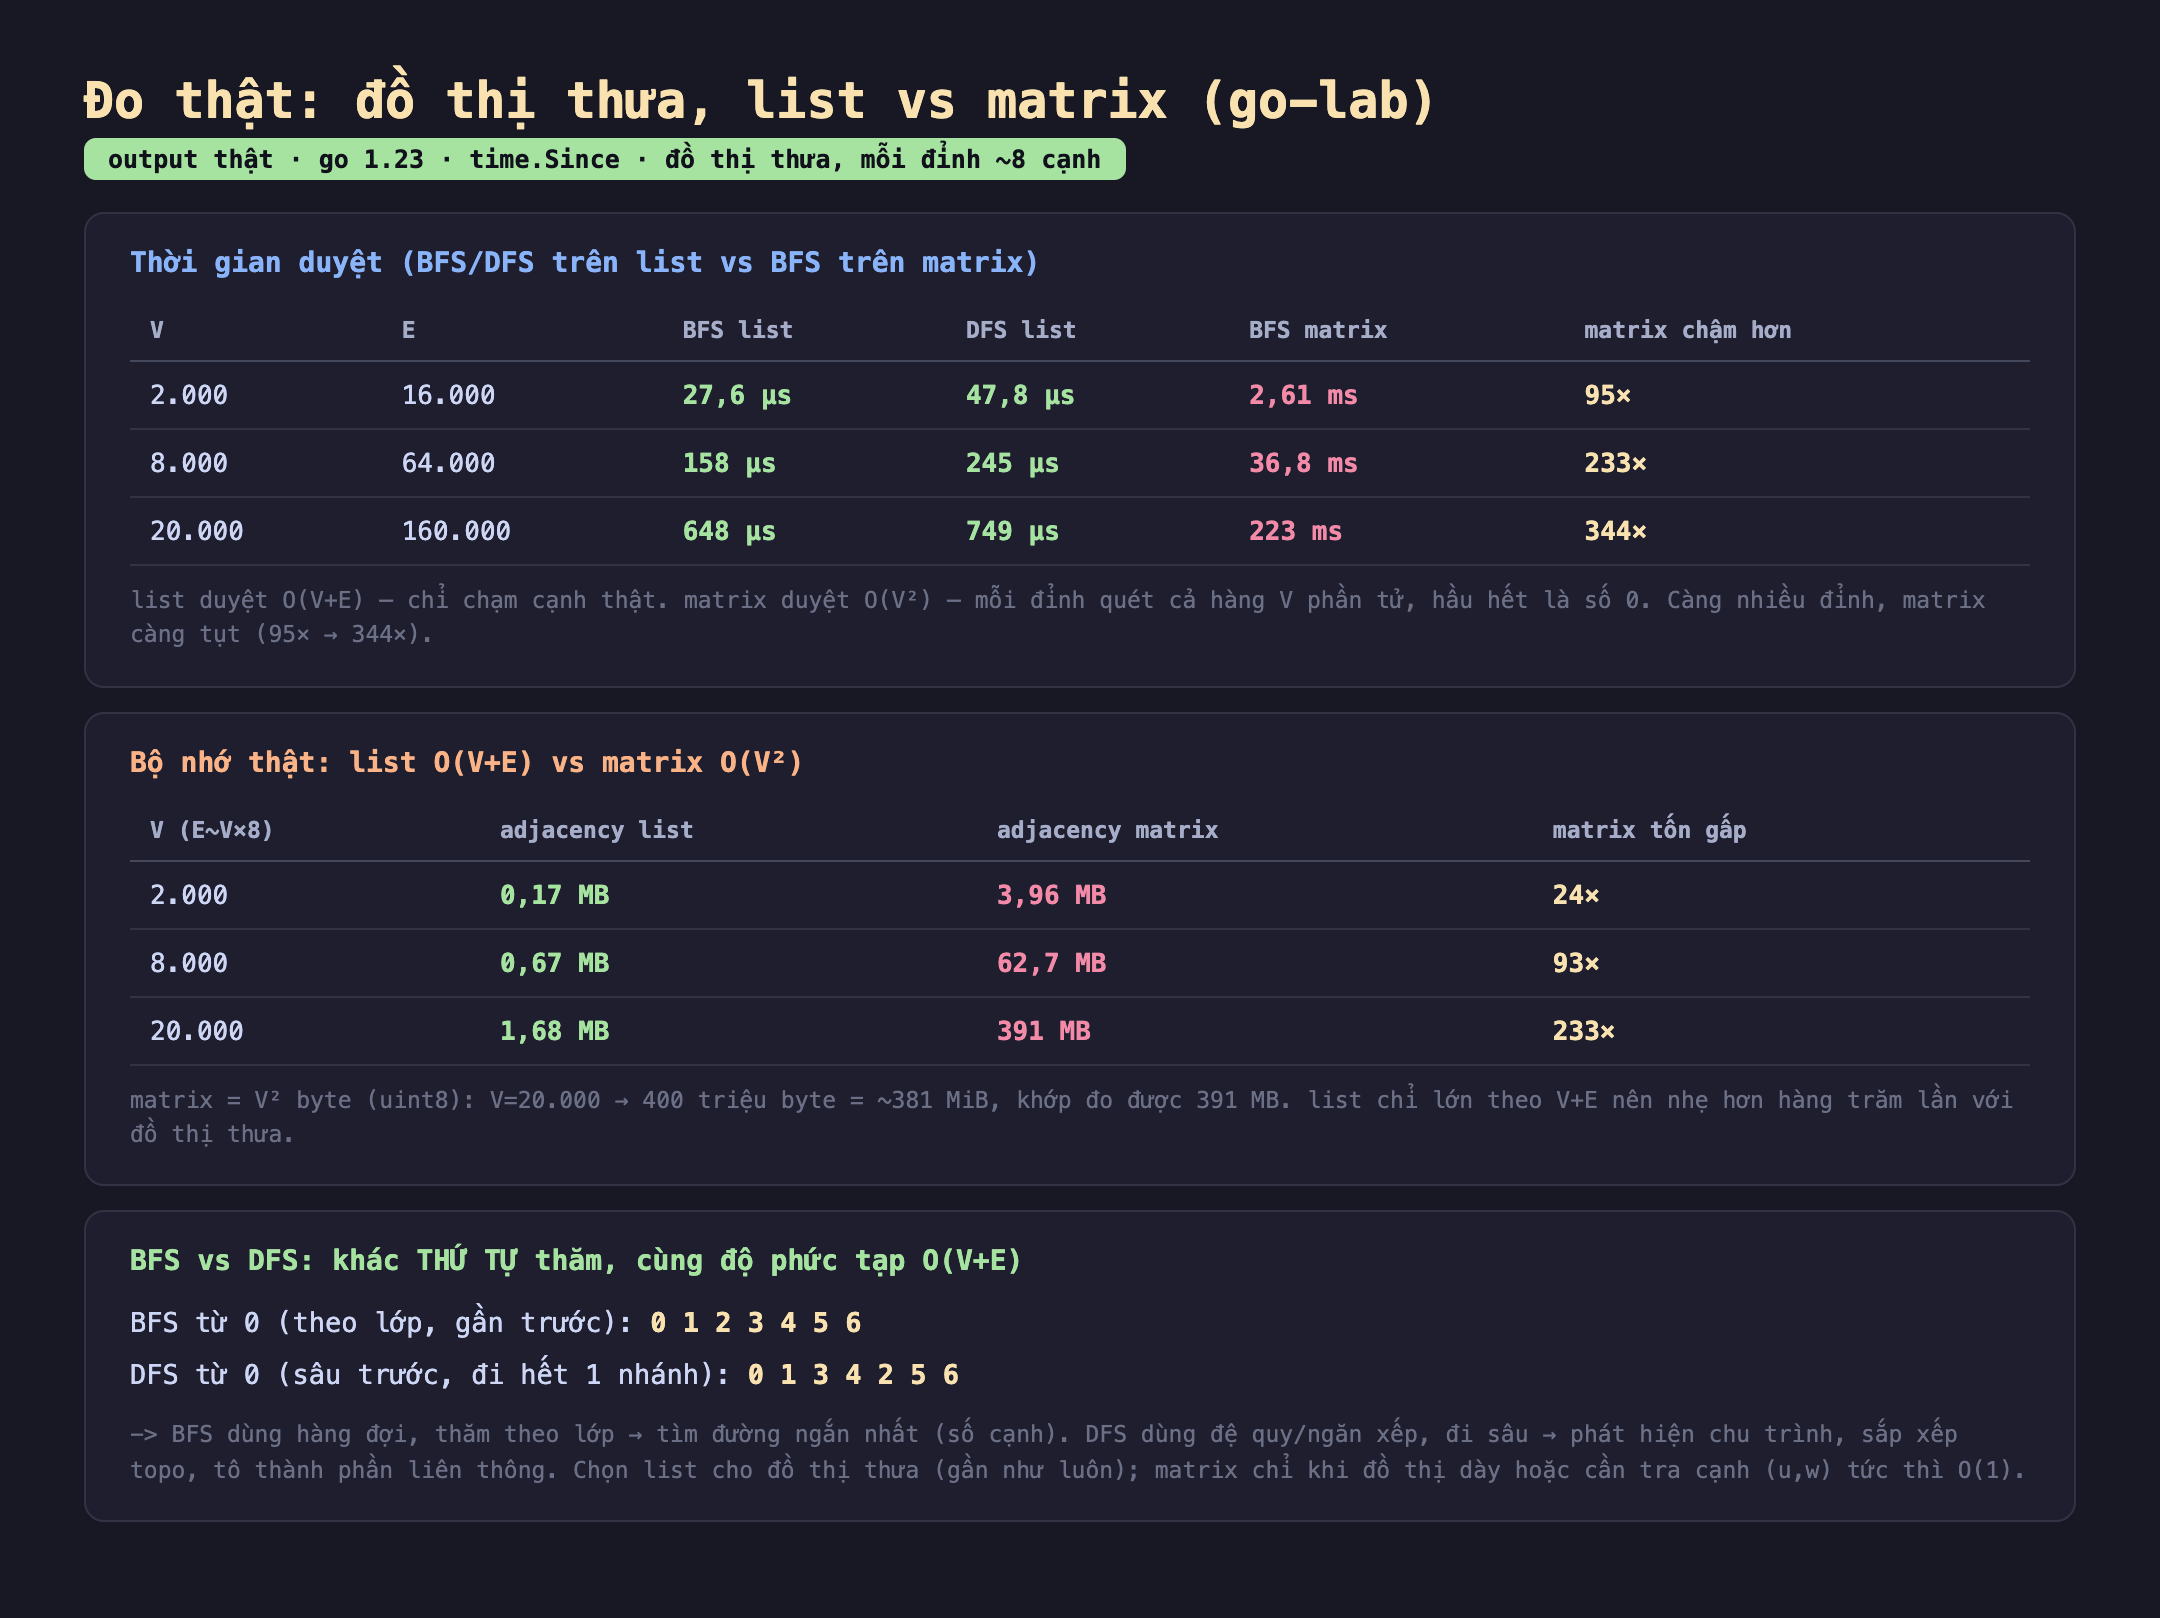
Hình 2: Kết quả thật. BFS/DFS trên list rất nhanh (O(V+E)); BFS trên matrix chậm hơn 95-344× (O(V²)). Ma trận tốn 24-233× bộ nhớ: 391 MB so với 1,68 MB ở V=20.000. BFS và DFS cho thứ tự thăm khác nhau.
- Thời gian: matrix chậm hơn 95× đến 344×. Trên list, BFS duyệt O(V+E) — mỗi đỉnh chỉ chạm các cạnh thật. Trên matrix, mỗi đỉnh phải quét cả hàng V phần tử, mà với đồ thị thưa thì hầu hết là số 0 — phí phạm. Càng nhiều đỉnh, tỉ lệ phí càng lớn: từ 95× (V=2.000) lên 344× (V=20.000).
- Bộ nhớ: matrix tốn 24× đến 233×. Ở V=20.000, matrix ngốn 391 MB còn list chỉ 1,68 MB. Con số matrix khớp với lý thuyết: V² byte = 20.000² = 400 triệu byte ≈ 381 MiB. Matrix tăng bình phương theo số đỉnh, trong khi list tăng tuyến tính theo V+E.
Hãy hình dung quy mô thật: một đồ thị 1 triệu đỉnh thưa (như mạng xã hội) cần ma trận kề 1 triệu² = 1 nghìn tỉ byte = ~1 TB RAM — bất khả thi. Cùng đồ thị đó, danh sách kề chỉ cần vài trăm MB. Đây không phải tối ưu vi mô; đây là khác biệt giữa "chạy được" và "không chạy được".
BFS vs DFS: khác thứ tự, không khác tốc độ
Trên cùng một đồ thị nhỏ, BFS cho thứ tự thăm 0 1 2 3 4 5 6 (theo lớp — thăm hết các đỉnh kề 0 trước), còn DFS cho 0 1 3 4 2 5 6 (đi sâu — xuống hết nhánh của 1 trước khi quay lại 2). Cả hai đều O(V+E); lựa chọn giữa chúng là về bài toán, không phải tốc độ:
- BFS thăm theo lớp nên tìm được đường đi ngắn nhất (ít cạnh nhất) trong đồ thị không trọng số — nền tảng cho tìm đường, lan truyền theo tầng.
- DFS đi sâu nên tự nhiên phù hợp phát hiện chu trình, sắp xếp topo (thứ tự thực thi task có phụ thuộc), tìm thành phần liên thông, và quay lui (backtracking).
Đánh đổi cần cân nhắc
Ma trận kề KHÔNG phải luôn tệ — nó thắng khi đồ thị dày hoặc cần tra cạnh O(1). Nếu đồ thị dày (E xấp xỉ V², ví dụ đồ thị gần đầy đủ), thì list cũng tốn ~V² và matrix không còn lãng phí; lúc đó matrix thậm chí nhanh hơn nhờ truy cập liền kề, thân thiện cache. Quan trọng hơn, matrix cho phép kiểm tra "có cạnh (u,w) không" trong O(1) (m[u][w]), còn list phải quét danh sách láng giềng của u — O(bậc). Thuật toán nào hỏi "u và w có nối nhau không" liên tục (như một số thuật toán đồ thị dày) sẽ hưởng lợi từ matrix.
Danh sách kề là mặc định đúng cho hầu hết đồ thị thực tế. Vì đa số đồ thị thực tế là thưa (mỗi đỉnh nối với một số nhỏ đỉnh khác, không phải tất cả), list gần như luôn là lựa chọn: ít bộ nhớ, duyệt nhanh. Trừ khi bạn biết đồ thị dày hoặc cần tra cạnh O(1), hãy mặc định dùng list.
DFS đệ quy có rủi ro tràn stack trên đồ thị sâu. DFS cài đặt đệ quy (như demo) xây ngăn xếp gọi sâu bằng độ dài đường đi dài nhất — với đồ thị rất sâu (ví dụ một chuỗi dài hàng trăm nghìn đỉnh), nó có thể tràn stack. Khi đó, cài DFS bằng ngăn xếp tường minh (explicit stack) thay vì đệ quy, hoặc dùng BFS nếu phù hợp bài toán. Đây là cạm bẫy giống memoization ở bài quy hoạch động.
Ba ý mang về
- Cách biểu diễn đồ thị quyết định hiệu năng nhiều hơn chọn BFS/DFS. Đo thật: trên đồ thị thưa 20.000 đỉnh, ma trận kề tốn 391 MB và duyệt chậm hơn 344× so với danh sách kề (1,68 MB). Matrix tăng bình phương O(V²), list tăng tuyến tính O(V+E).
- Danh sách kề là mặc định cho đồ thị thưa; ma trận chỉ cho đồ thị dày hoặc cần tra cạnh O(1). Đồ thị thực tế hầu hết thưa, nên list gần như luôn thắng; matrix thắng khi E≈V² hoặc khi thuật toán hỏi "có cạnh (u,w)?" liên tục.
- BFS và DFS khác thứ tự thăm, cùng O(V+E). Đo thật: BFS cho thứ tự theo lớp (
0 1 2 3 4 5 6), DFS theo chiều sâu (0 1 3 4 2 5 6). BFS cho đường ngắn nhất không trọng số; DFS cho phát hiện chu trình, sắp xếp topo, thành phần liên thông — nhưng DFS đệ quy có rủi ro tràn stack trên đồ thị sâu.
Nguồn
- Wikipedia — Breadth-first search, Depth-first search: https://en.wikipedia.org/wiki/Breadth-first_search
- Wikipedia — Adjacency list vs adjacency matrix: https://en.wikipedia.org/wiki/Adjacency_matrix
- CLRS — Introduction to Algorithms, Graph Algorithms: https://mitpress.mit.edu/9780262046305/introduction-to-algorithms/
Phần sau ta nâng cấp BFS lên đồ thị có trọng số: thuật toán Dijkstra tìm đường đi ngắn nhất, và đo thật vì sao dùng heap (hàng đợi ưu tiên ở bài 6) biến Dijkstra từ O(V²) thành O((V+E) log V).
