Thuật toán tham lam (greedy) hấp dẫn vì nó phản ánh đúng cách con người hay suy nghĩ: ở mỗi bước, chọn phương án trông tốt nhất ngay lúc này, rồi đi tiếp. Nó nhanh, dễ viết, dễ hiểu. Vấn đề là — đôi khi chuỗi các lựa chọn tốt nhất cục bộ lại dẫn tới một kết quả tệ nhất toàn cục.
Bài này (phần 8 loạt Giải thuật) đặt greedy cạnh quy hoạch động (DP — bài trước) qua một bài toán kinh điển: đổi tiền (coin change) — dùng ít đồng xu nhất để trả đủ một số tiền. Ta sẽ đo thật trường hợp greedy cho lời giải tối ưu, và trường hợp nó sai một cách ngoạn mục, để rút ra khi nào được tin greedy.
Hai cách tiếp cận
Greedy: luôn lấy đồng xu lớn nhất không vượt quá số tiền còn lại, lặp đến hết. Trực giác: dùng đồng lớn thì cần ít đồng hơn. Chi phí chỉ O(số mệnh giá).
DP: tính số đồng tối thiểu cho mọi số tiền từ 1 đến amount, mỗi số dựa trên các số nhỏ hơn đã tính. Nó xét mọi khả năng nên luôn cho lời giải tối ưu, nhưng tốn O(amount × số mệnh giá).
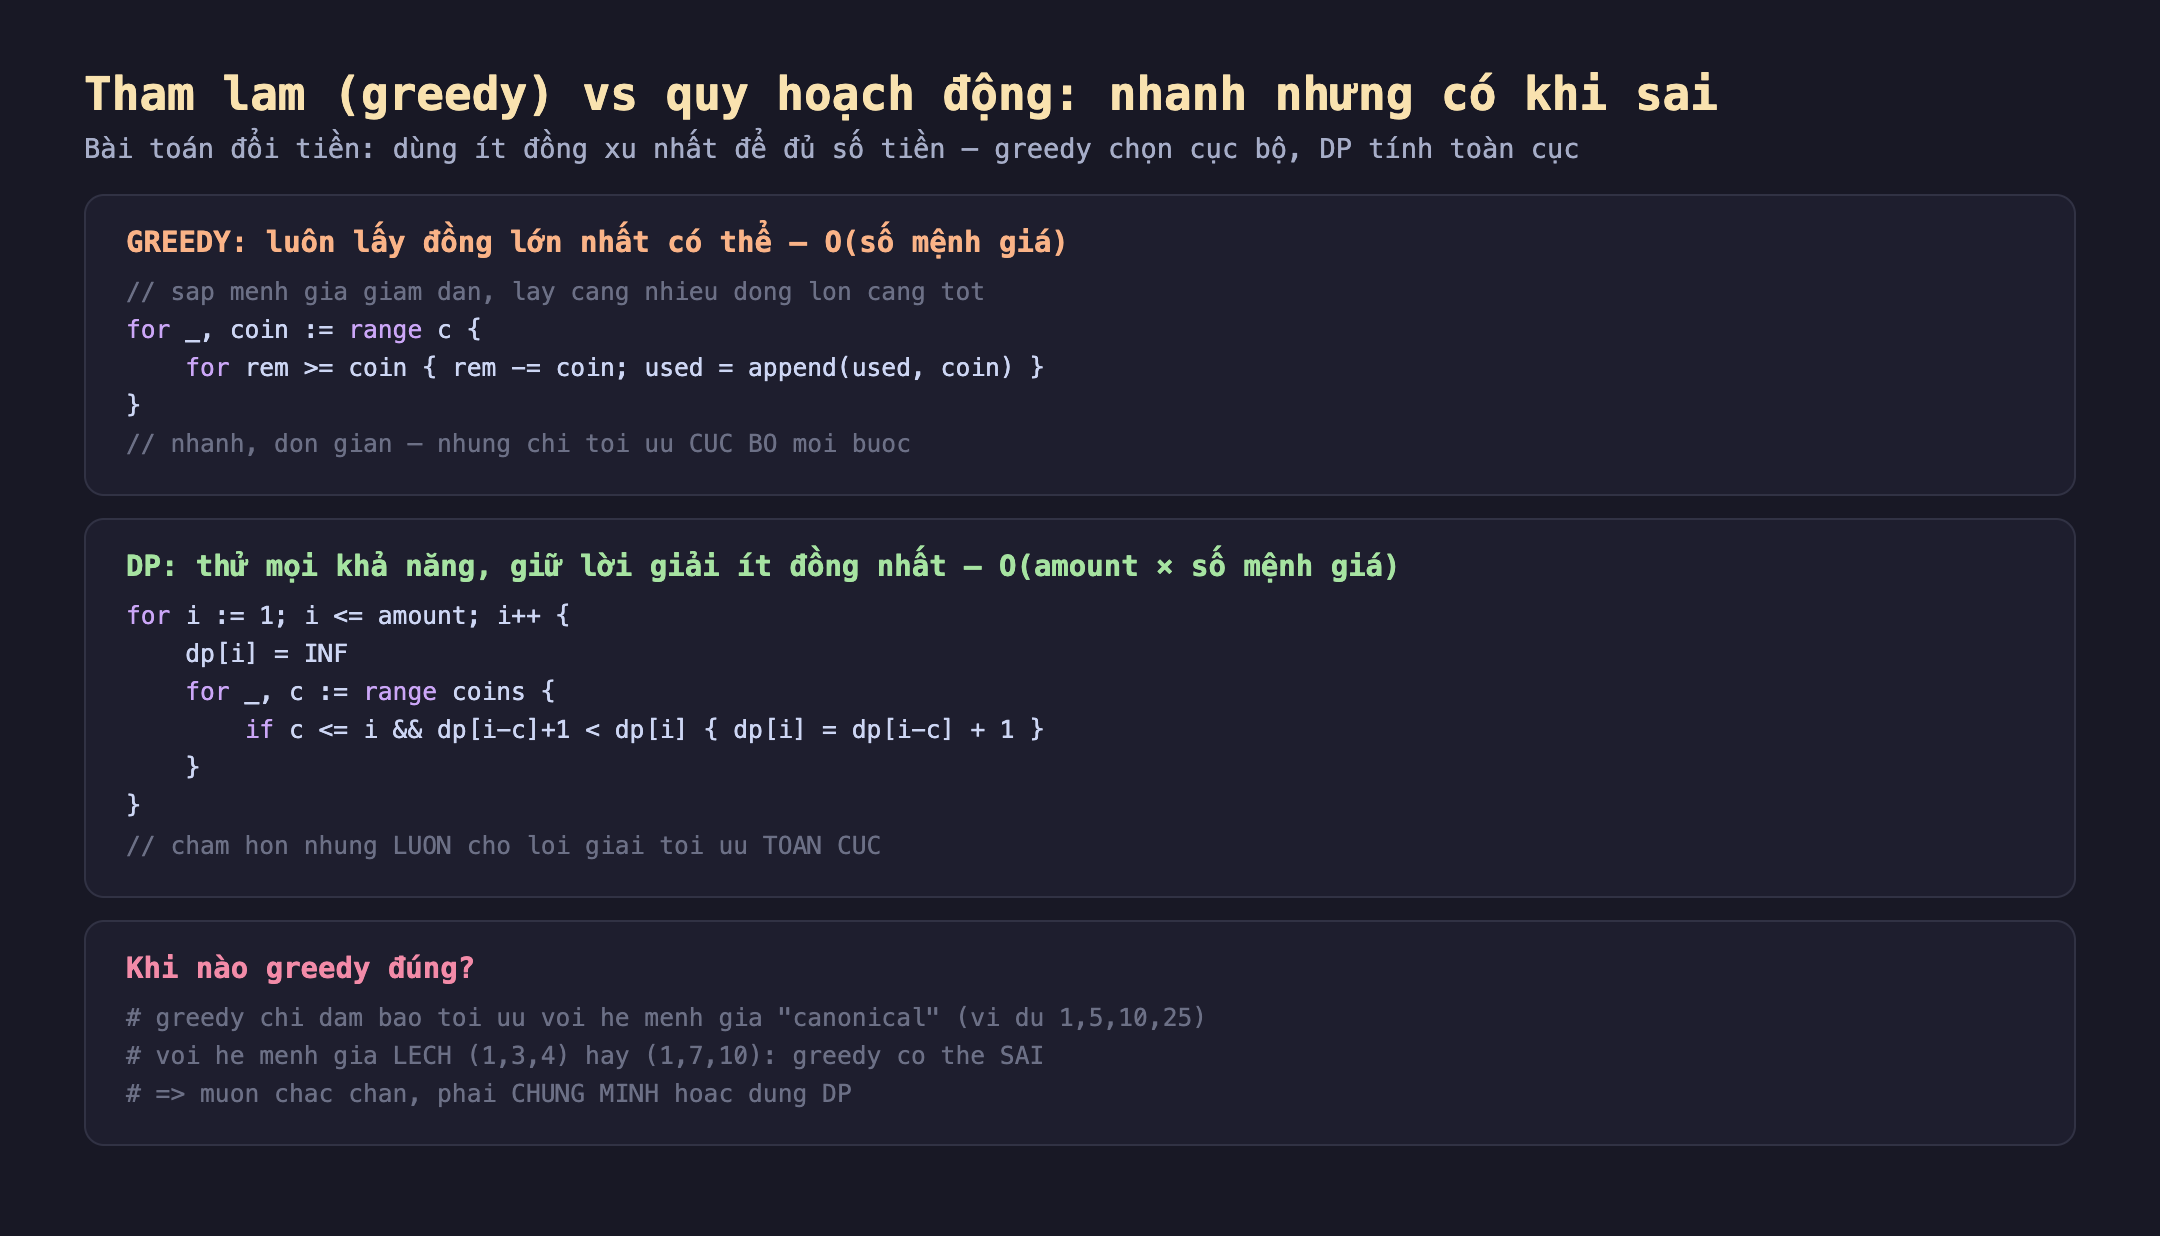
Hình 1: Greedy lấy đồng lớn nhất mỗi bước (O(số mệnh giá), nhanh nhưng tối ưu cục bộ). DP xét mọi số tiền và mọi mệnh giá (O(amount × mệnh giá), luôn tối ưu toàn cục). Greedy chỉ đảm bảo đúng với hệ mệnh giá "canonical".
// GREEDY: luon lay dong lon nhat <= so tien con lai
func greedyCoins(coins []int, amount int) int {
	sort.Sort(sort.Reverse(sort.IntSlice(coins)))
	count, rem := 0, amount
	for _, coin := range coins {
		for rem >= coin {
			rem -= coin
			count++
		}
	}
	return count
}

// DP: so dong it nhat de doi amount — luon toi uu
func dpCoins(coins []int, amount int) int {
	const INF = 1 << 30
	dp := make([]int, amount+1)
	for i := 1; i <= amount; i++ {
		dp[i] = INF
		for _, c := range coins {
			if c <= i && dp[i-c]+1 < dp[i] {
				dp[i] = dp[i-c] + 1
			}
		}
	}
	return dp[amount]
}
Đo thật: khi greedy đúng, khi greedy sai
Mình chạy cả hai trên ba bộ mệnh giá khác nhau. Kết quả thật từ go-lab:
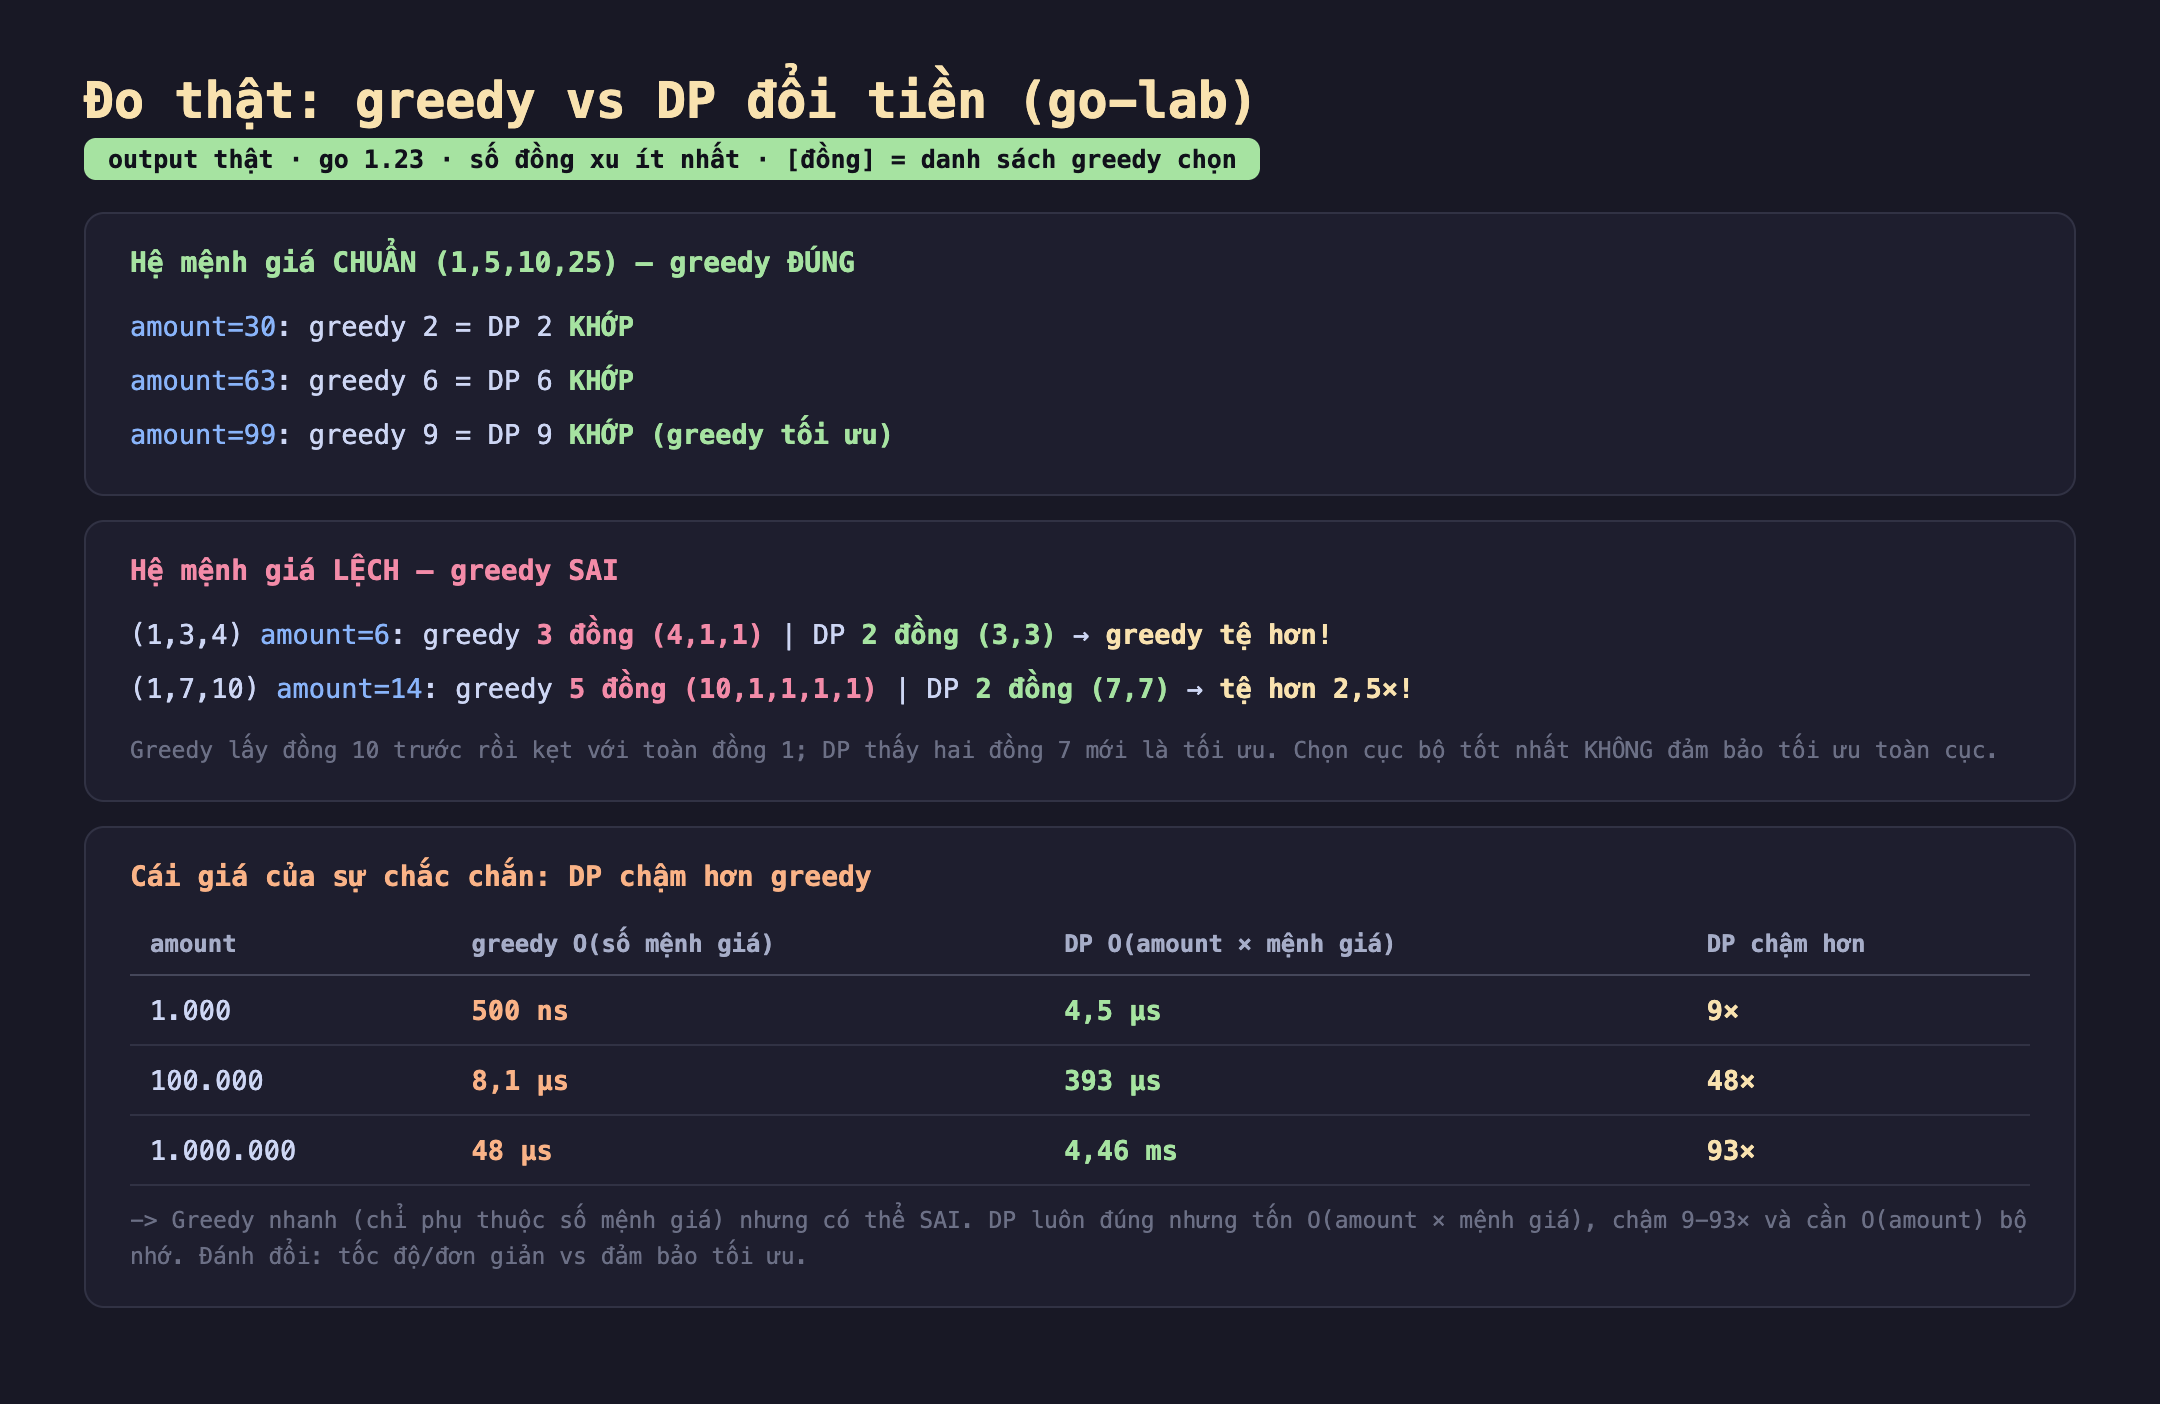
Hình 2: Kết quả thật. Hệ 1,5,10,25: greedy = DP (tối ưu). Hệ lệch 1,7,10 đổi 14: greedy dùng 5 đồng, DP chỉ 2. Greedy nhanh hơn DP 9-93 lần nhưng có thể sai.
- Hệ mệnh giá chuẩn (1, 5, 10, 25) — greedy đúng: với 30, 63, 99 đồng, greedy và DP cho cùng số đồng tối thiểu. Đây là hệ tiền của nhiều nước (như USD), và greedy hoạt động hoàn hảo — đó là lý do thu ngân trả tiền thừa theo kiểu greedy mà vẫn tối ưu.
- Hệ mệnh giá lệch (1, 3, 4) — greedy sai: để đổi 6, greedy lấy đồng 4 rồi kẹt với hai đồng 1 → 3 đồng (4+1+1). DP thấy ngay 3+3 → chỉ 2 đồng. Greedy thua.
- Hệ mệnh giá lệch (1, 7, 10) — greedy sai rõ: để đổi 14, greedy lấy đồng 10 rồi phải bù bốn đồng 1 → 5 đồng (10+1+1+1+1). DP thấy 7+7 → chỉ 2 đồng. Greedy dùng gấp 2,5 lần số đồng cần thiết. Lựa chọn "tốt nhất" ở bước đầu (lấy đồng 10) chính là thứ dẫn tới kết quả tệ.
Bài học cốt lõi: chọn tối ưu cục bộ ở mỗi bước không đảm bảo tối ưu toàn cục. Đồng 10 trông "tham lam" hợp lý, nhưng nó phá vỡ khả năng dùng cặp 7+7 đẹp đẽ.
Cái giá của sự chắc chắn
Nếu DP luôn đúng, sao không luôn dùng DP? Vì nó đắt hơn. Mình đo thời gian cả hai khi amount lớn dần:
- amount=1.000: greedy 500 ns, DP 4,5 µs → DP chậm hơn 9×.
- amount=100.000: greedy 8,1 µs, DP 393 µs → DP chậm hơn 48×.
- amount=1.000.000: greedy 48 µs, DP 4,46 ms → DP chậm hơn 93×.
Greedy chỉ phụ thuộc số mệnh giá (một vài phép lặp), còn DP phải điền bảng kích thước amount — nên khi số tiền lớn, DP chậm hơn hàng chục đến gần trăm lần, và còn tốn O(amount) bộ nhớ. Đây là đánh đổi kinh điển: tốc độ và sự đơn giản của greedy đổi lấy sự đảm bảo tối ưu của DP.
Đánh đổi cần cân nhắc
Greedy đúng chỉ khi bài toán có "tính chất tham lam" — phải chứng minh, không được đoán. Một số bài toán đảm bảo greedy tối ưu: hệ mệnh giá canonical, cây khung nhỏ nhất (Kruskal/Prim), mã Huffman, lập lịch theo thời gian kết thúc. Những bài này có tính chất toán học (matroid, exchange argument) bảo chứng greedy đúng. Nhưng với bài toán bất kỳ, dùng greedy mà không chứng minh là đánh cược — như hệ 1,7,10 cho thấy, nó có thể sai im lặng, cho ra kết quả "trông hợp lý" nhưng không tối ưu.
Khi greedy đúng, nó gần như luôn là lựa chọn tốt hơn DP. Nếu bạn đã chứng minh greedy tối ưu cho bài toán của mình, thì dùng nó: nhanh hơn, ít bộ nhớ hơn, code ngắn hơn. DP chỉ cần thiết khi greedy không đảm bảo đúng. Đừng dùng DP "cho chắc" khi greedy đã được chứng minh đúng — đó là trả giá cho sự đảm bảo mình đã có sẵn.
Có mức trung gian khi cả hai đều không ổn. Khi không gian trạng thái quá lớn cho DP (amount khổng lồ, hoặc nhiều chiều) mà greedy lại sai, còn các lựa chọn khác: quay lui có cắt tỉa (branch and bound), xấp xỉ (approximation — chấp nhận lời giải gần tối ưu với đảm bảo tỉ lệ), hoặc heuristic. Nhiều bài toán thực tế (ba lô, lập lịch phức tạp) là NP-khó, nên "tối ưu chính xác" bằng DP chỉ khả thi ở quy mô nhỏ; ở quy mô lớn, một greedy/heuristic đủ tốt lại là lựa chọn thực dụng.
Ba ý mang về
- Tối ưu cục bộ không bằng tối ưu toàn cục. Đo thật: hệ mệnh giá 1,7,10 đổi 14 đồng, greedy lấy đồng 10 rồi dùng tổng 5 đồng, trong khi DP thấy 7+7 chỉ cần 2 đồng — greedy tệ hơn 2,5 lần. Lựa chọn "tốt nhất ngay bây giờ" có thể phá hỏng lời giải tốt nhất.
- Greedy đúng cho một số bài, không phải mọi bài — phải chứng minh. Đo thật: với hệ chuẩn 1,5,10,25 greedy luôn tối ưu (khớp DP), nhưng hệ lệch thì sai. Greedy chỉ đảm bảo đúng với bài có tính chất tham lam (matroid, exchange argument); dùng mà không chứng minh là đánh cược.
- Đánh đổi: tốc độ vs đảm bảo. Đo thật: greedy nhanh hơn DP 9-93 lần (chỉ O(số mệnh giá) vs O(amount × mệnh giá)). Khi greedy được chứng minh đúng thì dùng nó; khi không, dùng DP (luôn đúng, đắt hơn) hoặc heuristic nếu bài toán quá lớn.
Nguồn
- Wikipedia — Greedy algorithm, Change-making problem: https://en.wikipedia.org/wiki/Change-making_problem
- Wikipedia — Matroid (vì sao greedy tối ưu với một số bài): https://en.wikipedia.org/wiki/Matroid
- MIT 6.046 — Greedy Algorithms: https://ocw.mit.edu/courses/6-046j-design-and-analysis-of-algorithms-spring-2015/
Phần sau ta bước vào đồ thị: hai cách duyệt nền tảng BFS và DFS khác nhau thế nào, và đo thật chi phí của hai cách biểu diễn đồ thị — danh sách kề (adjacency list) so với ma trận kề (adjacency matrix).
