Quy hoạch động (dynamic programming — DP) nghe đáng sợ vì cái tên, nhưng ý tưởng cốt lõi lại giản dị đến mức gần như hiển nhiên: đừng tính lại thứ bạn đã tính rồi. Nghe đơn giản, nhưng khoảng cách hiệu năng mà nó tạo ra thì không hề đơn giản — nó là khác biệt giữa một hàm chạy gần ba giây và cùng hàm đó chạy dưới một micro giây.
Bài này (phần 7 loạt Giải thuật) dùng ví dụ kinh điển — Fibonacci — để đo thật ba cách tiếp cận: đệ quy ngây thơ, memoization (top-down) và tabulation (bottom-up). Con số sẽ cho thấy tại sao DP là một trong những kỹ thuật tối ưu mạnh nhất, và đánh đổi giữa hai biến thể của nó.
Vấn đề: bài toán con chồng lặp
Fibonacci định nghĩa đệ quy: fib(n) = fib(n-1) + fib(n-2). Viết thẳng ra code trông rất gọn:
func fibNaive(n int) int {
	if n < 2 {
		return n
	}
	return fibNaive(n-1) + fibNaive(n-2) // cung 1 gia tri tinh lai nhieu lan
}
Vấn đề ẩn trong dòng cuối: để tính fib(5), ta gọi fib(4) và fib(3); nhưng fib(4) lại gọi fib(3) lần nữa; fib(3) lại gọi fib(2) nhiều lần... Cùng một bài toán con bị tính đi tính lại theo cấp số nhân. Đây gọi là bài toán con chồng lặp (overlapping subproblems) — dấu hiệu nhận ra một bài toán DP.
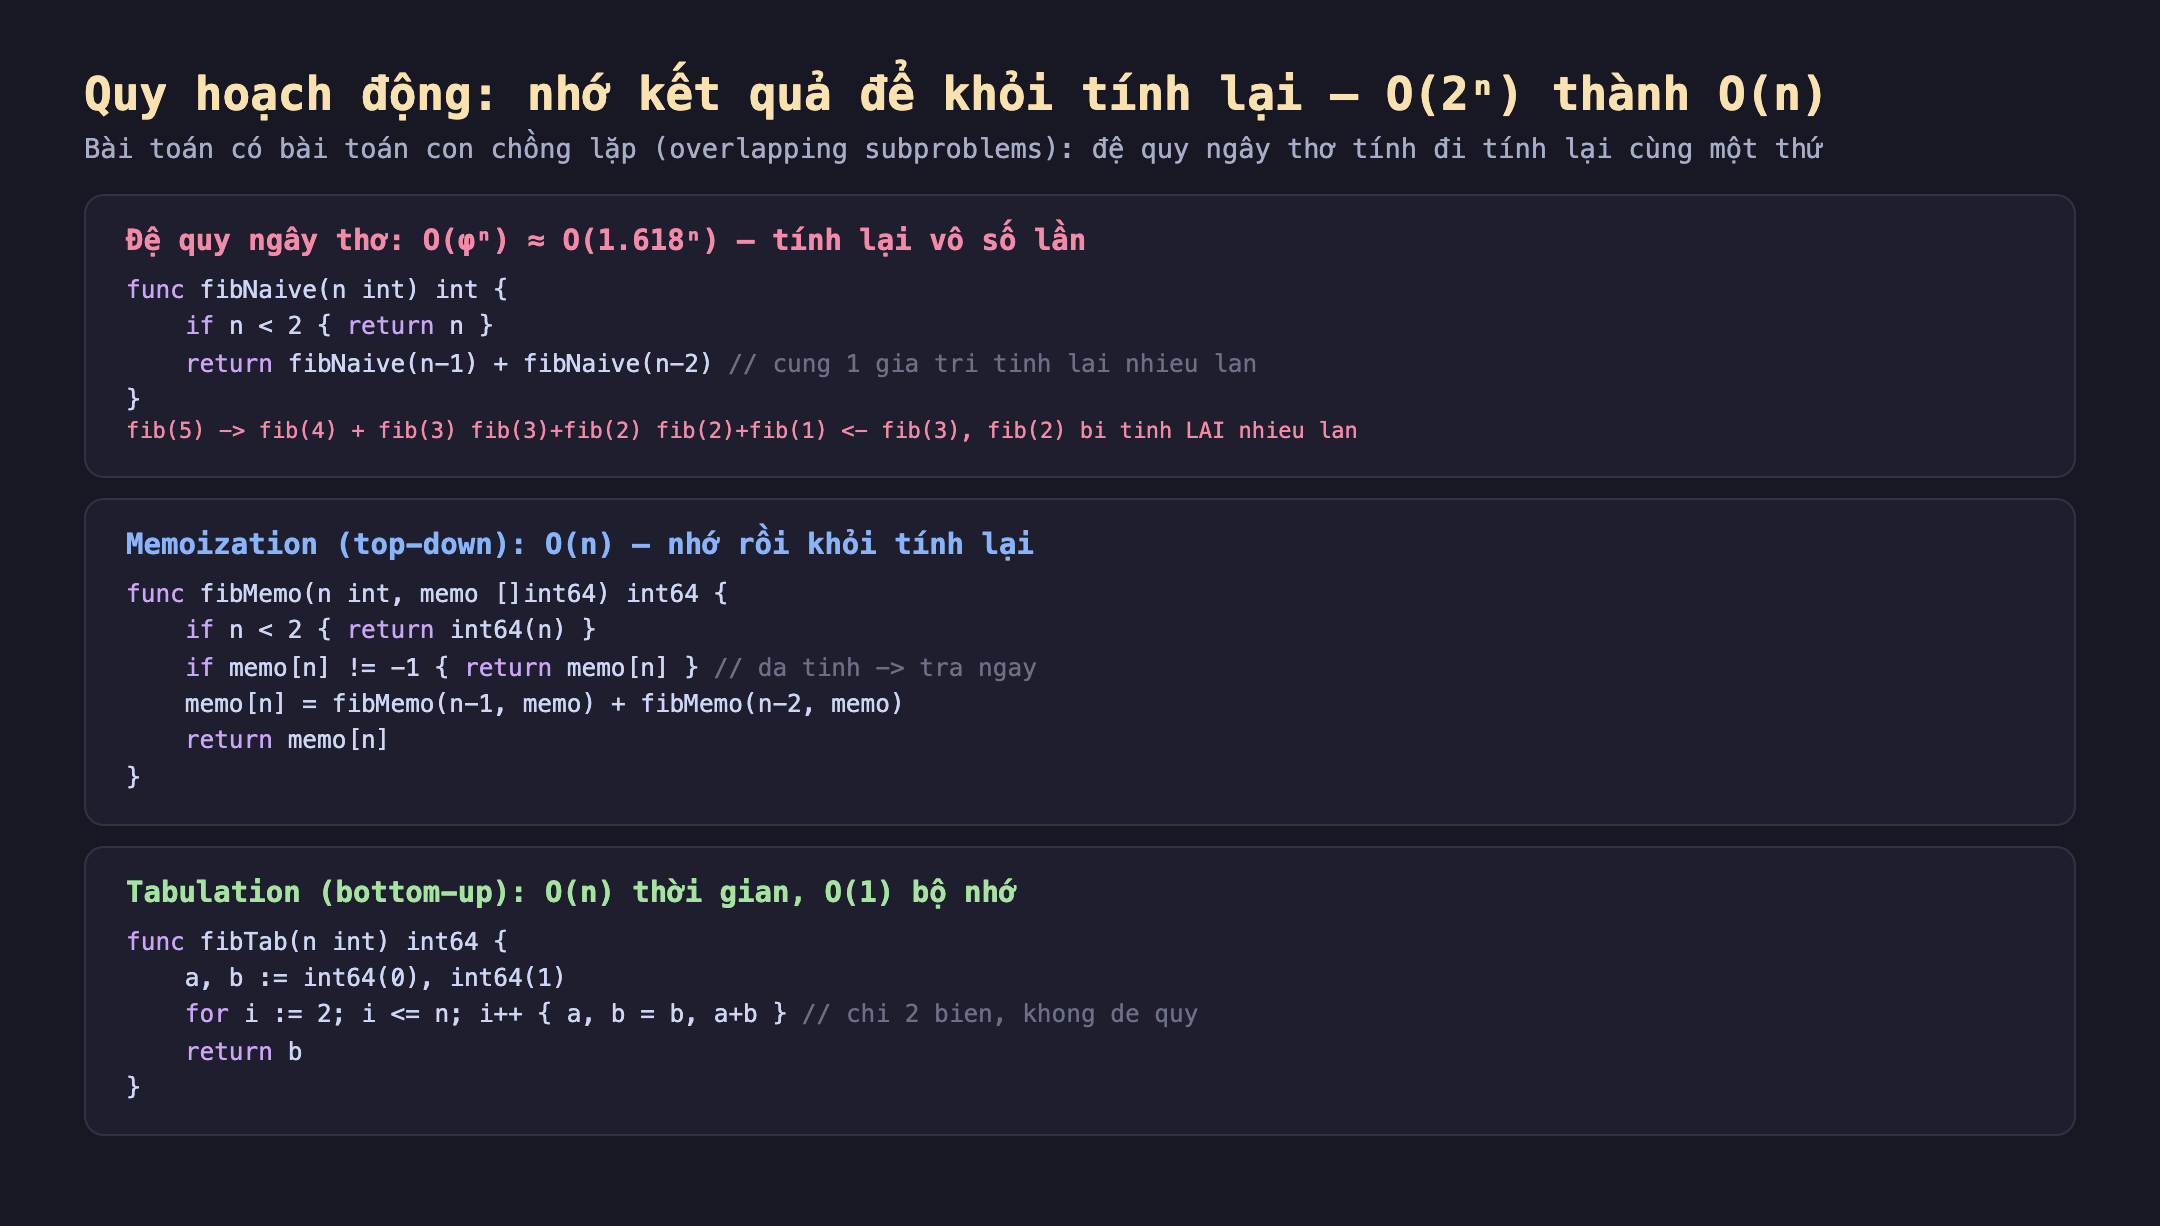
Hình 1: Ba cách tính Fibonacci. Đệ quy ngây thơ tính lại cùng bài toán con theo cấp số nhân (O(φⁿ)). Memoization lưu kết quả đã tính vào mảng (O(n)). Tabulation lặp từ dưới lên chỉ giữ 2 biến (O(n) thời gian, O(1) bộ nhớ).
Đo thật: ba cách, ba thế giới khác nhau
Mình tính Fibonacci ở các n từ 20 đến 45 bằng cả ba cách, đếm luôn số lần gọi hàm của bản ngây thơ. Kết quả thật từ go-lab:
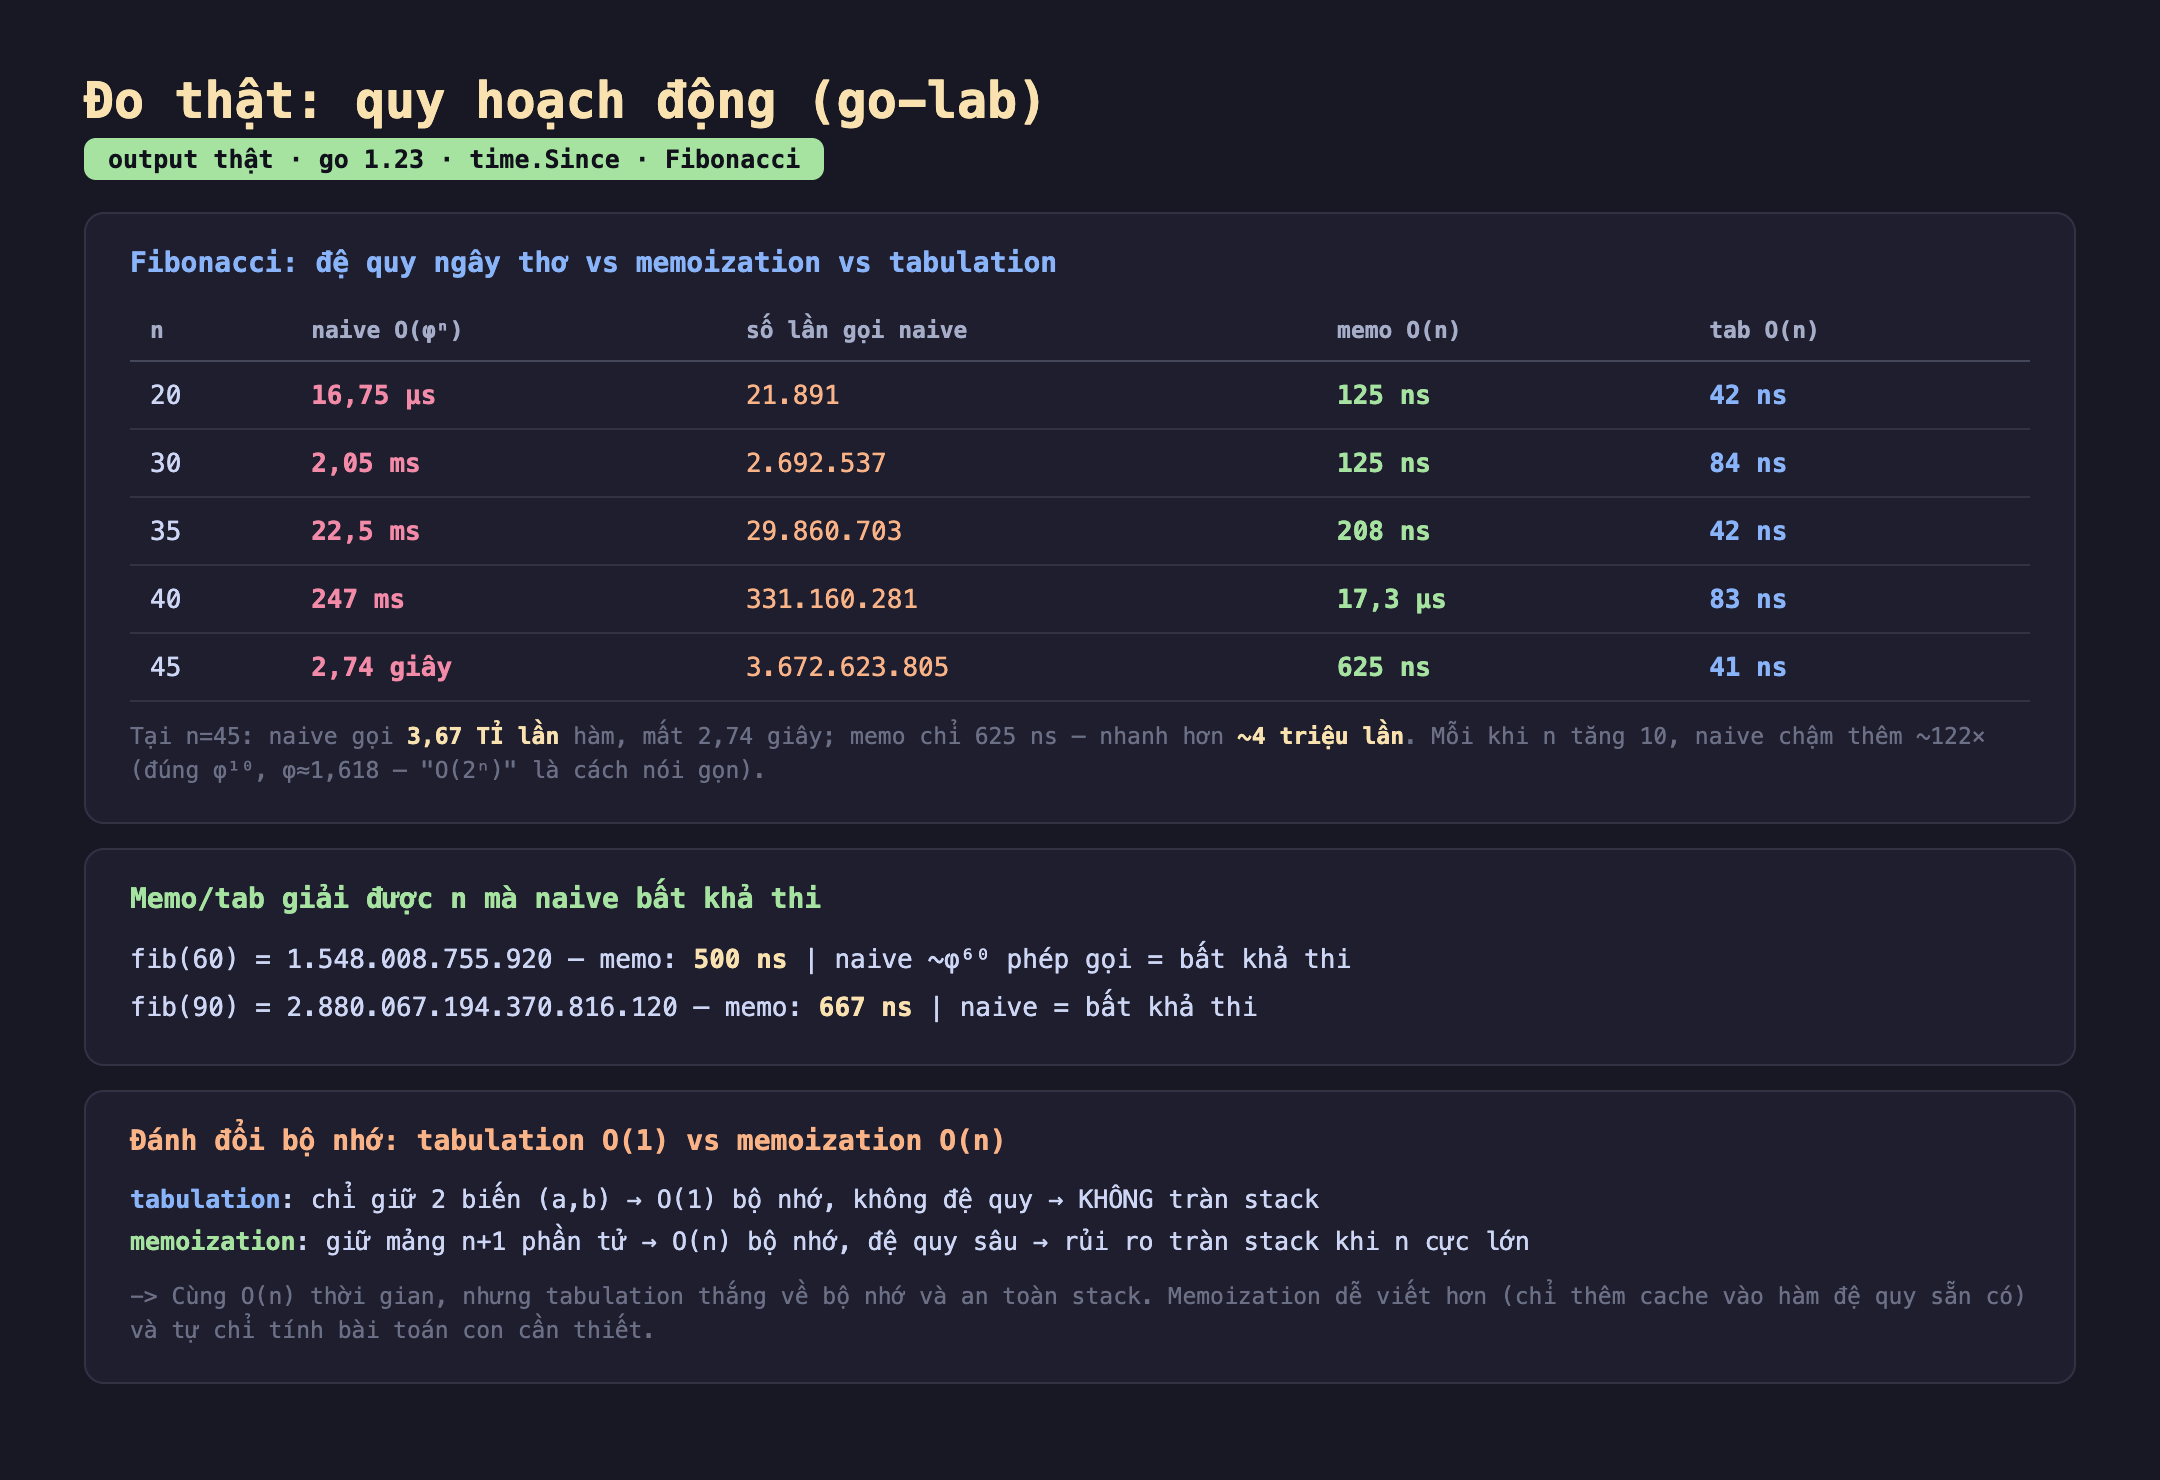
Hình 2: Kết quả thật. naive bùng nổ tới 2,74 giây ở n=45 (3,67 tỉ lần gọi hàm); memo và tab giữ dưới micro giây. memo giải fib(90) trong 667 ns — naive bất khả thi.
- Đệ quy ngây thơ bùng nổ theo cấp số nhân: từ 16,75 µs (n=20) lên 2,74 giây (n=45). Mỗi khi n tăng 10, thời gian nhân khoảng 122 lần. Đáng chú ý: đây chính xác là
φ¹⁰vớiφ ≈ 1,618(tỉ lệ vàng) — độ phức tạp của Fibonacci đệ quy thật ra là O(φⁿ) ≈ O(1,618ⁿ), chứ "O(2ⁿ)" chỉ là cách nói gọn cho "hàm mũ". Số lần gọi hàm là bằng chứng rõ nhất: để tính fib(45), bản ngây thơ gọi hàm 3.672.623.805 lần — hơn 3,67 tỉ lần. - Memoization và tabulation phẳng: cả hai giữ dưới micro giây ở mọi n (memo 125 ns - 17 µs, tab 41-84 ns). Tại n=45, memo nhanh hơn naive khoảng 4 triệu lần.
- DP giải được bài naive không thể chạm tới: memo tính fib(60) và fib(90) trong dưới 700 ns. Với naive, fib(90) cần ~φ⁹⁰ phép gọi — nhiều hơn số giây kể từ Big Bang; bất khả thi về mặt vật lý.
Memoization vs tabulation: hai hướng của cùng ý tưởng
Cả hai đều xóa bỏ việc tính lại, nhưng theo hai hướng ngược nhau:
Memoization (top-down) giữ nguyên hàm đệ quy, chỉ thêm một bộ nhớ đệm (cache): trước khi tính, kiểm tra xem đã tính chưa; nếu rồi thì trả về ngay.
func fibMemo(n int, memo []int64) int64 {
	if n < 2 {
		return int64(n)
	}
	if memo[n] != -1 { // da tinh -> tra ngay
		return memo[n]
	}
	memo[n] = fibMemo(n-1, memo) + fibMemo(n-2, memo)
	return memo[n]
}
Tabulation (bottom-up) lật ngược chiều: tính từ bài toán con nhỏ nhất đi lên, điền vào một bảng. Với Fibonacci, ta thậm chí chỉ cần giữ hai biến gần nhất:
func fibTab(n int) int64 {
	a, b := int64(0), int64(1)
	for i := 2; i <= n; i++ {
		a, b = b, a+b // chi 2 bien, khong de quy
	}
	return b
}
Đánh đổi cần cân nhắc
Cùng O(n) thời gian, nhưng tabulation thắng về bộ nhớ. Memoization giữ cả mảng n+1 phần tử → O(n) bộ nhớ. Tabulation Fibonacci chỉ giữ hai biến → O(1) bộ nhớ. Trong demo, tab (41 ns) cũng nhỉnh hơn memo vì không có chi phí gọi hàm đệ quy và truy cập mảng. Khi chỉ cần kết quả cuối (không cần bảng trung gian), tabulation với "cửa sổ trượt" vài biến là tối ưu nhất.
Memoization có rủi ro tràn stack, tabulation thì không. Vì memoization vẫn đệ quy, nó xây ngăn xếp gọi sâu n tầng — với n rất lớn (hàng trăm nghìn), chương trình có thể tràn stack và sập. Tabulation là vòng lặp thuần, không đệ quy, nên an toàn ở mọi n. Đây là lý do với các bài DP sâu, tabulation thường là lựa chọn production an toàn hơn.
Nhưng memoization dễ viết và linh hoạt hơn. Memoization chỉ cần thêm một dòng cache vào hàm đệ quy đã có sẵn — gần như không phải nghĩ lại cấu trúc. Nó cũng chỉ tính những bài toán con thực sự cần (lazy): nếu lời giải không chạm tới một số trạng thái, chúng không bao giờ được tính. Tabulation thì phải điền toàn bộ bảng theo thứ tự, kể cả ô không cần. Với không gian trạng thái thưa (nhiều ô không dùng), memoization có thể làm ít việc hơn. Chọn tabulation khi cần tối ưu bộ nhớ/tránh tràn stack; chọn memoization khi muốn viết nhanh từ đệ quy có sẵn hoặc không gian trạng thái thưa.
Ba ý mang về
- DP xóa bỏ việc tính lại, biến hàm mũ thành tuyến tính. Đo thật: fib(45) đệ quy ngây thơ gọi hàm 3,67 tỉ lần, mất 2,74 giây; thêm một mảng nhớ (memoization) đưa về O(n), chỉ 625 ns — nhanh hơn ~4 triệu lần. Dấu hiệu nhận ra bài DP là "bài toán con chồng lặp".
- Độ phức tạp đúng của Fibonacci đệ quy là O(φⁿ) ≈ O(1,618ⁿ). Đo thật: mỗi khi n tăng 10, thời gian nhân ~122× = φ¹⁰. "O(2ⁿ)" là cách nói gọn cho hàm mũ; con số thật khít với tỉ lệ vàng.
- Memoization và tabulation cùng O(n) nhưng khác đánh đổi. Tabulation: O(1) bộ nhớ (chỉ 2 biến), không đệ quy nên không tràn stack — an toàn cho n lớn. Memoization: dễ viết từ đệ quy có sẵn, chỉ tính bài toán con cần thiết — hợp khi không gian trạng thái thưa.
Nguồn
- Wikipedia — Dynamic programming, Memoization: https://en.wikipedia.org/wiki/Dynamic_programming
- Wikipedia — Fibonacci number (độ phức tạp đệ quy): https://en.wikipedia.org/wiki/Fibonacci_sequence#Matrix_form
- MIT 6.006 — Dynamic Programming: https://ocw.mit.edu/courses/6-006-introduction-to-algorithms-spring-2020/
Phần sau ta so sánh tham lam (greedy) và quy hoạch động: khi nào chọn cục bộ tốt nhất ở mỗi bước lại cho lời giải toàn cục đúng, khi nào nó sai, và đo thật một bài toán mà greedy cho kết quả tệ hơn DP.
