Một yêu cầu rất thường gặp: "cho tôi 10 sản phẩm bán chạy nhất", "20 request chậm nhất", "100 điểm gần nhất". Đây là bài toán top-k: tìm k phần tử lớn nhất (hoặc nhỏ nhất) trong N phần tử. Phản xạ đầu tiên của hầu hết lập trình viên là: sắp xếp cả mảng rồi lấy k phần tử đầu. Nó chạy đúng, nó ngắn gọn — và với N lớn, nó lãng phí đến mức khó tin.
Có một cấu trúc dữ liệu sinh ra cho bài toán này: heap (và anh em của nó, hàng đợi ưu tiên — priority queue). Bài này (phần 6 loạt Giải thuật) đo thật khoảng cách giữa hai cách tiếp cận, và kết quả — nhanh hơn 247 lần — lớn hơn cả những gì Big-O đơn thuần dự báo.
Heap là gì và vì sao nó hợp với top-k
Heap là một cây nhị phân thỏa một bất biến đơn giản: cha luôn nhỏ hơn (hoặc bằng) con (min-heap). Hệ quả: phần tử nhỏ nhất luôn nằm ở đỉnh, lấy ra trong O(1), và sau khi lấy, cây tự sắp lại trong O(log n).
Mẹo cho top-k nằm ở một ý tưởng ngược đời: để tìm k phần tử lớn nhất, ta dùng một min-heap giữ đúng k phần tử. Đỉnh heap là phần tử nhỏ nhất trong nhóm k đang giữ — chính là "ngưỡng cửa". Mỗi phần tử mới chỉ cần so với ngưỡng đó: nếu lớn hơn thì thay vào, nếu không thì bỏ qua.
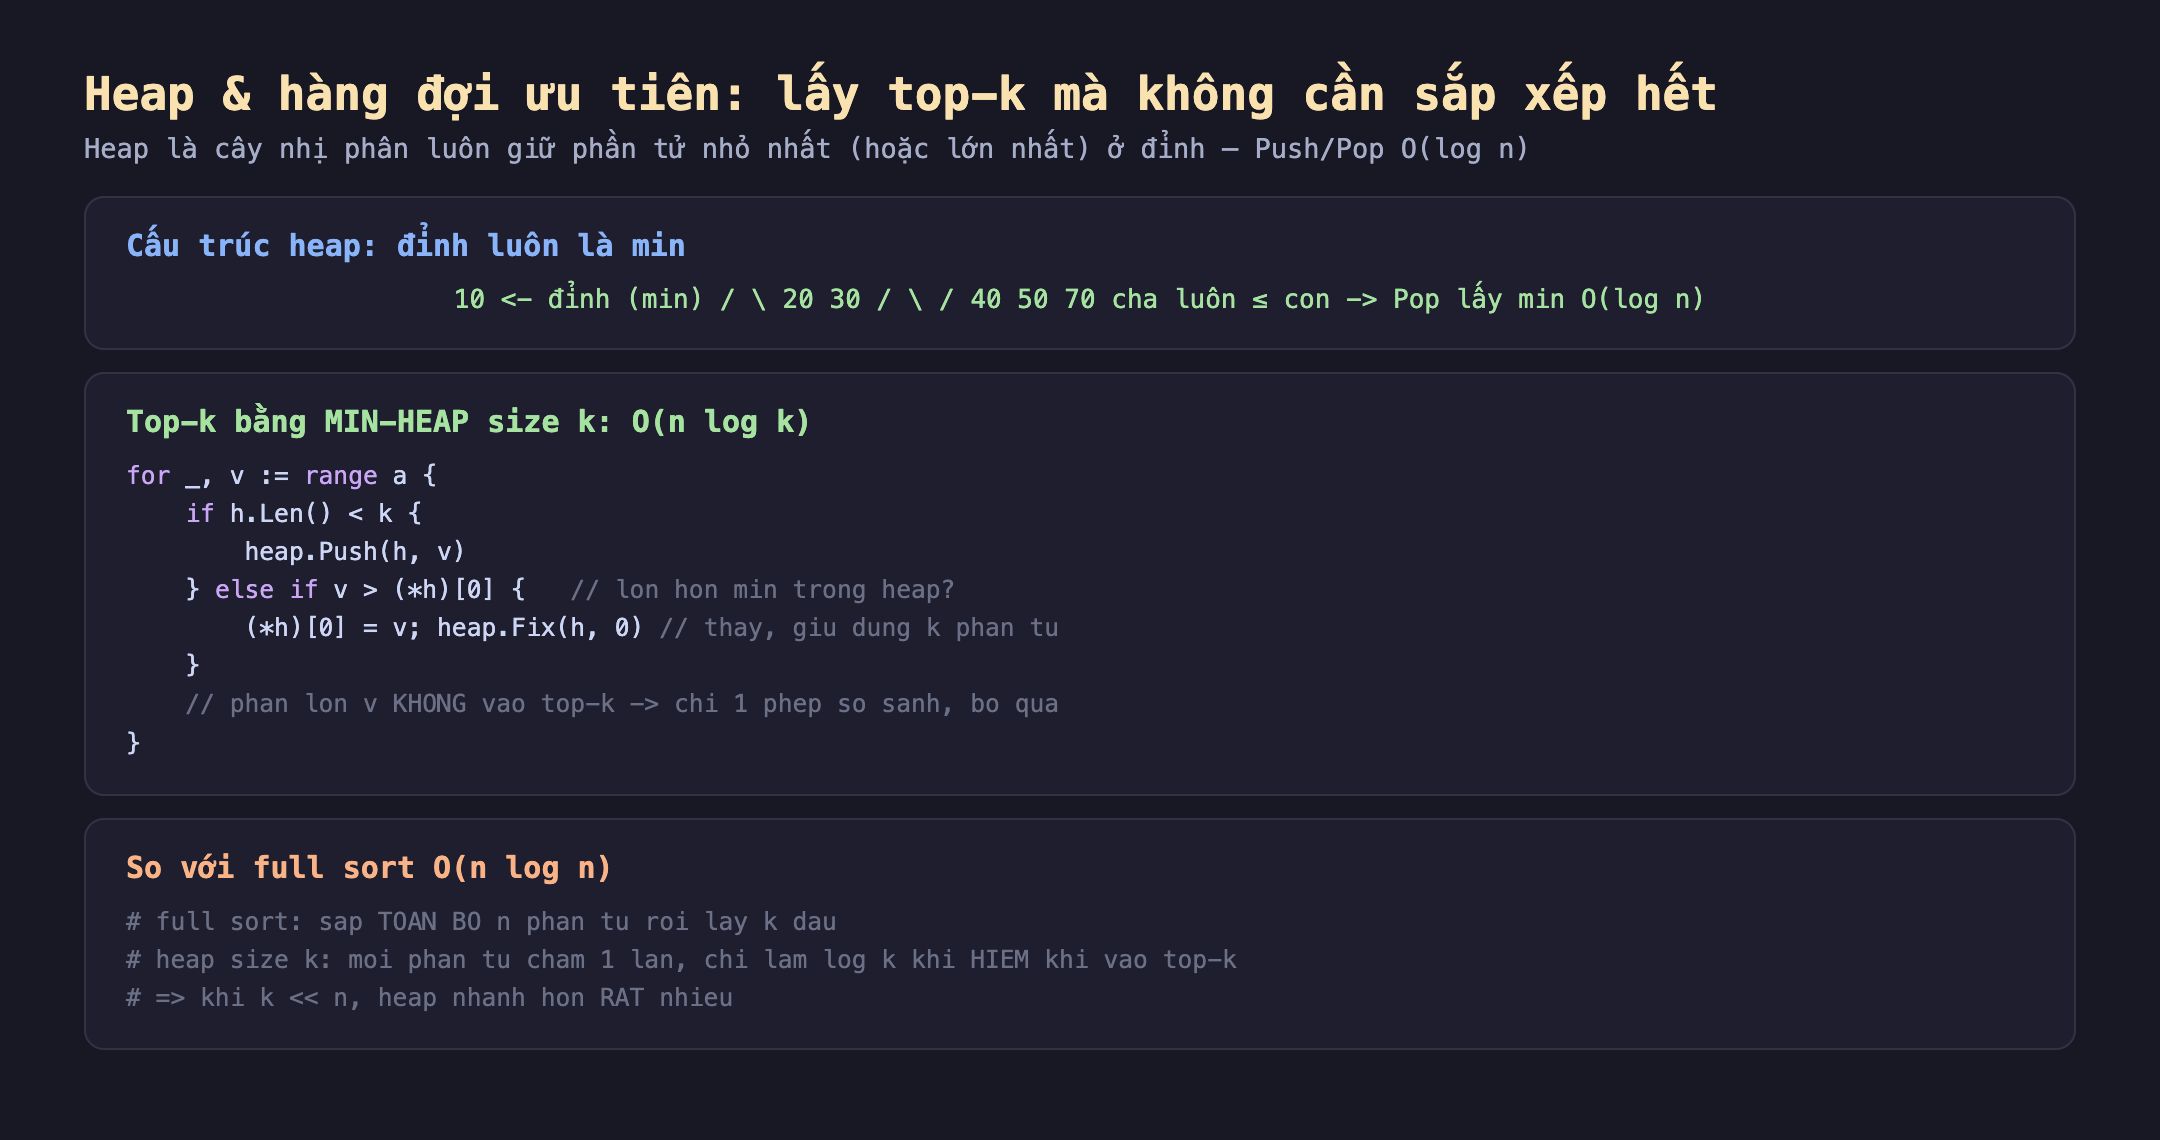
Hình 1: Min-heap giữ đỉnh là phần tử nhỏ nhất (Pop O(log n)). Top-k dùng min-heap size k: mỗi phần tử so với đỉnh (ngưỡng), chỉ thay khi lớn hơn. Full sort phải sắp toàn bộ; heap chỉ làm việc nặng khi phần tử thực sự vào top-k.
// top-k lon nhat bang min-heap size k: O(n log k)
func topKHeap(a []int, k int) []int {
	h := &MinHeap{}
	heap.Init(h)
	for _, v := range a {
		if h.Len() < k {
			heap.Push(h, v)
		} else if v > (*h)[0] { // lon hon min trong heap -> thay
			(*h)[0] = v
			heap.Fix(h, 0)
		}
		// phan lon v khong vao top-k -> chi 1 phep so sanh roi bo qua
	}
	res := make([]int, h.Len())
	for i := len(res) - 1; i >= 0; i-- {
		res[i] = heap.Pop(h).(int)
	}
	return res
}
Đo thật: heap đối đầu full sort
Mình tìm top-10 (k=10) từ các mảng N = 100.000 đến 8 triệu phần tử, bằng hai cách: full sort rồi lấy 10 đầu, và min-heap size 10. Kết quả thật từ go-lab:
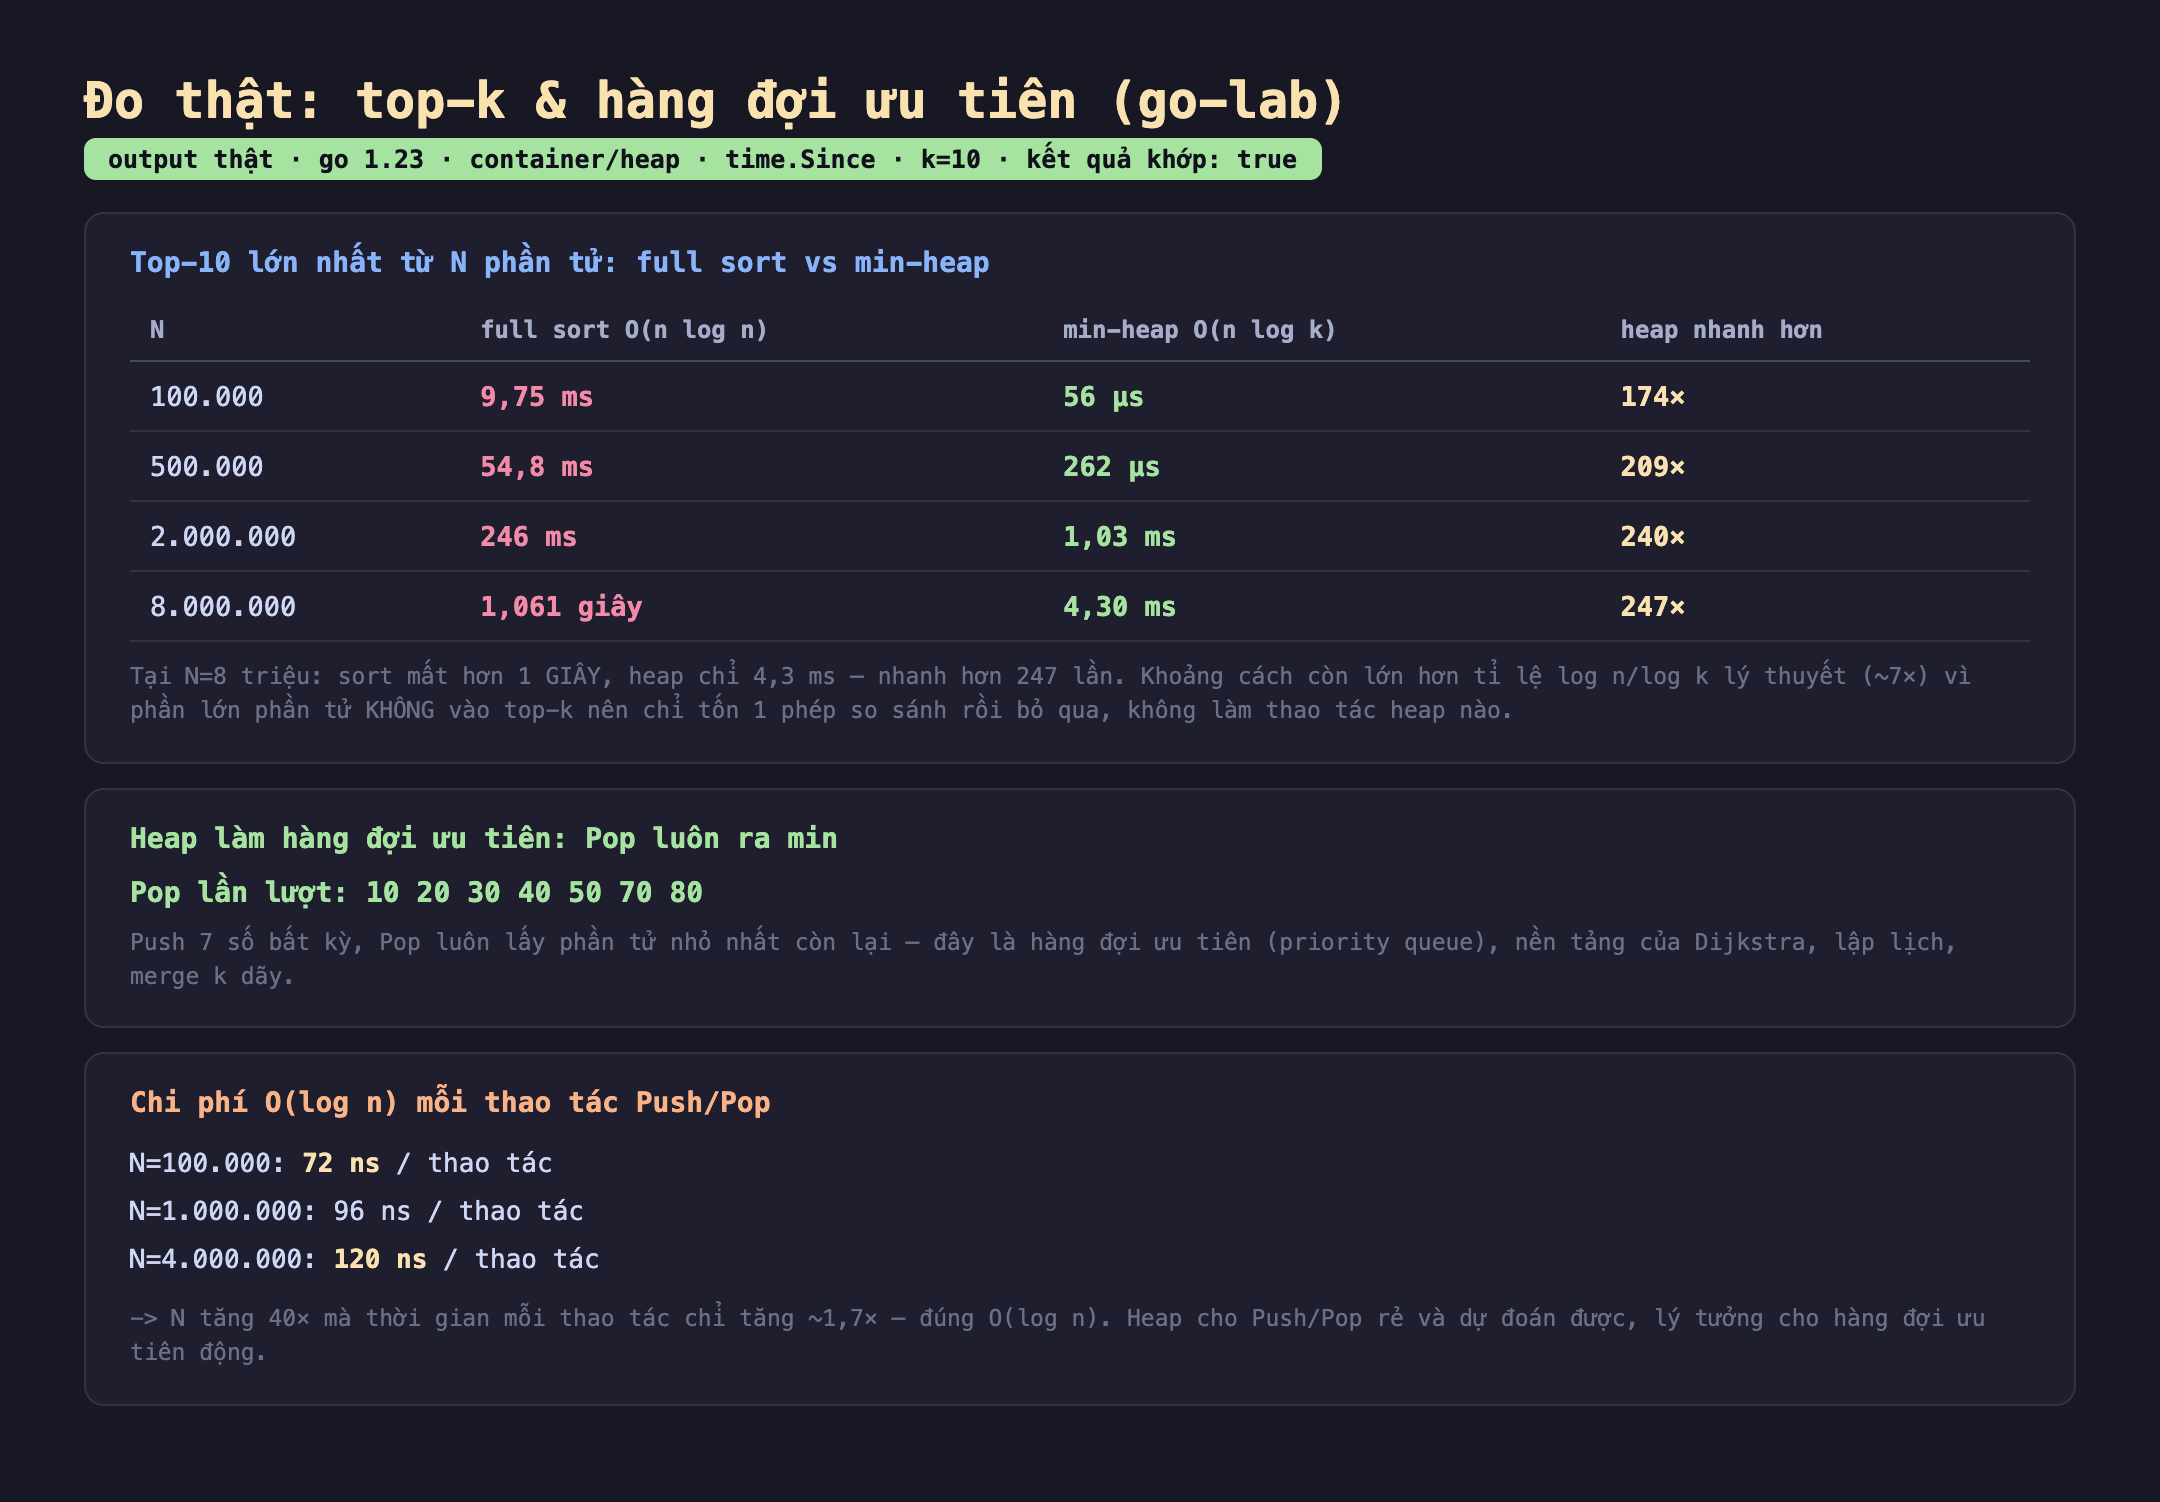
Hình 2: Kết quả thật. Heap top-k nhanh hơn full sort 174× đến 247×; tại N=8 triệu sort mất hơn 1 giây còn heap chỉ 4,3 ms. Hàng đợi ưu tiên Pop ra min đúng thứ tự. Push/Pop ~72-120 ns, đúng O(log n).
- Khoảng cách khổng lồ và tăng dần: heap nhanh hơn 174× ở N=100.000, lên 247× ở N=8 triệu. Tại N=8 triệu, full sort ngốn hơn 1 giây, còn heap xong trong 4,3 ms.
- Kết quả khớp: cả hai cách cho cùng top-10 (cột "kết quả khớp: true") — heap không đánh đổi độ chính xác lấy tốc độ, nó đơn giản là làm ít việc hơn.
Vì sao nhanh hơn cả tỉ lệ Big-O dự báo? Lý thuyết nói full sort là O(n log n) còn heap là O(n log k); với k=10, tỉ lệ log n / log k ở N=8 triệu chỉ khoảng 7×. Nhưng ta đo được 247×. Khác biệt đến từ chi tiết thực thi: sau khi heap đã đầy 10 phần tử đủ lớn, đại đa số phần tử còn lại thất bại ngay ở phép so sánh v > đỉnh và bị bỏ qua — không tốn một thao tác heap nào. Nên trên thực tế, heap chỉ duyệt mỗi phần tử một lần với một phép so sánh rẻ, và chỉ trả chi phí log k cho số ít phần tử thực sự lọt vào top-k. Cộng thêm full sort còn tốn cấp phát (copy mảng) và đảo chiều. Big-O cho giới hạn trên; thực tế thường còn tốt hơn.
Heap còn là hàng đợi ưu tiên
Top-k chỉ là một ứng dụng. Bản chất heap là hàng đợi ưu tiên (priority queue): một hàng đợi mà Pop luôn trả phần tử ưu tiên nhất (nhỏ nhất hoặc lớn nhất), bất kể thứ tự đưa vào. Demo thật: push bảy số bất kỳ, Pop lần lượt cho ra dãy đã sắp 10 20 30 40 50 70 80.
Và mỗi thao tác Push/Pop đo được ~72-120 ns, tăng từ 72 (N=100k) lên 120 ns (N=4 triệu) — N tăng 40 lần mà thời gian mỗi thao tác chỉ tăng ~1,7 lần, đúng dấu vân tay O(log n). Sự rẻ và ổn định này khiến heap là xương sống của nhiều thuật toán kinh điển:
- Dijkstra (đường đi ngắn nhất — bài sau): luôn lấy đỉnh có khoảng cách nhỏ nhất kế tiếp.
- Lập lịch (scheduler): luôn chạy task ưu tiên cao nhất.
- Merge k dãy đã sắp: giữ heap k con trỏ, luôn lấy phần tử nhỏ nhất.
- Luồng sự kiện theo thời gian (event loop, simulation): luôn xử lý sự kiện sắp tới nhất.
Đánh đổi cần cân nhắc
Heap top-k thắng khi k nhỏ so với N — không phải luôn luôn. Lợi thế đến từ việc giữ heap nhỏ (size k). Nếu k xấp xỉ N (lấy "top 90%"), heap mất ưu thế vì gần như mọi phần tử đều vào heap và bạn trả log k ≈ log n cho từng cái — lúc đó full sort (hoặc partial sort) có thể tốt bằng hoặc hơn. Quy tắc: dùng heap khi k << n; khi k lớn, cân nhắc sort.
Heap không cho bạn thứ tự của phần ngoài top-k. Full sort trả về toàn bộ mảng đã sắp — nếu bạn cần cả danh sách có thứ tự chứ không chỉ k phần tử đầu, thì phải sort, và chi phí O(n log n) là không tránh khỏi. Heap chỉ thắng khi bạn thật sự chỉ cần k phần tử. Đừng dùng heap top-k rồi phát hiện mình cần sắp cả phần còn lại.
Có lựa chọn thứ ba: quickselect O(n) trung bình. Nếu chỉ cần tập hợp k phần tử lớn nhất (không cần chúng đã sắp với nhau), thuật toán quickselect (phân hoạch kiểu quicksort quanh phần tử thứ k) cho O(n) trung bình — nhanh hơn cả heap O(n log k) về lý thuyết. Đổi lại nó phá hủy thứ tự mảng gốc và có trường hợp xấu O(n²). Khi top-k là điểm nóng hiệu năng và k khá lớn, quickselect đáng cân nhắc; với k nhỏ và cần đơn giản, heap thường là lựa chọn thực dụng nhất.
Ba ý mang về
- Đừng sắp xếp cả mảng chỉ để lấy k phần tử. Đo thật: min-heap size k lấy top-10 từ 8 triệu phần tử trong 4,3 ms, full sort mất hơn 1 giây — nhanh hơn 247 lần, và cho cùng kết quả. Lợi thế còn lớn hơn tỉ lệ Big-O vì phần lớn phần tử bị bỏ qua chỉ sau một phép so sánh.
- Heap cho Push/Pop O(log n) rẻ và ổn định. Đo thật: mỗi thao tác 72-120 ns, N tăng 40× mà chỉ chậm thêm 1,7×. Đây là nền tảng của hàng đợi ưu tiên — Pop luôn ra phần tử ưu tiên nhất.
- Heap là xương sống của nhiều thuật toán. Dijkstra, lập lịch, merge k dãy, event loop đều dựa trên priority queue. Nhưng heap top-k chỉ thắng khi
k << n; khi k lớn hoặc cần cả mảng đã sắp, hãy quay lại sort (hoặc cân nhắc quickselect O(n)).
Nguồn
- Go docs — container/heap: https://pkg.go.dev/container/heap
- Wikipedia — Binary heap, Priority queue: https://en.wikipedia.org/wiki/Binary_heap
- Wikipedia — Selection algorithm (quickselect): https://en.wikipedia.org/wiki/Selection_algorithm
Phần sau ta sang quy hoạch động (dynamic programming): vì sao memoization biến một hàm đệ quy O(2^n) thành O(n), và đo thật khoảng cách giữa đệ quy ngây thơ, memoization và tabulation.
