Cây tìm kiếm nhị phân (Binary Search Tree — BST) là cấu trúc dữ liệu mà ai học giải thuật cũng cài một lần, và cũng là nơi bộc lộ rõ nhất một sự thật khó chịu: cùng một cấu trúc, cùng một thuật toán, nhưng độ phức tạp thực tế phụ thuộc vào thứ tự dữ liệu đi vào. Một BST có thể cho tra cứu O(log n) tuyệt đẹp, hoặc thoái hóa thành O(n) thảm họa — khác biệt chỉ nằm ở cách bạn chèn.
Bài trước đã cho thấy hash table (map) nhanh O(1). Vậy tại sao cây vẫn tồn tại, và tại sao map của Go lại chọn hash table chứ không phải cây? Bài này (phần 5 loạt Giải thuật) đo cả BST cân bằng, BST suy biến và map Go cạnh nhau để trả lời.
Cơ chế: tìm bằng cách đi xuống
BST đặt mỗi node theo quy tắc: mọi key bên trái nhỏ hơn node, mọi key bên phải lớn hơn. Để tìm một key, bạn bắt đầu từ gốc và đi xuống — mỗi bước so sánh rồi rẽ trái hoặc phải, loại bỏ cả một nhánh. Số bước tối đa chính bằng chiều cao của cây.
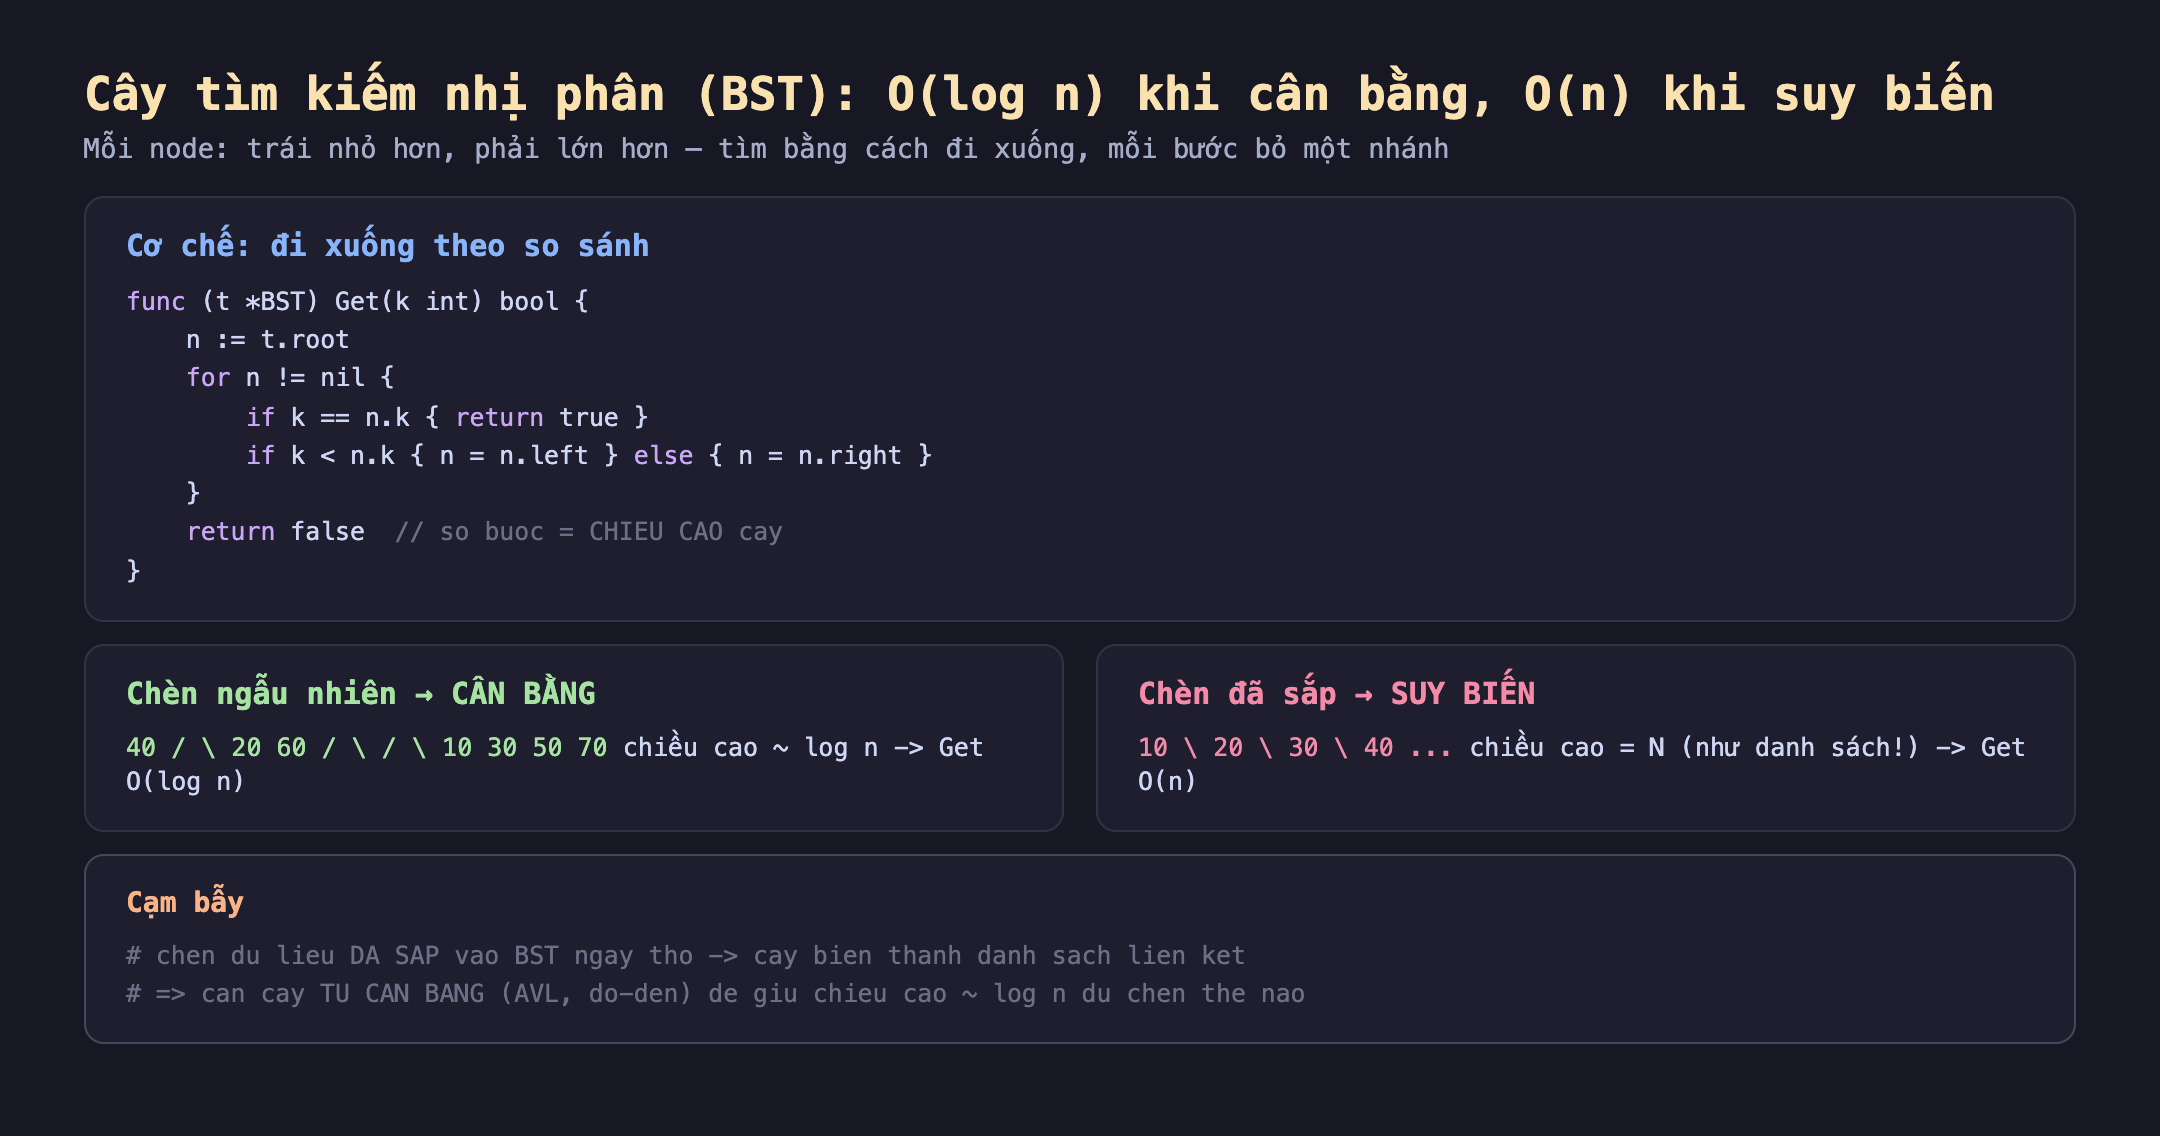
Hình 1: Get đi từ gốc xuống, mỗi bước bỏ một nhánh — số bước = chiều cao cây. Chèn ngẫu nhiên → cây cân bằng (cao ~log n, O(log n)). Chèn đã sắp → cây suy biến thành danh sách liên kết (cao = N, O(n)).
type tnode struct{ k int; left, right *tnode }
type BST struct{ root *tnode }

func (t *BST) Get(k int) bool {
	n := t.root
	for n != nil {
		if k == n.k {
			return true
		}
		if k < n.k { // nho hon -> re trai; lon hon -> re phai
			n = n.left
		} else {
			n = n.right
		}
	}
	return false // so buoc = chieu cao cay
}
Điểm mấu chốt: hiệu năng của BST = chiều cao của nó. Và chiều cao lại phụ thuộc hoàn toàn vào thứ tự chèn.
Đo thật: cân bằng, suy biến, và map Go
Mình xây ba thứ với cùng N phần tử: một BST chèn theo thứ tự ngẫu nhiên (cân bằng tự nhiên), một BST chèn theo thứ tự đã sắp 0,1,2,... (suy biến), và một map Go. Rồi đo chiều cao cây và thời gian tra cứu. Kết quả thật từ go-lab:
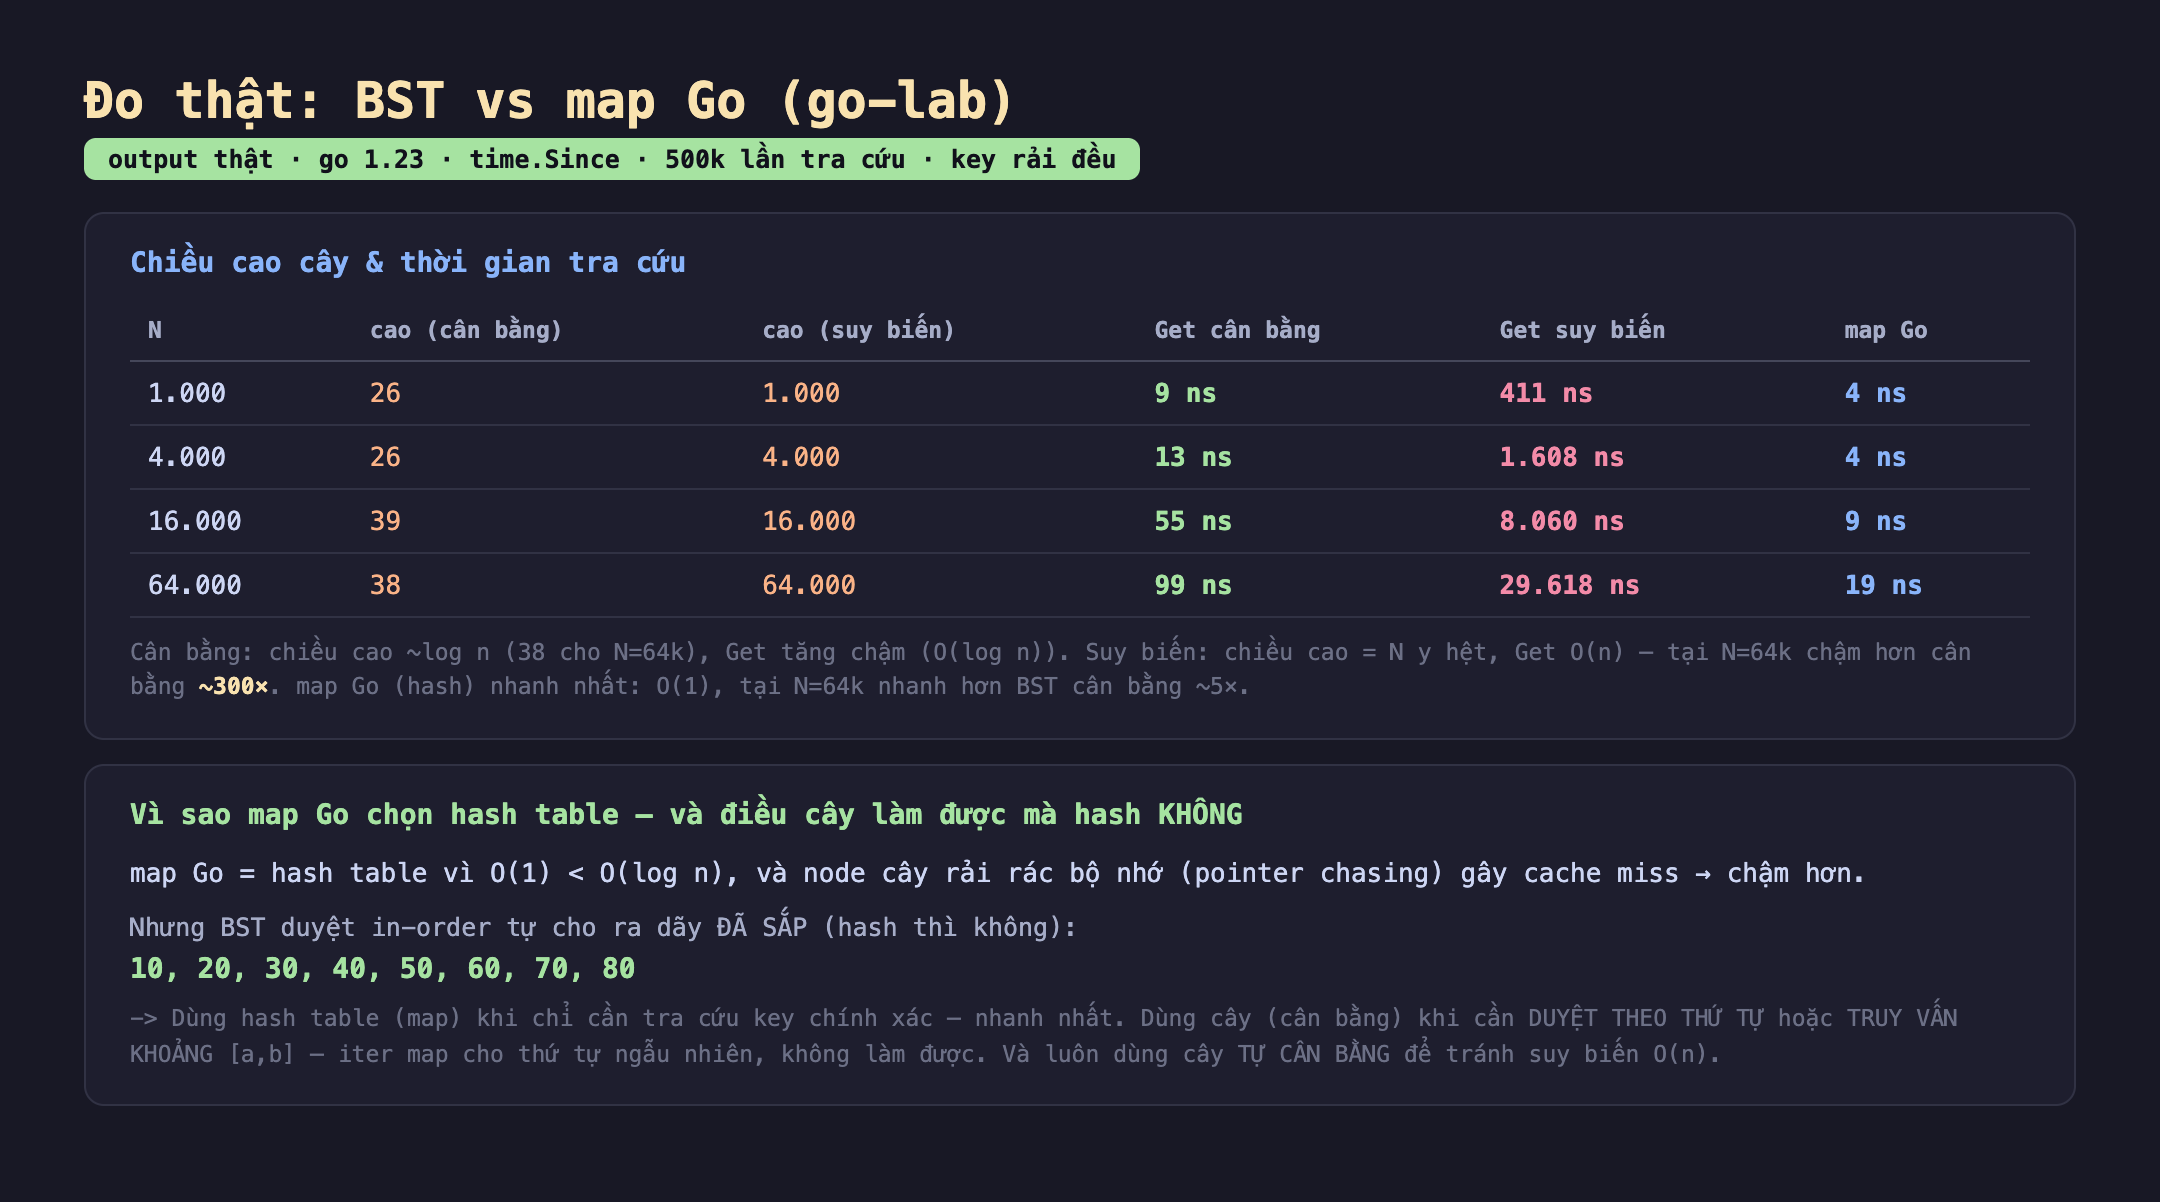
Hình 2: Kết quả thật. Cây cân bằng cao ~log n (38 cho N=64k), Get tăng chậm; cây suy biến cao = N y hệt, Get O(n) chậm ~300× ở N=64k; map Go nhanh nhất (O(1)). In-order traversal cho dãy đã sắp — điều hash không làm được.
- Cây cân bằng = O(log n): chiều cao chỉ 26-38 dù N tăng tới 64.000 (đúng là ~log n), và Get tăng chậm từ 9 → 99 ns. Mỗi lần N tăng, thời gian nhích lên một chút chứ không nhân đôi.
- Cây suy biến = O(n), thảm họa: chèn dữ liệu đã sắp khiến mỗi node chỉ có con phải — cây biến thành danh sách liên kết, chiều cao = N y hệt (1.000, 4.000, 16.000, 64.000). Get phải duyệt tuyến tính: 411 → 29.618 ns. Tại N=64.000, cây suy biến chậm hơn cây cân bằng ~300 lần — cùng code, chỉ khác thứ tự chèn.
- map Go thắng cả cây cân bằng: 4-19 ns, nhanh hơn BST cân bằng ~5× ở N=64.000.
Vì sao map Go dùng hash table, không dùng cây
Hai lý do, và cả hai đều đo được ở trên:
1. O(1) nhanh hơn O(log n). Hash table tra cứu trong thời gian hằng số, cây cân bằng cần log n bước. Ở N=64.000, đó là chênh lệch 19 ns so với 99 ns.
2. Cây gây cache miss. Đây là lý do tinh tế hơn và thường bị bỏ qua. Node của cây là các struct cấp phát riêng lẻ, nằm rải rác khắp bộ nhớ. Mỗi bước đi xuống cây là một lần truy cập con trỏ tới vùng nhớ ngẫu nhiên (pointer chasing) — rất dễ cache miss. Để ý: Get cân bằng tăng từ 9 ns (N=1.000) lên 99 ns (N=64.000), gấp 11 lần dù chiều cao chỉ tăng ~1,5 lần. Phần dôi ra chính là cache miss khi cây lớn ra khỏi cache. Hash table truy cập một mảng liền kề, thân thiện cache hơn nhiều.
Vậy nên khi bạn chỉ cần tra cứu key chính xác (có/không, lấy giá trị theo key), hash table là lựa chọn đúng — và đó là điều map được dùng cho.
Nhưng cây làm được điều hash table không thể
Nếu hash nhanh hơn mọi mặt, tại sao cây vẫn tồn tại? Vì cây giữ thứ tự. Duyệt cây theo in-order (trái → gốc → phải) tự động cho ra dãy đã sắp xếp:
Duyet in-order: 10, 20, 30, 40, 50, 60, 70, 80
Đây là thứ hash table không bao giờ làm được: lặp qua một map Go cho thứ tự ngẫu nhiên (Go cố tình xáo trộn để bạn không phụ thuộc vào thứ tự). Và quan trọng hơn, cây trả lời được các truy vấn mà hash bó tay:
- Truy vấn khoảng: "tất cả key trong [20, 50]" — cây duyệt được, hash phải quét toàn bộ.
- Phần tử kế cận: "key nhỏ nhất lớn hơn 35" — cây tìm trong O(log n), hash không có khái niệm này.
- Min/max, phần tử thứ k — cây hỗ trợ tự nhiên.
Đây là lý do index của database (B-tree, một họ hàng của BST) dùng cây chứ không dùng hash: truy vấn WHERE age BETWEEN 20 AND 50 ORDER BY age cần thứ tự, và cây cho điều đó.
Đánh đổi cần cân nhắc
BST ngây thơ nguy hiểm trong production — luôn dùng cây tự cân bằng. Thí nghiệm trên cho thấy chèn dữ liệu đã sắp (một tình huống cực kỳ phổ biến: timestamp tăng dần, ID tự tăng, dữ liệu đã sort sẵn) làm BST suy biến thành O(n). Giải pháp là cây tự cân bằng — AVL, cây đỏ-đen (red-black), hoặc B-tree — chúng tự xoay node để giữ chiều cao luôn ~log n bất kể thứ tự chèn. Đừng bao giờ dùng BST tự viết ngây thơ cho dữ liệu không kiểm soát được thứ tự.
Cây cân bằng phải trả giá để duy trì cân bằng. Mỗi lần chèn/xóa, cây đỏ-đen phải kiểm tra và xoay lại các node để giữ bất biến cân bằng. Chi phí này là O(log n) phụ cho mỗi thao tác ghi — đáng giá để tránh suy biến, nhưng không miễn phí. Nếu dữ liệu của bạn đảm bảo đến theo thứ tự ngẫu nhiên, BST thường cũng đủ cân bằng mà không cần cơ chế xoay.
Lựa chọn thật sự là: bạn cần thứ tự hay không. Nếu chỉ tra cứu key chính xác → hash table (map), nhanh nhất. Nếu cần duyệt theo thứ tự, truy vấn khoảng, hoặc tìm phần tử kế cận → cây cân bằng, chấp nhận O(log n) để đổi lấy khả năng đó. Chọn sai nghĩa là hoặc trả tiền cho khả năng không dùng, hoặc thiếu khả năng cần dùng rồi phải quét toàn bộ.
Ba ý mang về
- Hiệu năng BST = chiều cao cây, mà chiều cao phụ thuộc thứ tự chèn. Đo thật: cùng N=64.000, cây cân bằng (cao 38) tra cứu 99 ns, cây suy biến (cao 64.000, do chèn dữ liệu đã sắp) tra cứu 29.618 ns — chậm gấp ~300 lần. Luôn dùng cây tự cân bằng.
- map Go dùng hash table vì O(1) nhanh hơn O(log n) và thân thiện cache hơn. Đo thật: map Go 19 ns so với BST cân bằng 99 ns ở N=64.000 — cây chậm thêm vì pointer chasing gây cache miss.
- Cây tồn tại vì nó giữ thứ tự. In-order traversal cho dãy đã sắp, truy vấn khoảng, tìm phần tử kế cận — những thứ hash table không làm được. Chọn hash khi tra key chính xác, chọn cây khi cần thứ tự (index database dùng B-tree chính vì vậy).
Nguồn
- Wikipedia — Binary search tree, Self-balancing BST: https://en.wikipedia.org/wiki/Self-balancing_binary_search_tree
- Go blog — Maps in action (vì sao map không bảo đảm thứ tự): https://go.dev/blog/maps
- CMU 15-451 — Balanced trees (red-black, AVL): https://www.cs.cmu.edu/~15451-f23/
Phần sau ta sang heap và hàng đợi ưu tiên: cấu trúc cho phép luôn lấy phần tử nhỏ nhất (hoặc lớn nhất) trong O(log n), và đo thật bài toán top-k — vì sao heap đánh bại việc sắp xếp toàn bộ rồi lấy k phần tử đầu.
