Hash table (bảng băm) là cấu trúc dữ liệu được dùng nhiều nhất mà ít người hiểu sâu. Nó nấp sau mọi map trong Go, dict trong Python, HashMap trong Java, object trong JavaScript. Sức hấp dẫn của nó nằm ở một lời hứa gần như phi lý: tra cứu O(1) trung bình — tìm một phần tử nhanh như nhau dù bảng có 1.000 hay 1 triệu phần tử.
Nhưng chữ "trung bình" trong "O(1) trung bình" là một cảnh báo bị bỏ qua thường xuyên. Hash table có những cách sụp đổ ngoạn mục về O(n), và khi điều đó xảy ra trong production, nó biến một service nhanh thành một service treo. Bài này (phần 4 loạt Giải thuật) đo cả hai mặt: phép màu O(1), và ba cách nó vỡ.
Cơ chế: vì sao tra cứu lại O(1)
Ý tưởng cốt lõi đơn giản đến bất ngờ. Thay vì quét từng phần tử để tìm, hash table băm key thành một con số, rồi dùng số đó làm chỉ số (index) để nhảy thẳng tới vị trí cần — không duyệt gì cả.
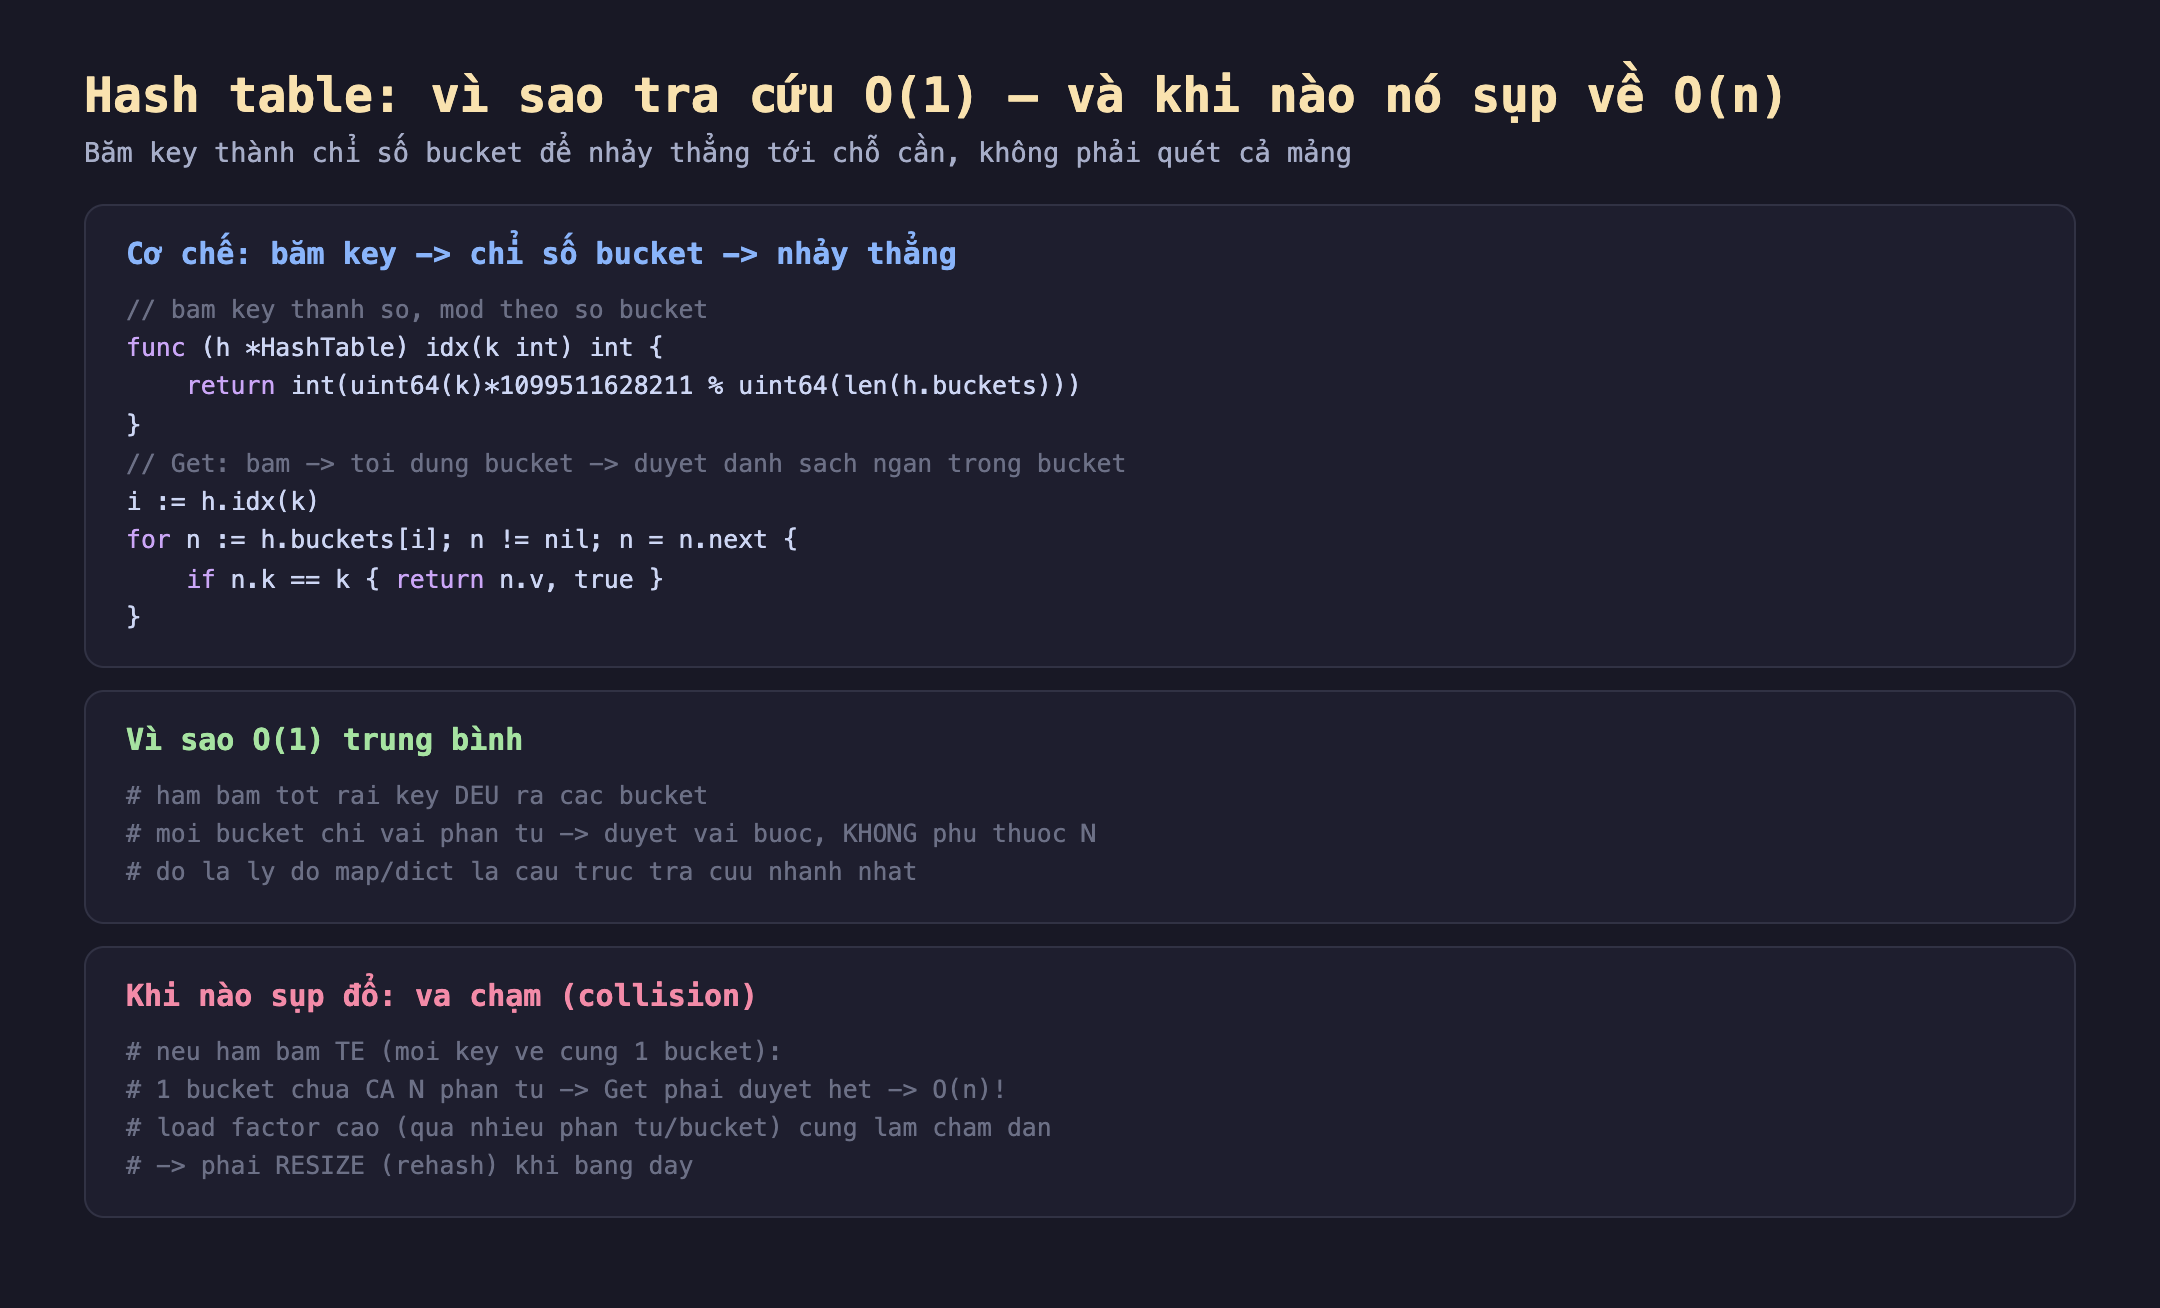
Hình 1: idx băm key thành chỉ số bucket; Get nhảy tới bucket rồi duyệt danh sách ngắn trong đó. Băm tốt rải key đều → mỗi bucket vài phần tử → O(1). Băm tệ → mọi key dồn một bucket → O(n).
type node struct{ k, v int; next *node }
type HashTable struct{ buckets []*node }

// bam key thanh so, mod theo so bucket -> chi so bucket
func (h *HashTable) idx(k int) int {
	return int(uint64(k) * 1099511628211 % uint64(len(h.buckets)))
}

func (h *HashTable) Get(k int) (int, bool) {
	i := h.idx(k)
	for n := h.buckets[i]; n != nil; n = n.next { // duyet danh sach trong bucket
		if n.k == k {
			return n.v, true
		}
	}
	return 0, false
}
Chìa khóa nằm ở idx: nếu hàm băm rải key đều ra các bucket, thì mỗi bucket chỉ chứa vài phần tử, và vòng lặp duyệt trong bucket chỉ chạy vài bước — không phụ thuộc vào N. Đó chính là nguồn gốc của O(1).
Đo thật: O(1) đối đầu O(n)
Mình so ba cách tra cứu một key trong N phần tử: hash table tự viết, map built-in của Go, và quét tuyến tính một slice. Mỗi phép đo chạy 1 triệu lần tra cứu với key rải đều. Kết quả thật từ go-lab:
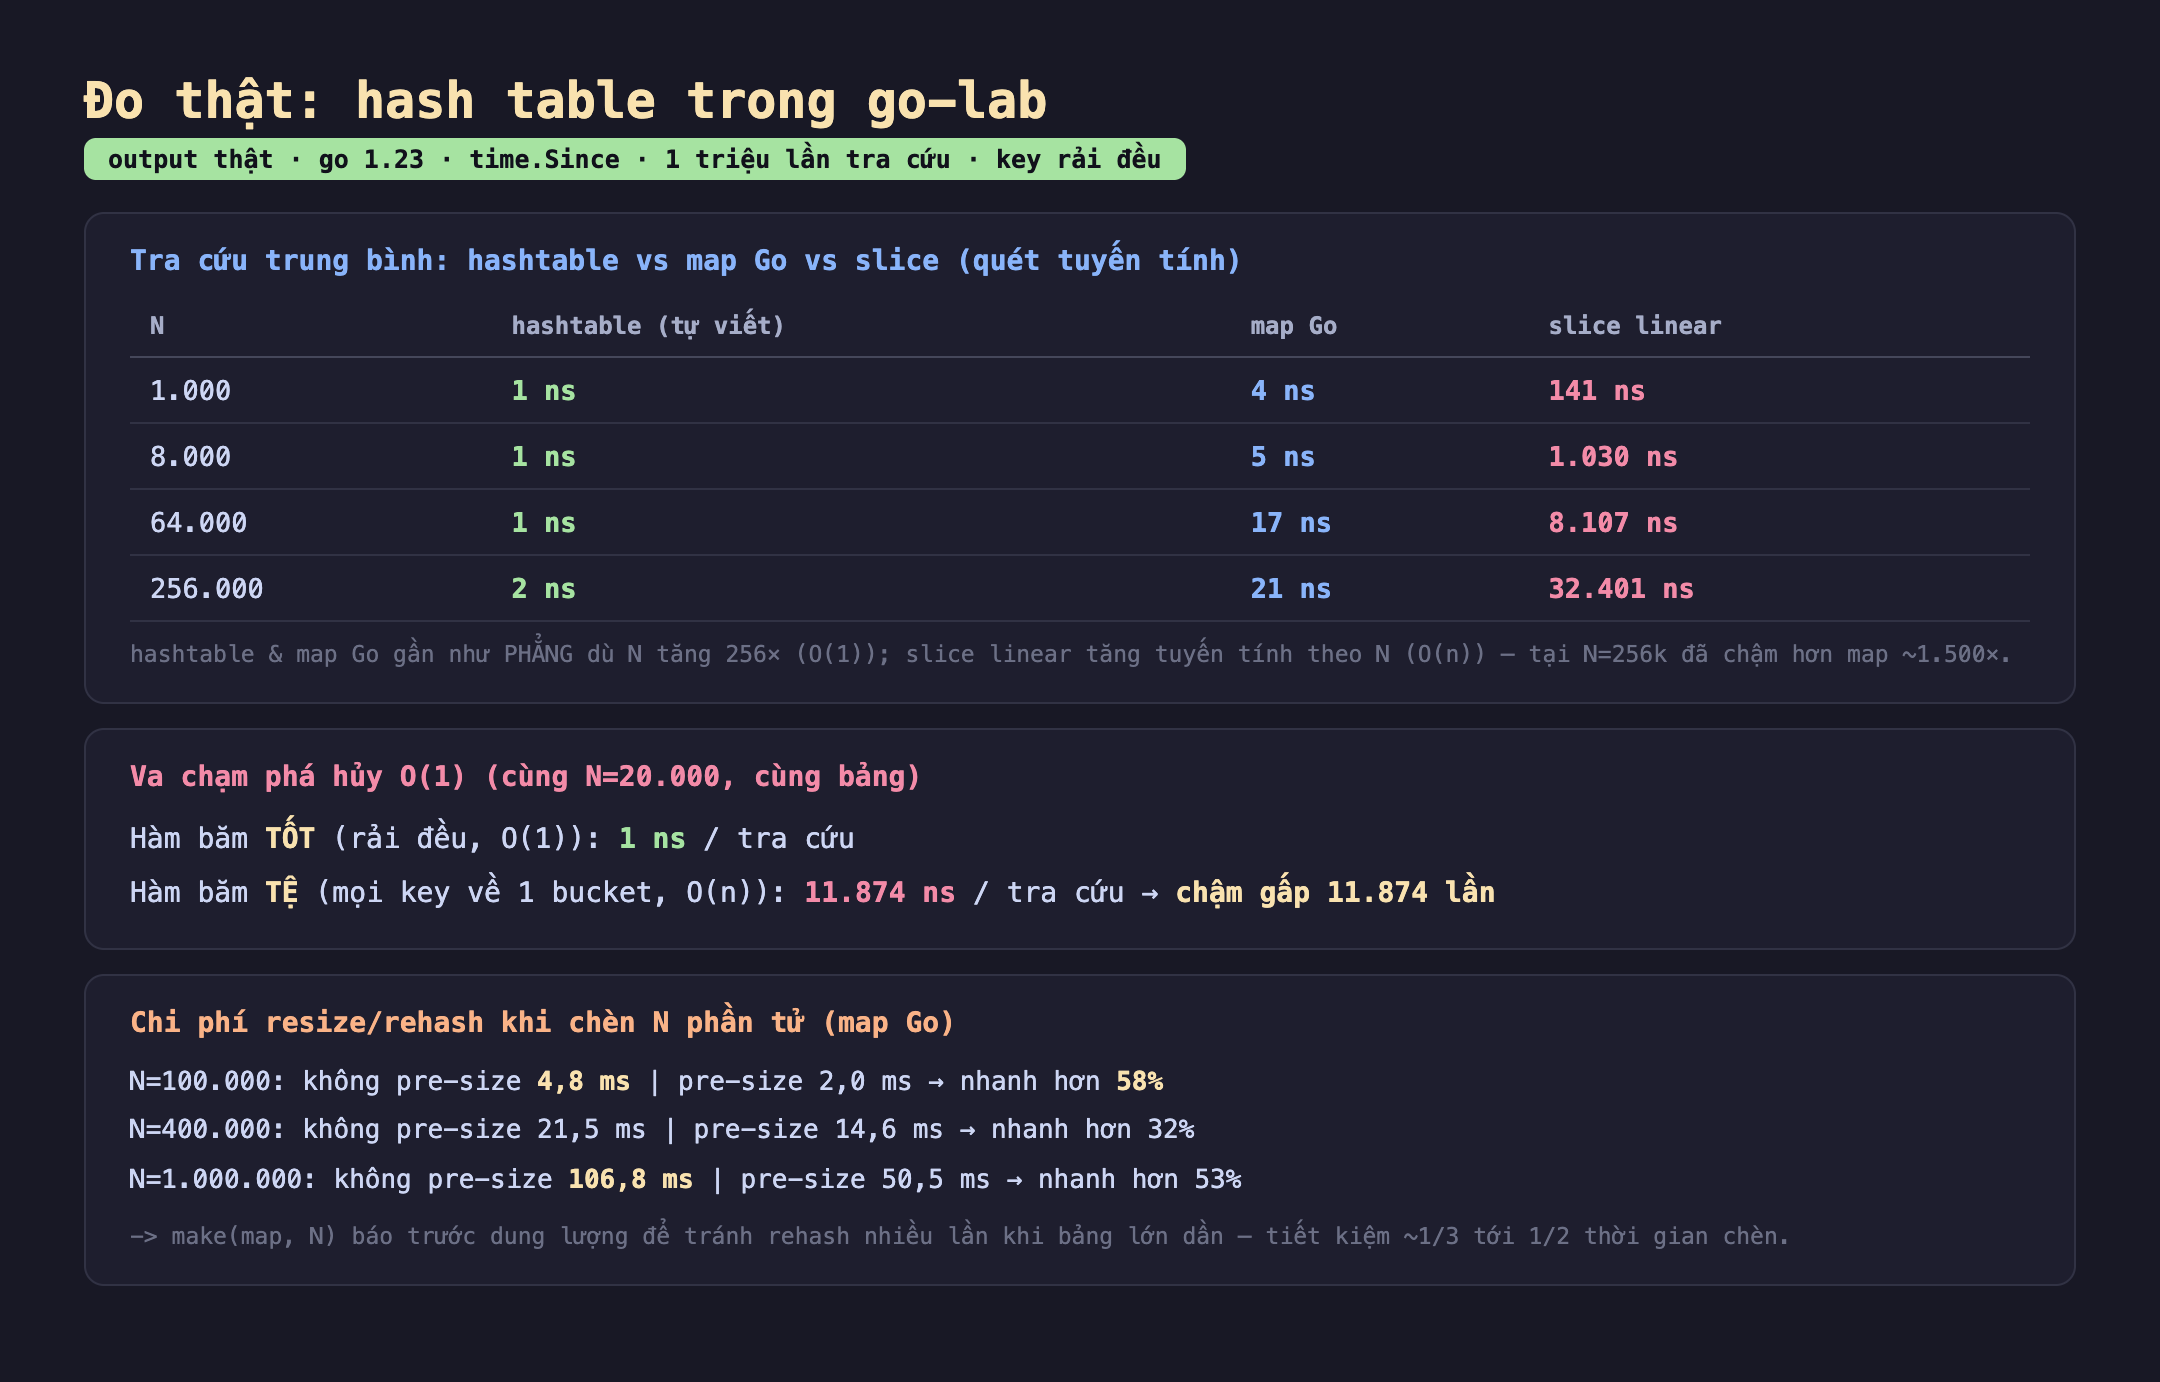
Hình 2: Kết quả thật. hashtable và map Go gần như phẳng dù N tăng 256×; slice linear tăng tuyến tính; va chạm làm tra cứu chậm 11.874×; không pre-size map khiến chèn chậm gấp đôi vì rehash.
- O(1) là có thật: hashtable giữ 1-2 ns và map Go giữ 4-21 ns dù N tăng 256 lần (1.000 → 256.000). map Go nhích lên chút (4→21 ns) không phải vì độ phức tạp đổi, mà vì bảng lớn ra khỏi CPU cache — nhưng về cơ bản vẫn phẳng.
- O(n) tăng không ngừng: slice linear đi từ 141 ns → 32.401 ns khi N tăng. Tại N=256.000, quét slice chậm hơn tra map ~1.500 lần. Đây là lý do bạn dùng
map[key]thay vì quét slice để kiểm tra "phần tử này có tồn tại không".
Ba cách hash table sụp đổ về O(n)
Cách 1: hàm băm tệ → va chạm (collision). Đây là thảm họa lớn nhất. Nếu hàm băm dồn nhiều key vào cùng một bucket, bucket đó phình thành một danh sách liên kết dài — và tra cứu phải duyệt hết, tức O(n). Mình đo bằng cách cố tình làm một hàm băm tệ (mọi key về bucket 0) trên cùng N=20.000: hàm băm tốt cho 1 ns/tra cứu, hàm băm tệ cho 11.874 ns/tra cứu — chậm gấp 11.874 lần. Cùng một cấu trúc, cùng dữ liệu, chỉ khác chất lượng hàm băm, mà hiệu năng khác nhau bốn bậc độ lớn.
Cách 2: quên báo trước dung lượng → rehash lặp lại. Khi bảng đầy (load factor vượt ngưỡng), nó phải resize: cấp một mảng bucket lớn hơn và băm lại toàn bộ phần tử vào vị trí mới — một thao tác O(n). Nếu bạn chèn N phần tử vào bảng nhỏ, nó resize nhiều lần dọc đường. Mình đo chèn vào map Go có và không báo trước dung lượng: với N=1 triệu, không pre-size mất 106,8 ms, còn make(map[int]int, N) chỉ mất 50,5 ms — nhanh hơn 53%. Một tham số dung lượng duy nhất cắt đôi thời gian chèn.
Cách 3 (ngắn gọn): tấn công va chạm có chủ đích. Kẻ tấn công biết hàm băm của bạn có thể cố tình gửi hàng loạt key cùng bucket (hash flooding), ép mọi tra cứu về O(n) và làm sập server. Đây là lý do Go (và nhiều ngôn ngữ) dùng hàm băm có seed ngẫu nhiên mỗi lần chạy chương trình — để kẻ ngoài không đoán được key nào sẽ va chạm.
Đánh đổi cần cân nhắc
O(1) là trung bình được khấu hao, không phải đảm bảo mỗi thao tác. Phần lớn thao tác là O(1), nhưng thao tác gây resize là O(n) (phải rehash toàn bộ). Với hệ thống nhạy độ trễ (low-latency), một lần resize bất ngờ giữa luồng xử lý có thể gây spike độ trễ (latency spike) khó chịu. Khi cần độ trễ ổn định và biết trước số phần tử, hãy pre-size để tránh resize giữa chừng — hoặc dùng cấu trúc có độ trễ dự đoán được hơn.
Hash table không giữ thứ tự, và không tra theo khoảng. Khác mảng đã sắp (binary search ở bài trước), hash table không trả lời được "các key trong khoảng [a, b]" hay "key nhỏ nhất lớn hơn x" — vì nó cố tình xáo trộn key qua hàm băm. Khi cần truy vấn theo khoảng hoặc duyệt theo thứ tự, cây cân bằng (bài sau) hoặc mảng đã sắp mới là lựa chọn đúng, dù chúng chỉ cho O(log n).
Bộ nhớ đổi lấy tốc độ. Hash table nhanh một phần vì giữ bảng thưa (load factor thường dưới 0,75-0,8): luôn có bucket trống để giảm va chạm. Nghĩa là nó tốn nhiều RAM hơn số phần tử thực chứa. Với dữ liệu khổng lồ mà bộ nhớ eo hẹp, đây là cái giá cần cân nhắc — đôi khi một mảng đã sắp gọn hơn lại hợp lý hơn dù tra cứu chậm hơn.
Ba ý mang về
- O(1) của hash table là có thật và ngoạn mục. Đo thật: hashtable và map Go giữ ~1-21 ns dù N tăng 256×, trong khi quét slice tăng tuyến tính tới 32 µs (chậm hơn ~1.500× ở N=256k). Đây là lý do dùng map để kiểm tra tồn tại thay vì quét.
- "Trung bình" là chữ quan trọng — va chạm phá hủy O(1). Đo thật: hàm băm tệ (mọi key một bucket) làm tra cứu chậm 11.874 lần vì bucket thành danh sách O(n). Chất lượng hàm băm quyết định tất cả.
- Resize là O(n) ẩn — hãy pre-size khi biết trước số phần tử. Đo thật: chèn 1 triệu phần tử không pre-size mất 106,8 ms, pre-size chỉ 50,5 ms (nhanh hơn 53%) vì tránh rehash lặp lại. Và hash table không giữ thứ tự, không tra theo khoảng.
Nguồn
- Go blog — Maps in action: https://go.dev/blog/maps
- Go source — runtime/map.go (resize, load factor): https://cs.opensource.google/go/go/+/refs/tags/go1.23.0:src/runtime/map.go
- Wikipedia — Hash table (collision, load factor): https://en.wikipedia.org/wiki/Hash_table
Phần sau ta chuyển sang cây cân bằng: vì sao cây tìm kiếm nhị phân (BST) cho O(log n), điều gì khiến cây mất cân bằng thành O(n), và vì sao map của Go lại chọn hash table chứ không phải cây.
