Sắp xếp là bài toán được nghiên cứu kỹ nhất trong khoa học máy tính, và cũng là nơi câu "O(n log n) tốt hơn O(n²)" được lặp lại nhiều nhất. Điều đó đúng — nhưng nó chỉ là một phần của câu chuyện. Khi bạn thực sự đo các thuật toán sắp xếp chạy trên dữ liệu thật, vài điều lộ ra mà công thức Big-O không hề nói: hằng số ẩn, chi phí cấp phát bộ nhớ, và vì sao bạn gần như không bao giờ nên tự viết hàm sort.
Bài này (phần 3 loạt Giải thuật) cho bốn thuật toán đọ sức trong go-lab: insertion sort (O(n²)), quicksort và mergesort tự viết (O(n log n)), và sort.Ints của thư viện chuẩn Go. Mỗi con số dưới đây là đo thật.
Bốn thuật toán, bốn triết lý
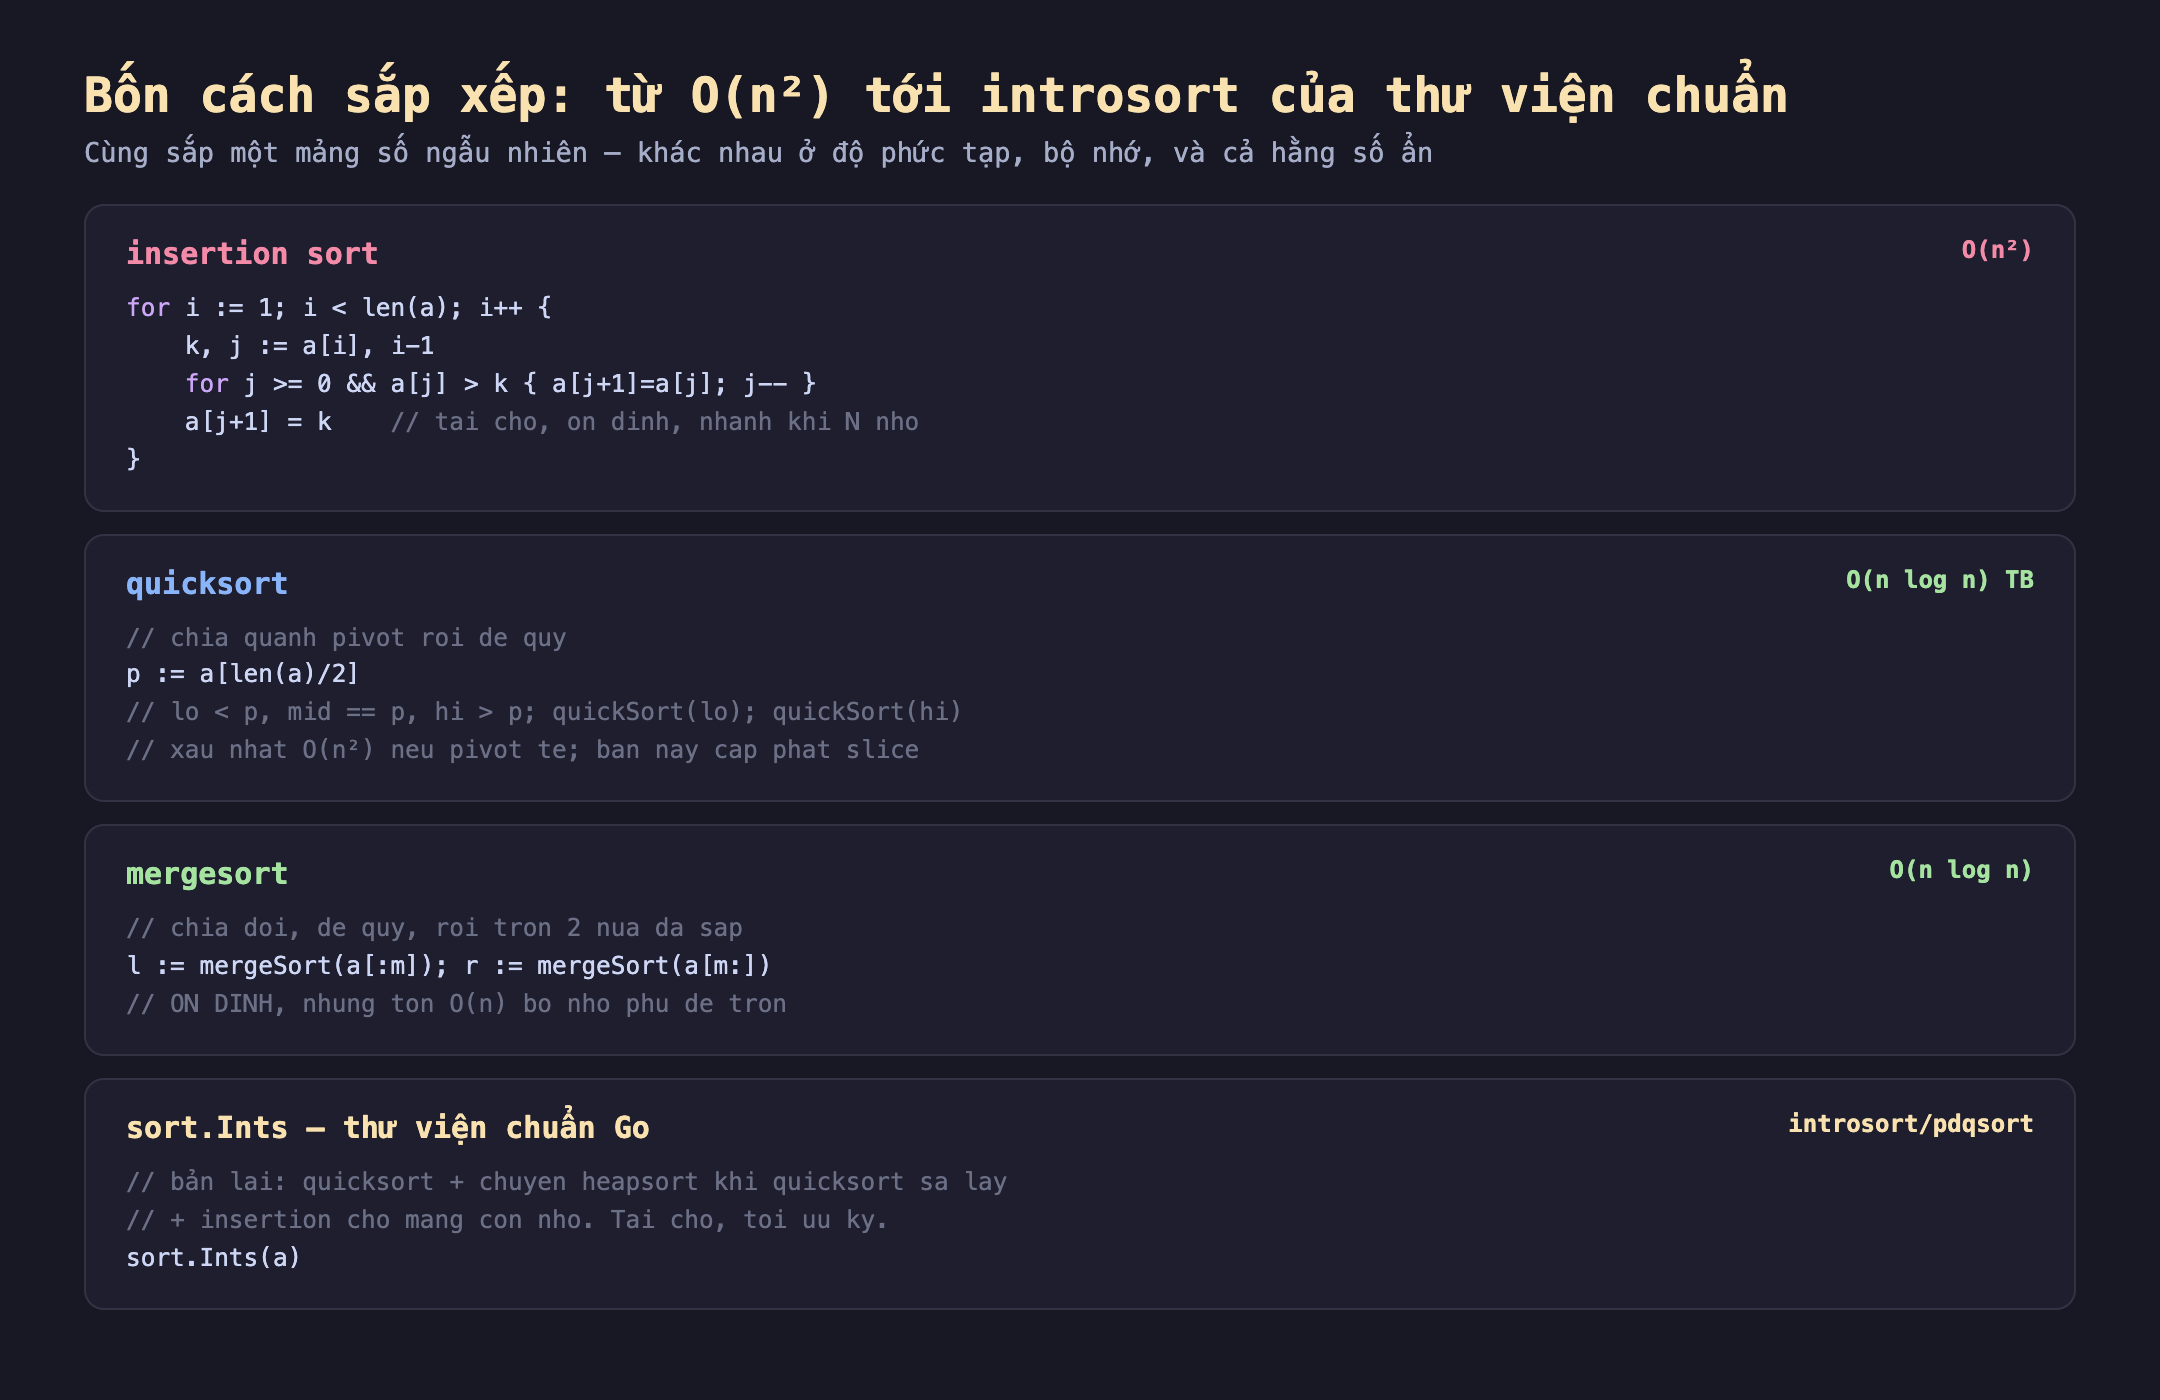
Hình 1: Bốn cách tiếp cận. insertion chèn tuần tự (tốt cho N nhỏ); quicksort chia-để-trị quanh pivot; mergesort chia đôi rồi trộn (ổn định, tốn RAM); sort.Ints là introsort — bản lai thông minh của thư viện chuẩn.
// O(n^2): chen tung phan tu vao dung vi tri — tai cho, on dinh
func insertionSort(a []int) {
	for i := 1; i < len(a); i++ {
		k, j := a[i], i-1
		for j >= 0 && a[j] > k {
			a[j+1] = a[j]
			j--
		}
		a[j+1] = k
	}
}

// O(n log n) trung binh: chia quanh pivot roi de quy
func quickSort(a []int) {
	if len(a) <= 1 {
		return
	}
	p := a[len(a)/2]
	var lo, mid, hi []int
	for _, v := range a {
		switch {
		case v < p:
			lo = append(lo, v)
		case v == p:
			mid = append(mid, v)
		default:
			hi = append(hi, v)
		}
	}
	quickSort(lo)
	quickSort(hi)
	copy(a, append(append(lo, mid...), hi...))
}
Đo thật: bốn thuật toán trên cùng dữ liệu
Mình sinh mảng số nguyên ngẫu nhiên (cùng seed 42 để công bằng) ở các kích thước 1.000 → 64.000, rồi đo từng thuật toán sắp một bản sao. insertion sort bị bỏ qua ở N=64.000 vì O(n²) đã quá chậm. Kết quả thật:
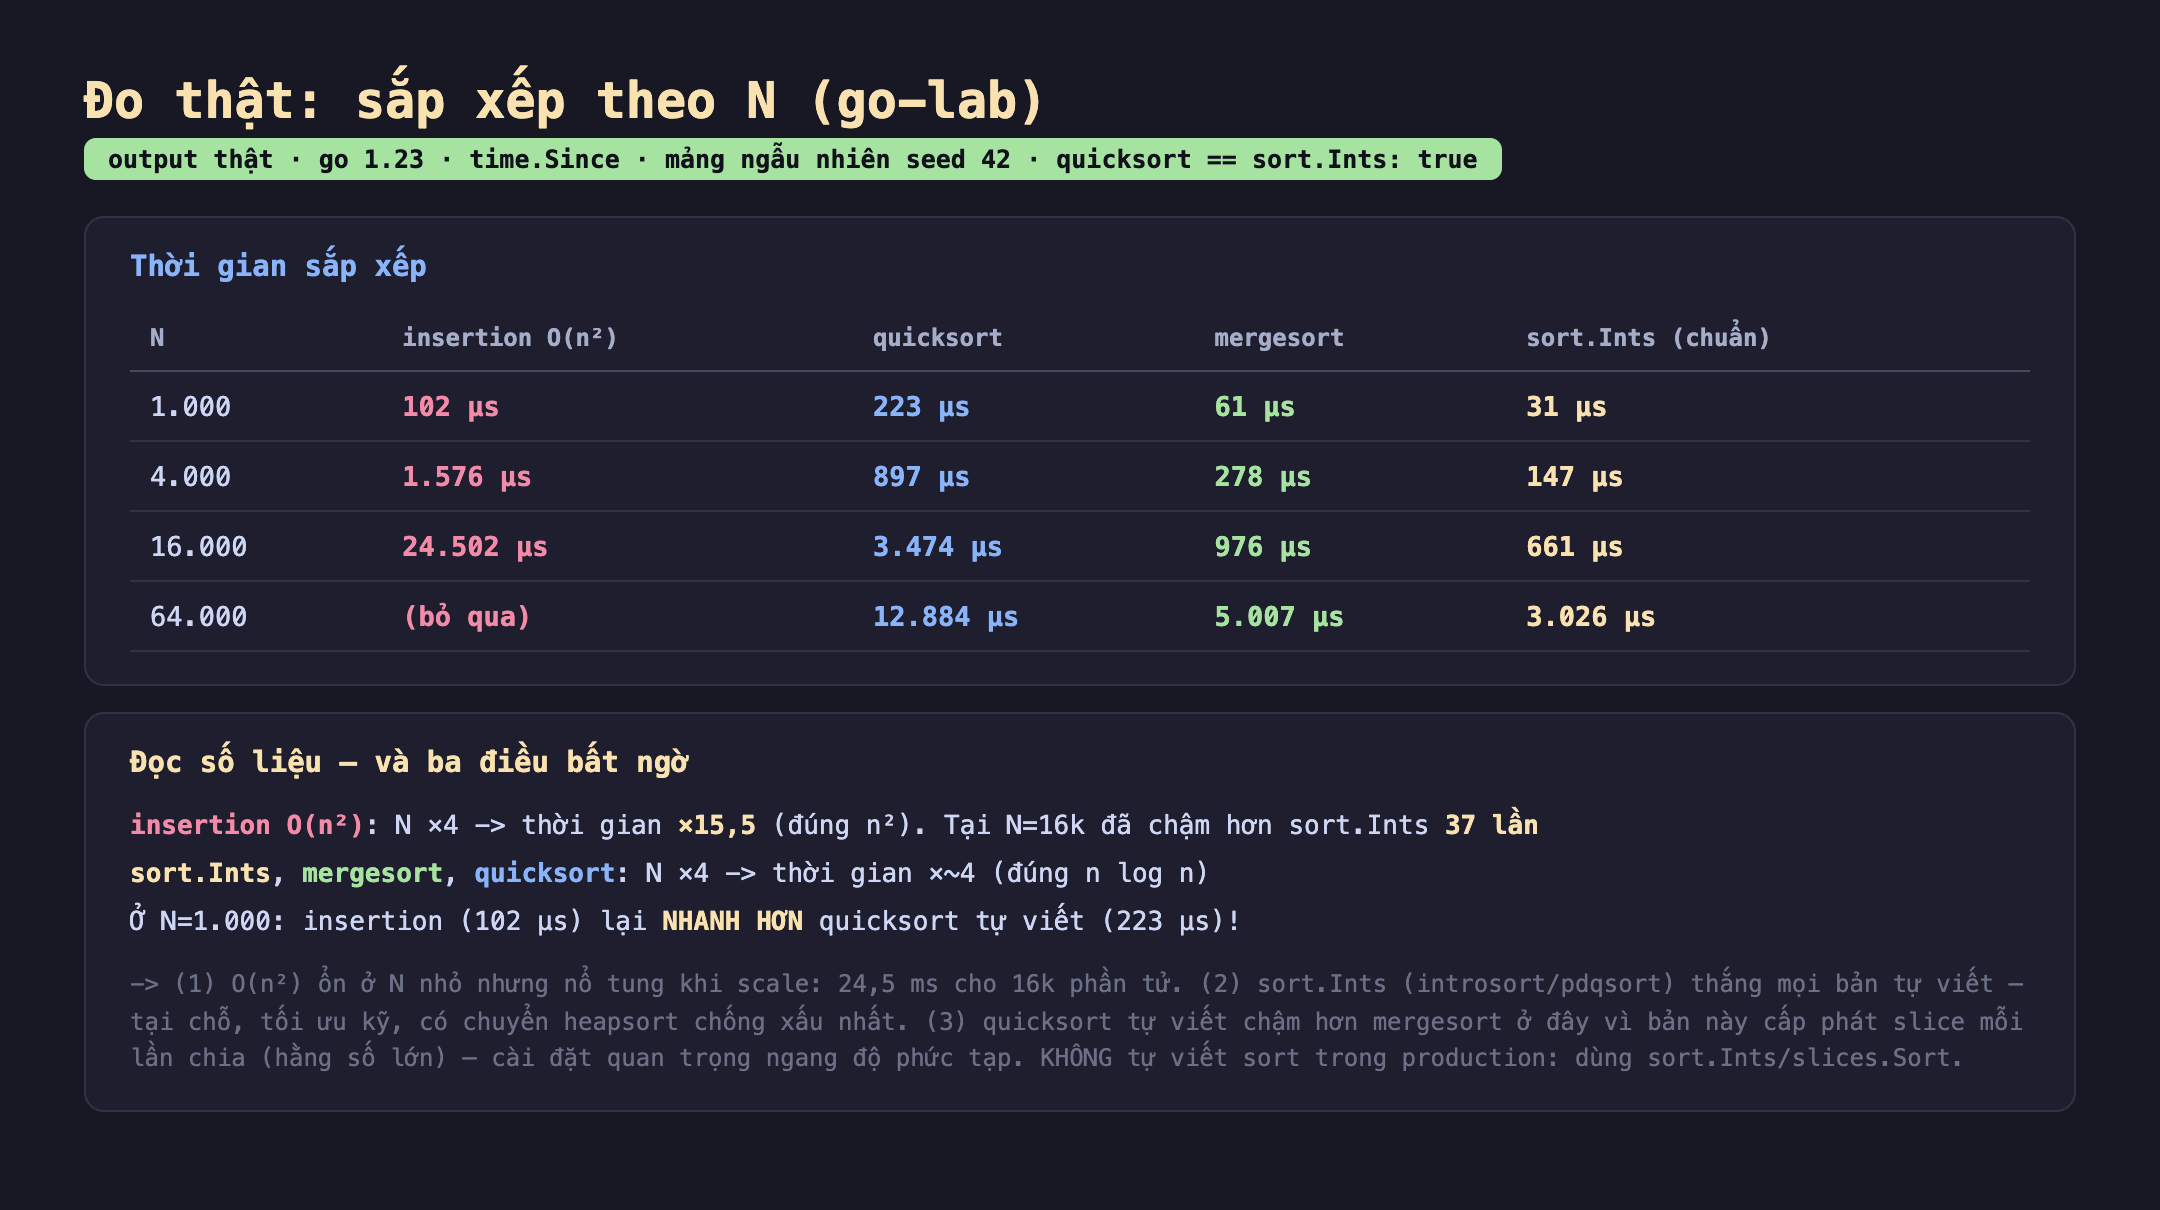
Hình 2: Kết quả thật. insertion O(n²) nhân ~15,5 mỗi khi N ×4; ba thuật toán O(n log n) nhân ~4; sort.Ints nhanh nhất ở mọi N. Kiểm đúng: quicksort cho kết quả y hệt sort.Ints.
Đọc con số cho thấy Big-O hiện ra — và cả những điều Big-O không nói:
- insertion O(n²) nổ tung khi scale: 102 → 1.576 → 24.502 µs. Mỗi khi N ×4, thời gian ×~15,5 (đúng dấu vân tay n²:
4² = 16). Tại N=16.000 nó đã chậm hơnsort.Ints37 lần, và ở N=64.000 thì không buồn đo nữa. - Ba thuật toán O(n log n) scale đẹp: quicksort, mergesort và
sort.Intsđều nhân ~4 mỗi khi N ×4 (n log n gần như tuyến tính ở vùng này). Khoảng cách với insertion ngày càng rộng. sort.Intsthắng tuyệt đối: 31 → 147 → 661 → 3.026 µs, nhanh nhất ở mọi kích thước.
Ba điều bất ngờ Big-O không nói
Bất ngờ 1: ở N nhỏ, O(n²) đánh bại O(n log n). Tại N=1.000, insertion sort (102 µs) nhanh hơn quicksort tự viết của mình (223 µs). Không phải toán sai — mà vì insertion có hằng số cực nhỏ (chỉ so sánh và dịch trong một mảng liền kề, thân thiện cache), còn quicksort trả chi phí đệ quy và cấp phát. Đây chính là lý do mọi thư viện sort thật đều chuyển sang insertion sort cho các mảng con nhỏ. "Tốt hơn khi N lớn" không có nghĩa "tốt hơn ở mọi N".
Bất ngờ 2: quicksort tự viết thua mergesort — vì cấp phát bộ nhớ. Trên lý thuyết quicksort thường nhanh hơn mergesort nhờ hằng số nhỏ và tính tại-chỗ. Nhưng bản quicksort của mình (12.884 µs ở N=64.000) chậm hơn mergesort (5.007 µs), vì nó cấp phát ba slice mới (lo, mid, hi) ở mỗi lần chia — áp lực cấp phát và GC nuốt hết ưu thế thuật toán. Cùng một độ phức tạp O(n log n), nhưng cài đặt quyết định tất cả. Một quicksort tại-chỗ (hoán đổi trong mảng, không cấp phát) sẽ nhanh hơn hẳn.
Bất ngờ 3: đừng bao giờ tự viết sort cho production. sort.Ints đánh bại cả ba bản tự viết ở mọi N, vì nó là introsort (còn gọi pdqsort trong Go hiện đại): bắt đầu bằng quicksort, chuyển sang heapsort khi phát hiện quicksort đang sa lầy vào trường hợp xấu O(n²), và dùng insertion sort cho mảng con nhỏ. Nó gộp ưu điểm của cả ba, sắp tại chỗ, và được tối ưu suốt nhiều năm. Code của bạn gần như chắc chắn không thắng được nó.
Đánh đổi cần cân nhắc
Ổn định (stable) hay không — không phải thuật toán nào cũng có. Một sort ổn định giữ nguyên thứ tự tương đối của các phần tử bằng khóa. mergesort và insertion sort ổn định; quicksort và introsort (sort.Ints) thì không. Khi sắp theo nhiều tiêu chí (ví dụ sắp theo tên, rồi sắp theo tuổi mà vẫn giữ thứ tự tên trong cùng tuổi), bạn cần sort ổn định — dùng sort.SliceStable thay vì sort.Slice. Điều này không hiện trong Big-O nhưng quyết định tính đúng của kết quả.
Bộ nhớ: tại chỗ hay không. insertion và introsort sắp tại chỗ (O(1) bộ nhớ phụ, hoặc O(log n) cho ngăn xếp đệ quy). mergesort cần O(n) bộ nhớ phụ để trộn — với mảng khổng lồ, đây có thể là yếu tố quyết định. Khi RAM eo hẹp, một thuật toán chậm hơn chút nhưng tại-chỗ lại là lựa chọn đúng.
Dữ liệu gần như đã sắp thay đổi cuộc chơi. Trên mảng gần như đã sắp, insertion sort chạy gần O(n) (mỗi phần tử chỉ dịch vài bước), và pdqsort có nhánh phát hiện mẫu để tận dụng điều đó. Nếu dữ liệu của bạn thường gần sắp sẵn (ví dụ thêm vài phần tử vào một mảng đã sắp), đừng mặc định quicksort — đo trên dữ liệu thật của bạn, không phải dữ liệu ngẫu nhiên.
Ba ý mang về
- O(n²) nổ tung nhưng chỉ khi N đủ lớn. Đo thật: insertion nhân ~15,5 mỗi khi N ×4, chậm hơn
sort.Ints37 lần ở N=16.000 — nhưng lại nhanh hơn quicksort tự viết ở N=1.000. Hằng số và cache quyết định vùng N nhỏ. - Cài đặt quan trọng ngang độ phức tạp. Quicksort tự viết thua mergesort vì cấp phát slice mỗi lần chia; cùng O(n log n) nhưng áp lực bộ nhớ/GC làm nó chậm gấp đôi. Big-O bỏ qua hằng số, nhưng bạn thì không được bỏ qua.
- Dùng thư viện chuẩn, đừng tự viết.
sort.Ints/slices.Sortlà introsort/pdqsort — lai quicksort + heapsort + insertion, tại chỗ, chống trường hợp xấu, tối ưu nhiều năm. Nó thắng mọi bản tự viết ở mọi N; chỉ tự cài khi học, không phải khi chạy thật.
Nguồn
- Go docs — sort.Ints, sort.SliceStable: https://pkg.go.dev/sort
- Go blog / source — pdqsort trong slices.Sort: https://cs.opensource.google/go/go/+/refs/tags/go1.23.0:src/slices/sort.go
- David Musser — Introspective Sorting (introsort): https://en.wikipedia.org/wiki/Introsort
Phần sau ta mổ xẻ hash table: vì sao nó cho tra cứu O(1) trung bình, điều gì xảy ra khi va chạm (collision) nhiều, và đo thật chi phí khi bảng băm phải mở rộng (resize) lúc dữ liệu lớn dần.
