Tìm một phần tử trong mảng là thao tác cơ bản đến mức ít ai nghĩ lại. Hai lựa chọn kinh điển: linear search (quét từng phần tử, O(n)) và binary search (chia đôi không gian mỗi bước, O(log n)). Lý thuyết nói binary thắng, và bài trước đã cho thấy O(log n) gần như phẳng còn O(n) tăng tuyến tính. Vậy câu chuyện kết thúc ở đó?
Không hẳn. Binary search có một điều kiện tiên quyết dễ bị quên: mảng phải đã được sắp xếp. Và cái giá của việc sắp xếp trước, cộng với cách CPU đọc bộ nhớ, biến một kết luận tưởng như hiển nhiên thành một quyết định có điều kiện. Bài này (phần 2 loạt Giải thuật) đo cả hai, rồi đo luôn cái giá đó.
Hai thuật toán, hai điều kiện
Linear search không đòi hỏi gì: mảng thế nào cũng tìm được, quét tuần tự tối đa N phép so sánh. Binary search đòi mảng đã sắp để mỗi bước loại bỏ được một nửa không gian — nhờ đó chỉ cần tối đa log₂(N) phép so sánh.
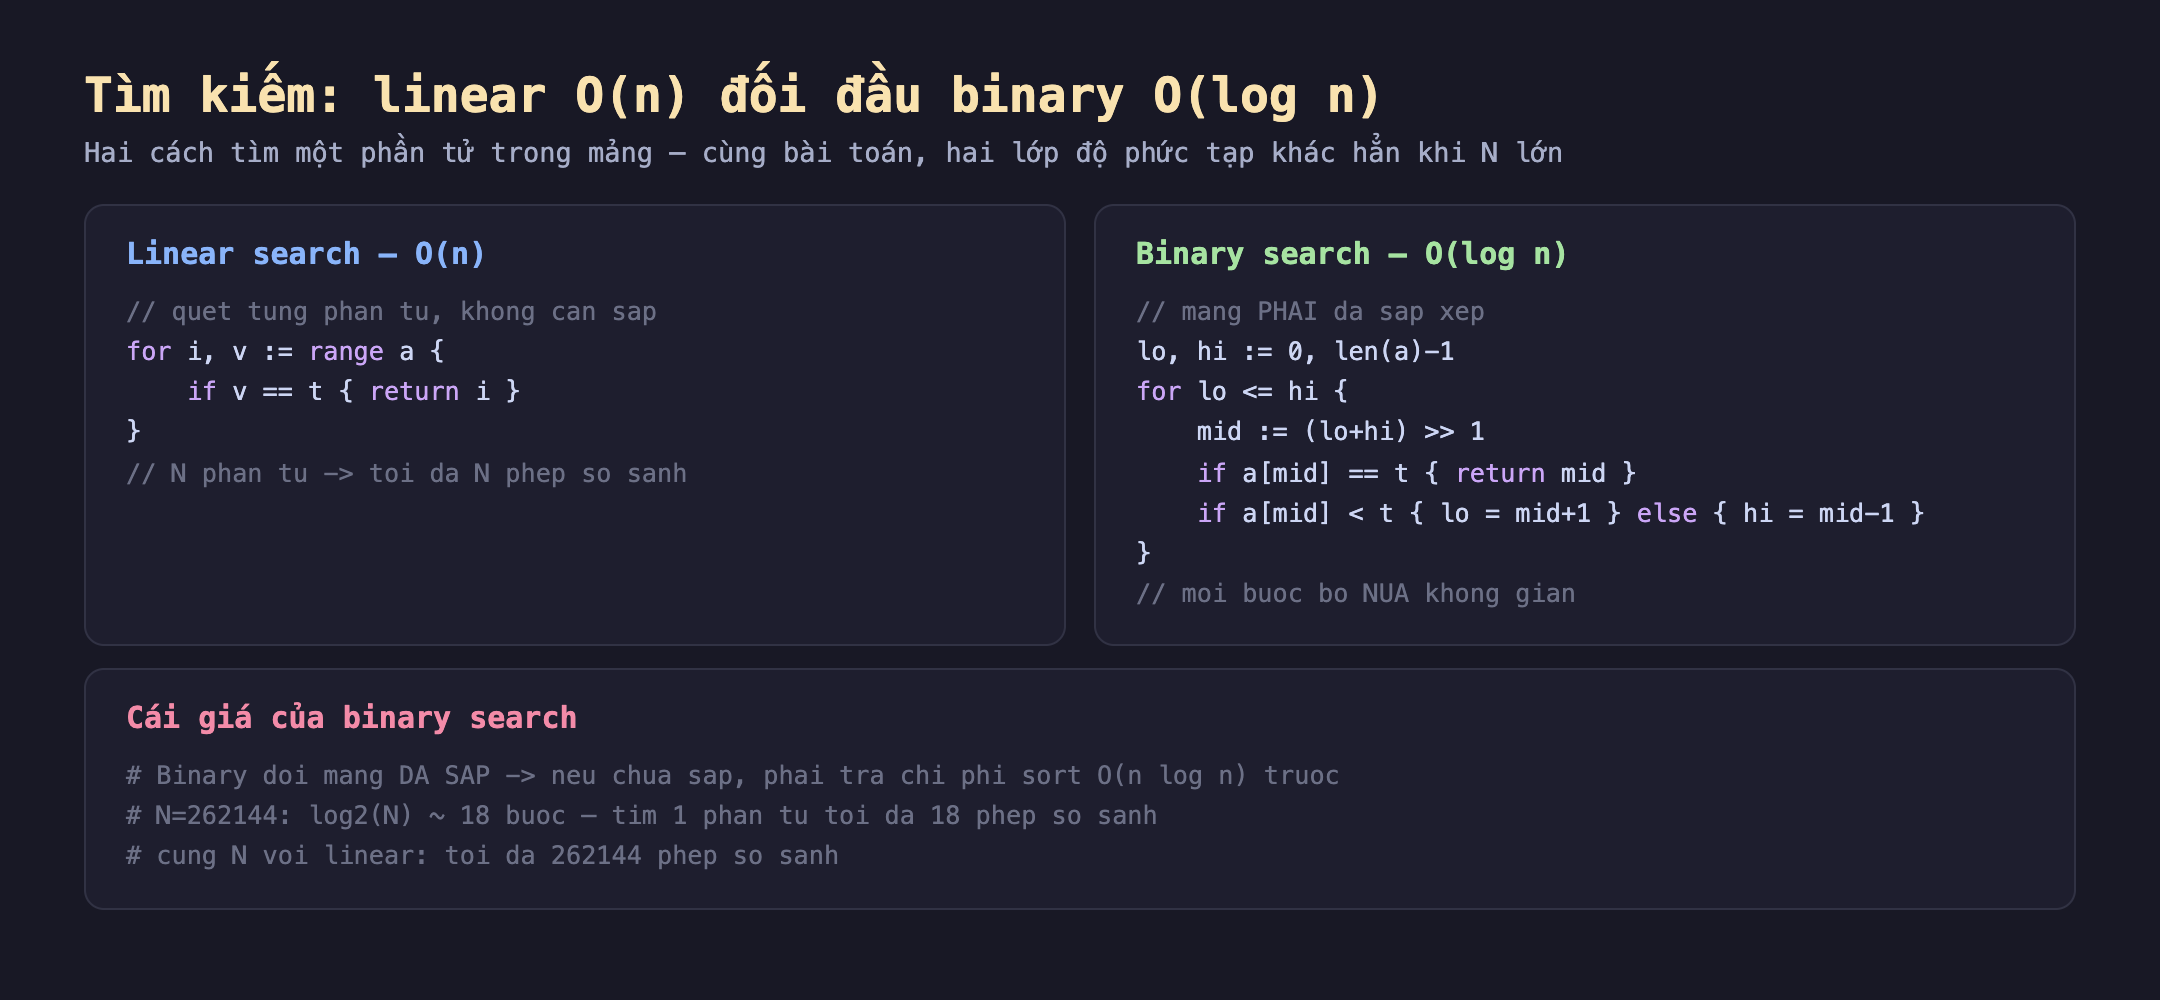
Hình 1: linear quét tuần tự, không cần điều kiện; binary đòi mảng đã sắp, mỗi bước bỏ nửa không gian (mid = (lo+hi) >> 1). Với N=262.144, binary cần tối đa ~18 phép so sánh, còn linear tối đa 262.144.
func linear(a []int, t int) int {
	for i, v := range a {
		if v == t {
			return i
		}
	}
	return -1
}

func binary(a []int, t int) int { // a PHAI da sap xep
	lo, hi := 0, len(a)-1
	for lo <= hi {
		mid := int(uint(lo+hi) >> 1) // tranh tran so khi lo+hi lon
		if a[mid] == t {
			return mid
		}
		if a[mid] < t {
			lo = mid + 1
		} else {
			hi = mid - 1
		}
	}
	return -1
}
Chi tiết nhỏ đáng chú ý: mid := int(uint(lo+hi) >> 1) thay vì (lo+hi)/2. Với mảng cực lớn, lo+hi có thể tràn số nguyên có dấu; ép sang uint rồi dịch bit né được lỗi kinh điển này. Đây là bug từng tồn tại trong thư viện chuẩn của nhiều ngôn ngữ suốt nhiều năm.
Đo thật: tìm trên mảng đã sắp
Mình tạo mảng đã sắp ở năm kích thước, rồi thực hiện 2 triệu lần tìm trên mỗi mảng (để trung bình ra con số sạch, vì một lần tìm quá nhanh). Kết quả thật từ go-lab:
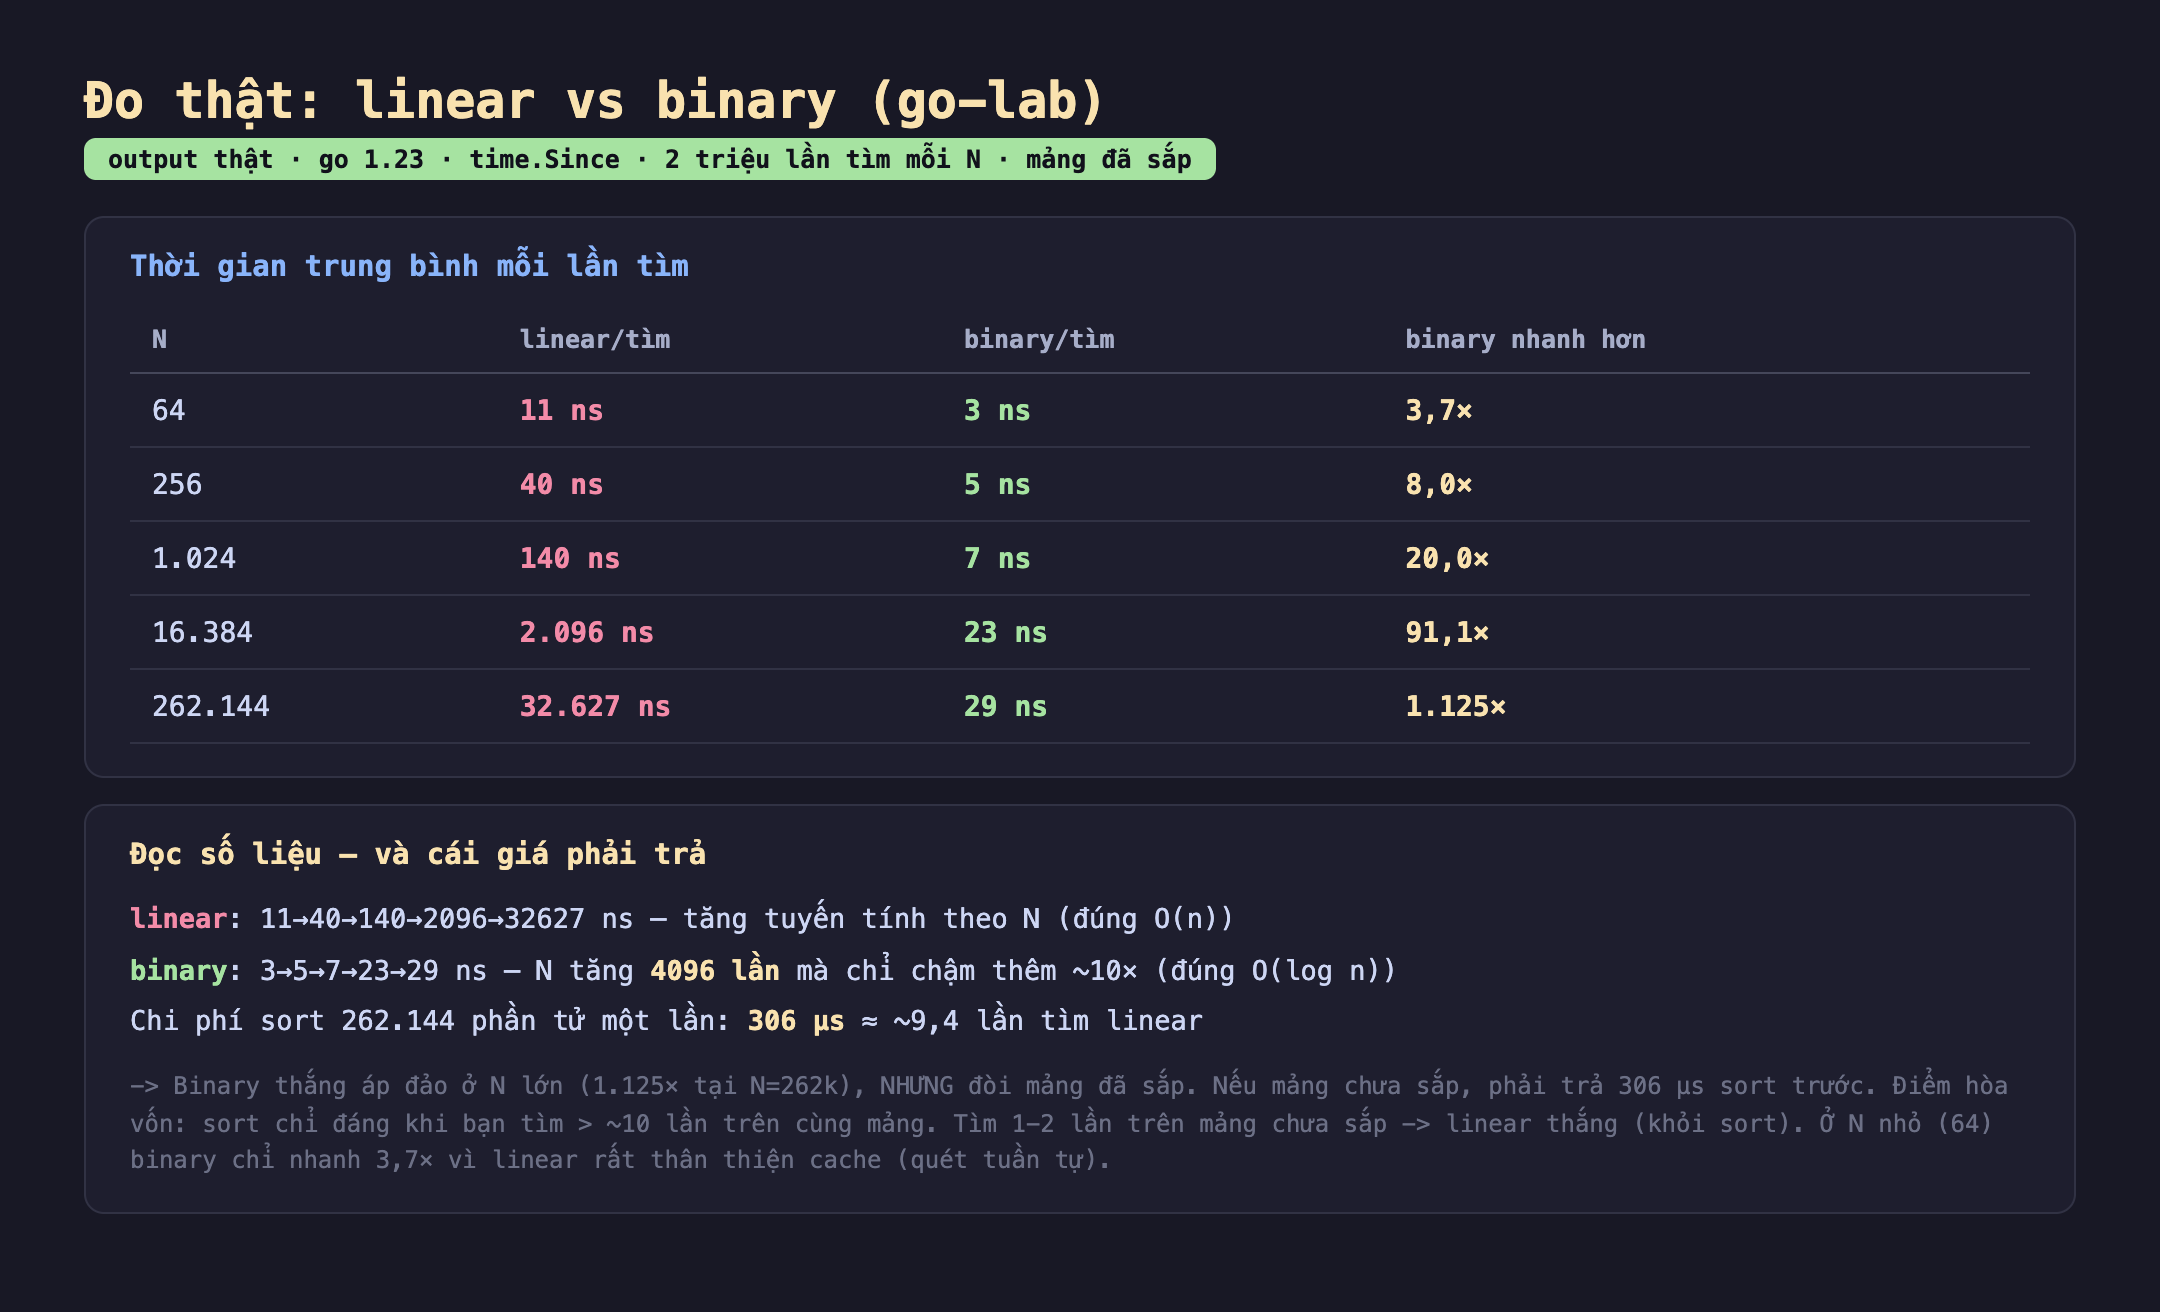
Hình 2: Kết quả thật. linear tăng tuyến tính theo N; binary N tăng 4096 lần mà chỉ chậm thêm ~10×; tại N=262.144 binary nhanh hơn 1.125×. Chi phí sort một lần: 306 µs.
Đọc con số:
- linear: 11 → 40 → 140 → 2.096 → 32.627 ns. Tăng gần đúng tuyến tính theo N — đúng O(n). Trung bình mỗi lần tìm phải quét khoảng nửa mảng.
- binary: 3 → 5 → 7 → 23 → 29 ns. N tăng từ 64 lên 262.144 (4.096 lần) mà thời gian chỉ tăng ~10×. Đây là O(log n) hiện ra:
log₂(262144)/log₂(64) = 18/6 = 3, số bước chỉ gấp 3, phần dôi là do mảng lớn ra khỏi cache. - Khoảng cách bùng nổ theo N: 3,7× ở N=64, nhưng 1.125× ở N=262.144. Càng nhiều dữ liệu, binary càng thắng đậm.
Nhưng binary không miễn phí: cái giá sắp xếp
Đây là chỗ lý thuyết sách giáo khoa hay bỏ qua. Binary search đòi mảng đã sắp. Nếu dữ liệu của bạn chưa sắp, bạn phải trả chi phí sort.Ints trước — mình đo được 306 µs cho 262.144 phần tử. Con số đó tương đương khoảng 9,4 lần tìm linear (32,6 µs mỗi lần) trên chính mảng đó.
Từ đó rút ra điểm hòa vốn thực tế: gọi q là số lần bạn cần tìm trên cùng một mảng chưa sắp.
- Dùng linear (không sắp): tổng chi phí ≈
q × 32.627 ns. - Dùng sort + binary: tổng chi phí ≈
306.125 ns + q × 29 ns.
Cho hai vế bằng nhau: 306.125 ≈ q × 32.598, suy ra q ≈ 9,4. Nghĩa là:
- Tìm 1-2 lần trên mảng chưa sắp → linear thắng. Bỏ công sort để tìm vài lần là lỗ.
- Tìm nhiều lần (hơn ~10) trên cùng mảng → sort một lần rồi binary thắng áp đảo, vì chi phí sort được chia đều (khấu hao) cho rất nhiều lần tìm.
Đây chính là lý do các cấu trúc tra cứu đọc-nhiều-ghi-ít (chỉ mục database, bảng tra cố định) luôn giữ dữ liệu ở dạng đã sắp: chi phí sắp xếp trả một lần, lợi ích binary gặt mãi về sau.
Đánh đổi cần cân nhắc
Ở N nhỏ, cache khiến linear không tệ như lý thuyết. Tại N=64, binary chỉ nhanh hơn 3,7× — không phải vì toán sai, mà vì linear quét tuần tự, cực kỳ thân thiện với CPU cache và bộ nạp trước (prefetcher). Binary thì nhảy lung tung (mid nhảy khắp mảng), mỗi bước có thể là một lần cache miss. Với mảng nhỏ nằm gọn trong cache L1, chi phí mỗi phép so sánh của linear gần như bằng không, nên ưu thế O(log n) bị thu hẹp. Sự khác biệt chỉ bùng nổ khi mảng vượt kích thước cache.
Mảng thay đổi liên tục phá vỡ lợi thế binary. Phân tích hòa vốn ở trên giả định mảng sắp một lần rồi tra nhiều lần. Nếu mảng bị chèn/xóa liên tục, bạn phải sắp lại (hoặc chèn đúng vị trí, cũng O(n) để dịch phần tử) sau mỗi thay đổi — chi phí này có thể nuốt hết lợi ích. Khi dữ liệu động mà cần tra cứu nhanh, một map (hash table, O(1) trung bình — bài sau) hay cây cân bằng thường hợp hơn mảng + binary search.
Binary search có nhiều cạm bẫy cài đặt. Ngoài lỗi tràn số (lo+hi)/2 đã nói, còn các biến thể tinh vi: tìm phần tử đầu tiên thỏa điều kiện, tìm cận dưới/cận trên (lower/upper bound), xử lý phần tử trùng. Cài sai điều kiện vòng lặp (< hay <=, mid+1 hay mid) dẫn tới lặp vô hạn hoặc bỏ sót. Trong code thật, nên dùng sort.Search của thư viện chuẩn thay vì tự viết — nó đã xử lý đúng các ca biên này.
Ba ý mang về
- Binary search thắng càng đậm khi N càng lớn. Đo thật: binary nhanh hơn linear 3,7× ở N=64 nhưng 1.125× ở N=262.144, vì binary gần như phẳng (O(log n)) còn linear tăng tuyến tính (O(n)).
- Binary không miễn phí — cái giá là sắp xếp trước. Sort 262.144 phần tử tốn 306 µs ≈ 9,4 lần tìm linear; điểm hòa vốn ~10 lần tìm. Tìm 1-2 lần trên mảng chưa sắp thì linear thắng; tra cứu nhiều lần thì sort một lần rồi binary.
- Big-O không phải tất cả — cache và tính động của dữ liệu có tiếng nói. Ở N nhỏ linear thân thiện cache nên khoảng cách hẹp; mảng thay đổi liên tục xóa sạch lợi thế binary, lúc đó map hay cây cân bằng hợp hơn.
Nguồn
- Go docs — sort.Search: https://pkg.go.dev/sort#Search
- Jon Bentley — Programming Pearls (lỗi tràn số trong binary search): https://en.wikipedia.org/wiki/Binary_search_algorithm#Implementation_issues
- Go docs — package time: https://pkg.go.dev/time
Phần sau ta mổ xẻ sắp xếp: quicksort đối đầu mergesort, vì sao sort của thư viện chuẩn lại là bản lai (introsort), và đo thật xem O(n log n) khác O(n²) bao xa khi dữ liệu lớn.
